Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Cette page explique comment utiliser databricks Data Classification in Unity Catalog pour classifier et baliser automatiquement les données sensibles dans votre catalogue.
Pour les nouveaux classificateurs, les changements de comportement de classification et d’autres mises à jour, consultez les notes de publication de la classification des données.
Les catalogues de données peuvent avoir une grande quantité de données, contenant souvent des données sensibles connues et inconnues. Il est essentiel que les équipes de données comprennent le type de données sensibles qui existe dans chaque table afin qu’elles puissent régir et démocratiser l’accès à ces données.
Pour résoudre ce problème, Databricks Data Classification utilise un agent pour classifier et étiqueter automatiquement des tables dans votre catalogue. Cela vous permet de découvrir des données sensibles et d’appliquer des contrôles de gouvernance sur les résultats, à l’aide d’outils tels que le contrôle d’accès basé sur les attributs dans le catalogue Unity. Pour obtenir la liste des balises prises en charge, consultez balises de classification prises en charge.
À l’aide de cette fonctionnalité, vous pouvez :
- Classifier les données : le moteur utilise un système IA agentique pour classifier et étiqueter automatiquement toutes les tables dans le catalogue Unity.
- Optimisez les coûts grâce à l’analyse intelligente : le système détermine intelligemment quand analyser vos données en tirant parti du catalogue Unity et du moteur d’intelligence des données. Cela signifie que l’analyse est incrémentielle et optimisée pour garantir que toutes les nouvelles données sont classées sans configuration manuelle.
- Passez en revue et protégez les données sensibles : l’affichage des résultats vous aide à afficher les résultats de classification et à protéger les données sensibles en étiquetant et en créant des stratégies de contrôle d’accès pour chaque classe.
Les administrateurs de compte et de metastore peuvent surveiller la couverture de classification, par exemple le pourcentage de tables avec des détections de données sensibles, dans la page Données du Hub de gouvernance.
Important
Databricks Data Classification utilise le stockage par défaut pour stocker les résultats de classification. Vous n’êtes pas facturé pour le stockage.
Databricks Data Classification utilise un modèle de langage volumineux (LLM) pour faciliter la classification.
Spécifications
- Votre espace de travail doit disposer du calcul sans serveur (activé par défaut dans les espaces de travail avec Unity Catalog).
- Pour permettre la classification des données, vous devez posséder le catalogue ou en avoir le
MANAGEprivilège. - Pour activer l’étiquetage automatique d’un catalogue, vous devez avoir
USE CATALOGsur le catalogue,APPLY TAGsur le catalogue etASSIGNsur la balise appliquée. - Pour consulter les résultats de classification dans l’interface, vous devez avoir soit :
-
MANAGEdans le catalogue, ou -
READ METADATAdans le catalogue, ou -
USE CATALOG,USE SCHEMA, etSELECTsur le catalogue.
-
- Pour afficher des exemples de valeurs associées aux détections, vous devez avoir
SELECTsur la table système de résultats.
Remarque
Par défaut, seuls les administrateurs de compte disposent des autorisations MANAGE et ASSIGN sur les balises régies par le système de classification des données. Les administrateurs de compte peuvent accorder MANAGE et ASSIGN pour des balises gouvernées individuelles à d’autres utilisateurs, principaux de service ou groupes. Consultez Gérer les autorisations sur les balises régies.
Utiliser la classification des données
Vous pouvez activer la classification des données pour plusieurs catalogues à la fois à partir de la page de résultats ou configurer des catalogues individuels avec un contrôle au niveau du schéma plus granulaire.
Activer plusieurs catalogues
- Dans la page résultats de la classification des données, cliquez sur Configurer.
- Sélectionnez les catalogues que vous souhaitez activer, ou sélectionnez tous les catalogues disponibles dans l’espace de travail.
- Cliquez sur Activer.
L’activation de tous les catalogues disponibles n’active pas automatiquement les catalogues futurs. Pour classifier un nouveau catalogue, revenez à la boîte de dialogue Configurer et activez-le.
Activer un seul catalogue avec sélection de schéma
Pour déterminer quels schémas d’un catalogue sont analysés :
Accédez au catalogue, puis cliquez sur l’onglet Détails .
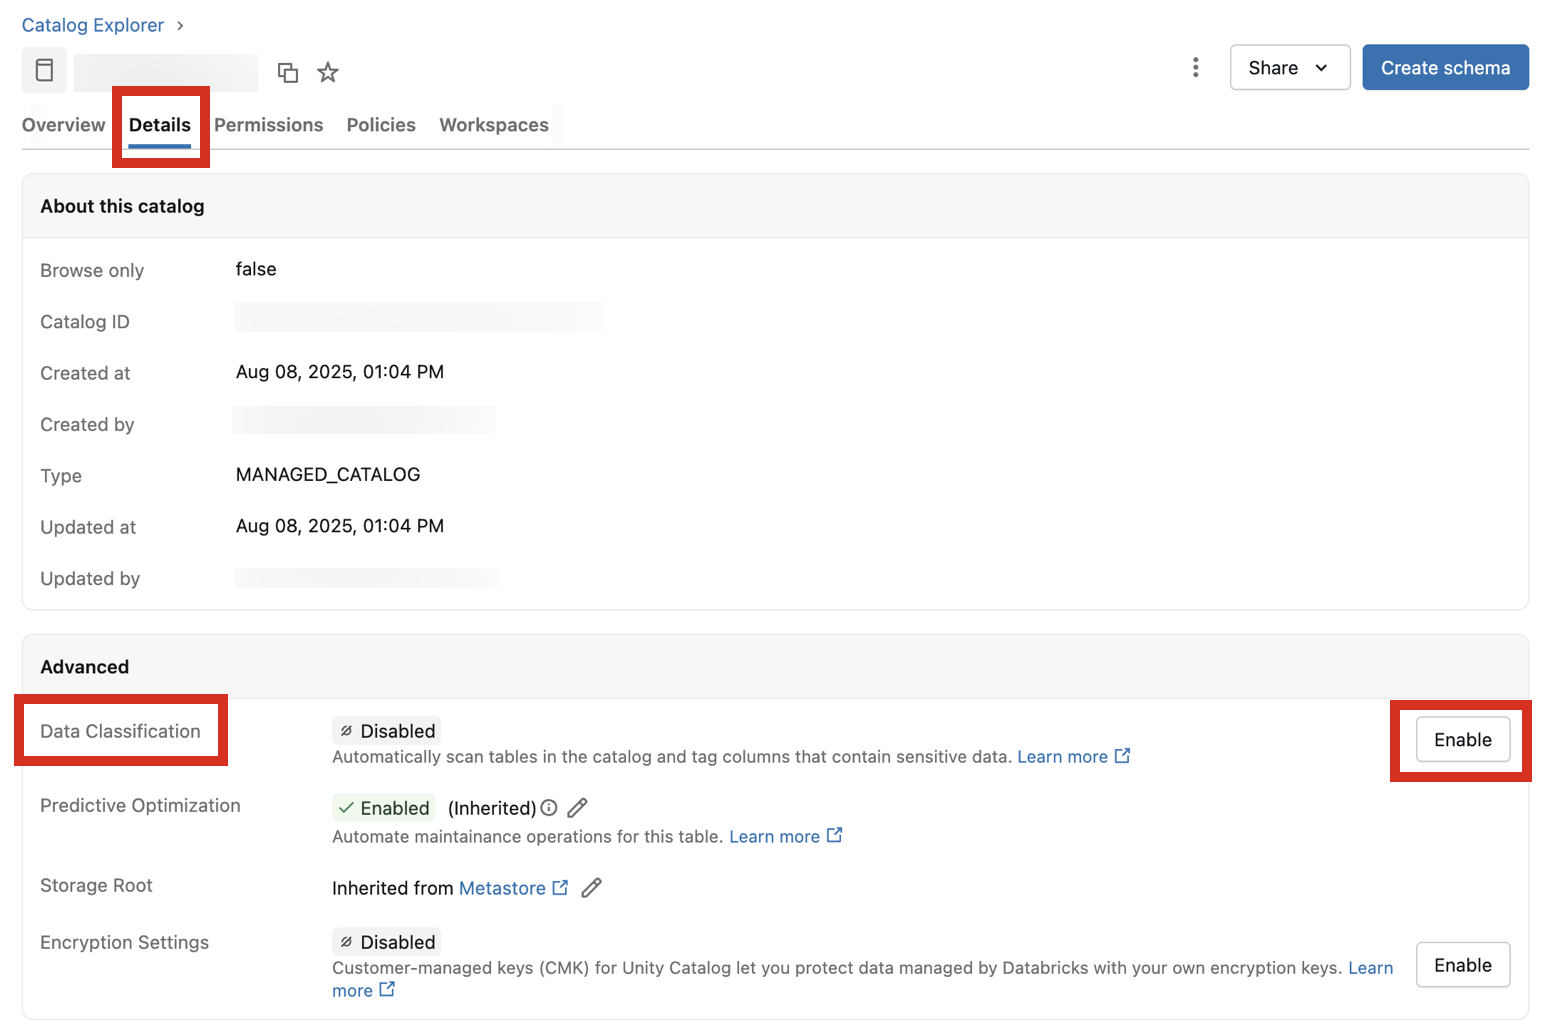
En regard de la classification des données, cliquez sur le bouton Activer .
La boîte de dialogue Classification des données s’affiche. Utilisez le menu déroulant Étendue du schéma pour choisir les schémas à analyser :
- Tous les schémas sélectionnés et futurs (par défaut) : analyse automatiquement les schémas existants et tous les nouveaux schémas créés à l’avenir. Décochez la case en regard de tout schéma existant que vous souhaitez exclure de l’analyse.
- Seuls les schémas sélectionnés : analyse uniquement les schémas que vous sélectionnez. Les nouveaux schémas ne sont pas analysés tant que vous ne les ajoutez pas à la liste.
Vous pouvez également sélectionner une stratégie d’utilisation.
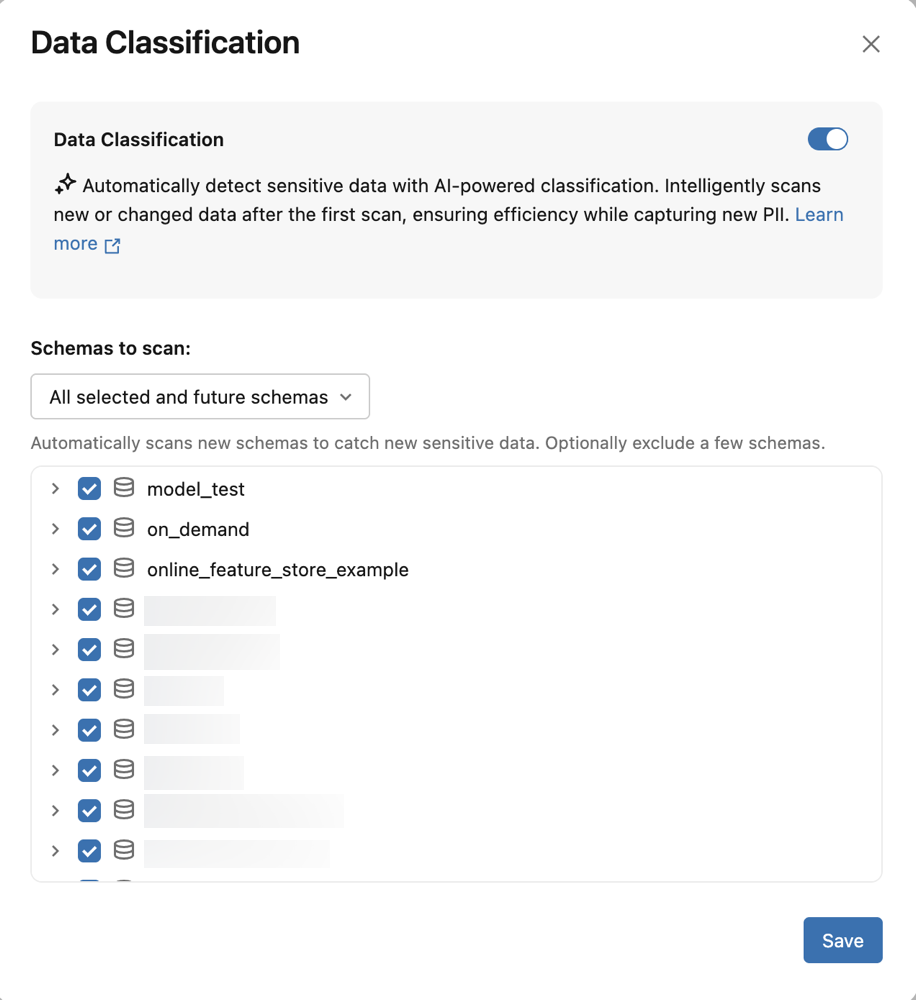
Cliquez sur Enregistrer.
Cela crée un travail en arrière-plan qui analyse de façon incrémentielle toutes les tables du catalogue ou des schémas sélectionnés.
Le moteur de classification s’appuie sur l’analyse intelligente pour déterminer quand analyser une table. Les nouvelles tables et colonnes d’un catalogue sont généralement analysées dans les 24 heures suivant la création.
Déclenchez manuellement un scan complet
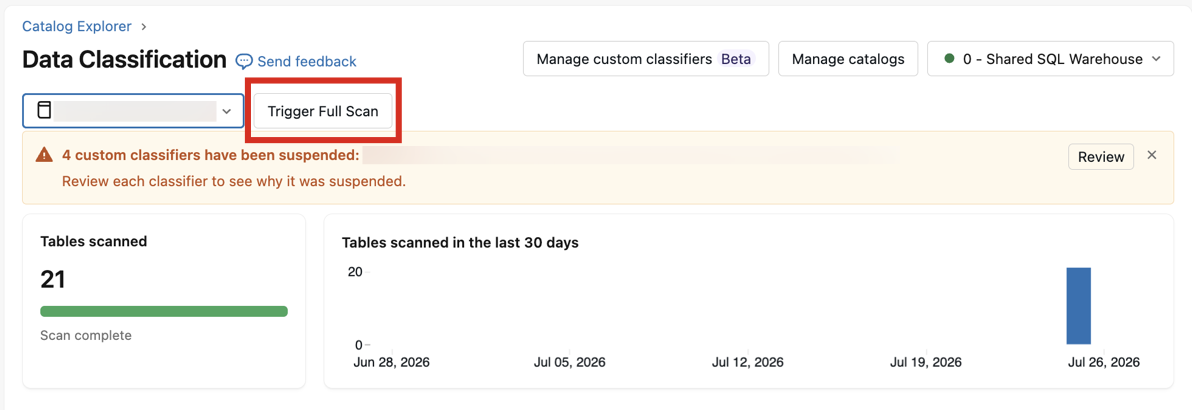
Après le scan initial, vous pouvez déclencher manuellement un scan complet à tout moment. Un balayage complet réévalue chaque table des schémas et catalogues où la classification des données est activée. Il ne scanne pas les schémas que vous avez exclus ou non sélectionnés. Le scan applique toutes les classes nouvellement configurées à vos données existantes et nouvelles, et engendre des coûts de calcul similaires à ceux du scan initial.
Pour déclencher un scan complet pour un catalogue :
Accédez au catalogue, puis cliquez sur l’onglet Détails .
À côté de Classification des données, cliquez sur Voir les résultats pour ouvrir l’interface de classification des données.
Par défaut, le catalogue est sélectionné comme périmètre. Cliquez sur Déclencher le scan complet.
Classifier les opinions
Important
Cette fonctionnalité est en version bêta. Pour l’utiliser, un administrateur d’espace de travail doit activer le Scan de la Vue de Classification des Données depuis la page des Aperçus . Consultez Gérer les préversions d’Azure Databricks.
Par défaut, la classification des données scanne les tableaux, les tables en streaming et les vues matérialisées. Lorsque le scan de la vue est activé, la classification des données analyse également les colonnes des vues régulières du catalogue Unity et y classe les données sensibles, en utilisant les mêmes détecteurs et classes qu’elle applique aux tables.
Consultez les résultats de classification qui apparaissent à côté de vos résultats de tableau, à la fois dans la page des résultats de la classification des données et dans la table du système des résultats.
Activer le balayage de la vue
Après qu’un administrateur d’espace de travail active l’aperçu, tous les catalogues avec la classification des données activée dans l’espace de travail incluent les vues de leur prochain balayage programmé.
Remarque
Activer la numérisation des vues augmente le coût de classification des données, car les vues sont numérisées en plus de vos tableaux. La taille de cette augmentation dépend du nombre de vues de vos catalogues et de leur taille et complexité. Databricks recommande de commencer par activer l’analyse des vues dans un espace de travail contenant des catalogues plus petits afin d’observer l’impact sur les coûts avant de l’activer plus largement. Afficher les coûts de classification des données.
Afficher les limitations de numérisation
- Les balises de classification ne sont pas appliquées par défaut aux colonnes de vue. Contrairement aux tableaux, les vues sont classifiées mais leurs colonnes ne sont pas étiquetées avec
class.*, car une balise de classification sur une vue peut entrer en conflit avec une politique existante de masque de colonne ou de filtre de ligne et rendre la vue non interrogable. Si ABAC on Views (Beta) est activé, l’auto-étiquetage des colonnes de vue est pris en charge. Dans tous les cas, vous obtenez les résultats complets de la classification sur la page des résultats et dans la table du système de résultats. - Les vues avec des définitions non sûres ne sont pas numérisées. Les vues dont les définitions utilisent des opérations non sûres, telles que les fonctions définies par l’utilisateur du métastore Hive héritées,
reflect(), etjava_method(), ne sont pas balayées. Ils sont signalés avec le statutUNSUPPORTED_VIEW_DEFINITION. - Les vues métriques ne sont pas balayées.Les vues métriques sont exclues du balayage des vues et n’apparaissent pas dans les résultats de classification des vues.
Afficher les résultats de la classification
Pour afficher les résultats de classification, cliquez sur Afficher les résultats en regard du paramètre Classification des données .
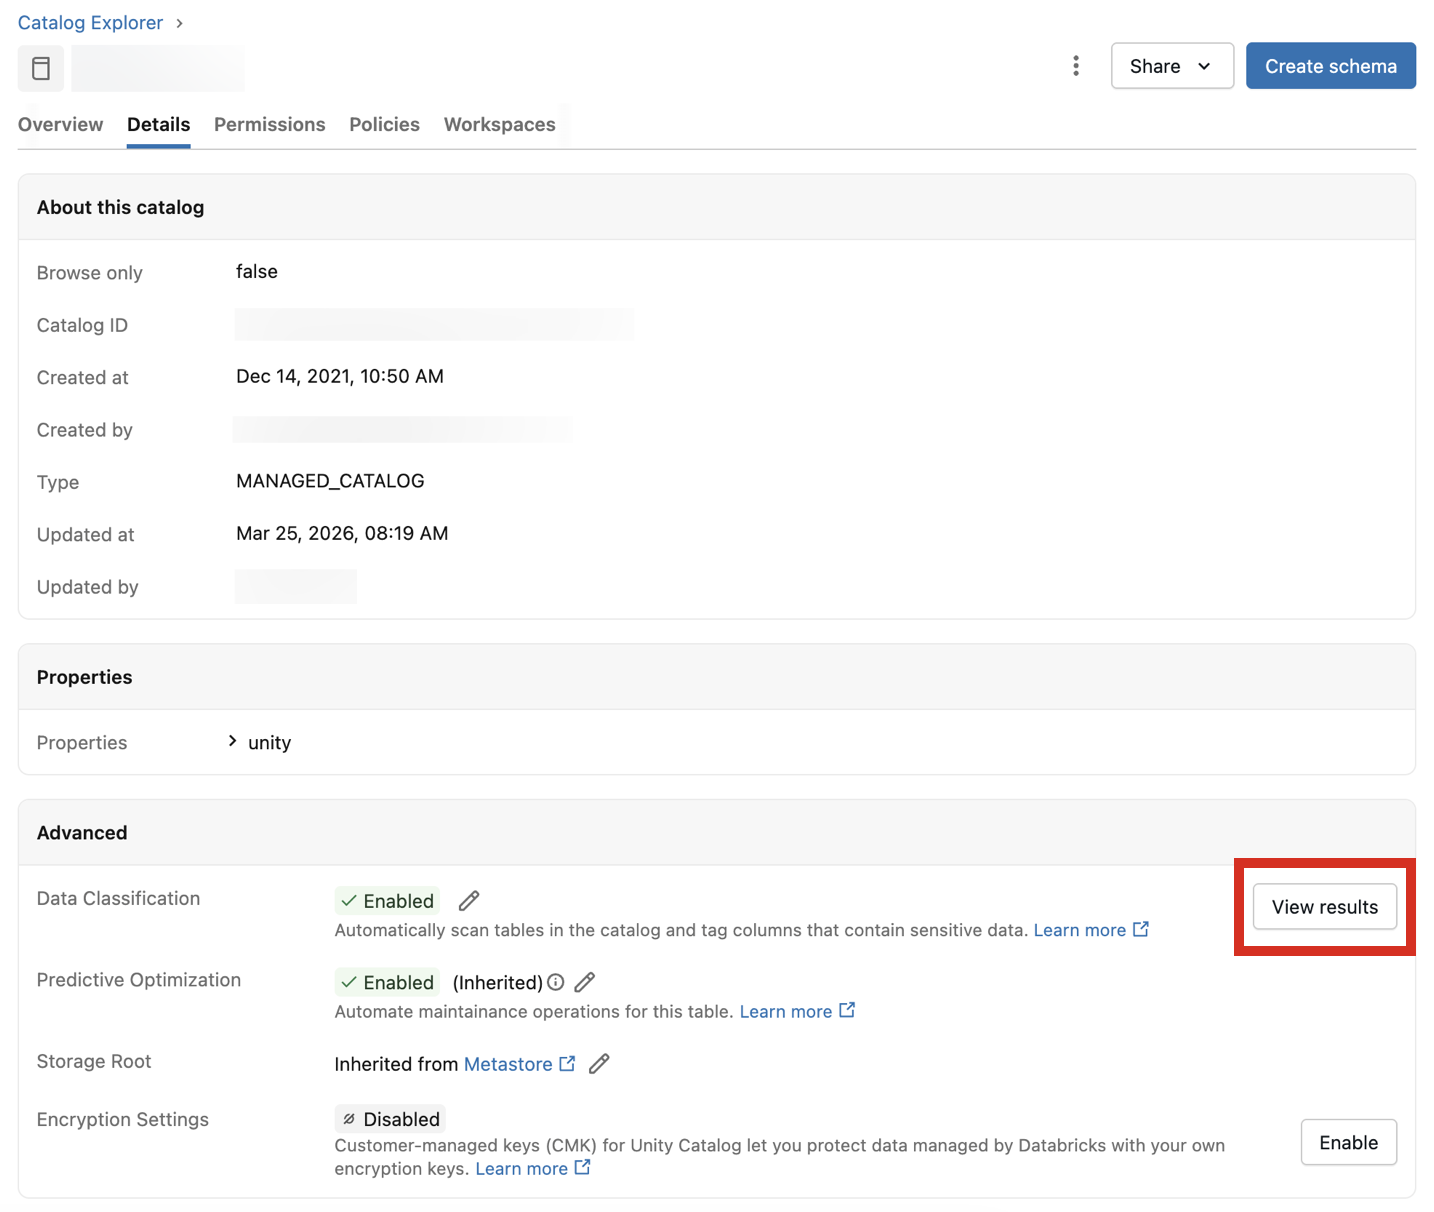
Cela ouvre l’interface utilisateur de classification des données pour le catalogue. Pour afficher les résultats de classification, un entrepôt SQL serverless est requis.
Vous pouvez également afficher les résultats agrégés dans tous les catalogues classés dans le metastore à l’aide du sélecteur de catalogue en haut à gauche. Choisissez tous les catalogues dans le menu déroulant.
Utilisez le filtre du cadre de conformité pour limiter les résultats aux classifications associées à un cadre de conformité spécifique.
Pour chaque type de classification, le tableau affiche :
- Colonnes détectées : nombre de colonnes où la classification a été détectée.
- Marquage automatique : état de marquage pour cette classification : actif ou inactif. Dans la vue metastore, un état partiellement actif indique que l’étiquetage est activé dans certains catalogues, mais pas tous les catalogues.
- Cadre de conformité : Les cadres de conformité associés à la classification. Pour plus de détails sur les classifications incluses dans chaque cadre, voir la référence du cadre de conformité.
- Accès utilisateur non masqué (derniers 7 jours) : Le pourcentage d’utilisateurs ayant accédé à des données non masquées de cette classification au cours des 7 derniers jours. Utilisez-la pour évaluer l’exposition des données sensibles au sein de votre organisation.
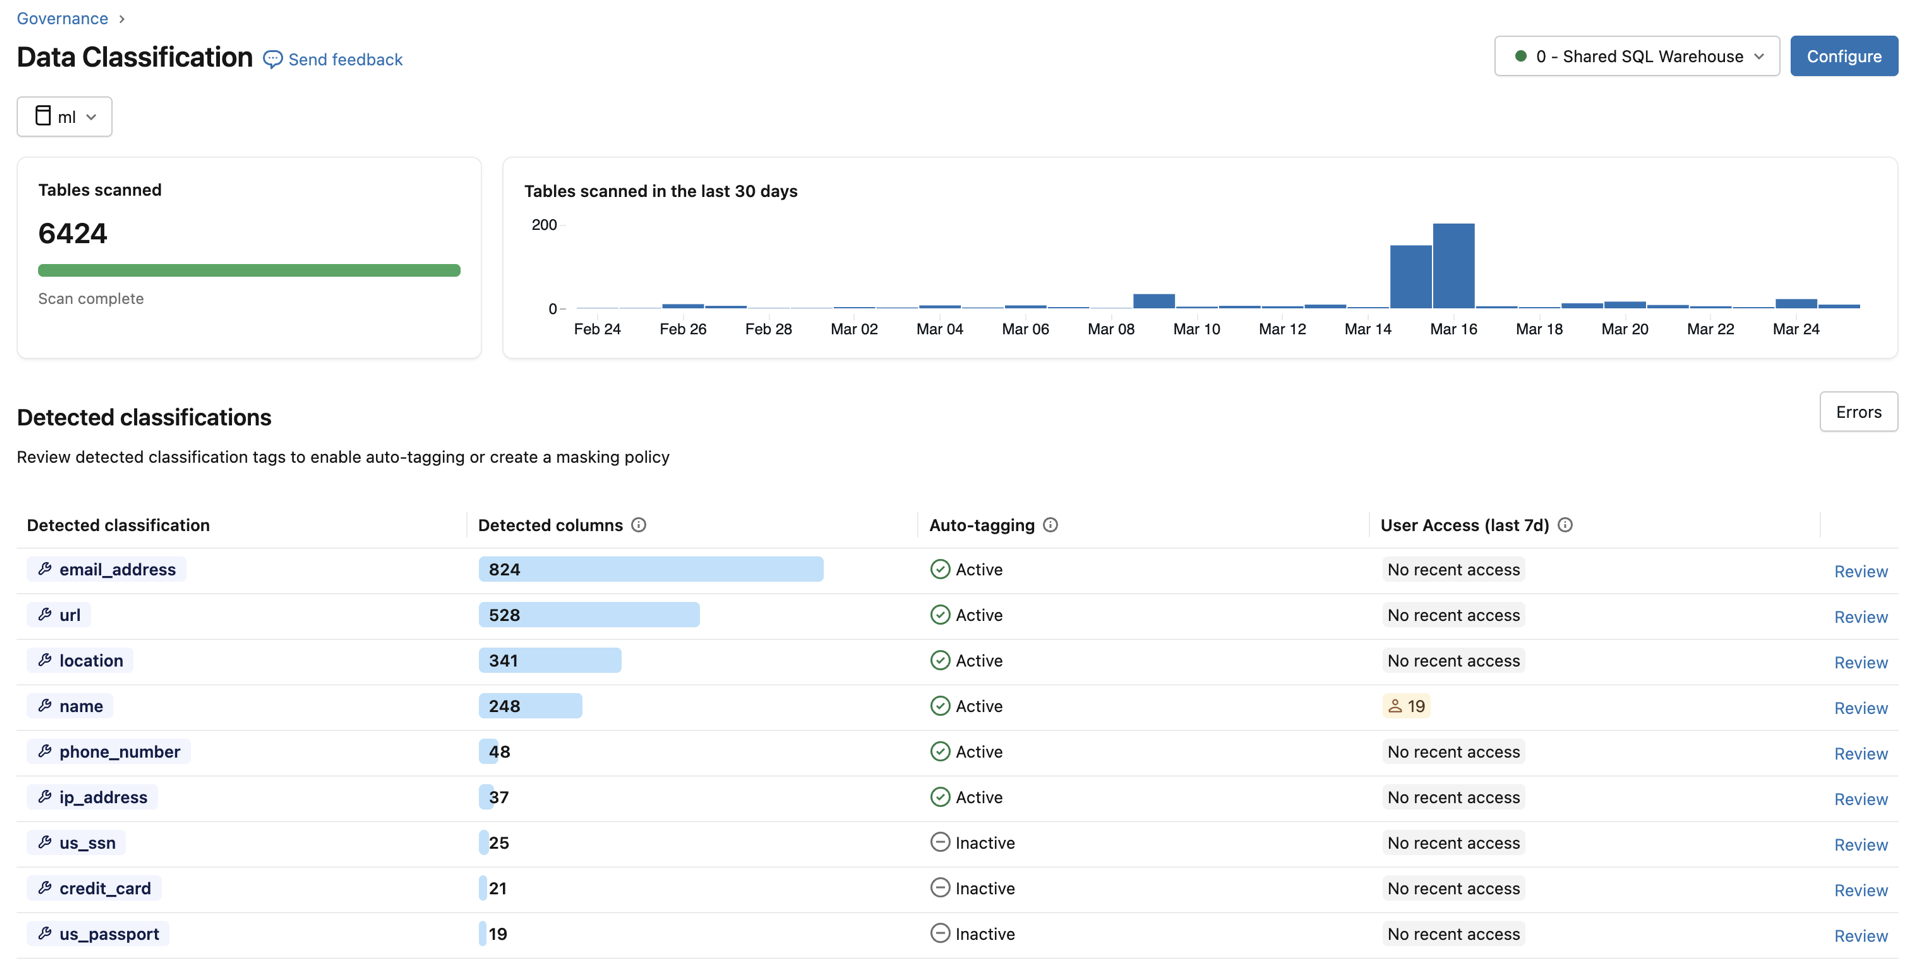
Passer en revue les détections
Pour passer en revue les résultats d’un type de classification spécifique, cliquez sur Vérifier dans la colonne la plus à droite. Un panneau s’affiche avec deux onglets :
- Colonnes détectées : affiche les colonnes dans lesquelles la balise de classification a été détectée avec une confiance élevée, classées par la détection la plus récente en premier. Inclut également un graphique détections au fil du temps et une liste de colonnes détectées avec des exemples de valeurs. Cliquez sur n’importe quelle barre dans le graphique pour afficher les détections spécifiques pour cette date. Les exemples de valeurs s’affichent uniquement si vous disposez des autorisations requises pour afficher les résultats de classification.
- Accès utilisateur : répertorie tous les utilisateurs qui ont accédé à des colonnes avec cette balise de classification, affichant leur e-mail et leur nom d’utilisateur, ainsi que s’ils ont masqué ou non l’accès. Affiche également toutes les stratégies de contrôle d’accès en fonction des attributs (ABAC) affectées à cette balise de classification. Lorsque vous affichez les résultats d’un seul catalogue, vous pouvez créer une politique ABAC directement à partir du panneau.
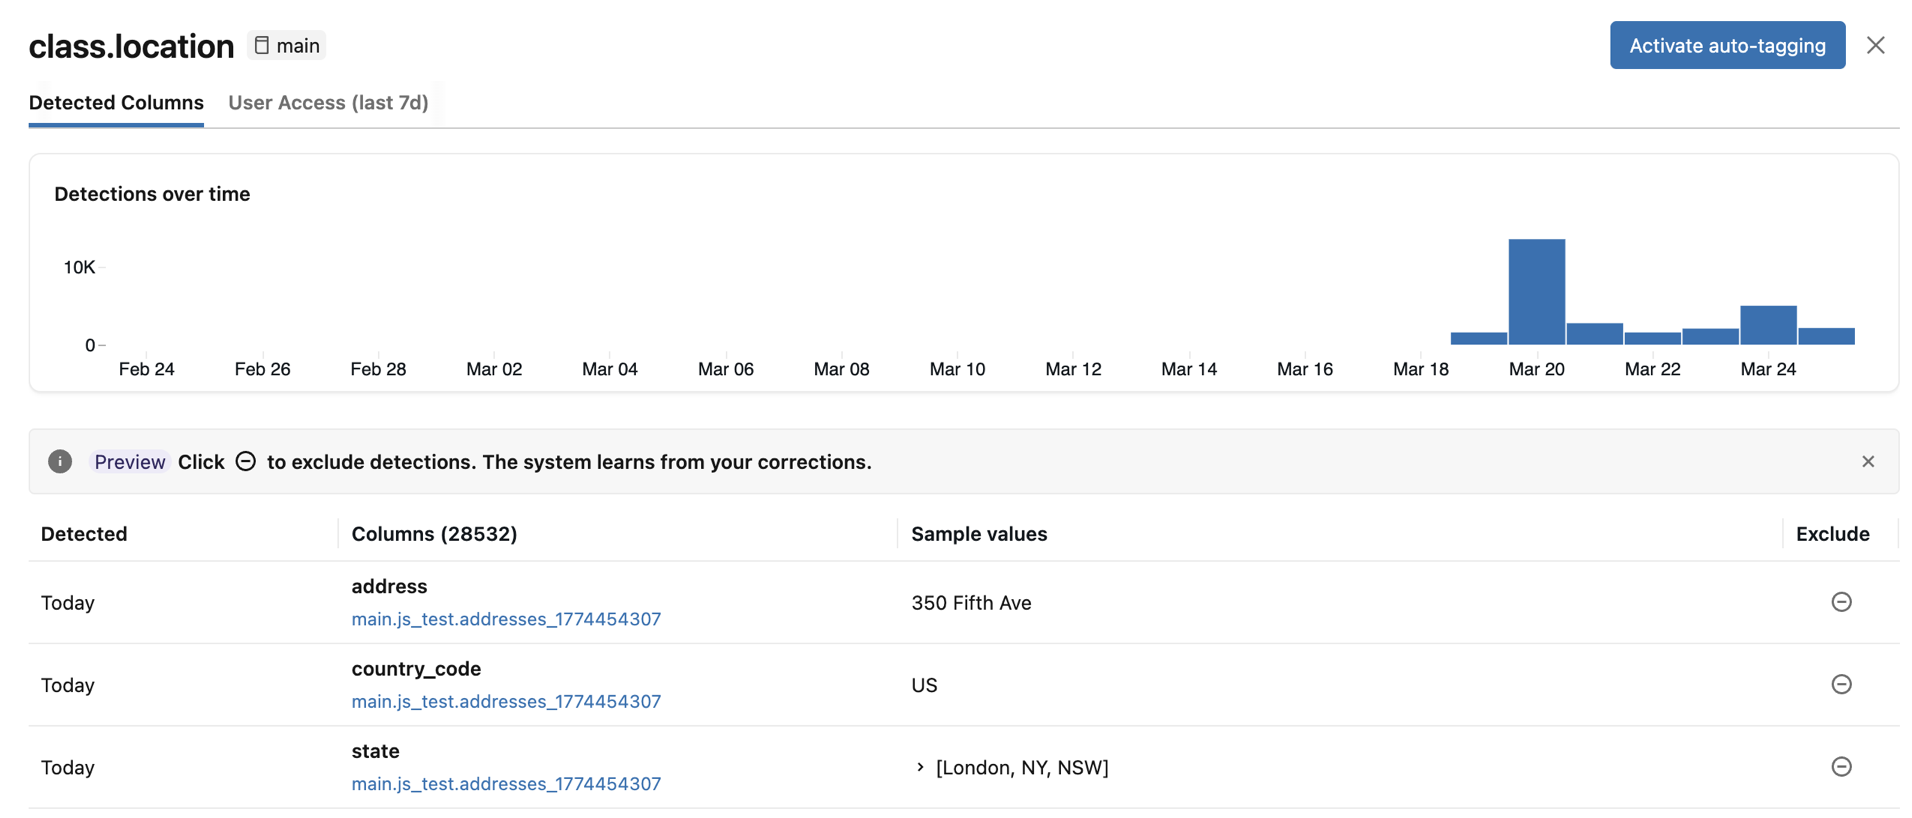
Si des colonnes détectées sont incorrectes, vous pouvez cliquer sur l’icône Exclure à droite de l’entrée. Voir Exclure les détections.
Activer l’étiquetage automatique
Si les colonnes identifiées correspondent à vos attentes, vous pouvez activer l’étiquetage automatique pour la balise de classification. Lorsque l’étiquetage automatique est activé, toutes les détections existantes et futures de cette classification sont marquées.
Vous pouvez configurer l’étiquetage automatique à deux niveaux :
-
Niveau du metastore : activez ou désactivez tous les catalogues en même temps. Vous devez être administrateur du métastore et disposer de l’autorisation
ASSIGNsur la balise à appliquer. -
Niveau du catalogue : activez ou désactivez uniquement le catalogue actuel. Les paramètres au niveau du catalogue sont prioritaires sur le paramètre au niveau du metastore. Vous devez avoir
USE CATALOGetAPPLY TAGsur le catalogue, etASSIGNsur la balise appliquée.
Au niveau du catalogue, l’étiquetage automatique a trois états :
- Valeur par défaut (héritée) : le catalogue hérite du paramètre d’étiquetage du niveau du metastore.
- Actif : l’étiquetage est explicitement activé pour ce catalogue, quel que soit le paramètre au niveau du metastore.
- Inactif : l’étiquetage est explicitement désactivé pour ce catalogue, quel que soit le paramètre au niveau du metastore.
Lorsque vous désactivez l’étiquetage, aucune étiquette future n’est appliquée, mais les balises existantes ne sont pas supprimées.
Remarque
Lorsque vous activez l’étiquetage automatique, les balises ne sont pas immédiatement remplies. Ils seront renseignés lors de l’analyse suivante, qui devrait prendre effet dans les 24 heures. Les classifications suivantes seront étiquetées immédiatement.
Exclure les détections
Important
Les exclusions de détection et leur utilisation pour améliorer la précision future de la classification sont en version bêta.
Dans le panneau de révision, vous pouvez exclure des détections de colonnes individuelles. Exclusion d’une détection :
- Supprime toute balise de classification existante de cette colonne.
- Empêche les analyses futures d’appliquer à nouveau la balise à cette colonne.
- Fournit des commentaires qui améliorent la précision des résultats futurs de classification.
Pour exclure une détection, cliquez sur l’icône Exclure pour la colonne correspondante dans le panneau de révision. Pour réinscrire la détection, cliquez à nouveau sur l’icône.
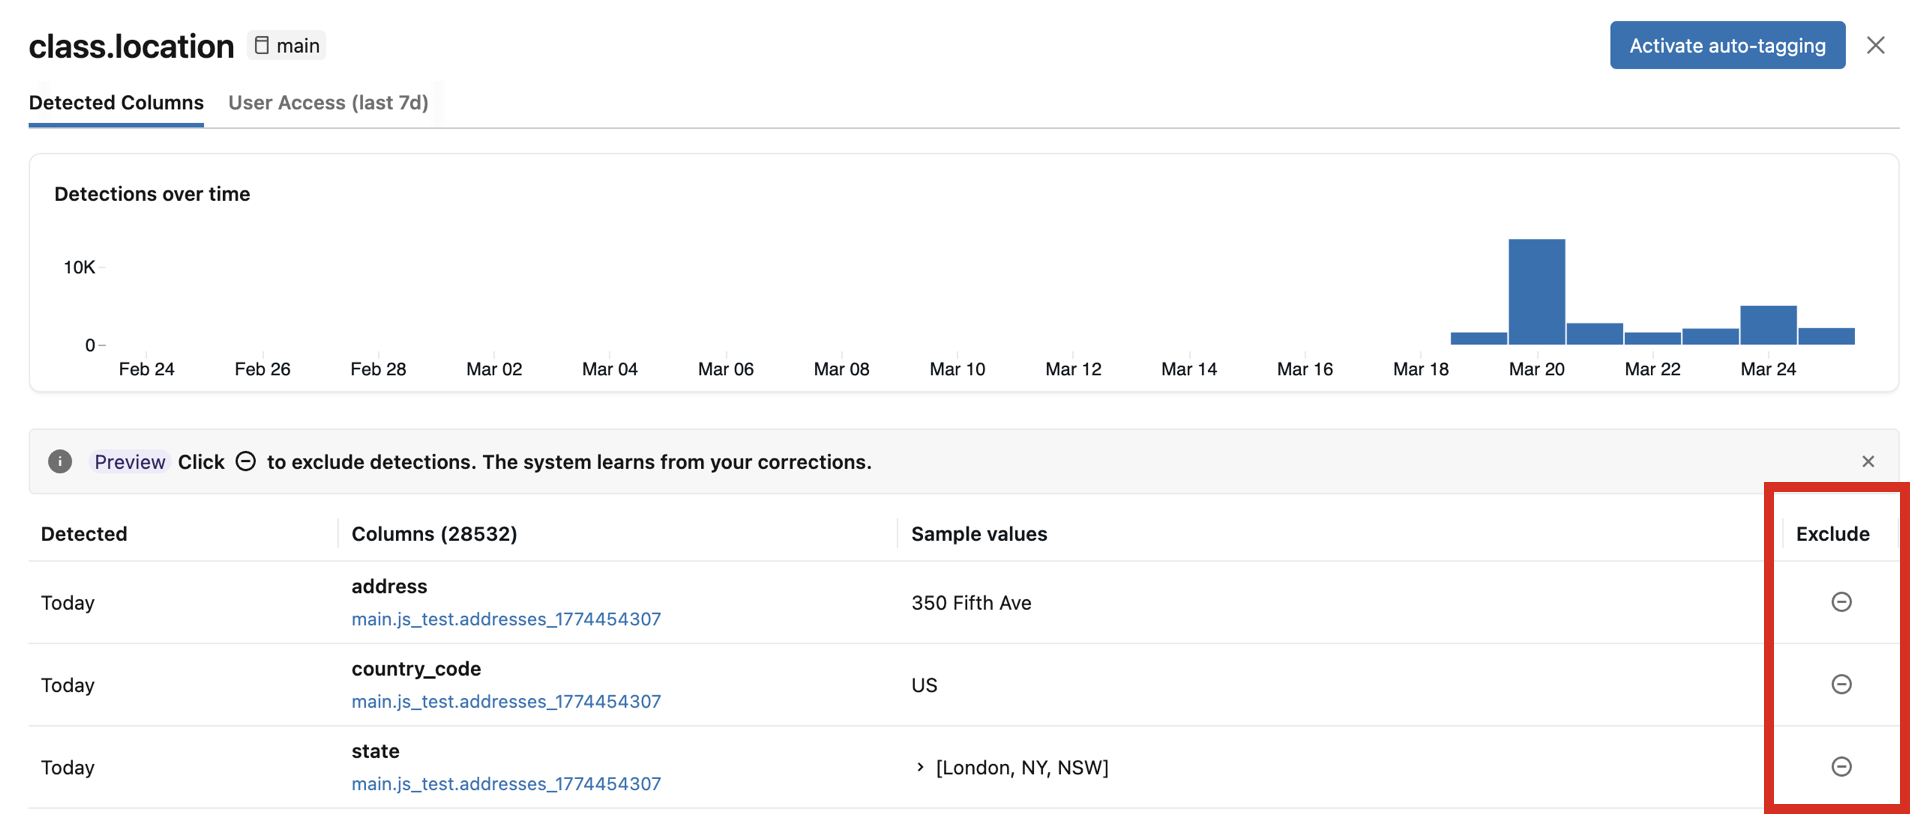
Table système des résultats
La classification des données crée une table système nommée system.data_classification.results pour stocker les résultats qui, par défaut, sont accessibles uniquement à l’administrateur du compte. L’administrateur de compte peut partager cette table. La table est accessible uniquement lorsque vous utilisez le calcul sans serveur. Pour plus d’informations sur ce tableau, consultez la référence de la table système de classification des données.
Important
La table de résultats system.data_classification.results contient tous les résultats de classification pour l'ensemble du métastore et inclut des valeurs d'exemple provenant des tables dans chaque catalogue. Vous devez uniquement partager cette table avec les utilisateurs qui sont privilégiés pour afficher les résultats de classification à l’échelle du metastore, y compris les exemples de valeurs.
Les utilisateurs ayant SELECT accès à ce tableau peuvent également voir des exemples de valeurs associées aux détections dans la page de résultats de classification des données.
Configurer des contrôles de gouvernance en fonction des résultats de classification des données
Masquer les données sensibles à l’aide d’une stratégie ABAC
Databricks recommande d’utiliser le contrôle d’accès basé sur les attributs dans le catalogue Unity pour créer des contrôles de gouvernance basés sur les résultats de classification des données.
Pour créer une stratégie à partir de la page résultats de la classification des données, cliquez sur Vérifier pour une balise de classification, ouvrez l’onglet Accès utilisateur , puis cliquez sur Nouvelle stratégie. Le formulaire de politique est prérempli pour masquer les colonnes dont la classification est en cours de révision. Pour masquer les données, spécifiez n’importe quelle fonction de masquage inscrite dans le catalogue Unity, puis cliquez sur Enregistrer.
Vous pouvez également créer une stratégie qui couvre plusieurs balises de classification, en modifiant quand la colonne répond à la condition et en fournissant plusieurs balises.
Par exemple, pour créer une stratégie appelée « Confidentiel » qui masque tout nom, e-mail ou numéro de téléphone, définissez la condition de réponse sur has_tag("class.name") OR has_tag("class.email_address") OR has_tag("class.phone_number").
Découverte et suppression du RGPD
Cet exemple de cahier montre comment utiliser la classification des données afin de faciliter l’identification et la suppression des données pour la conformité au RGPD.
Découverte et suppression RGPD à l’aide du notebook de classification des données
Obtenir un ordinateur portable
Comment gérer des balises incorrectes
Si une classification est incorrecte, excluez la détection du panneau de révision. L’exclusion d’une détection supprime la balise, l’empêche d’être réappliquée et améliore la précision des analyses futures. Voir Exclure les détections.
Erreurs de numérisation
Si des erreurs se produisent pendant l’analyse, un bouton Erreurs apparaît en haut à droite de la table de résultats.
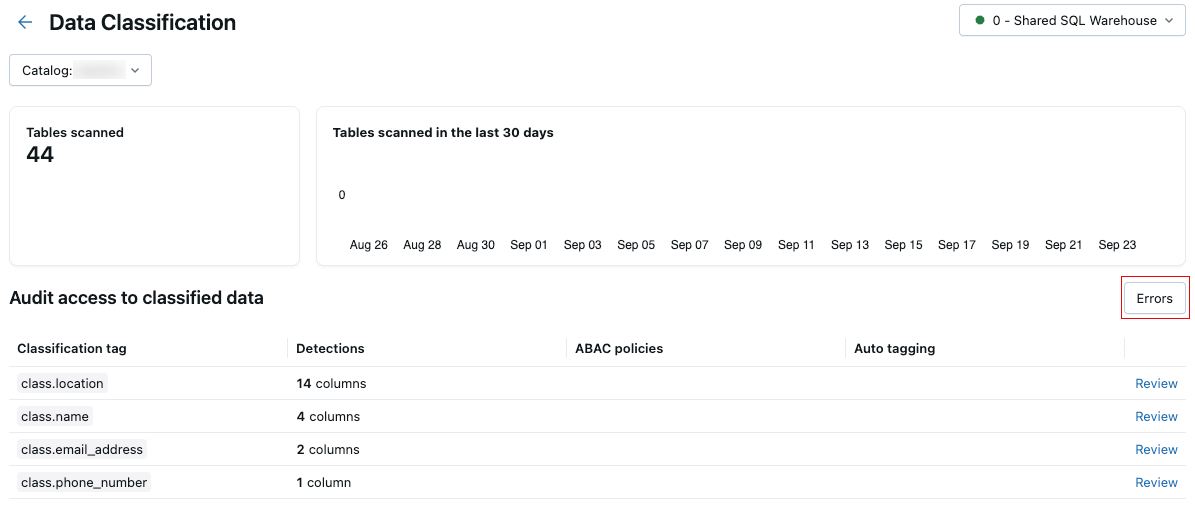
Cliquez sur le bouton pour afficher les tables qui ont échoué à l’analyse et aux messages d’erreur associés.
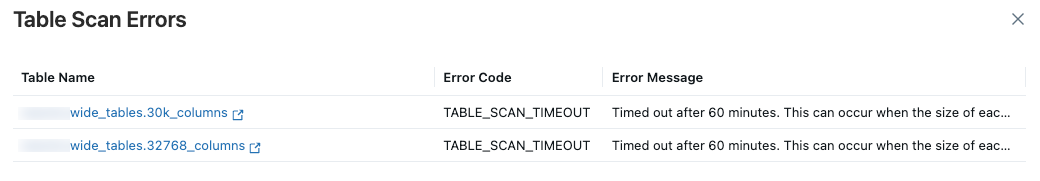
Par défaut, les échecs survenues pour des tables individuelles sont ignorés et réessayés le jour suivant.
Afficher les dépenses de classification des données
Pour comprendre comment la classification des données est facturée, consultez la page de tarification. Vous pouvez afficher les dépenses liées à la classification des données en exécutant une requête ou en affichant le tableau de bord d’utilisation.
Remarque
L’analyse initiale est plus coûteuse que les analyses suivantes sur le même catalogue, car ces analyses sont incrémentielles et entraînent généralement des coûts inférieurs.
Afficher l’utilisation à partir de la table système system.billing.usage
Vous pouvez interroger les dépenses de classification des données à partir de system.billing.usage. Les champs created_by et catalog_id peuvent être utilisés éventuellement pour décomposer les coûts :
-
created_by: inclure pour voir les coûts par l’utilisateur qui a déclenché l’utilisation. -
catalog_id: inclure pour afficher les coûts par catalogue. L’ID de catalogue est affiché dans lesystem.data_classification.resultstableau.
Exemple de requête pour les 30 derniers jours :
SELECT
   usage_date,
   identity_metadata.created_by,
   usage_metadata.catalog_id,
   SUM(usage_quantity) AS dbus
FROM
   system.billing.usage
WHERE
   usage_date >= DATE_SUB(CURRENT_DATE(), 30)
  AND billing_origin_product = 'DATA_CLASSIFICATION'
GROUP BY
   usage_date,
   created_by,
   catalog_id
ORDER BY
   usage_date DESC,
   created_by;
Pour calculer le coût total du dollar, joignez-vous à system.billing.list_prices. L’exemple de requête suivant utilise un paramètre nommé :add_on_rate en tant que multiplicateur sur le prix catalogue. Définissez-le sur 1 pour utiliser directement le prix de la liste, ou sur une valeur inférieure à 1 pour refléter une remise négociée (par exemple, 0.9 pour une remise de 10%).
Exemple de requête pour le coût total du dollar au cours des 30 derniers jours :
SELECT
  u.usage_date,
  SUM(u.usage_quantity * lp.pricing.effective_list.default) * :add_on_rate
    AS `Data Classification Dollar Cost`
FROM system.billing.usage AS u
JOIN system.billing.list_prices AS lp
  ON lp.sku_name = u.sku_name
WHERE
  u.billing_origin_product = 'DATA_CLASSIFICATION'
  AND u.usage_end_time >= lp.price_start_time
  AND (lp.price_end_time IS NULL OR u.usage_end_time < lp.price_end_time)
  AND u.usage_date >= DATE_ADD(CURRENT_DATE(), -30)
GROUP BY
  u.usage_date
ORDER BY
  u.usage_date DESC;
Afficher l’utilisation à partir du tableau de bord d’utilisation
Si vous disposez déjà d'un tableau de bord d'utilisation configuré dans votre espace de travail, vous pouvez l'utiliser pour filtrer l'utilisation en sélectionnant l'origine de facturation Project étiquetée « Classification des données ». Si vous n’avez pas configuré de tableau de bord d’utilisation, vous pouvez en importer un et appliquer le même filtrage. Pour plus d’informations, consultez Tableaux de bord Utilisation.
Balises de classification prises en charge
Pour obtenir la liste complète des balises prises en charge organisées par des étiquettes globales, des étiquettes régionales et des infrastructures de conformité (PII, PCI DSS, RGPD, HIPAA, GLBA, DPDPA et PIPEDA), consultez les balises de classification prises en charge.
Limites
- L’analyse des vues Unity Catalog est en version bêta ; consultez Classifier les vues. Les vues métriques et les vues avec des définitions dangereuses ne sont pas scannées.