Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Important
Cette fonctionnalité est disponible en préversion publique.
AI Runtime propose deux environnements Python gérés pour le calcul GPU serverless. L’environnement standard inclut cuda. À compter de la version 5 de l’environnement, torch et torchvision ne sont plus préinstallés. L’environnement IA Databricks est préchargé avec PyTorch, Transformers et d’autres frameworks de ML et d’apprentissage profond. Choisissez l’environnement Standard pour un contrôle total sur votre pile de dépendances ou l’environnement IA pour une configuration de formation prête à l’emploi. Vous pouvez partir de l’un ou l’autre environnement et installer vous-même d’autres paquets.
Tip
- Choisissez l’environnement Standard pour le contrôle total des dépendances, ou l’environnement IA Databricks pour une pile ML prête à l’emploi.
- La norme inclut
cuda. À partir de la version 5 de l’environnement,torchettorchvisionne sont pas préinstallés. L’environnement IA ajoute PyTorch, Transformers et bien d’autres. - Installez plus de packages avec
%uv pip install(environnement version 5 et ultérieure) ou%pip installdans un notebook, ou avecenvironment.dependenciesdans la ligne de commande.
Environnement à utiliser
AI Runtime offre deux environnements de Python managés, l’environnement Standard et l’environnement Databricks AI.
| Environnement | Caractéristiques clés | Quand utiliser |
|---|---|---|
| Environnement standard | Minimal ; comprend cuda. À compter de la version 5 de l’environnement, torch et torchvision ne sont plus préinstallés. |
Vous souhaitez un contrôle total sur votre pile de dépendances et préférez installer uniquement ce dont vous avez besoin |
| Environnement d’IA Databricks | Préchargé avec des frameworks ML populaires (PyTorch, Transformers, etc.) | Vous souhaitez un environnement complet pour l’apprentissage, l’optimisation et l’expérimentation sans gestion manuelle des dépendances |
Vous pouvez aussi utiliser un environnement de base d’espace de travail qu’un administrateur de workspace a créé pour l’exécution IA. Consultez Créer pour le calcul GPU sans serveur (AI Runtime).
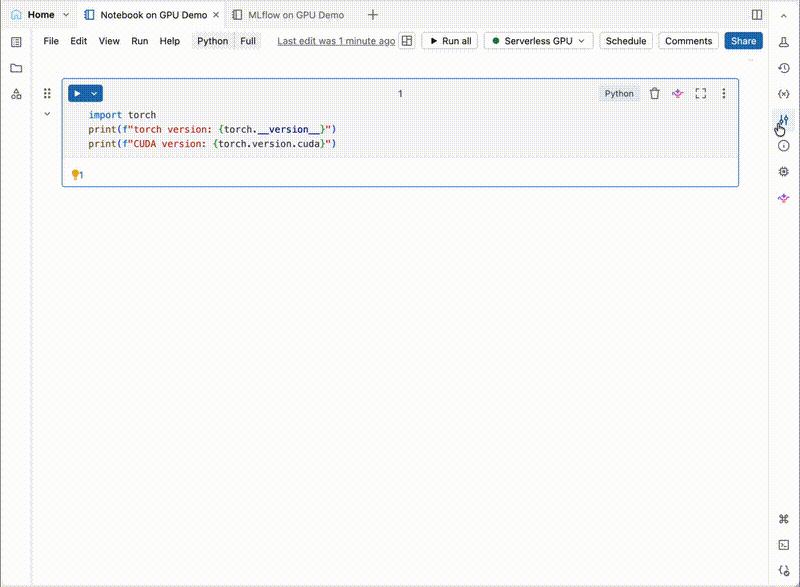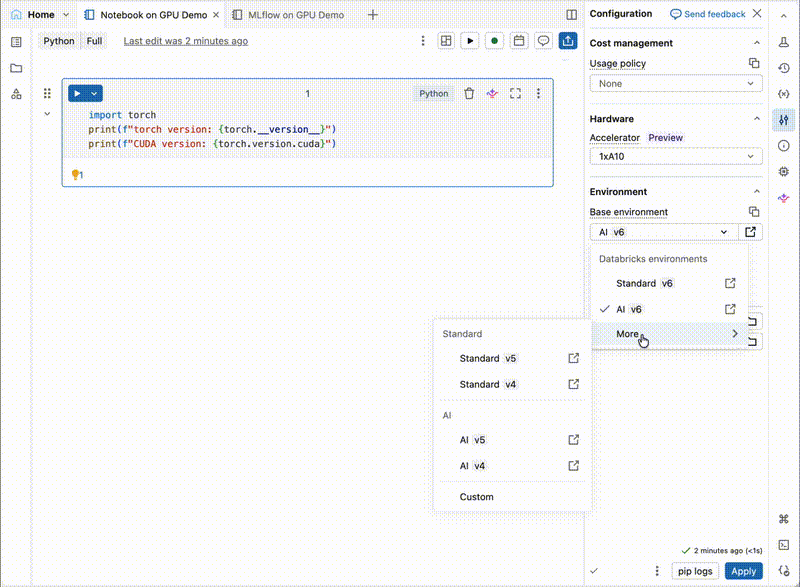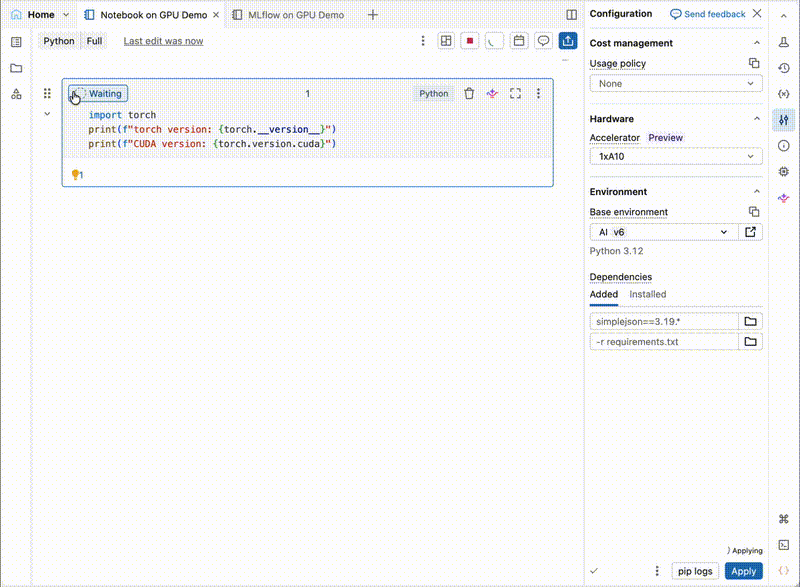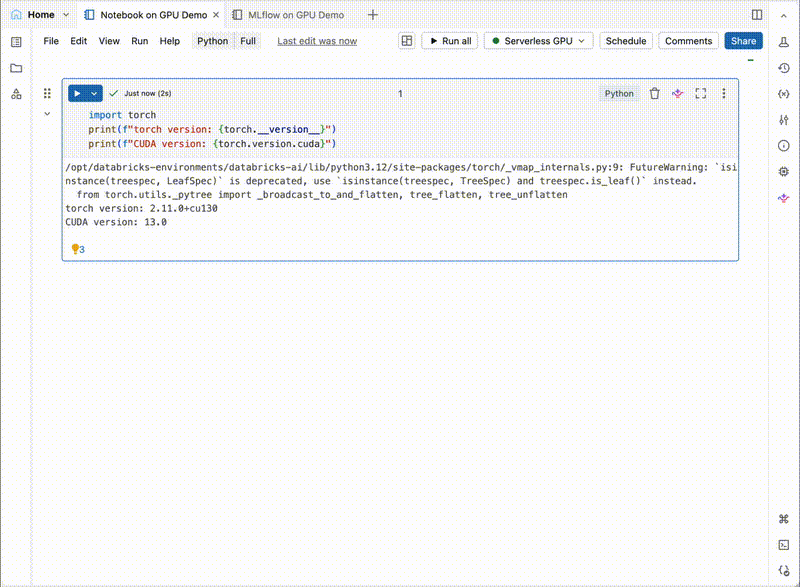
Pour choisir un environnement dans un carnet, ouvrez le panneau latéral Environnement et sélectionnez un environnement de base :
Environnement standard (environnement minimal)
Un environnement minimal et stable contenant uniquement les packages requis pour l’opération AI Runtime. L’environnement comprend la prise en charge du GPU via cuda. À compter de la version 5 de l’environnement, torch et torchvision ne sont plus préinstallés. Installez les versions dont votre charge de travail a besoin avec %uv pip install ou %pip install. Pour connaître les packages installés dans chaque version de l’environnement, consultez les notes de publication ci-dessous.
Idéal pour : les utilisateurs qui veulent contrôler entièrement leur pile de dépendances et préfèrent installer uniquement ce dont ils ont besoin.
Pour sélectionner : Dans le panneau latéral Environnement , choisissez Standard v6 comme environnement de base.
Pour plus d’informations sur les versions de package installées dans différentes versions, consultez les notes de publication :
Environnement d’IA Databricks
Disponible dans l’environnement 4 et versions ultérieures. L’environnement IA repose sur l’environnement Standard, avec des packages d’exécution courants et des packages spécifiques à l’apprentissage automatique pour les GPU. Les packages préinstallés sont les suivants :
- PyTorch (avec prise en charge de CUDA)
- Transformateurs (Hugging Face)
- Et d’autres dépendances ML/DL
Idéal pour : les praticiens ML qui souhaitent un environnement complet pour l'entraînement des charges de travail, le réglage fin et l’expérimentation sans gestion manuelle des dépendances.
Pour sélectionner : dans le panneau latéral Environnement , choisissez AI v6 comme environnement de base.
Pour plus d’informations sur les versions de package installées dans différentes versions, consultez les notes de publication :
Installer des paquets supplémentaires
Vous pouvez partir soit d’un environnement managé, soit d’un environnement de base workspace et installer vos propres paquets Python par-dessus. La façon dont vous les installez dépend de la façon dont vous vous connectez à l’exécution IA.
Dans un carnet
Installez des paquets au début de votre notebook ou de votre script d’entraînement avec %uv pip, qui s’installe avec uv et est plus rapide que %pip. Les versions à épingles pour que les runs restent reproductibles :
%uv pip install "trl==1.1.0"
%uv pip install "transformers==5.5.4"
Pour la référence complète sur %pip et %uv pip, y compris les versions d’environnement compatibles avec chacune d’elles, consultez Gérer les bibliothèques avec les commandes %uv.
Lorsque vous utilisez le @distributed décorateur pour des charges de travail multi-GPU, les packages que vous installez avant d’appeler .distributed() sont automatiquement instantanés et propagés à tous les processus distribués. La taille totale des packages installés ne doit pas dépasser 15 Go. Pour plus d’informations, consultez Ajouter des dépendances au notebook.
Avec le CLI
La air CLI utilise les mêmes environnements gérés. Sélectionnez-en un avec environment.version, puis listez les paquets à installer par-dessus sous environment.dependencies dans votre fichier YAML de charge de travail. La CLI les installe dans l’environnement sélectionné avec uv, vous n’avez donc pas à gérer vous-même un environnement virtuel séparé :
environment:
  version: '6'
  dependencies:
    - trl==1.1.0
    - transformers==5.5.4
Pour partir de l’environnement IA Databricks à la place, définissez version sur un identifiant d’environnement IA tel que databricks_ai_v5. Pour le format complet des dépendances, les indicateurs d’installation pris en charge et la prise en charge des images Docker personnalisées, voir Dépendances Python.
Environnements de base d’espace de travail
Un administrateur d’espace de travail peut créer un environnement de base d’espace de travail pour le calcul GPU serverless, ce qui le rend disponible pour tous les utilisateurs de l’espace de travail via le menu déroulant De l’environnement de base . Pour plus d’informations, consultez Créer pour le calcul GPU sans serveur (AI Runtime).
Pour utiliser un environnement de base dans une charge de travail planifiée, référencez-le par son identifiant dans le environments bloc d’un travail ou d’un bundle. Par exemple, cette tâche Declarative Automation Bundles sélectionne l’environnement d’IA Databricks :
resources:
  jobs:
    train:
      tasks:
        - task_key: train
          environment_key: default
      environments:
        - environment_key: default
          spec:
            base_environment: databricks_ai_v6
Pour un exemple complet de tâche, consultez Planifier avec l’API Jobs et les lots d’automatisation déclarative.
Mise en cache de l’environnement et modules personnalisés
Quand les environnements sont-ils mis en cache ?
AI Runtime met en cache l’environnement de votre ordinateur portable, donc lorsque vous le rouvrez, vous n’avez pas besoin de réinstaller les paquets. Pour plus de détails, voir Réinitialiser les dépendances de l’environnement.
La mise en cache s’applique aux carnets interactifs. Les charges de travail qui passent par la air CLI ou sont planifiées comme des tâches n’utilisent pas ce cache ; chaque exécution installe ses dépendances de nouveau.
Par bonne pratique, épinglez les packages vers une version spécifique afin que votre environnement en cache reste valide et que vos exécutions restent reproductibles.
Comment importer des modules personnalisés ?
Les étapes suivantes montrent comment utiliser vos propres modules Python.
- Synchronisez votre code avec l’espace de travail. Clonez un dépôt Git dans l’espace de travail avec un dossier Git, ou téléchargez les fichiers directement en fichiers d’espace de travail. Stockez le code partagé sous
/Workspace/Sharedpour les projets d’équipe, ou dans un dossier utilisateur pour le développement personnel. Garder le code dans un dossier Git le maintient contrôlé par version. -
Ajoutez le dossier à
sys.pathet importez-le en haut de votre carnet ou script d’entraînement :
import sys
sys.path.append("/Workspace/Shared/my-project/src")
from my_module import my_function
Limites
Les fonctionnalités suivantes ne sont pas disponibles sur AI Runtime :
- Fonctions Spark : vous ne pouvez pas importer ou utiliser directement des fonctions PySpark. AI Runtime est un environnement Python uniquement ; Spark n’est pas disponible en tant que runtime local. Toutefois, Spark Connect est disponible pour le chargement des données. Consultez Charger des données sur AI Runtime.
- Bibliothèques ML de Databricks Runtime : les paquets préinstallés ne remplacent pas Databricks Runtime ML. Certaines bibliothèques ML disponibles dans Databricks Runtime ML peuvent ne pas être préinstallées sur AI Runtime.
- Artefacts privés : AI Runtime prend en charge les artefacts privés dans certains cas. Pour plus d’informations, contactez l’équipe de votre compte.