Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
AI Runtime s’intègre à MLflow pour fournir des outils de suivi des expériences, d’observabilité et de débogage. MLflow offre un seul endroit pour les paramètres d’exécution, les métriques, les métriques du système GPU, les journaux et les artefacts, que vous développiez dans un notebook, que vous soumettiez une charge de travail avec la databricks air CLI ou que vous planifiiez une tâche.
Ce que propose MLflow
Une expérience MLflow regroupe les exécutions d’entraînement associées, et chaque exécution fournit un enregistrement persistant de la configuration et des résultats d’entraînement.
- Métriques et paramètres : Enregistrez la perte d’entraînement, les métriques d’évaluation, les taux d’apprentissage et les hyperparamètres, puis comparez-les entre les exécutions.
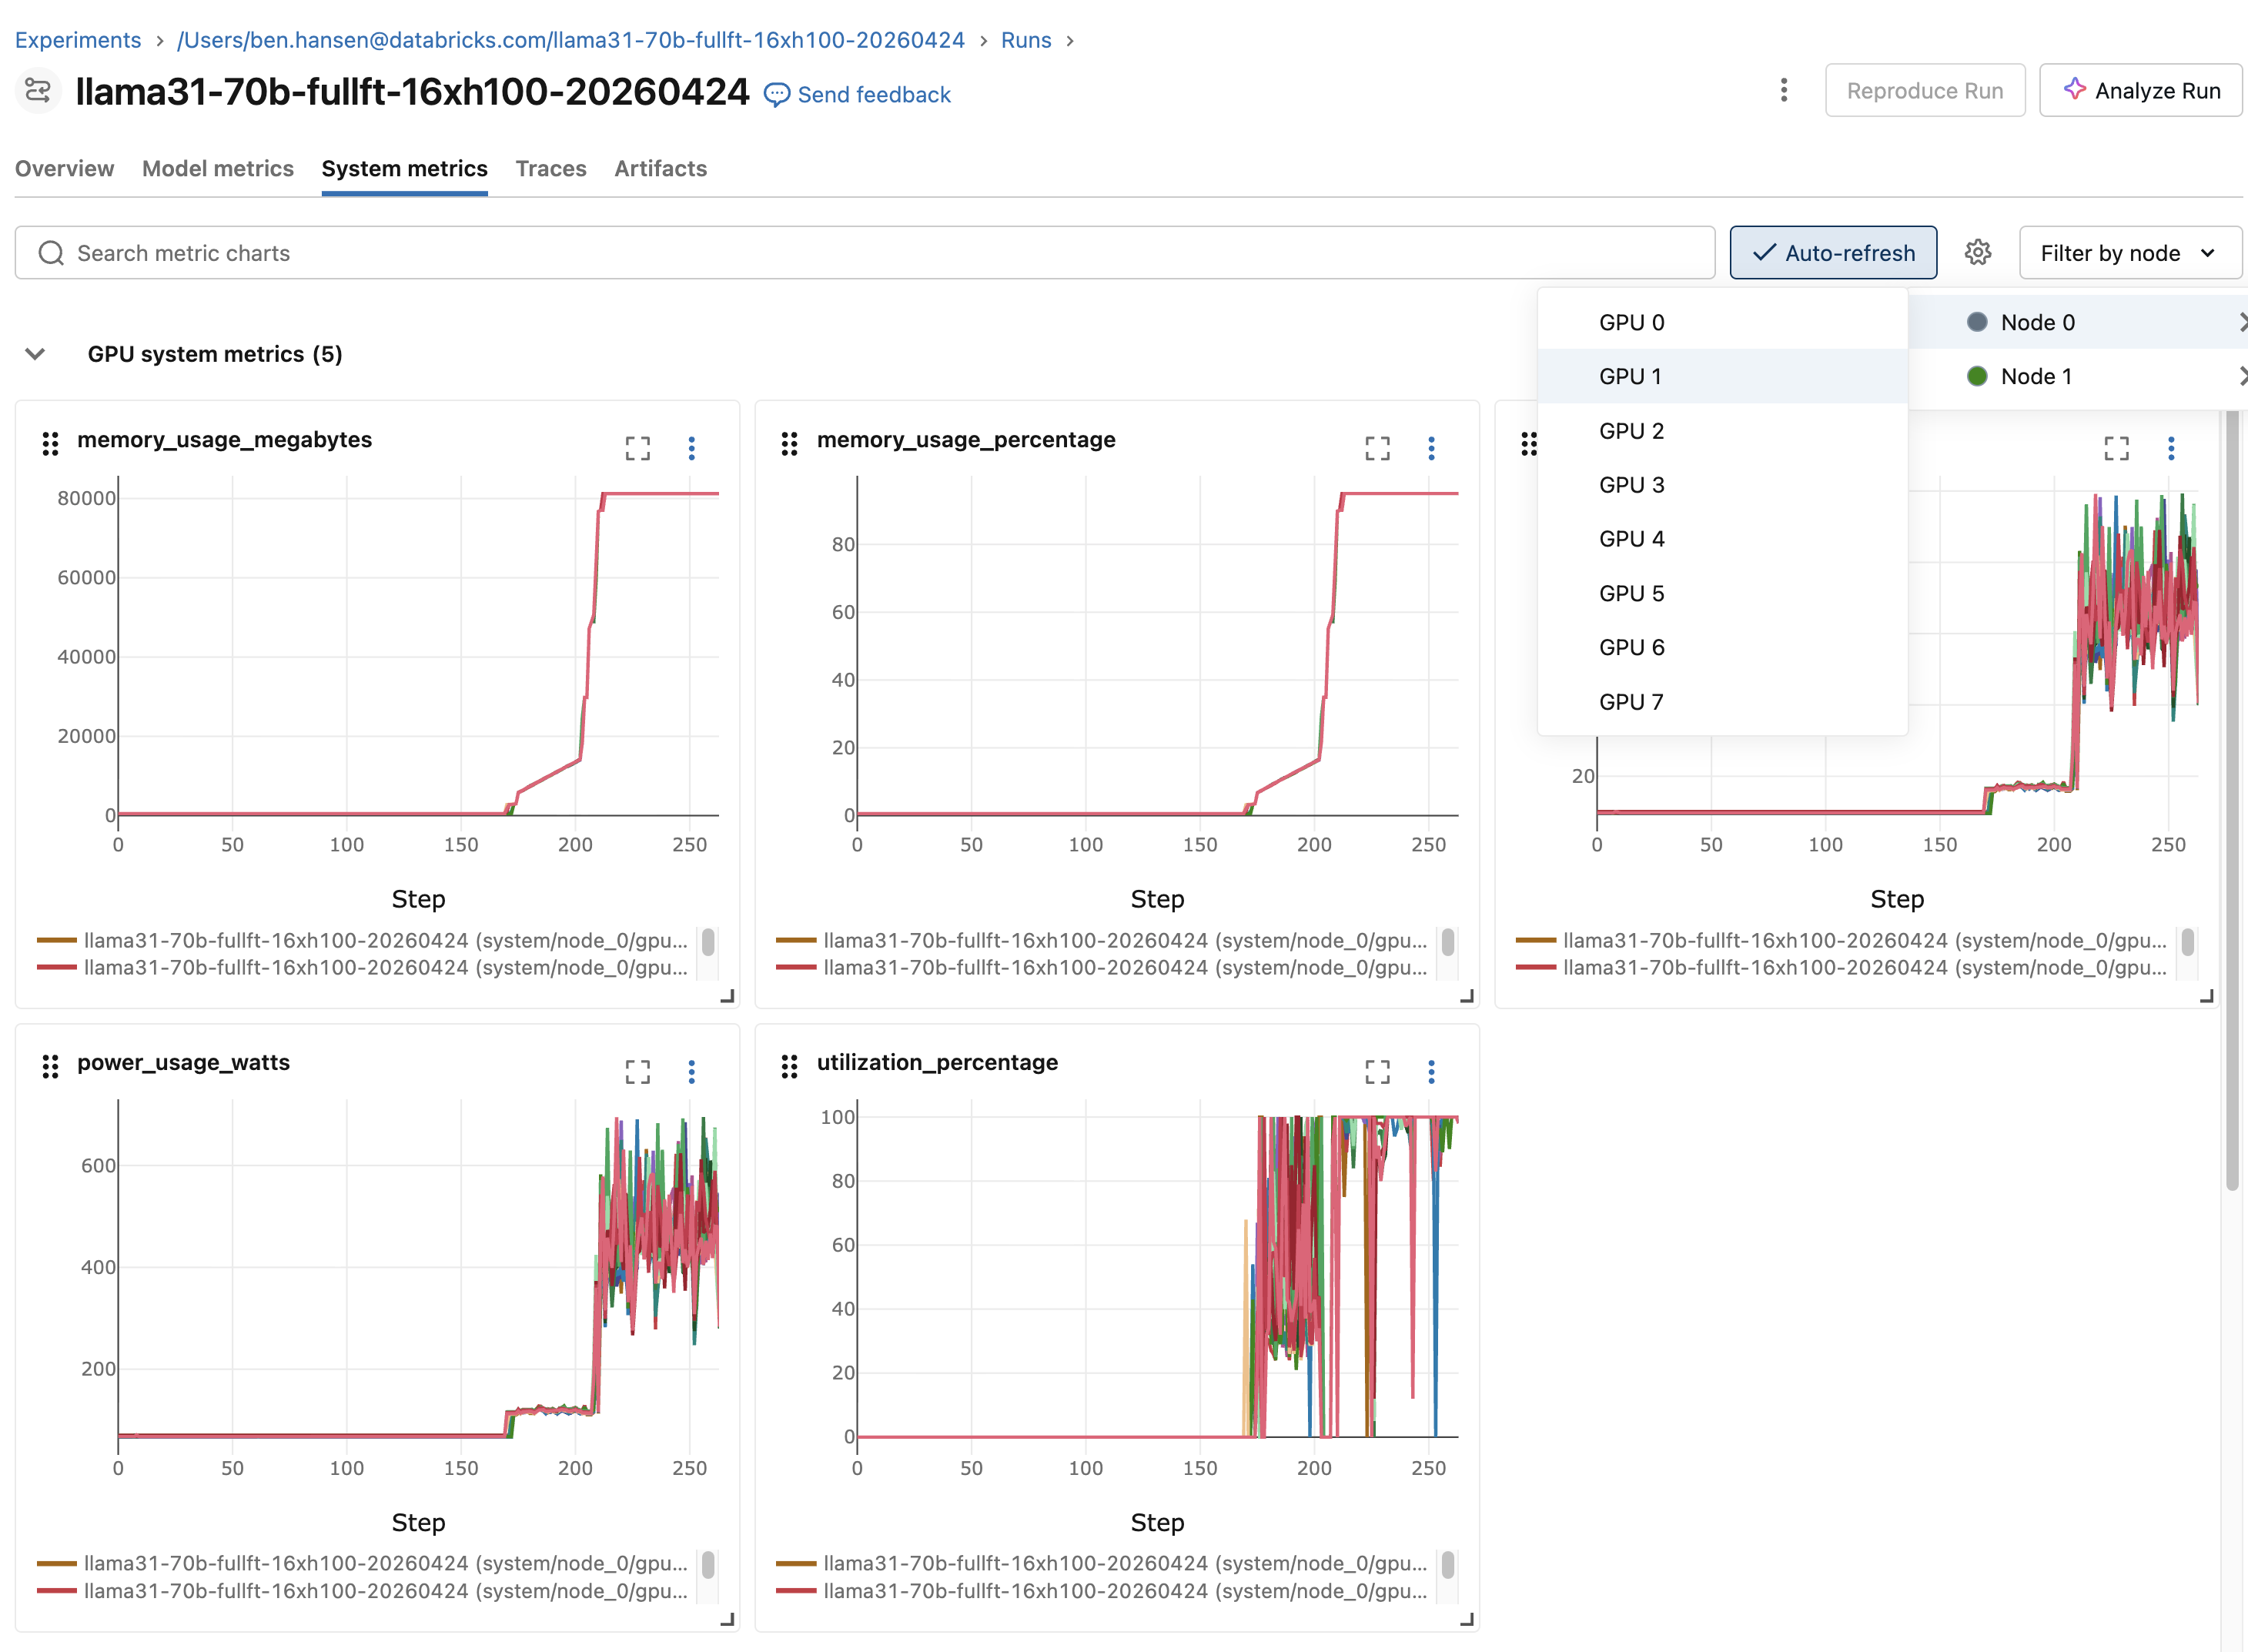
- Métriques système : Consultez l’utilisation du GPU, du CPU et de la mémoire pour les exécutions gérées dans l’onglet Métriques système .
- Vue des journaux : Voir la sortie du pilote pour une charge de travail adossée à un job dans l’onglet Journaux de l’exécution. Voir Voir les journaux dans l’onglet MLflow Logs.
- Artefacts et modèles : Stockez les fichiers de modèles, les configurations et autres sorties avec l’exécution. Utilisez un volume du catalogue Unity pour les artefacts volumineux ou durables.
- Partage et collaboration : Accordez l’accès à une expérience afin que d’autres utilisateurs de l’espace de travail puissent consulter et comparer ses exécutions. Consultez Organiser des exécutions de formation avec des expériences MLflow.
- Intégrations de frameworks : Utilisez les intégrations MLflow avec Hugging Face Transformers, PyTorch Lightning et autres bibliothèques prises en charge.
Pour les charges de travail adossées à des jobs, telles que les charges soumises avec databricks air run, l’exécution du job Azure Databricks complète MLflow en enregistrant l’état d’exécution, les ressources de calcul, les tentatives et la sortie du driver.
Comment les runs MLflow sont créés
La façon dont vous démarrez ou rejoignez une exécution MLflow dépend de la manière dont vous commencez la charge de travail :
| Comment exécuter la charge de travail | Comment démarre une exécution MLflow | Comment sélectionner l’expérience |
|---|---|---|
Databricks CLI (databricks air run) |
Chaque tentative crée automatiquement une exécution. | Définissez experiment_name dans le fichier YAML de charge de travail. |
Notebook avec le SDK Databricks AI Runtime (.distributed()) |
Chaque appel crée automatiquement une exécution. | Appelez mlflow.set_experiment() avant .distributed(), ou définissez MLFLOW_EXPERIMENT_NAME. |
| Le code s’exécute directement dans un notebook associé | Aucune exécution n’est créée automatiquement. Utilisez mlflow.start_run() ou l’autologging. |
Appelez mlflow.set_experiment() dans le notebook. |
Planifié ai_runtime_task |
La tâche crée automatiquement un run. | Définissez experiment dans la configuration de la tâche. Voir tâche AI Runtime. |
Après que votre code a démarré ou rejoint le bon run, utilisez l’API de suivi MLflow pour enregistrer des données d’entraînement personnalisées. Pour les frameworks pris en charge, vous pouvez utiliser l’autologging au lieu d’ajouter des appels de journalisation individuels. Pour les schémas de Deep Learning, voir le flux de travail MLflow 3 en Deep Learning.
Utilisez les pratiques suivantes lorsque vous configurez le suivi MLflow :
- Réglez
stepsur une valeur significative telle que le lot global ou l’époque. Consignez à intervalles réguliers au lieu de le faire pour chaque batch. MLflow limite le nombre d’étapes métriques par exécution. Consultez l’article Limites des ressources. - Pour l’entraînement distribué, enregistrez une métrique à partir du rang 0 uniquement afin que chaque valeur soit enregistrée une seule fois.
- Pour les flux de travail de notebook, utilisez des chemins d’expérimentation absolus, tels que
/Users/<username>/my-experimentou/Workspace/Shared/<team>/my-experiment. Mettez les expériences que vous souhaitez partager dans un dossier d’espace de travail partagé. - Stockez de grands points de contrôle durables dans un volume du catalogue Unity. Pour les modèles de checkpointing, voir Améliorer les performances et la résilience de l’entraînement dans AI Runtime.
Note
Utilisez MLflow 3.7 et supérieur pour les exemples de cette page.
Suivre les charges de travail de Databricks CLI
Lorsque vous soumettez une charge de travail avec databricks air run, AI Runtime crée une exécution de job Azure Databricks pour les détails d’exécution et une exécution MLflow pour les données d’expérimentation. La soumission originale et ses essais partagent une exécution de travail, tandis que chaque tentative crée une exécution MLflow distincte dans la même expérimentation afin que vous puissiez comparer les tentatives.
Les métriques GPU, CPU et système mémoire sont capturées automatiquement pour chaque exécution gérée et apparaissent dans l’onglet des métriques du système MLflow.
Configurez et consignez dans l’exécution
Utilisez le workload YAML pour sélectionner l’expérience et configurez éventuellement le nom de l’exécution et l’emplacement de l’artefact. L’exemple suivant montre les champs MLflow nécessaires :
experiment_name: my-training
mlflow_run_name: baseline-lr3e5
mlflow_artifact_location: /Volumes/main/default/mlflow-artifacts/my-training
Pour les exigences des champs, les valeurs par défaut et les valeurs prises en charge, voir référence Workload YAML.
L’exécution IA expose l’ID d’exécution gérée via MLFLOW_RUN_ID. Pour enregistrer vos propres paramètres, métriques et artefacts dans cette exécution, rouvrez-la avec l’API de suivi MLflow :
import os

import mlflow

# Log from rank 0 only because all nodes share the same MLFLOW_RUN_ID.
if os.environ.get("RANK", "0") == "0":
    with mlflow.start_run(run_id=os.environ["MLFLOW_RUN_ID"]):
        mlflow.log_param("learning_rate", 3e-4)
        for step, loss in enumerate(training_losses):
            mlflow.log_metric("train_loss", loss, step=step)
Trouvez les exécutions et les journaux d'activité
Les journaux sont disponibles à la fois via la CLI Databricks et la page d’exécution MLflow. Utilisez les commandes suivantes pour trouver les charges de travail, inspecter une charge de travail et diffuser ou télécharger des journaux :
databricks air list --all-status
databricks air get <job-run-id>
databricks air logs <job-run-id>
databricks air logs <job-run-id> --node 2
databricks air logs <job-run-id> --download-to ./logs/
Suivre les charges de travail des notebooks
Depuis un notebook, vous pouvez exécuter du code directement dans la session jointe ou lancer un entraînement distribué via le décorateur @distributed du SDK Databricks AI Runtime.
Exécutez du code directement dans un notebook
Le code exécuté directement dans un notebook attaché ne crée pas automatiquement un run MLflow. Sélectionnez une expérience, puis lancez une exécution ou activez l’auto-enregistrement :
import mlflow

mlflow.set_experiment("/Users/<username>/my-experiment")

with mlflow.start_run(run_name="baseline"):
    train()
Pour activer l’autologging de PyTorch Lightning, utilisez le motif suivant :
mlflow.pytorch.autolog()

with mlflow.start_run(run_name="lightning-baseline"):
    trainer.fit(model, datamodule=datamodule)
Pour Hugging Face Transformers, configurez TrainingArguments comme suit :
from transformers import TrainingArguments

args = TrainingArguments(
    output_dir="/Volumes/<catalog>/<schema>/<volume>/checkpoints",
    report_to="mlflow",
    run_name="llama7b-sft-lr3e5",
    logging_steps=50,
)
Utilisez le SDK Databricks AI Runtime
Pour l’entraînement distribué depuis un notebook, utilisez le @distributed décorateur du SDK Databricks AI Runtime (databricks-sdk-air). Le SDK est disponible dans l’espace de noms databricks.air de l’environnement GPU versions 6 et ultérieures, ou comme serverless_gpu dans l’environnement GPU versions 5 et antérieures.
from databricks.air import distributed

@distributed()
def train():
    # Training code
    ...

train.distributed()
Chaque appel .distributed() crée automatiquement un run MLflow. L’expérience par défaut est /Users/{WORKSPACE_USER}/{notebook-name}. Pour sélectionner une autre expérience, définissez-la avant d’appeler .distributed():
mlflow.set_experiment("/Users/<username>/my-experiment")
train.distributed()
Lorsque vous appelez .distributed() à l’intérieur d’une exécution active, AI Runtime crée une exécution enfant imbriquée :
with mlflow.start_run() as parent_run:
    train.distributed()
Pour reprendre une exécution précédente, définissez MLFLOW_RUN_ID avant .distributed():
import os

os.environ["MLFLOW_RUN_ID"] = "<previous-run-id>"
train.distributed()
Utilisez le lien d’exécution dans la sortie de la cellule ou le panneau Experiment du notebook pour ouvrir la run MLflow.
Voir les logs
- Sortie du notebook : La sortie standard et les erreurs issues du code d’entraînement apparaissent dans la sortie de la cellule du notebook.
-
Journaux MLflow : Pour les charges de travail des notebooks supportées par des tâches telles que
.distributed(remote=True)appels, l’onglet Journaux d'activité MLflow affiche la sortie de l’exécution de la tâche associée.
Surveillez les ressources GPU en temps réel
Le panneau des ressources GPU du notebook affiche l’utilisation en temps réel, la mémoire et la température pour les charges de travail à nœud unique et multinœud. Utilisez l’onglet métriques du système MLflow lorsque vous avez besoin d’un enregistrement persistant lié à une exécution.
Pour ouvrir le volet, connectez le notebook à AI Runtime, puis cliquez sur  Ressources GPU dans le panneau latéral droit.
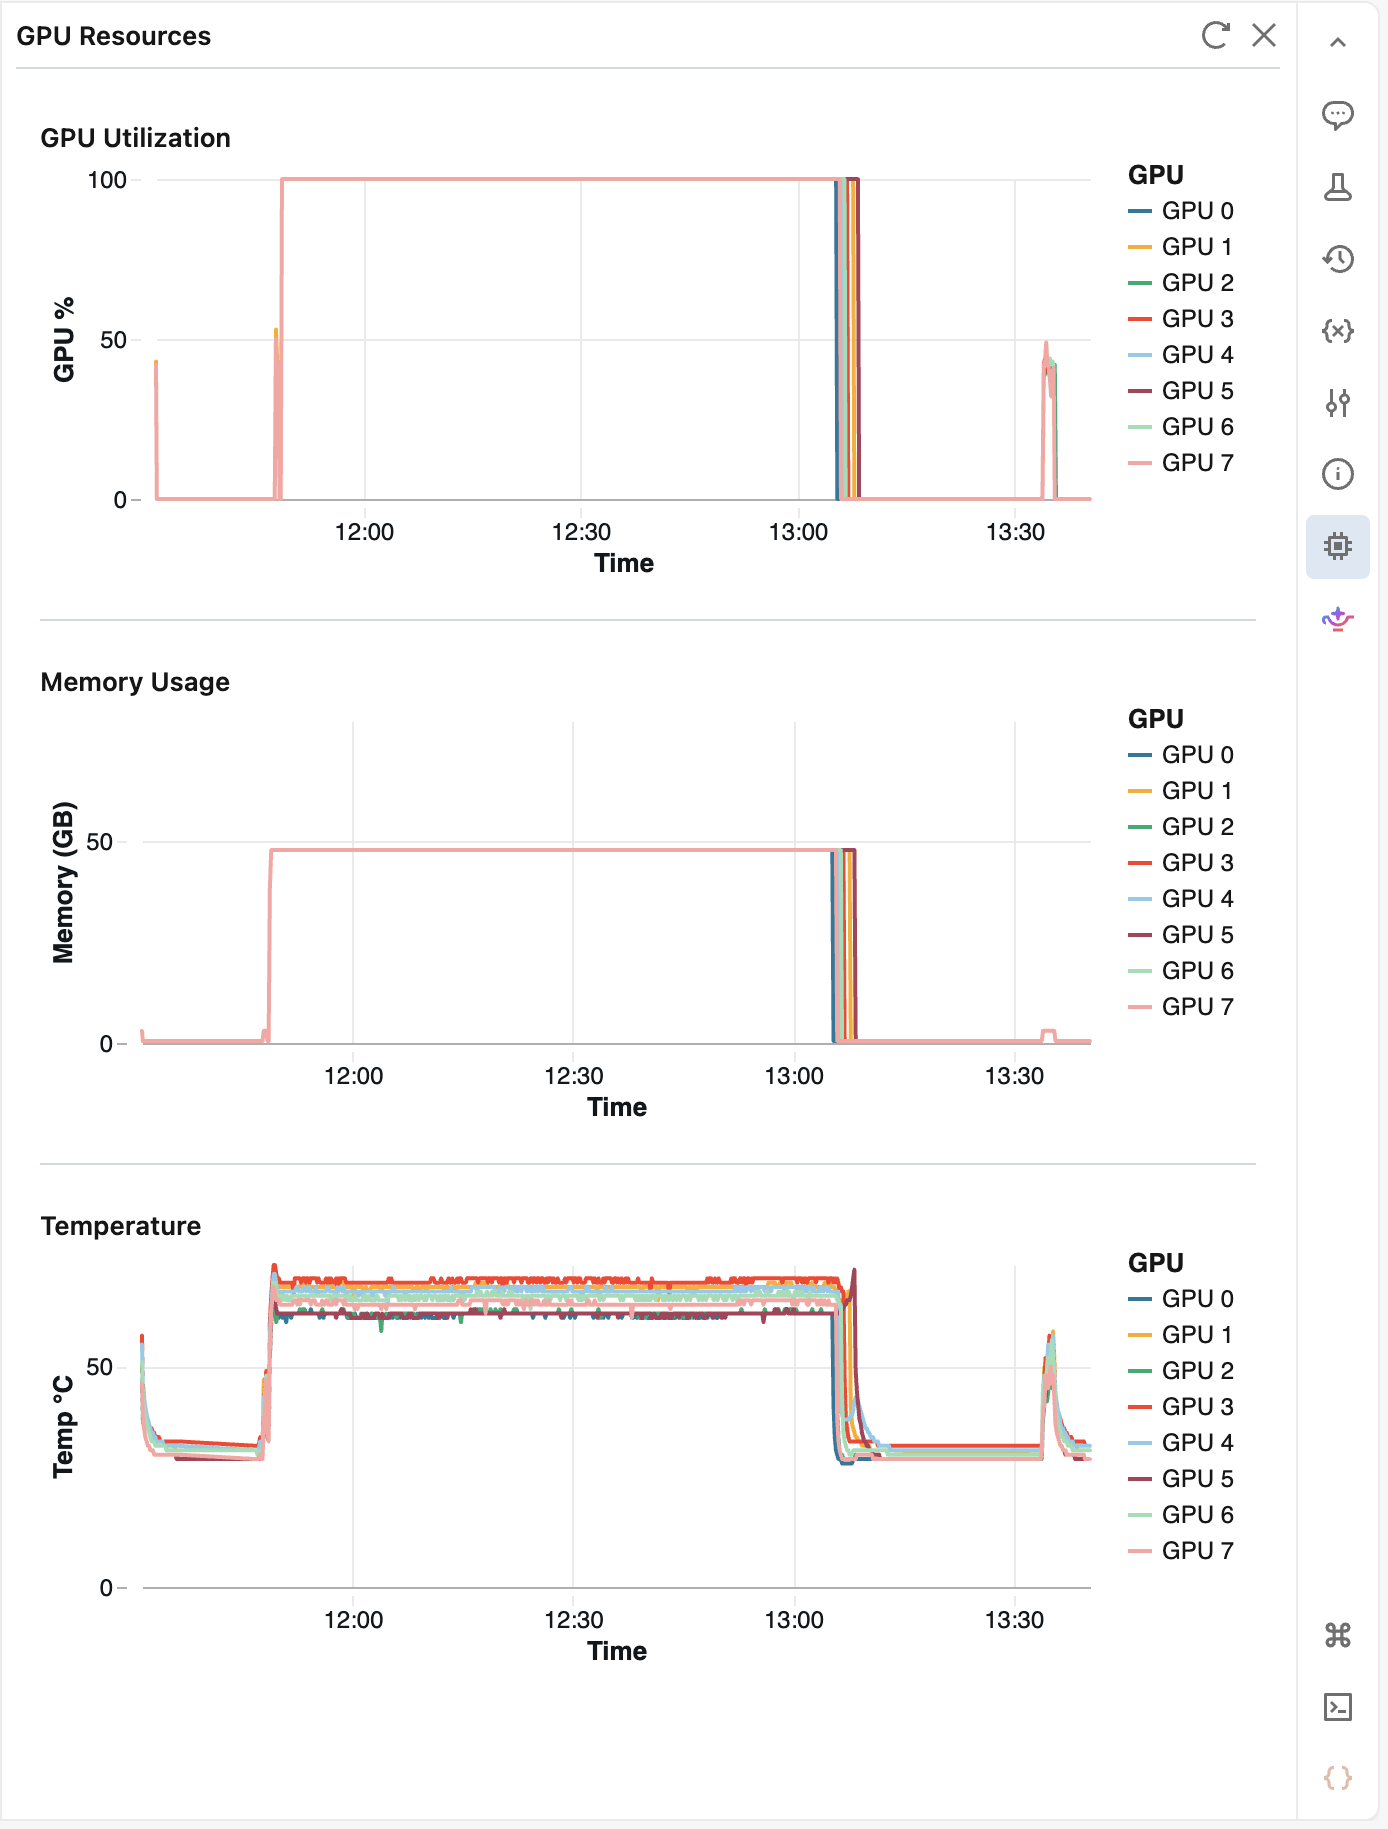
Le volet interroge les métriques toutes les 10 secondes et conserve jusqu’à 2 heures d’historique.
 Actualiser pour récupérer les dernières valeurs. Après 5 minutes d’inactivité, le panneau se met en pause. Rouvrez-le pour reprendre la surveillance.
Voir les journaux dans l’onglet MLflow Logs
L’onglet Logs sur une page de run MLflow affiche la sortie d’une charge de travail d’exécution IA supportée par des jobs. Pour l’ouvrir, allez sur la page d’exécution et cliquez sur Journaux.
Pour les nouvelles exécutions, l’onglet Logs remplace les fichiers journaux précédemment stockés dans l’onglet Artefacts de l’exécution, qui sont obsolètes. Les exécutions créées plus tôt conservent leurs fichiers journaux dans l’onglet Artefacts.
Depuis l’onglet Journaux , vous pouvez :
- Recherche : Affichez uniquement les lignes contenant un terme de recherche.
- Filtrez par nœud, niveau et plage de temps : sélectionnez un seul nœud d’une charge de travail multi-nœuds, affichez uniquement les informations, les lignes d’avertissement ou d’erreur, ou restreignez la vue à une plage de temps.
- Suivre une charge de travail en cours : pendant que l’exécution est active, un nouveau résultat apparaît au fur et à mesure. Faites défiler vers le haut pour mettre en pause l’abonnement.
- Copiez et téléchargez : copiez les lignes chargées, ou téléchargez toutes les lignes correspondant aux filtres actuels.
Conservation des journaux
Les journaux sont disponibles dans l’onglet Journaux pendant 60 jours.
Dépannage de l’accès aux journaux
L’onglet Logs sur une page d’exécution MLflow affiche en continu la sortie de l’exécution de tâche Azure Databricks associée. L’accès à l’expérimentation MLflow n’implique pas l’accès au job.
Si l’onglet indique que vous n’avez pas accès à ces journaux, demandez à un utilisateur ayant la permission Peut gérer ou à un administrateur de l’espace de travail de vous accorder au moins Peut voir sur le travail. Voir Contrôler l’accès à un travail.
Limites globales dans Azure Databricks
Consultez l’article Limites des ressources.