Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Important
Cette fonctionnalité est en version bêta. Pour l’utiliser, un administrateur d’espace de travail doit activer les mises à jour efficaces des colonnes depuis la page Aperçus . Consultez Gérer les préversions d’Azure Databricks.
Efficient Column Updates (ECU) vous permet d’ajouter et de remplir des colonnes dans une table Delta Lake sans réécrire les colonnes inchangées. Utilisez-le pour renseigner de nouvelles fonctionnalités, embeddings et autres valeurs dérivées dans des ensembles de données existants.
L’ajout d’une colonne modifie le schéma de la table sans réécrire les données existantes. Remplir cette colonne avec des valeurs peut nécessiter la réécriture des fichiers de données contenant les lignes affectées, y compris celles qui n’ont pas changé. Efficient Column Updates évite ces réécritures de colonnes inchangées en écrivant les valeurs des colonnes mises à jour dans des fichiers Parquet séparés.
Cela est particulièrement utile lorsque vous ajoutez un petit nombre de colonnes à une table contenant de grandes charges utiles ou des embeddings. Les requêtes continuent de renvoyer une seule table logique, combinant les données existantes avec les valeurs de colonnes mises à jour.
Le diagramme suivant compare l’ajout et le rétroremplissage d’une colonne. Les blocs gris représentent les données de colonnes existantes, les blocs verts représentent les nouvelles données de colonnes, et les contours rouges identifient les données réécrites.
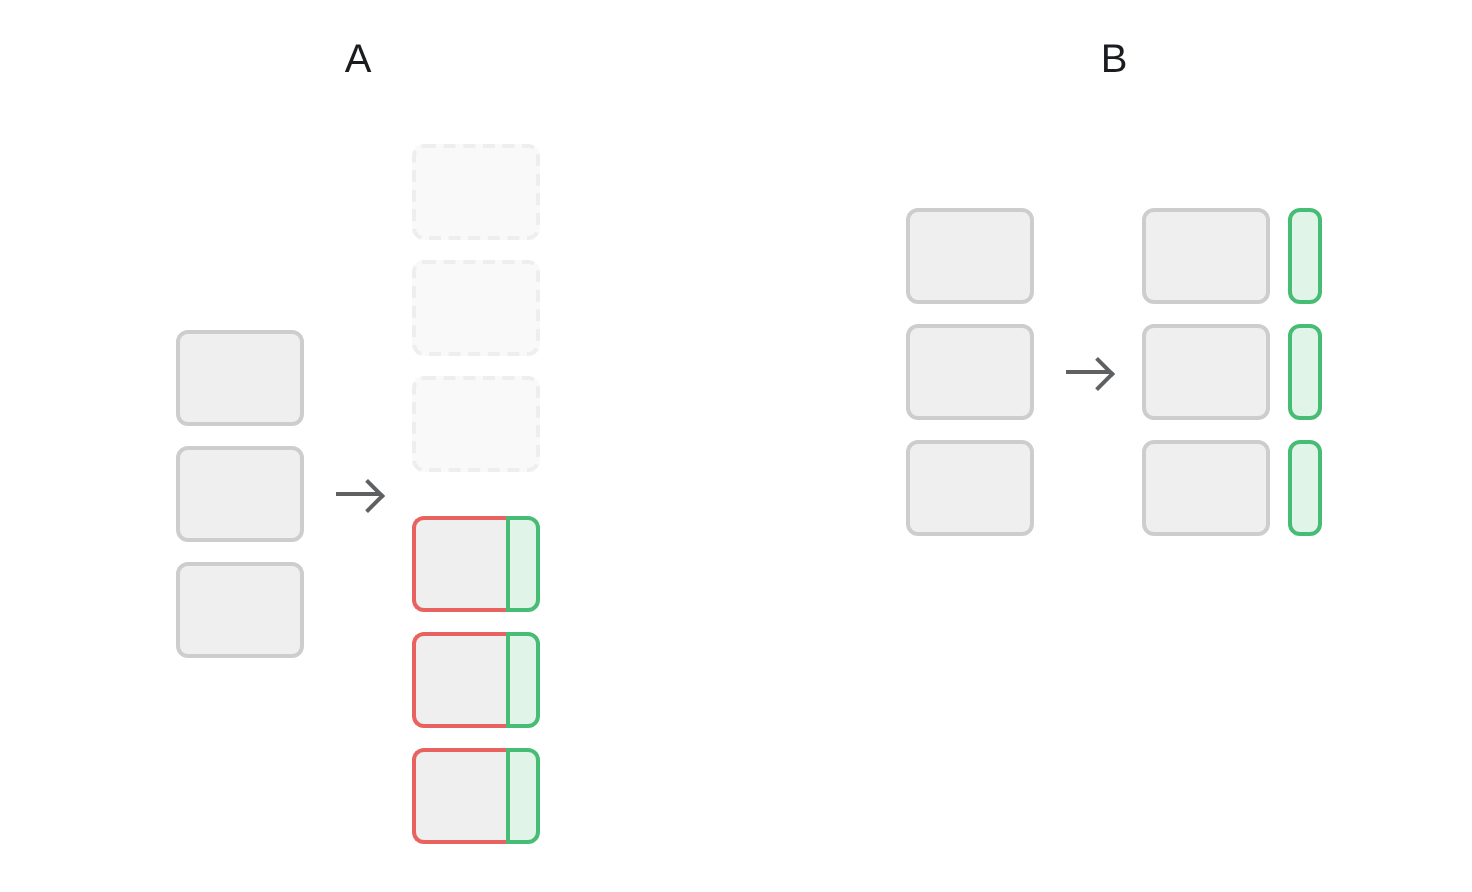
- R : Sans ECU, un remblai remplace les fichiers de données originaux (contours pointillés) par des fichiers contenant à la fois les colonnes inchangées et la nouvelle colonne.
- B : Avec l’ECU, les fichiers originaux sont conservés et les nouvelles valeurs de colonnes sont écrites dans des fichiers séparés.
Requirements
- Utilisez Databricks Runtime 19 ou supérieur pour lire ou écrire sur une table avec les mises à jour efficientes de colonne activées.
- Utilisez une table Delta Lake gérée par Unity Catalog avec les commits de catalogue activés.
- Activez les vecteurs de suivi de ligne et de suppression sur la table.
- Utilisez le mappage de colonnes en
idmode ('delta.columnMapping.mode' = 'id'). Ce mode doit être défini lors de la création de la table. - Activez la version Bêta depuis la page Aperçus de l’espace de travail.
Activer des mises à jour efficaces des colonnes
Vous pouvez activer les mises à jour efficaces des colonnes lors de la création d’un tableau ou sur un tableau existant qui répond aux exigences. Examinez les limitations avant de l’activer.
Pour créer une table avec les mises à jour de colonne efficaces activées, définissez la delta.enableColumnUpdates-preview propriété de la table avec les propriétés des fonctionnalités requises :
CREATE TABLE documents (
  document_id BIGINT,
  description STRING
)
TBLPROPERTIES (
  'delta.feature.catalogManaged' = 'supported',
  'delta.enableRowTracking' = 'true',
  'delta.enableDeletionVectors' = 'true',
  'delta.columnMapping.mode' = 'id',
  'delta.enableColumnUpdates-preview' = 'true'
);
Pour une table existante qui utilise déjà le mappage de colonnes en id mode, activez les valides de catalogue, le suivi de lignes et les vecteurs de suppression s’ils ne sont pas déjà activés :
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.feature.catalogManaged' = 'supported',
  'delta.enableRowTracking' = 'true',
  'delta.enableDeletionVectors' = 'true'
);
Ensuite, activez les mises à jour efficaces des colonnes :
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.enableColumnUpdates-preview' = 'true'
);
Si vous rencontrez des problèmes, vous pouvez revenir aux mises à jour standard.
Ajouter et renseigner une colonne
L’exemple suivant utilise une table existante documents avec une colonne document_id et une description colonne de type string. Il ajoute une colonne contenant la longueur de chaque description :
ALTER TABLE documents ADD COLUMN text_length INT;

UPDATE documents
SET text_length = LENGTH(description);
Après l’ajout de la colonne, les lignes existantes contiennent NULL dans text_length jusqu’à ce que UPDATE renseigne ses valeurs. Mises à jour efficaces des colonnes permet au backfill d’écrire les nouvelles valeurs de colonnes sans réécrire les colonnes inchangées.
Interrogez la table pour inspecter les valeurs remplies :
SELECT document_id, description, text_length
FROM documents
LIMIT 10;
Les mises à jour efficaces des colonnes réduisent la réécriture des données lors d’un rétroremplissage. La mise à jour lit toujours les colonnes d’entrée et calcule les nouvelles valeurs.
Activer les mises à jour efficaces de colonnes ne garantit pas que chaque UPDATE les utilise. Dans certains cas, Azure Databricks revient à une mise à jour standard qui réécrit les fichiers de données affectés. La mise à jour réussit tout de même et produit les mêmes résultats.
Revenir aux mises à jour standard
Si vous rencontrez des problèmes avec les mises à jour de colonnes efficaces, désactivez les nouvelles mises à jour de colonnes et consolidez les fichiers de colonnes existants :
Arrêtez d’écrire de nouveaux fichiers de colonnes :
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.enableColumnUpdates-preview' = 'false'
);
Réécrivez les fichiers de données contenant des fichiers de colonnes en utilisant REORG TABLE:
REORG TABLE documents APPLY (PURGE);
REORG écrit les dernières valeurs de colonnes dans les fichiers de données réécrits, créant ainsi une nouvelle version de la table sans fichiers de colonnes. Les valeurs mises à jour sont conservées. Les versions antérieures de table peuvent encore référencer des fichiers de colonnes.
La fonctionnalité de table reste activée dans le protocole de table, donc les lectures et écritures nécessitent toujours Databricks Runtime 19 ou supérieur.
Limitations
- Efficient Column Updates est incompatible avec le flux de données de modification lors de l’écriture (CDF). Voir Flux de données de modification hérité.
- Efficient Column Updates est incompatible avec Universal Format (UniForm).
- Les tables gérées par Apache Iceberg ne sont pas prises en charge.
-
MERGEles opérations n’utilisent pas les mises à jour efficientes des colonnes. - La désactivation de Efficient Column Updates avec
DROP FEATUREn’est pas prise en charge. Databricks recommande d’éviter de l’activer sur les tables critiques. Pour ne plus utiliser les mises à jour des colonnes, voir Revenir aux mises à jour standard. - Les pipelines Lakeflow ne sont pas pris en charge.