Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Les fonctions définies par l’utilisateur dans le catalogue Unity étendent les fonctionnalités SQL et Python dans Azure Databricks. Ils vous permettent de définir, d’utiliser et de partager et de gérer en toute sécurité des fonctions personnalisées dans les environnements informatiques.
Les UDF Python enregistrées en tant que fonctions dans Unity Catalog diffèrent en termes de portée et de prise en charge des UDF PySpark étendues à un bloc-notes ou à SparkSession. Consultez Python fonctions scalaires définies par l’utilisateur (UDF).
Pour inscrire des fonctions définies par l’utilisateur écrites en Scala ou Java dans le catalogue Unity, consultez Scala et Java fonctions définies par l’utilisateur dans le catalogue Unity.
Pour voir quelles charges de travail et tables font référence à un UDF dans le catalogue Unity avant de le modifier, voir Voir la lignée UDF.
Consultez CREATE FUNCTION (SQL, Python, Scala et Java) pour obtenir une référence complète du langage SQL.
Spécifications
Pour utiliser les UDF dans le catalogue Unity, vous devez remplir les conditions suivantes :
- Pour utiliser du code Python dans des fonctions définies par l’utilisateur inscrites dans Unity Catalog, vous devez utiliser un entrepôt SQL serverless ou pro ou un cluster exécutant Databricks Runtime 13.3 LTS ou une version ultérieure.
- Si une vue inclut une fonction UDF Python du catalogue Unity, elle échoue sur les entrepôts SQL classiques.
- La prise en charge des instances ARM pour les UDF Scala sur Unity Catalog est disponible dans Databricks Runtime 15.2 et versions ultérieures.
Les UDF Python scalaires et par lot pour Unity Catalog sont généralement disponibles sur tous les types de calcul pris en charge.
Prérequis de la fonctionnalité Python UDF
Les exigences varient selon la fonctionnalité. Databricks Runtime 19 et l’environnement version 6 ne sont pas des exigences générales pour les UDF Python du catalogue Unity.
Pour les UDF de session PySpark sur des notebooks serverless ou des jobs, les exigences d’environnement font référence à l’environnement de session. Pour les UDF Python définis en SQL, ils font référence à environment_version dans chaque clause de ENVIRONMENT fonction. Changer l’environnement de session ne modifie pas l’environnement d’une fonction existante du catalogue Unity. Par exemple, une session utilisant la version 6 de l’environnement peut appeler une fonction du catalogue Unity définie avec la version 5 de l’environnement.
| Fonctionnalité | Spécifications |
|---|---|
ENVIRONMENT clause et dépendances personnalisées |
Notebooks et tâches serverless ; entrepôts SQL Pro ou serverless ; Databricks Runtime 16.2 ou version ultérieure sur une capacité de calcul classique. Sur le calcul classique exécutant Databricks Runtime 16.2 à 18.1, environment_version doit être 'None'. |
| UDF Python Unity Catalog par lots | Calcul sans serveur ; entrepôts SQL pro et serverless ; Databricks Runtime 16.3 ou supérieur sur le calcul classique |
| Gestionnaire nommé pour un UDF scalaire Python | Databricks Runtime 18.1 ou version ultérieure avec le calcul classique. Dans l’environnement de calcul serverless ainsi que dans les entrepôts de données SQL Pro et serverless, définissez explicitement le environment_version de l’UDF sur 6 ou une valeur supérieure. |
| Identifiants de service dans un UDF scalaire Python | Databricks Runtime 18.1 ou version ultérieure avec le calcul classique. Dans l’environnement de calcul serverless ainsi que dans les entrepôts de données SQL Pro et serverless, définissez explicitement le environment_version de l’UDF sur 6 ou une valeur supérieure. Le calcul classique ne nécessite pas d’environnement version 6. Sur les entrepôts SQL sans serveur, activez également la préversion publique de la mise en réseau des charges de travail isolées. |
| Identifiants de service dans un catalogue Batch Unity Python UDF | Calcul sans serveur ; entrepôts SQL professionnels et sans serveur ; Databricks Runtime 16.3 ou version ultérieure sur des ressources de calcul classiques. La version 6 de l’environnement n’est pas requise. Sur les entrepôts SQL sans serveur, activez également la préversion publique de la mise en réseau des charges de travail isolées. |
| Secrets dans un scalaire ou catalogue Batch Unity Python UDF | Explicitement réglé environment_version sur 6 ou au-dessus ; calcul sans serveur ; entrepôts SQL pro et serverless ; Databricks Runtime 19 ou supérieur avec mode d’accès standard sur calcul classique. L’invocation directe n’est pas prise en charge sur un environnement de calcul en mode d’accès dédié. |
Comportement d’entrée compatible avec TIMESTAMP PySpark |
Databricks Runtime 18.1 ou version ultérieure avec le calcul classique. Dans l’environnement de calcul serverless ainsi que dans les entrepôts de données SQL Pro et serverless, définissez explicitement le environment_version de l’UDF sur 6 ou une valeur supérieure. |
| Plus de cinq appels UDF dans une requête | Databricks Runtime 18.1 ou version ultérieure avec le calcul classique. Dans les environnements de calcul serverless ainsi que dans les entrepôts SQL Pro et Serverless, définissez explicitement le paramètre environment_version de chaque UDF sur 6 ou une valeur supérieure. |
Les UDF et fonctionnalités existantes disponibles lors de la Prévisualisation publique continuent de fonctionner sur les versions d’exécution antérieures applicables.
La version de l’environnement détermine également si les appelants ont besoin d’un accès direct aux dépendances stockées dans un volume du catalogue Unity. Voir les autorisations pour les dépendances dans les volumes Unity Catalog.
Versions de l’environnement de calcul classique
En calcul classique, définir environment_version à une valeur autre que 'None' nécessite Databricks Runtime 18.2 ou supérieur. Sur Databricks Runtime 16.2 à 18.1, activez environment_version = 'None' chaque fois que vous utilisez la clause ENVIRONMENT. La valeur 'None' utilise l’environnement Python par défaut.
Sur Databricks Runtime 18.2 ou version ultérieure, pour garantir un comportement prévisible, Azure Databricks recommande de définir explicitement une valeur environment_version fixe dans chaque définition d’UDF Python Unity Catalog. Choisissez une version qui répond aux exigences fonctionnelles de l’UDF et respecte les recommandations de compatibilité suivantes :
| Version de Databricks Runtime | Version maximale recommandée de l’environnement |
|---|---|
| 18.2 à 18.x | 5 |
| 19.x | 6 |
Créer des UDF SQL et Python dans Unity Catalog
Pour créer une UDF SQL ou Python dans Unity Catalog, les utilisateurs doivent disposer des autorisations USAGE et CREATE sur le schéma et de l’autorisation USAGE sur le catalogue. Pour plus d’informations, consultez le catalogue Unity.
Pour exécuter une fonction UDF, les utilisateurs ont besoin d’une autorisation EXECUTE sur la fonction UDF. Les utilisateurs ont également besoin d’une autorisation USAGE sur le schéma et le catalogue.
Pour créer et inscrire une fonction UDF dans un schéma de catalogue Unity, le nom de la fonction doit suivre le format catalog.schema.function_name. Vous pouvez également sélectionner le catalogue et le schéma appropriés dans l’Éditeur SQL.
Dans ce cas, votre nom de fonction ne doit pas être précédé de catalog.schema :
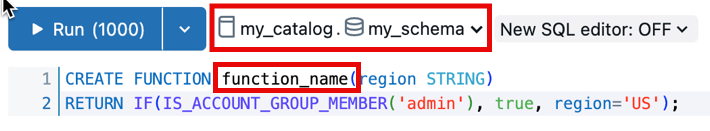
L’exemple suivant inscrit une nouvelle fonction dans le my_schema schéma du my_catalog catalogue :
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight DOUBLE, height DOUBLE)
RETURNS DOUBLE
LANGUAGE SQL
RETURN
SELECT weight / (height * height);
Les UDF Python pour Unity Catalog utilisent des instructions délimitées par des doubles signes dollar ($$). Vous devez spécifier un mappage de type de données. L’exemple suivant enregistre une fonction UDF qui calcule l’index de masse corporelle :
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight_kg DOUBLE, height_m DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
return weight_kg / (height_m ** 2)
$$;
Vous pouvez maintenant utiliser cette fonction de catalogue Unity dans vos requêtes SQL ou code PySpark :
SELECT person_id, my_catalog.my_schema.calculate_bmi(weight_kg, height_m) AS bmi
FROM person_data;
Consultez les exemples de filtre de lignes et les exemples de masque de colonne pour obtenir d’autres exemples UDF.
Utilisez un gestionnaire nommé dans un UDF scalaire Python
En calcul classique, les gestionnaires nommés nécessitent Databricks Runtime 18.1 ou supérieur. Dans l’environnement de calcul serverless ainsi que dans les entrepôts de données SQL Pro et serverless, définissez explicitement le environment_version de l’UDF sur 6 ou une valeur supérieure. L’exemple suivant utilise la version 6 de l’environnement. Sur une capacité de calcul classique exécutant Databricks Runtime 18.1, omettez la clause ENVIRONMENT. Sur les versions ultérieures du runtime, suivez les recommandations de compatibilité si vous incluez cette clause.
Utilisez la HANDLER clause pour nommer une fonction Python dans le corps UDF comme point d’entrée. Le gestionnaire nommé accepte les arguments UDF et retourne une valeur correspondant au type de retour déclaré. Le code extérieur au gestionnaire s’exécute lorsque chaque environnement Python initialise la UDF, avant que le gestionnaire ne traite les entrées. Utilisez ce code pour une initialisation unique qui peut être réutilisée entre les appels du gestionnaire.
L’exemple suivant initialise greeting_prefix avant de définir greet_handler, la fonction qui gère les entrées UDF :
CREATE OR REPLACE FUNCTION my_catalog.my_schema.greet(name STRING)
RETURNS STRING
LANGUAGE PYTHON
HANDLER 'greet_handler'
ENVIRONMENT (
  environment_version = '6'
)
AS $$
# Runs once when each Python environment initializes the UDF.
greeting_prefix = "Hello"

def greet_handler(name):
    return f"{greeting_prefix}, {name}!"
$$;
Utiliser des secrets dans un UDF Python
Les UDF Python scalaires et par lot de Unity Catalog peuvent accéder aux secrets déclarés dans la clause SECRETS. La définition de la UDF doit explicitement être fixée environment_version à 6 ou au-dessus. Un secret du catalogue Unity utilise un nom en trois parties (catalog.schema.secret) et se distingue d’un secret Azure Databricks au niveau de l’espace de travail. Pour la prise en charge du calcul, les autorisations et l’exception de masque de colonne pour le calcul dédié, voir conditions requises et autorisations pour les UDF.
Pour accéder à un secret d’une UDF :
- Ajoutez le nom en trois parties du secret dans la clause
SECRETSde la définition de la fonction UDF. Une UDF ne peut récupérer que les secrets déclarés dans cette clause. - Dans le corps de l’UDF, appelez
databricks.secrets.get()avec le catalogue, le schéma et le nom secret.
L’exemple scalaire suivant de UDF utilise un secret du catalogue Unity comme clé de signature par code d’authentification de messages (HMAC) basé sur un hachage. Utilisez la même SECRETS clause avec PARAMETER STYLE PANDAS pour accéder aux secrets déclarés depuis un gestionnaire UDF Batch.
CREATE OR REPLACE FUNCTION main.default.sign_value(value STRING)
RETURNS STRING
LANGUAGE PYTHON
SECRETS (main.default.hmac_key)
ENVIRONMENT (
  environment_version = '6'
)
AS $$
import hashlib
import hmac
from databricks.secrets import get

key = get(catalog="main", schema="default", key="hmac_key")
return hmac.new(key.encode(), value.encode(), hashlib.sha256).hexdigest()
$$;
Warning
Ne renvoyez pas de valeurs secrètes depuis une UDF. Le masquage des secrets permet de réduire leur exposition accidentelle dans les messages d’erreur et les journaux, mais il n’empêche pas le code UDF de divulguer des données secrètes dans les résultats des requêtes.
Étendre les fonctions UDF à l’aide de dépendances personnalisées
Remarque
Pour installer des dépendances personnalisées depuis Internet sur un entrepôt SQL sans serveur, votre espace de travail doit avoir la fonctionnalité en préversion publique Activer la mise en réseau pour les charges de travail isolées dans les entrepôts SQL sans serveur activée sur la page Préversions.
Vous pouvez étendre les capacités des UDF Python de Unity Catalog au-delà de l’environnement Databricks Runtime en définissant des dépendances personnalisées pour des bibliothèques externes.
Exigences
Les dépendances personnalisées pour les fonctions UDF du catalogue Unity sont prises en charge sur les types de calcul suivants :
- Notebooks et travaux serverless
- Calcul universel classique à l’aide de Databricks Runtime version 16.2 et ultérieure
- Entrepôt SQL pro ou serverless
Sources de dépendances
Installez les dépendances à partir des sources suivantes :
- PyPI Packages
- Fichiers stockés dans les volumes du catalogue UnityVoir Permissions pour les dépendances dans les volumes du catalogue Unity.
- Fichiers disponibles dans les URL publiques Les règles de sécurité réseau de votre espace de travail doivent autoriser l’accès aux URL publiques. Consultez Spécifications.
Remarque
Si votre espace de travail limite l’accès réseau serverless, vous devez configurer des règles de sécurité réseau pour autoriser les URL publiques. Consultez Définir des règles de sortie.
Autorisations pour les dépendances dans les volumes de Unity Catalog
Le créateur de la fonction doit disposer de READ VOLUME sur un volume source pour ajouter une dépendance entre ce volume et une UDF.
Pour un UDF dont la définition définit explicitement environment_version sur 6 ou une valeur supérieure, les appelants doivent disposer de EXECUTE sur l’UDF, mais n’ont pas besoin de READ VOLUME sur le volume source. Si la définition UDF omet environment_version, le met à None, ou le met à une version antérieure, les appelants doivent également avoir READ VOLUME sur le volume source.
Définir des dépendances
Utilisez la ENVIRONMENT section de la définition UDF pour spécifier les dépendances :
CREATE OR REPLACE FUNCTION my_catalog.my_schema.mixed_process(data STRING)
RETURNS STRING
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["simplejson==3.19.3", "/Volumes/my_catalog/my_schema/my_volume/packages/custom_package-1.0.0.whl", "https://my-bucket.s3.amazonaws.com/packages/special_package-2.0.0.whl?Expires=2043167927&Signature=abcd"]',
  environment_version = '6'
)
AS $$
import simplejson as json
import custom_package
return json.dumps(custom_package.process(data))
$$;
La ENVIRONMENT section contient les champs suivants :
| Champ | Descriptif | Type | Exemple d’utilisation |
|---|---|---|---|
dependencies |
Liste des dépendances séparées par des virgules à installer. Chaque entrée est une chaîne qui est conforme au format de fichier de configuration requise pip. | STRING |
dependencies = '["simplejson==3.19.3", "/Volumes/catalog/schema/volume/packages/my_package-1.0.0.whl"]'dependencies = '["https://my-bucket.s3.amazonaws.com/packages/my_package-2.0.0.whl?Expires=2043167927&Signature=abcd"]' |
environment_version |
Spécifie la version de l’environnement dans laquelle il faut exécuter la UDF. Ce champ est obligatoire chaque fois que la ENVIRONMENT clause est présente. Une version d’environnement fixe exécute la fonction UDF avec une version Python spécifique et un ensemble de packages préinstallés, indépendamment de la version et des packages Python dans le Runtime Databricks sous-jacent.Les valeurs prises en charge sont une version d’environnement 3 ou ultérieure, telle que '6', ou la chaîne 'None'. La valeur 'None' sélectionne l’environnement Python par défaut. En calcul classique, définir environment_version à une valeur autre que 'None' nécessite Databricks Runtime 18.2 ou supérieur. Sur Databricks Runtime 16.2 à 18.1, seul 'None' est pris en charge. Lorsque les versions fixes de l’environnement sont prises en charge, sélectionnez-en explicitement une afin de garantir un comportement prévisible.Sur le calcul serverless ainsi que sur les entrepôts SQL pro et serverless, certaines fonctionnalités nécessitent une version explicite de l’environnement. Définissez environment_version à la version requise ou au-dessus dans chaque définition UDF. Omettre l’intégralité de la clause ENVIRONMENT ou définir environment_version = 'None' n’active pas ces fonctionnalités. Voir les exigences des fonctionnalités Python UDF.Pour plus d’informations sur la compatibilité des versions avec la capacité de calcul classique, consultez Versions d’environnement sur une capacité de calcul classique. Pour la liste des versions disponibles, voir Versions de l’environnement. |
STRING |
environment_version = '6' |
Utiliser les UDF Unity Catalog dans PySpark
from pyspark.sql.functions import expr

result = df.withColumn("bmi", expr("my_catalog.my_schema.calculate_bmi(weight_kg, height_m)"))
display(result)
Mettre à niveau une fonction UDF délimitée à une session
Remarque
La syntaxe et la sémantique des UDF Python dans Unity Catalog diffèrent de celles des UDF Python enregistrées dans SparkSession. Consultez les fonctions scalaires définies par l’utilisateur - Python.
Compte tenu de la fonction UDF suivante basée sur une session dans un notebook Azure Databricks :
from pyspark.sql.functions import udf
from pyspark.sql.types import StringType

@udf(StringType())
def greet(name):
    return f"Hello, {name}!"

# Using the session-based UDF
result = df.withColumn("greeting", greet("name"))
result.show()
Pour l’inscrire en tant que fonction de catalogue Unity, utilisez une instruction SQL CREATE FUNCTION , comme dans l’exemple suivant :
CREATE OR REPLACE FUNCTION my_catalog.my_schema.greet(name STRING)
RETURNS STRING
LANGUAGE PYTHON
AS $$
return f"Hello, {name}!"
$$
Partager les fonctions définies par l’utilisateur dans Unity Catalog
Les contrôles d’accès appliqués au catalogue, au schéma ou à la base de données où vous inscrivez la fonction UDF gèrent ses autorisations. Pour plus d’informations , consultez Gérer les privilèges dans le catalogue Unity .
Utilisez Azure Databricks SQL ou l’interface utilisateur de l’espace de travail Azure Databricks pour accorder des autorisations à un utilisateur ou un groupe (recommandé).
Autorisations dans l’interface utilisateur de l’espace de travail
- Trouvez le catalogue et le schéma où votre UDF est stocké, puis sélectionnez l'UDF.
- Recherchez une option Autorisations dans les paramètres UDF. Ajoutez des utilisateurs ou des groupes et spécifiez le type d’accès dont ils doivent disposer, tels que EXECUTE ou MANAGE.
autorisations 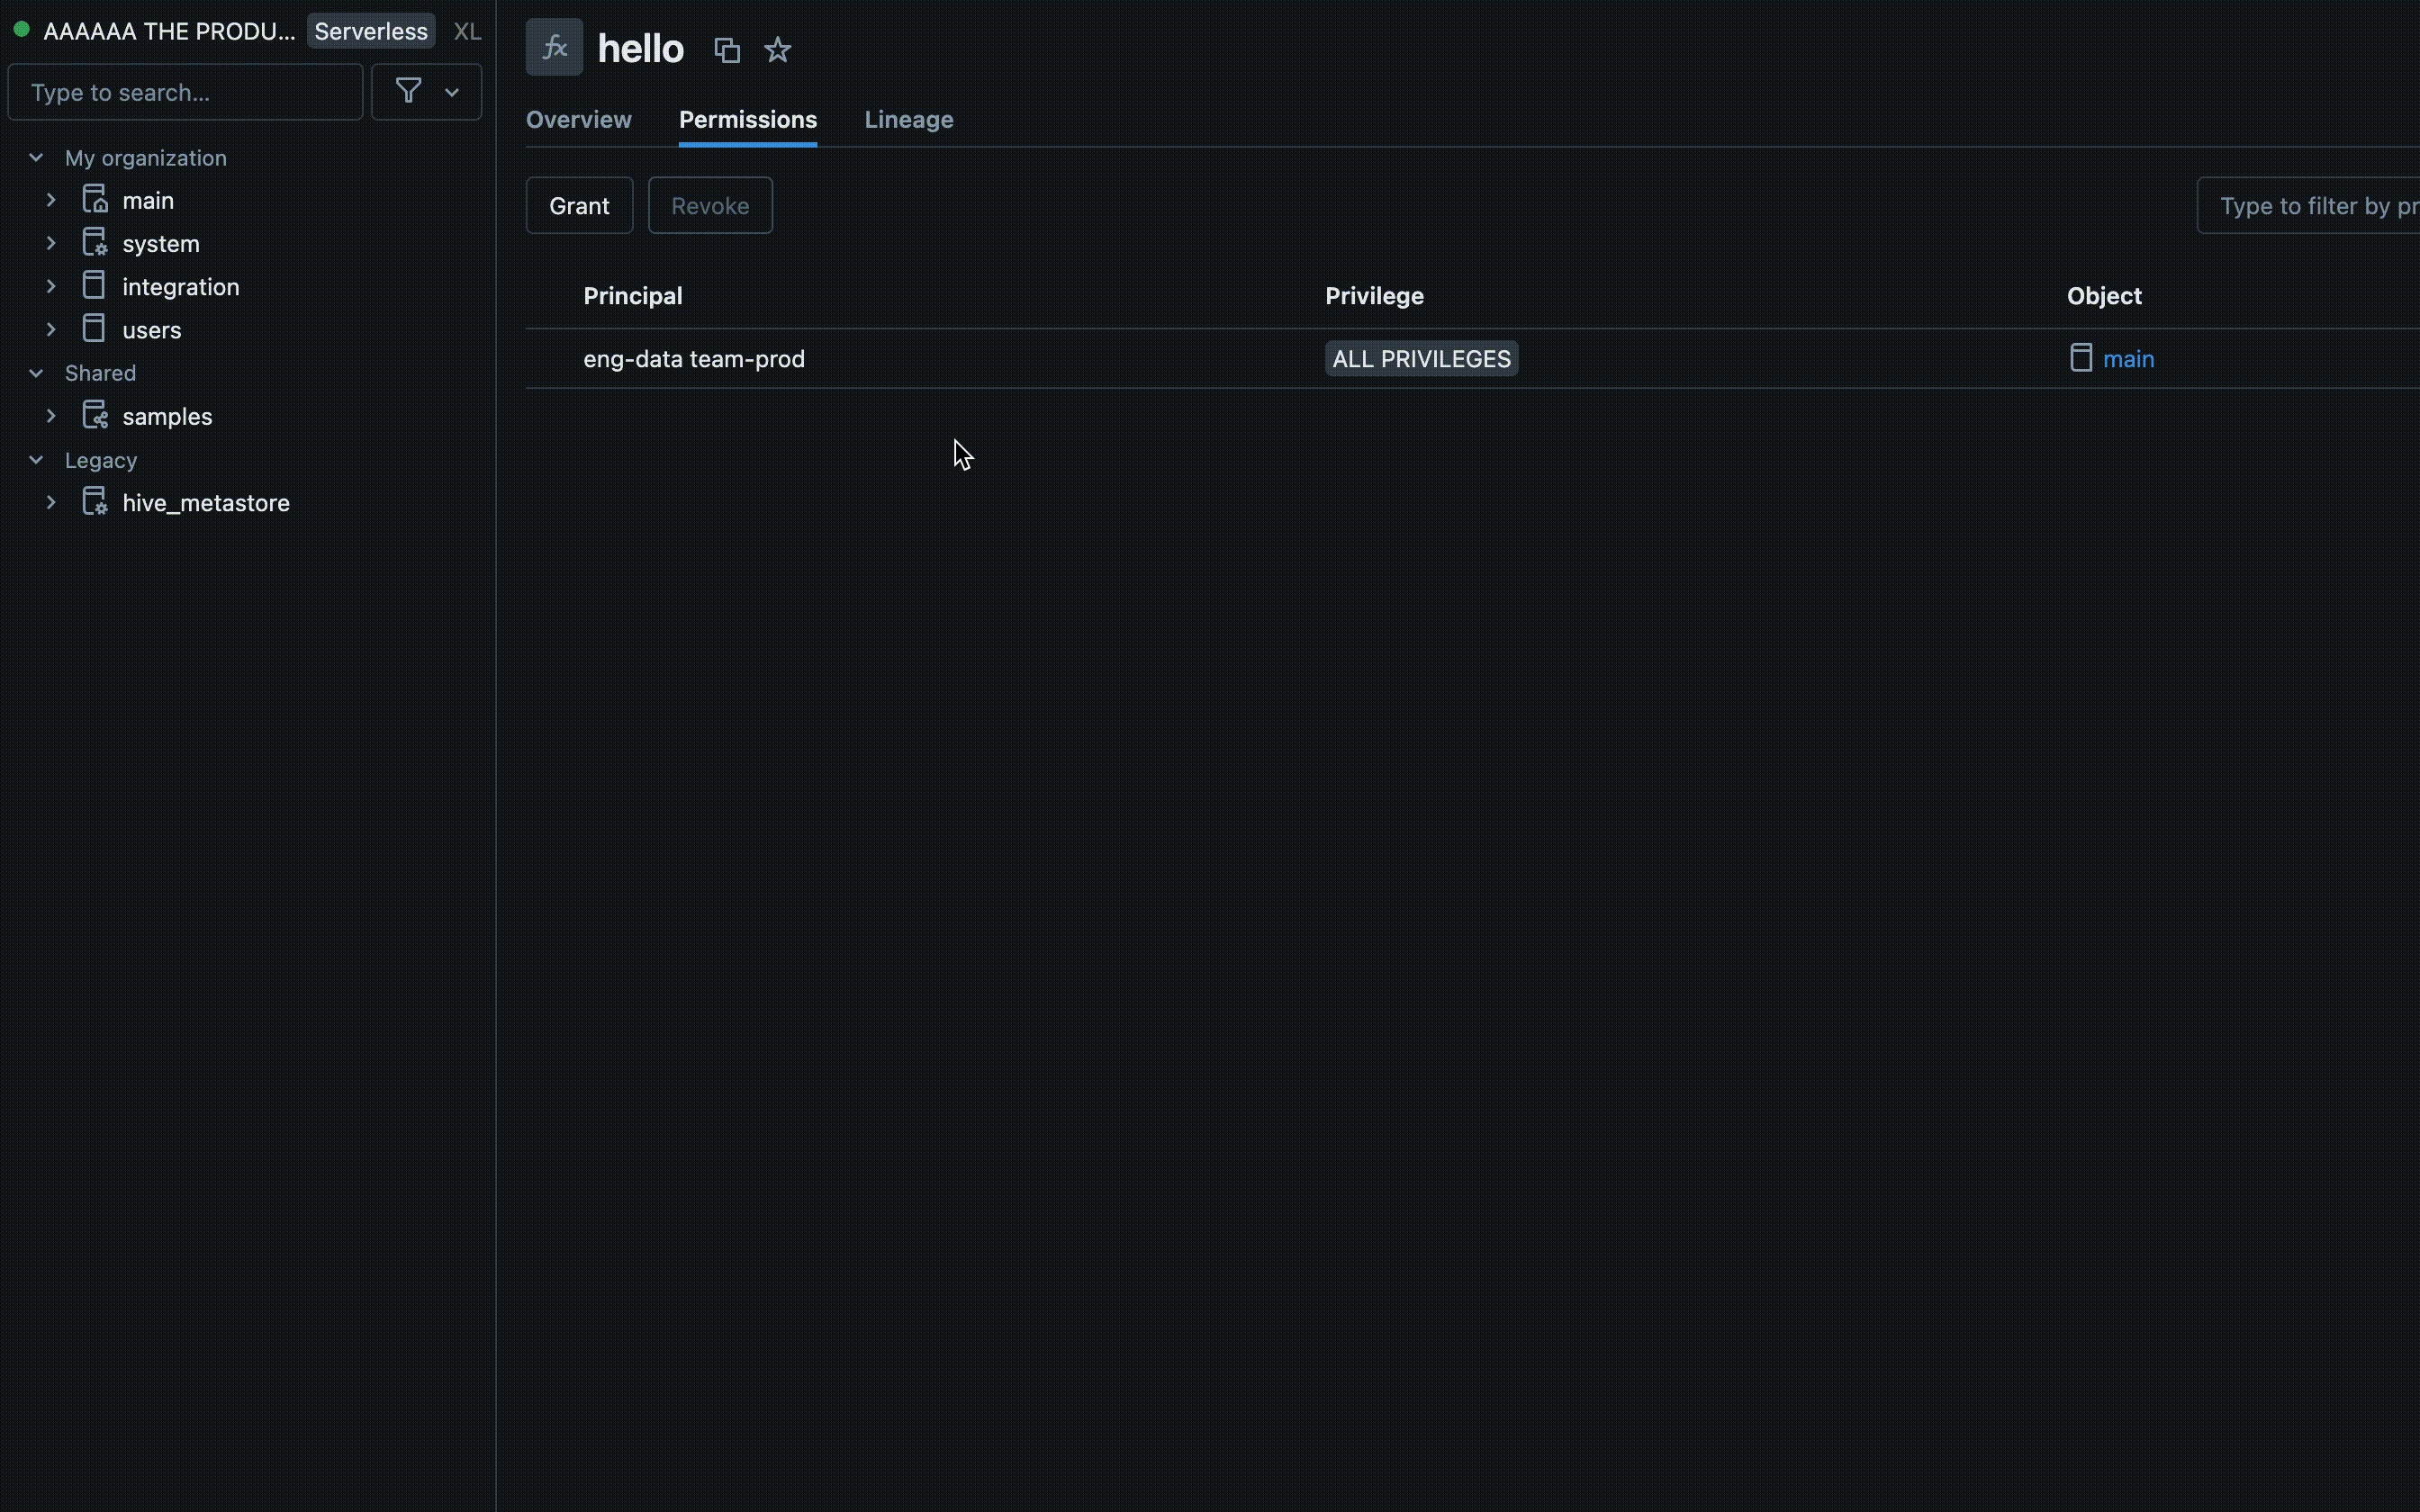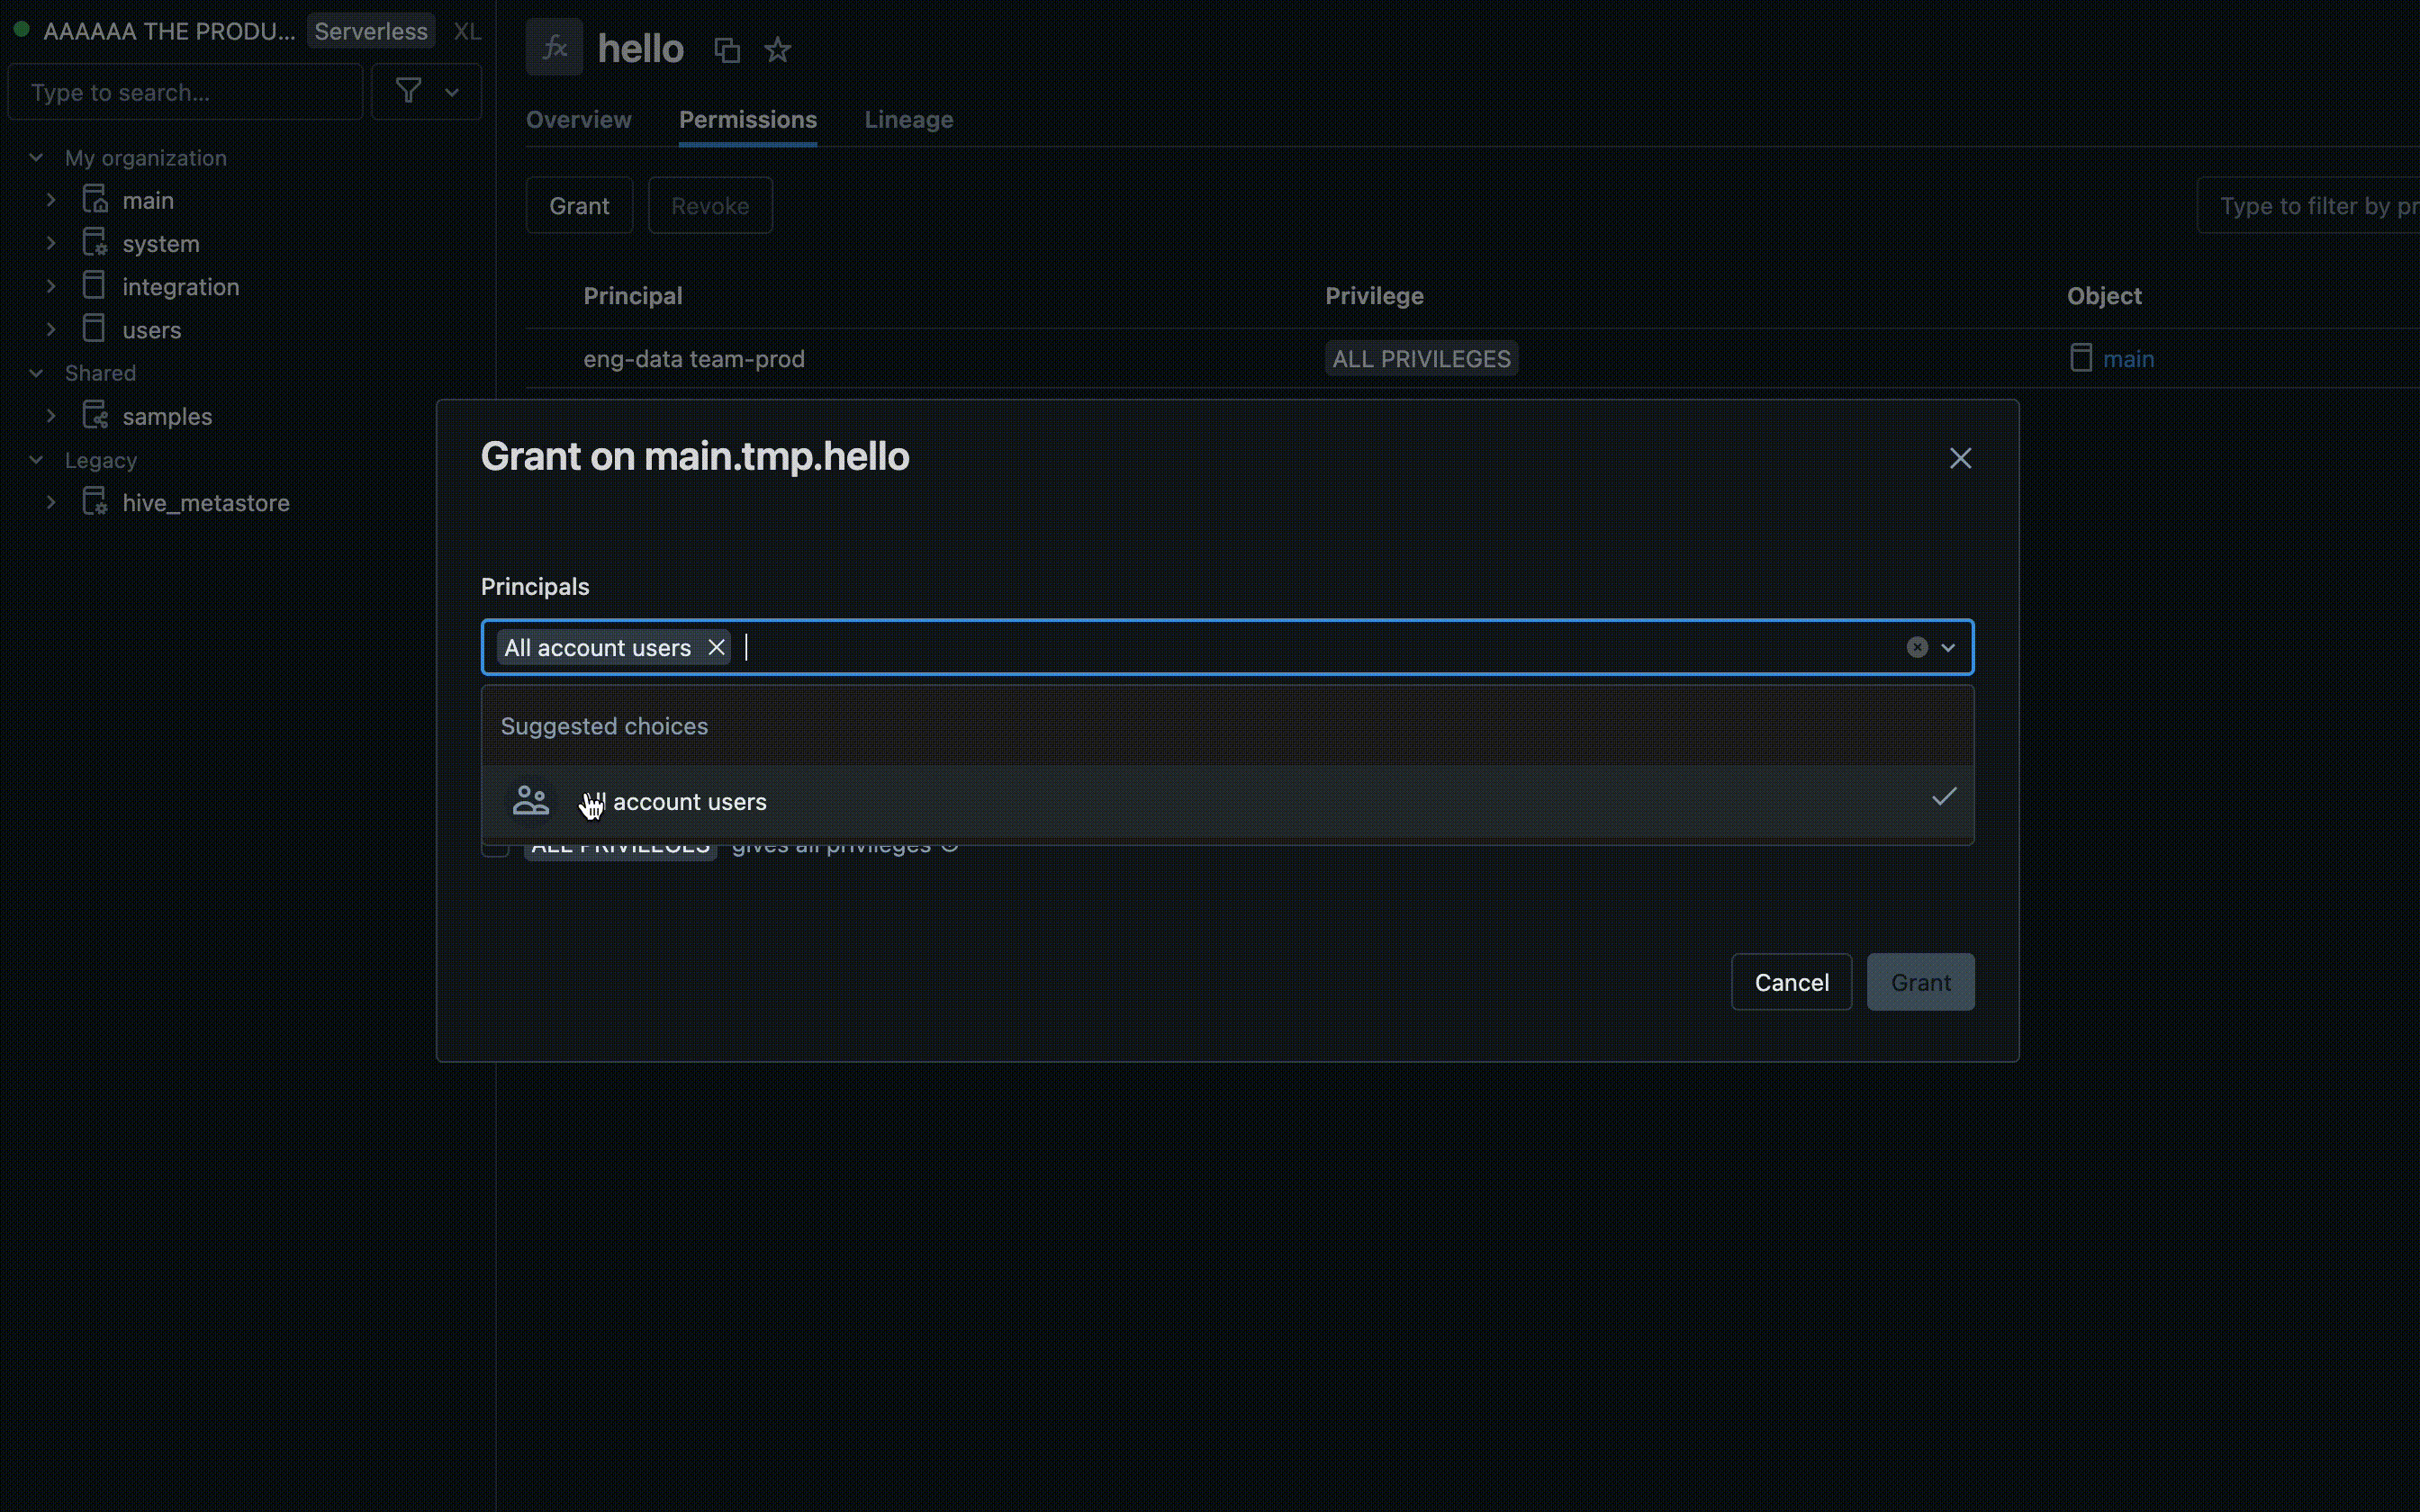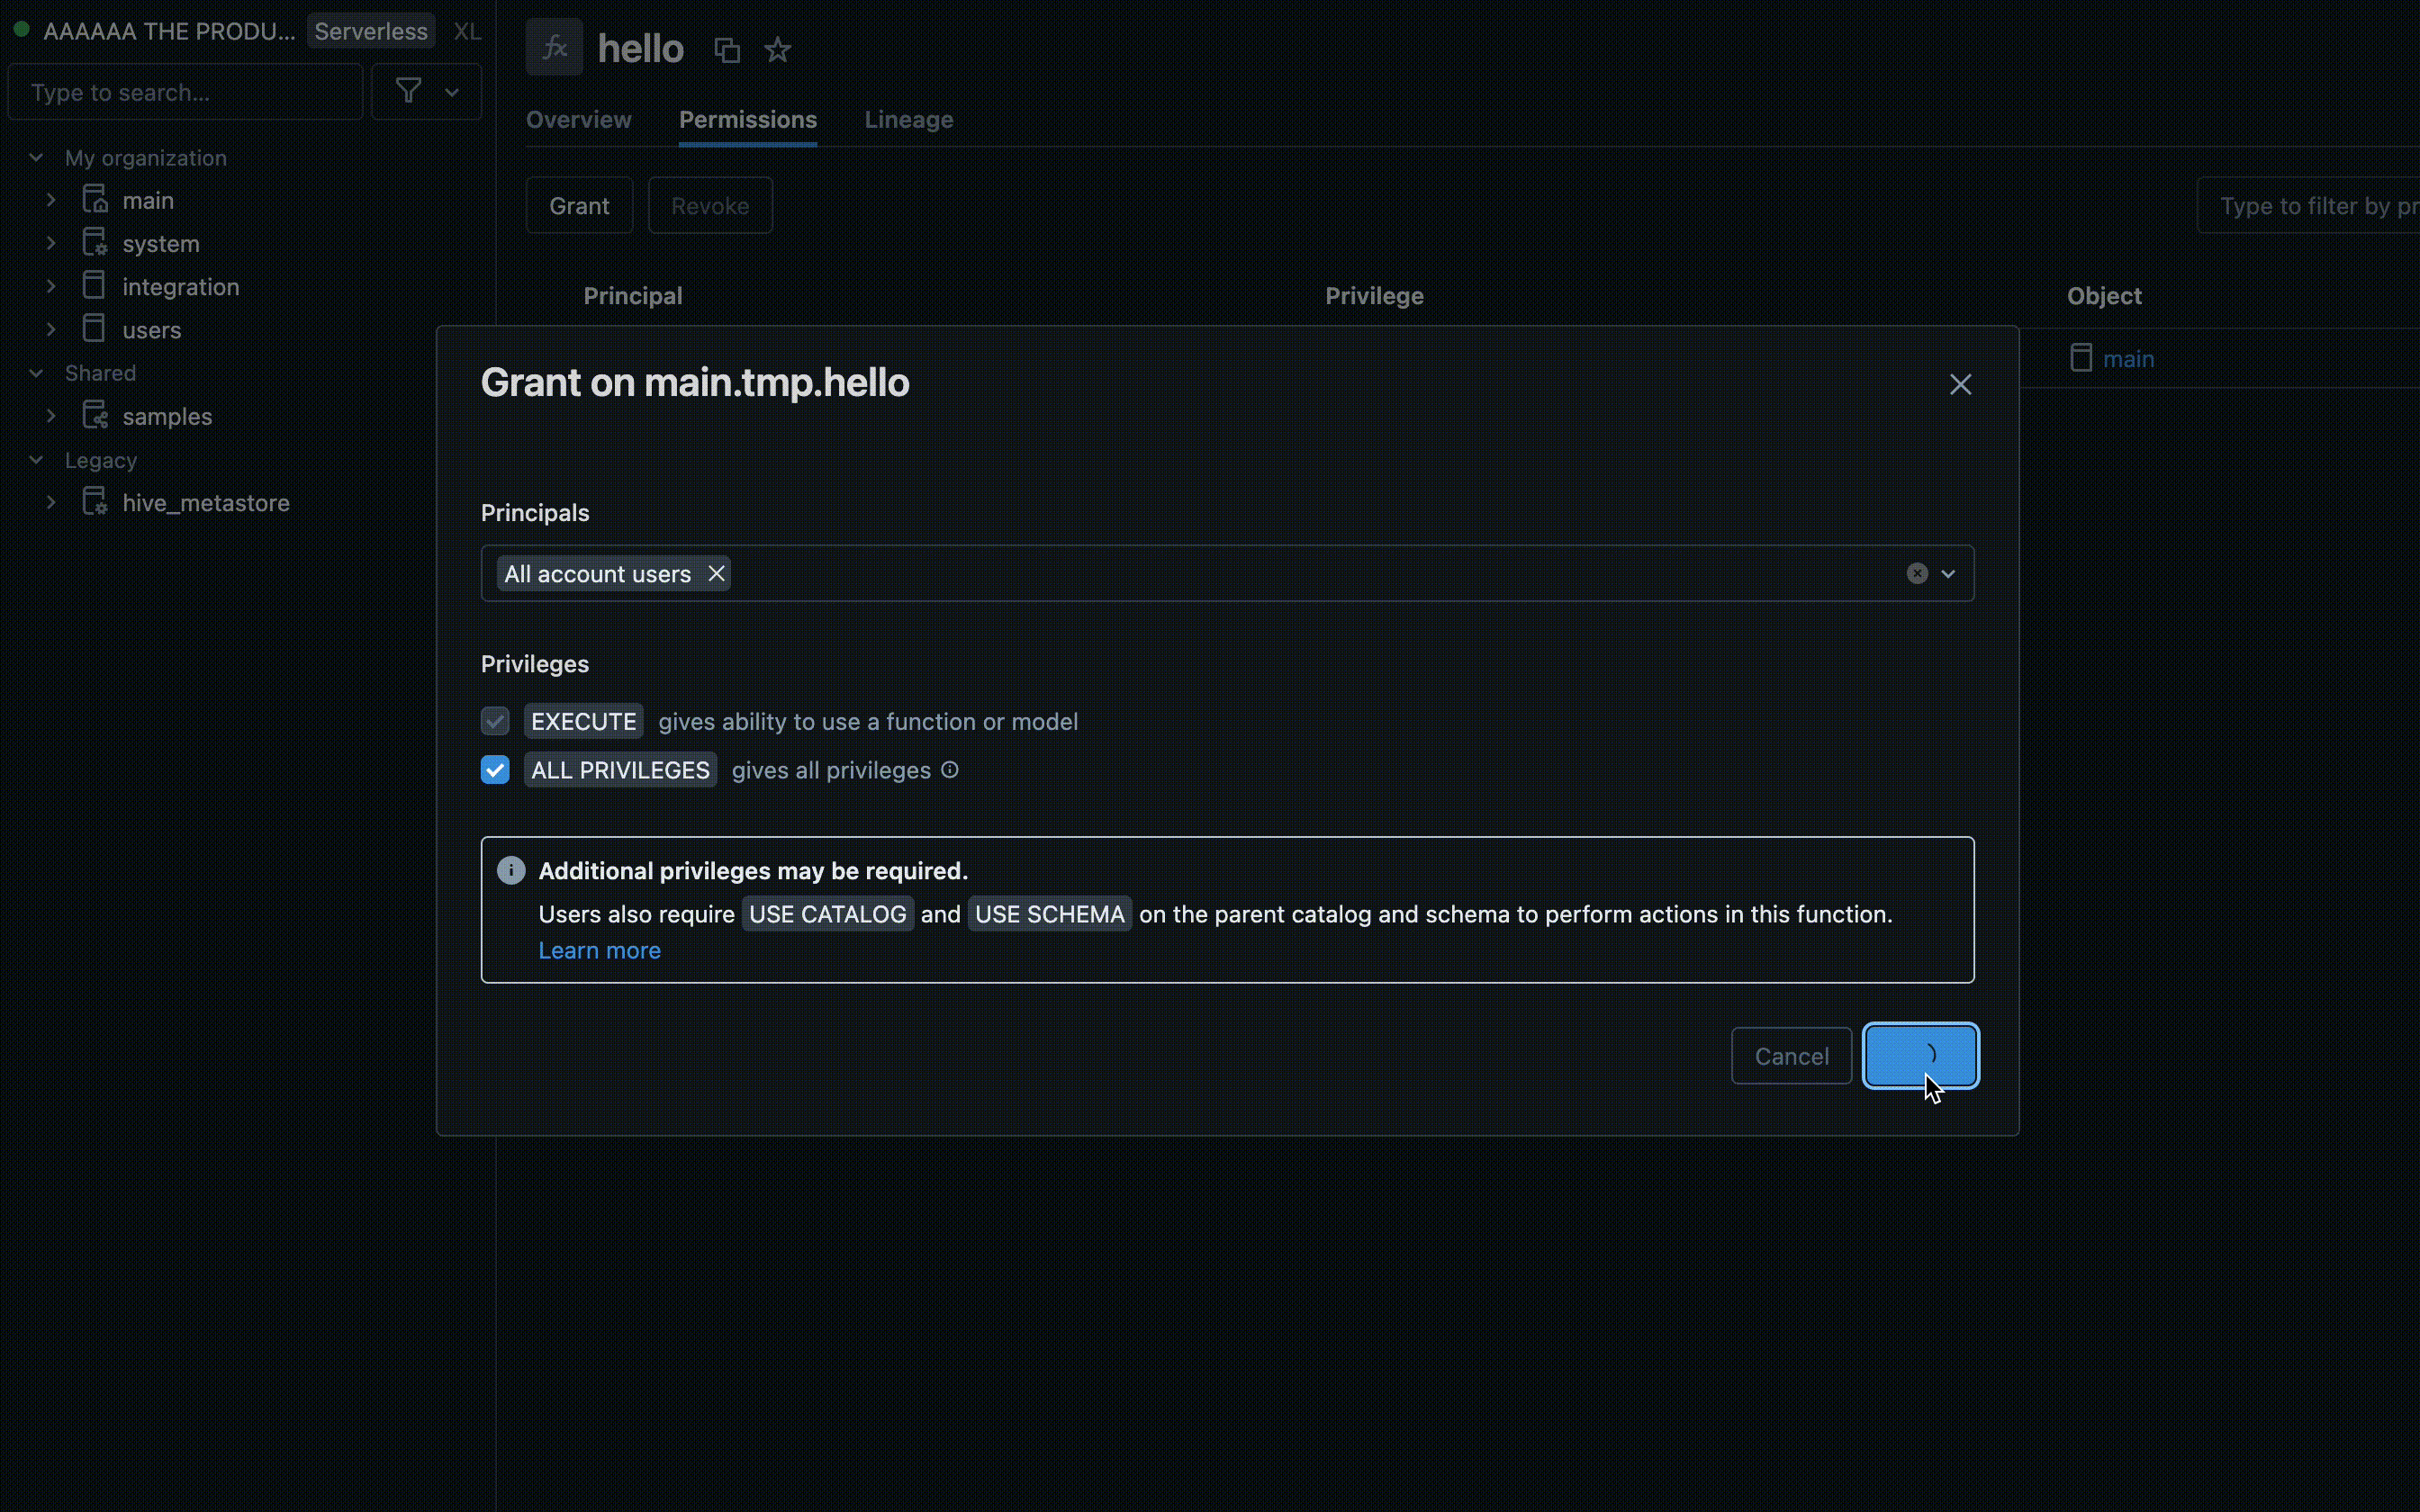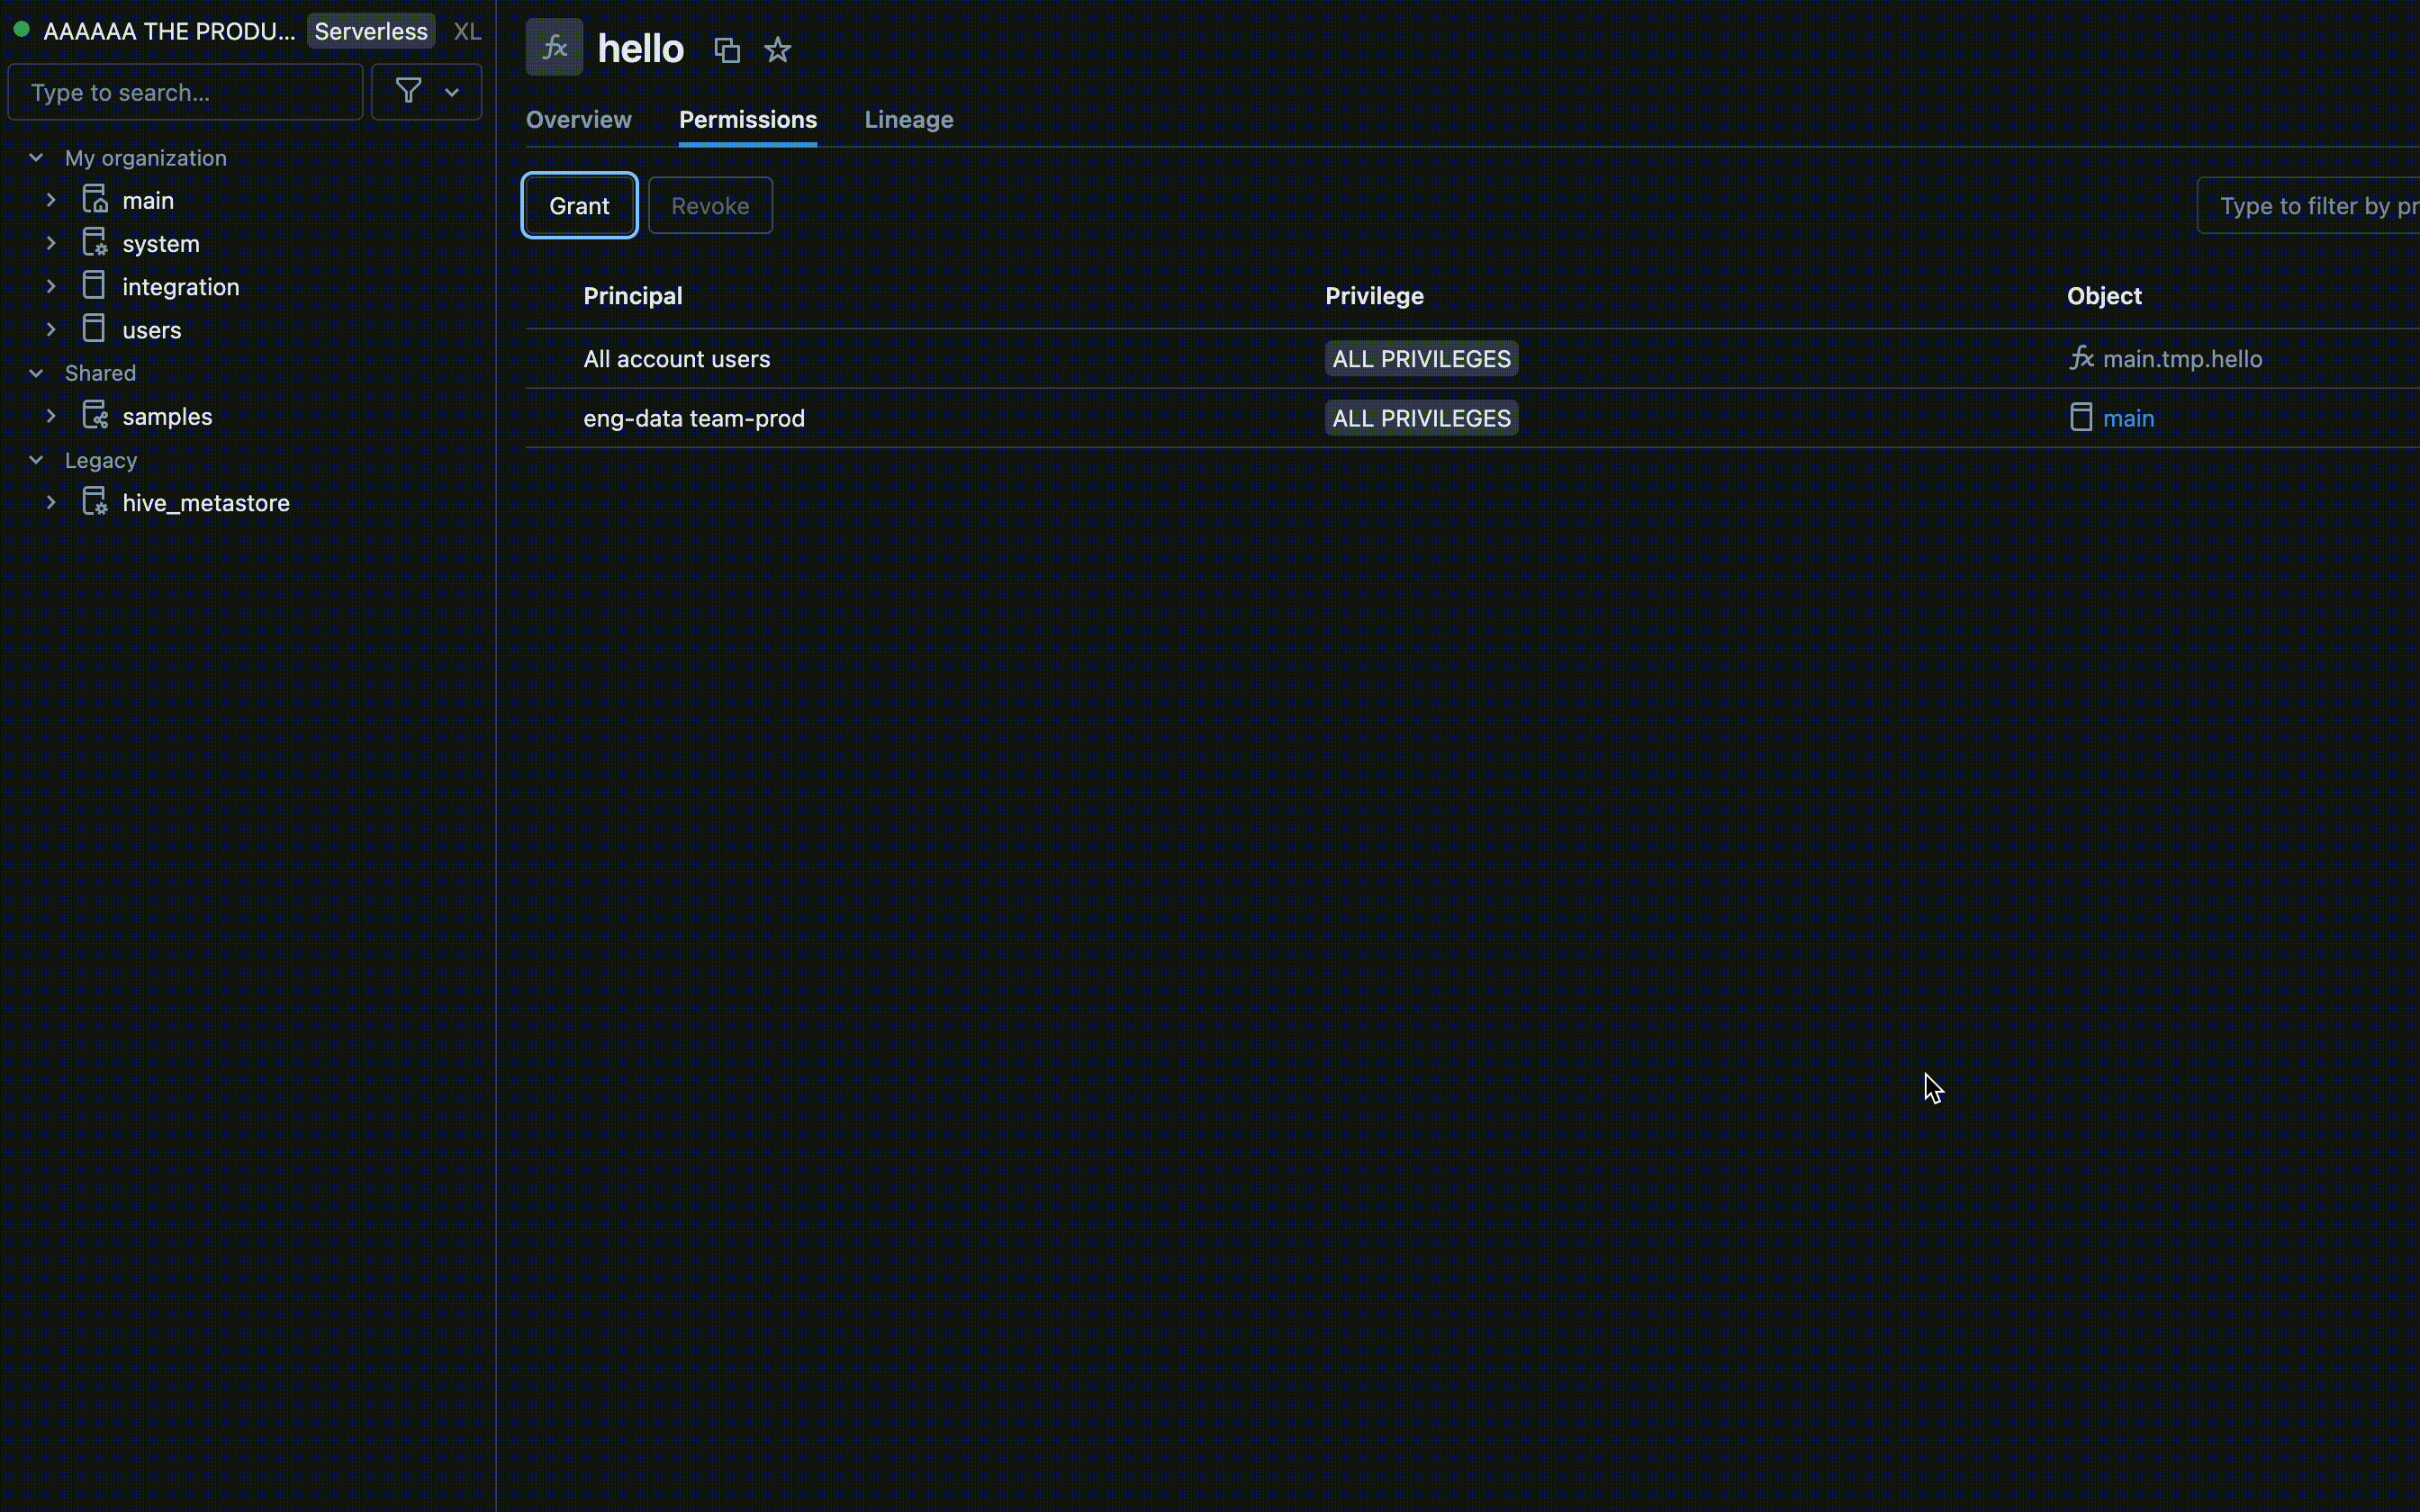
Autorisations à l’aide d’Azure Databricks SQL
L’exemple suivant accorde à un utilisateur l’autorisation EXECUTE sur une fonction :
GRANT EXECUTE ON FUNCTION my_catalog.my_schema.calculate_bmi TO `user@example.com`;
Pour supprimer des autorisations, utilisez la REVOKE commande comme dans l’exemple suivant :
REVOKE EXECUTE ON FUNCTION my_catalog.my_schema.calculate_bmi FROM `user@example.com`;
Isolation de l’environnement
Remarque
Les environnements d’isolation partagée nécessitent Databricks Runtime 18.1 et plus. Dans les versions antérieures, toutes les UDF Python Unity Catalog s’exécutent en mode d’isolation strict.
Les UDF Python du catalogue Unity avec le même propriétaire et la même session peuvent partager un environnement d’isolation de manière par défaut. Cela améliore les performances et réduit l’utilisation de la mémoire en réduisant le nombre d’environnements distincts qui doivent être lancés.
Isolation stricte
Pour vérifier qu’une fonction UDF s’exécute toujours dans son propre environnement entièrement isolé, ajoutez la STRICT ISOLATION clause caractéristique.
La plupart des fonctions définies par l’utilisateur n’ont pas besoin d’isolation stricte. Les UDFs de traitement de données standard bénéficient de l’environnement d’isolation partagé par défaut et s’exécutent plus rapidement avec une consommation de mémoire inférieure.
Ajoutez la clause caractéristique STRICT ISOLATION aux UDF qui :
- Exécutez l’entrée en tant que code à l’aide de
eval(),exec()ou de fonctions similaires. - Écrivez des fichiers dans le système de fichiers local.
- Modifiez les variables globales ou l’état système.
- Accéder ou modifier des variables d’environnement.
Le code suivant présente un exemple d’UDF qui doit être exécutée à l’aide de STRICT ISOLATION. Cette fonction UDF exécute un code arbitraire Python, ce qui peut modifier l’état du système, accéder aux variables d’environnement ou écrire dans le système de fichiers local. L’utilisation de la clause STRICT ISOLATION permet d’empêcher les interférences ou les fuites de données entre les fonctions définies par l’utilisateur.
CREATE OR REPLACE TEMPORARY FUNCTION run_python_snippet(python_code STRING)
RETURNS STRING
LANGUAGE PYTHON
STRICT ISOLATION
AS $$
import sys
from io import StringIO

# Capture standard output and error streams
captured_output = StringIO()
captured_errors = StringIO()
sys.stdout = captured_output
sys.stderr = captured_errors

try:
    # Execute the user-provided Python code in an empty namespace
    exec(python_code, {})
except SyntaxError:
    # Retry with escaped characters decoded (for cases like "\n")
    def decode_code(raw_code):
        return raw_code.encode('utf-8').decode('unicode_escape')
    python_code = decode_code(python_code)
    exec(python_code, {})

# Return everything printed to stdout and stderr
return captured_output.getvalue() + captured_errors.getvalue()
$$
Définir DETERMINISTIC si votre fonction produit des résultats cohérents
Ajoutez DETERMINISTIC à votre définition de fonction s’il produit les mêmes sorties pour les mêmes entrées. Cela permet aux optimisations des requêtes d’améliorer les performances.
Par défaut, Azure Databricks considère les UDF Python Batch Unity Catalog comme non déterministes, sauf si vous indiquez explicitement le contraire. Parmi les exemples de fonctions non déterministes, citons la génération de valeurs aléatoires, l’accès aux heures ou dates actuelles ou l’exécution d’appels d’API externes.
Voir CREATE FUNCTION (SQL, Python, Scala et Java)
UDFs pour les outils des agents
Les agents IA peuvent utiliser les fonctions utilisateur (UDF) de Unity Catalog comme outils pour effectuer des tâches et exécuter une logique personnalisée.
Consultez Créer des outils d’agent à l’aide des fonctions de catalogue Unity.
Fonctions définies par l'utilisateur (UDF) pour accéder aux API externes
Vous pouvez utiliser des fonctions définies par l’utilisateur pour accéder aux API externes à partir de SQL. L’exemple suivant utilise la bibliothèque Python requests pour effectuer une requête HTTP.
Remarque
Les UDF Python autorisent le trafic réseau TCP/UDP sur les ports 80, 443 et 53 en cas d’utilisation du calcul serverless ou du calcul configuré avec le mode d’accès standard.
CREATE FUNCTION my_catalog.my_schema.get_food_calories(food_name STRING)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import requests

api_url = f"https://example-food-api.com/nutrition?food={food_name}"
response = requests.get(api_url)

if response.status_code == 200:
   data = response.json()
   # Assume the API returns a JSON object with a 'calories' field
   calories = data.get('calories', 0)
   return calories
else:
   return None  # API request failed

$$;
UDF pour la sécurité et la conformité
Utilisez les fonctions UDF Python pour implémenter des mécanismes de tokenisation, de masquage des données, de suppression des données ou de chiffrement personnalisés.
L’exemple suivant masque l’identité d’une adresse e-mail tout en conservant la longueur et le domaine :
CREATE OR REPLACE FUNCTION my_catalog.my_schema.mask_email(email STRING)
RETURNS STRING
LANGUAGE PYTHON
DETERMINISTIC
AS $$
parts = email.split('@', 1)
if len(parts) == 2:
  username, domain = parts
else:
  return None
masked_username = username[0] + '*' * (len(username) - 2) + username[-1]
return f"{masked_username}@{domain}"
$$
L’exemple suivant applique cette fonction UDF dans une définition de vue dynamique :
-- First, create the view
CREATE OR REPLACE VIEW my_catalog.my_schema.masked_customer_view AS
SELECT
  id,
  name,
  my_catalog.my_schema.mask_email(email) AS masked_email
FROM my_catalog.my_schema.customer_data;

-- Now you can query the view
SELECT * FROM my_catalog.my_schema.masked_customer_view;
+---+------------+------------------------+------------------------+
| id|        name|                   email|           masked_email |
+---+------------+------------------------+------------------------+
|  1|    John Doe|   john.doe@example.com |  j*******e@example.com |
|  2| Alice Smith|alice.smith@company.com |a**********h@company.com|
|  3|   Bob Jones|    bob.jones@email.org |   b********s@email.org |
+---+------------+------------------------+------------------------+
Meilleures pratiques
Pour que les UDF soient accessibles à tous les utilisateurs, Databricks recommande de créer un catalogue et un schéma dédiés avec des contrôles d’accès appropriés.
Pour les UDF définies par l’équipe, utilisez un schéma dédié dans le catalogue d’équipes pour le stockage et la gestion.
Databricks vous recommande d’inclure les informations suivantes dans le docstring UDF :
- Numéro de version actuel
- Journal des modifications pour suivre les modifications entre les versions
- Objet UDF, paramètres et valeur de retour
- Exemple d’utilisation de la fonction UDF
L’exemple suivant illustre une UDF qui respecte les meilleures pratiques :
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight_kg DOUBLE, height_m DOUBLE)
RETURNS DOUBLE
COMMENT "Calculates Body Mass Index (BMI) from weight and height."
LANGUAGE PYTHON
DETERMINISTIC
AS $$
 """
Parameters:
calculate_bmi (version 1.2):
- weight_kg (float): Weight of the individual in kilograms.
- height_m (float): Height of the individual in meters.

Returns:
- float: The calculated BMI.

Example Usage:

SELECT calculate_bmi(weight, height) AS bmi FROM person_data;

Change Log:
- 1.0: Initial version.
- 1.1: Improved error handling for zero or negative height values.
- 1.2: Optimized calculation for performance.

 Note: BMI is calculated as weight in kilograms divided by the square of height in meters.
 """
if height_m <= 0:
 return None  # Avoid division by zero and ensure height is positive
return weight_kg / (height_m ** 2)
$$;
Comportement du fuseau horaire pour les entrées traitées ligne par ligne
TIMESTAMP Une entrée est transmise à une UDF Python traitant les lignes une par une sous la forme d’une valeur datetime sans fuseau horaire en UTC. Sur le calcul classique, ce comportement nécessite Databricks Runtime 18.1 ou supérieur. Dans l’environnement de calcul serverless ainsi que dans les entrepôts de données SQL Pro et serverless, définissez explicitement le environment_version de l’UDF sur 6 ou une valeur supérieure. L’objet datetime n’inclut pas les métadonnées du fuseau horaire dans son tzinfo attribut.
Les UDF Python Unity Catalog par lots reçoivent des horodatages en entrée dans des objets pandas.Series et n’utilisent pas ce mappage datetime.
Cette modification aligne les UDFs Python du catalogue Unity sur les UDFs Python optimisés par Arrow dans Apache Spark.
Par exemple, la requête suivante définit explicitement la version 6 de l’environnement et le fuseau horaire de la session à UTC :
SET TIME ZONE 'UTC';

CREATE FUNCTION timezone_udf(date TIMESTAMP)
RETURNS STRING
LANGUAGE PYTHON
ENVIRONMENT (
  environment_version = '6'
)
AS $$
return f"{type(date)} {date} {date.tzinfo}"
$$;

SELECT timezone_udf(TIMESTAMP '2024-10-23 10:30:00');
Le chemin d’exécution précédent renvoie une valeur consciente du fuseau horaire dans le fuseau horaire de la session. Cela s’applique au calcul classique avant Databricks Runtime 18.1. Elle s’applique aussi au calcul serverless ainsi qu’aux entrepôts SQL pro et serverless lorsque vous omettez la ENVIRONMENT clause, définissez environment_version = 'None', ou sélectionnez une version antérieure à 6. Avec le fuseau horaire de la session réglé à UTC, le chemin antérieur produit :
<class 'datetime.datetime'> 2024-10-23 10:30:00+00:00 UTC
Avec la définition présentée, le calcul sans serveur ainsi que les entrepôts SQL Pro et sans serveur adoptent un comportement compatible avec PySpark. La capacité de calcul classique exécutant Databricks Runtime 18.1 ou version ultérieure utilise le même comportement lorsque vous modifiez ou omettez la clause ENVIRONMENT :
<class 'datetime.datetime'> 2024-10-23 10:30:00 None
Ce changement peut affecter les champs d’horloge ainsi que tzinfo. À l’instant 2024-10-23T10:30:00Z, le comportement précédent dans une session America/Los_Angeles produit 2024-10-23 03:30:00-07:00. Le nouveau comportement produit la valeur UTC 2024-10-23 10:30:00 sans fuseau horaire.
Si votre UDF s’appuie sur les informations sur les fuseaux horaires, rétablissez explicitement l’UTC :
from datetime import timezone

date = date.replace(tzinfo=timezone.utc)
L’ajout d’informations sur les fuseaux horaires UTC ne restaure pas les champs d’horloge locaux de session précédents. Si votre logique a besoin de ces champs, convertissez également la valeur avec fuseau horaire dans le fuseau horaire de session prévu. Par exemple:
from zoneinfo import ZoneInfo

date = date.astimezone(ZoneInfo("America/Los_Angeles"))
Limites
- Vous pouvez définir n’importe quel nombre de fonctions Python au sein d’une fonction UDF Python, mais tous doivent retourner une valeur scalaire.
- Les fonctions Python doivent gérer les valeurs NULL indépendamment, et tous les mappages de types doivent suivre les mappages de langage SQL Azure Databricks.
- Si vous ne spécifiez pas de catalogue ou de schéma, Azure Databricks enregistre les UDF Python dans le schéma actif actuel.
- Les UDF Python s’exécutent dans un environnement isolé et sécurisé et n’ont pas accès au système de fichiers ni aux services internes.
- Vous pouvez appeler plus de cinq UDF dans une requête sur le calcul classique exécutant Databricks Runtime 18.1 ou supérieur. Dans les environnements de calcul serverless ainsi que dans les entrepôts SQL Pro et serverless, chaque définition d’UDF doit explicitement définir
environment_versionsur6ou supérieur.