Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Cet article décrit un processus en six phases de migration d’une charge de travail alimentée par un LLM d’un modèle de base vers un autre : les éléments à prendre en compte à chaque phase, les fonctionnalités de Microsoft Foundry qui s’appliquent et la manière dont le travail évolue selon les différents types d’équipes.
Signification de la migration de modèle
Chaque modèle que vous exécutez en production a une date de mise hors service. Lorsqu’un modèle dont vous dépendez est remplacé ou qu’un modèle plus récent servira mieux votre charge de travail, vous migrez. L’échange d’un modèle n’est pas un changement d’une ligne : un autre modèle peut changer silencieusement le ton, la mise en forme, la forme JSON, la latence, le coût ou le comportement d’appel d’outils, et interrompre le code en aval qui dépend de l’ancien comportement.
Une migration réussie préserve le comportement de l’application ou l’améliore de manière mesurable. La réussite nécessite un processus reproductible pour détecter la dérive, s’adapter en toute sécurité et prouver la qualité avant le déploiement large.
Quand migrer
Une migration démarre généralement pour l’une des quatre raisons suivantes :
- Un modèle est mis hors service. Sur Foundry, chaque modèle généralement disponible est fourni avec une date de mise hors service, et les familles plus âgées sont remplacées au fil du temps. Pour connaître la politique de mise hors service et les dates, consultez le cycle de vie des modèles Foundry et la politique de support ainsi que le calendrier de mise hors service des modèles.
- Un meilleur modèle est disponible. Un modèle plus récent offre une meilleure qualité, un coût inférieur, une meilleure latence ou une fonctionnalité (par exemple, une sortie structurée ou un appel d’outil amélioré) dont votre charge de travail a besoin.
- Un problème de coût ou de latence force une modification. La latence ou le coût unitaire du modèle actuel ne répond plus à vos besoins.
- Un écart de capacité bloque le produit. Le modèle actuel ne peut pas faire quelque chose dont votre produit a maintenant besoin.
Ce qui se passe à la date de mise hors service
Ce que fait Azure lorsqu’un modèle est mis hors service dépend de la façon dont vous achetez de la capacité, et Foundry utilise une terminologie différente pour chaque chemin d’accès :
- Les déploiements Standard, Standard global et Data Zone Standard (paiement à l’utilisation) sont mis à niveau automatiquement selon une planification propagée, région par région. Vous contrôlez le moment en définissant
versionUpgradeOptionsur l’une des valeurs suivantes :OnceNewDefaultVersionAvailable,OnceCurrentVersionExpiredouNoAutoUpgrade(ce qui signifie que le déploiement cesse de fonctionner lors de la mise hors service). Le traitement prioritaire suit le même chemin. - Les déploiements provisionnés (PTU)ne sont pas mis à niveau automatiquement. Vous les migrez vous-même, soit sur place (le trafic est basculé sur une période de 20 à 30 minutes sans interruption de service), soit en parallèle (déployez la nouvelle version, testez-la, basculez le trafic, supprimez l’ancienne).
- Les déploiements par lots suivent la procédure côte à côte : déployer le nouveau modèle, soumettre de nouveau les travaux, mettre hors service l’ancien déploiement.
Quel que soit le chemin d’accès, le défi du développeur est le même : à une date définie, votre trafic commence à atteindre un autre modèle. Le fait qu’un point de terminaison réponde toujours ne signifie pas que votre application fonctionne encore correctement ; les charges de travail mises à niveau automatiquement comme celles migrées manuellement bénéficient donc de l’évaluation et de la validation décrites dans cet article.
Migrer avant la date de mise hors service
La mise à niveau automatique n’est qu’un filet de sécurité pour les déploiements avec paiement à l’utilisation, pas un plan de migration. Les déploiements provisionnés n’ont aucun filet de sécurité. De toute façon, ce n’est pas un substitut à un plan de migration. Deux engagements de stratégie vous permettent de migrer selon votre propre planification au lieu d’attendre l’échéance :
- Le modèle de remplacement devient disponible environ 90 jours avant la mise hors service dans global Standard, et environ 30 jours avant la mise hors service dans les régions approvisionnées où le prédécesseur prend sa retraite. Utilisez cette fenêtre pour évaluer le nouveau modèle et migrer manuellement.
- Les dates de mise hors service ne sont pas extensibles. Il n’existe aucun processus d’exception. Par conséquent, une date que vous n’avez pas planifiée s’applique toujours à vous.
Vous n’avez pas besoin d’avis de dépréciation pour commencer. Si un modèle plus récent est moins cher, plus rapide ou plus capable, exécutez-le maintenant. La migration transforme délibérément la date de retraite en une formalité. Étant donné que les migrations se répètent, il vaut la peine de répéter le processus.
Qui doit utiliser le processus de migration
Le processus de migration convient le mieux lorsque votre équipe crée une fonctionnalité basée sur LLM à l’intérieur d’un produit ou d’une plateforme plus volumineux, migre à peu près trimestriellement et dispose d’un propriétaire clair (par exemple, une équipe de plateforme centrale ou l’équipe d’application) exécutant délibérément chaque migration.
Ce processus s’adapte également aux équipes natives de l’IA, où le modèle est le produit. Les phases sont identiques, mais elles s’exécutent plus rapidement et souvent en parallèle plutôt qu’en séquence stricte.
Le processus suppose que vous passez d’un modèle de base à un autre, c’est-à-dire à des modèles que vous déployez tels qu’ils sont publiés dans le catalogue de modèles, sans personnalisation au niveau des poids. Les charges de travail affinées sont hors de portée. Ils ne peuvent pas être mis à niveau automatiquement, car ils ont leur propre échéance de retrait pour l’entraînement et le déploiement. Adapter des charges de travail affinées implique une distillation ou un réentraînement, plutôt que des modifications des instructions ou du schéma. Si vous exécutez des déploiements affinés, envisagez de procéder à une nouvelle optimisation par rapport au modèle de base de remplacement tôt.
Phases de migration
Une migration se déroule en six phases. Chaque phase produit une sortie utilisée par la phase suivante. Les phases de migration sont les suivantes :
Découvrir → Évaluer → Adapter → Valider le déploiement → → Mettre hors service
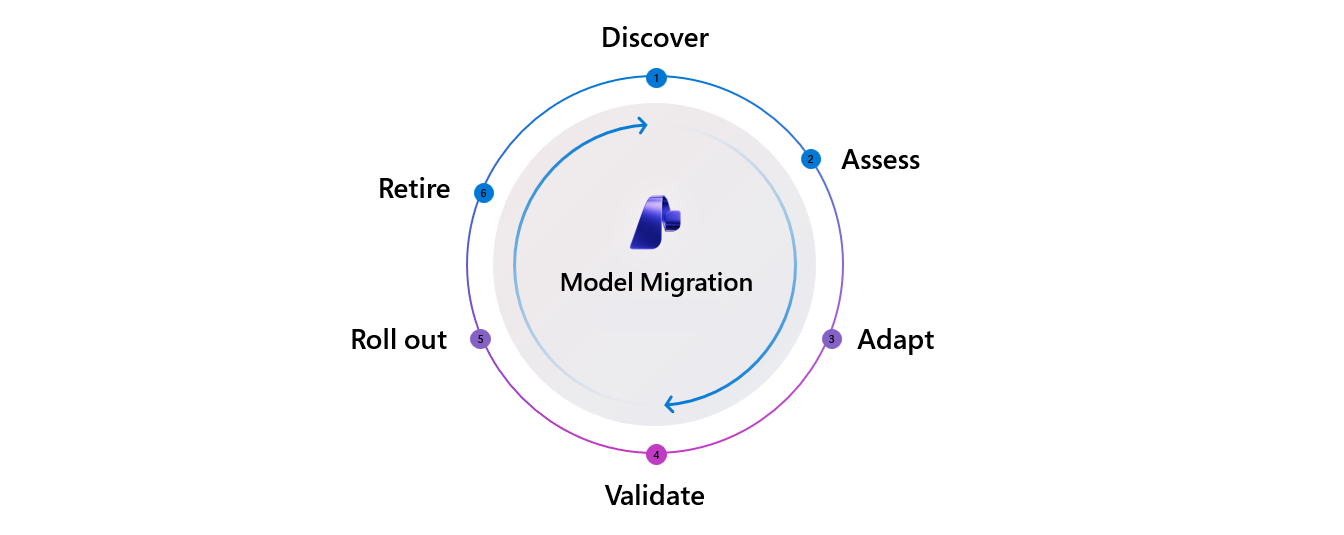
Le tableau suivant décrit chaque phase ainsi que les fonctionnalités et les outils Foundry qui les prennent en charge. Les fonctionnalités sont disponibles à la fois dans Microsoft Foundry et dans Azure OpenAI, sauf mention Foundry uniquement, ce qui signifie qu’Azure OpenAI n’a pas d’équivalent.
Les sections par phase plus loin dans cet article expliquent pourquoi chaque phase existe, à quoi ressemble un résultat réussi, à prendre en compte, quand utiliser chaque fonctionnalité et où la phase s’interrompt généralement.
| Phase | Description | Fonctionnalités et outils |
|---|---|---|
| Découvrez | Découvrez qu’un changement de modèle est à venir ou nécessaire, et décidez s’il faut agir. |
|
| Évaluer | Choisissez le modèle cible et vérifiez qu’il est opérationnel. |
|
| Adapter | Réexécutez la charge de travail actuelle sur le nouveau modèle, diagnostiquez les changements de comportement et redéfinissez les prompts, les paramètres, les définitions d’outils, les schémas de sortie et le code qui les appelle. |
|
| Procéder à la validation | Évaluer la charge de travail ajustée à l’aide d’une grille de qualité afin de déterminer si elle peut être livrée en toute sécurité. |
|
| Déployer | Déployez en production via un déploiement progressif, surveillez le comportement en production, puis validez définitivement ou revenez en arrière. |
|
| Mettre hors service | Mettez hors service l’ancien déploiement, libérez de la capacité, archivez les évaluations et mettez à jour la documentation des systèmes en aval. |
|
Avant de migrer : Préparer un jeu de données de test
Cette étape de préparation assemble un ensemble d’entrées représentatives, de sorties attendues et de critères de réussite convenus avant le début de tout travail de migration. Cet ensemble constitue une dépendance bloquante pour la partie centrale du processus : vous ne pouvez pas rejouer dans la phase Adapt sans entrées, et vous ne pouvez pas évaluer dans la phase Validate sans vérité terrain ni critères.
Éléments à prendre en compte
- Générez le jeu de données avant de choisir une cible. Le jeu de données décrit votre charge de travail, et non le modèle candidat, afin de pouvoir l’assembler en parallèle avec Discover.
- Rassemblez des entrées à partir de sources réelles ou synthétiques. Utilisez le trafic de production capturé ou des exemples de domaine organisés en tant que fichier CSV ou JSONL. Quand vous n’avez pas encore de données représentatives, générez des entrées synthétiques et contradictoires avec le simulateur.
- Instrumentez la capture avant d’en avoir besoin. La capture de contenu de production est opt-in et n’est jamais rétroactif. Vous ne pouvez donc pas évaluer le trafic que vous n’avez pas enregistré. Commencez à journaliser les prompts, les réponses, la latence et le nombre de tokens dès maintenant.
- Figer le jeu de données. Conservez les entrées, les vérités de base et les critères de réussite fixes pour l’ensemble de la migration. Si l’un d’eux change, vous ne pouvez plus comparer les résultats source et cible.
Vous avez également besoin d’un inventaire des déploiements de modèles que votre charge de travail utilise, y compris leurs types de déploiement (Standard, Provisionné ou Batch). Pour chaque modèle source, notez sa date de mise hors service et la suggestion de remplacement de la planification de mise hors service du modèle.
Phase 1 : Découvrir
L’objectif de la phase Découvrir est de reconnaître qu’un changement de modèle vient ou vaut la peine et de décider s’il faut agir. La sortie est une décision go/no-go, et rester sur le modèle actuel est un choix valide. Un résultat réussi est un signal précoce et structuré qui vous donne la date de dépréciation, le modèle de remplacement et la fenêtre de migration, ou une décision délibérée de rester sur le modèle actuel.
Éléments à prendre en compte
- Quelle est la date de mise hors service et combien de pistes avez-vous réellement ? Considérez la date d’abandon, moins le temps nécessaire à la validation et au déploiement, comme l’échéance réelle.
- Y a-t-il un remplacement suggéré, ou avez-vous besoin de mettre en liste les candidats vous-même ?
- La modification entraîne-t-elle des contraintes de conformité ou régionales (pour les charges de travail réglementées, la disponibilité et la certification sont-elles souvent importantes avant la qualité) ?
Là où cela échoue le plus souvent
Les équipes apprennent l’arrêt de certains services de manière incohérente, par e-mail, via une bannière sur le portail ou dans un message interne, et n’en prennent connaissance que tardivement. Ce délai raccourcit une fenêtre déjà serrée. Les développeurs indépendants et les petites équipes apprennent souvent la mise hors service d’un produit à la suite d’une erreur de production plutôt que par une annonce.
Ce que vous apportez
La planification de mise hors service et l’API Models exposent les données sur un contrat stable. Les organisations matures ajoutent une couche de notification interne mince en haut pour les acheminer vers les propriétaires appropriés.
Phase 2 : Évaluer
L’objectif de la phase Évaluer est de choisir le modèle cible candidat et de confirmer que vous pouvez l’exécuter : la région appropriée, le type de déploiement approprié, le quota suffisant et la disponibilité en même temps que le modèle actuel afin que la restauration reste possible. Un résultat réussi est un choix clair parmi les modèles candidats, avec la région, la référence SKU, le quota et le coût confirmés avant le démarrage du réglage.
Éléments à prendre en compte
- Qualité et positionnement entre candidats. Lorsque plusieurs modèles sont en lice, déterminez celui qui convient à votre charge de travail en fonction de la qualité, et pas simplement celui qui obtient le meilleur score sur un benchmark public.
- Coût de votre propre trafic. La structure tarifaire varie selon les générations de modèles. Les jetons de raisonnement, les entrées mises en cache et le surcoût lié aux sorties structurées peuvent faire varier l’économie unitaire du simple au double, voire davantage ; il faut donc estimer le coût mensuel à partir du trafic historique plutôt qu’en se fondant uniquement sur le prix catalogue.
- Disponibilité opérationnelle. Vérifiez la région, le SKU et le quota, et assurez-vous que la cible peut fonctionner côte à côte avec la source afin de conserver une possibilité de retour arrière.
- Vérification de la conformité. Pour les charges de travail réglementées, la certification et la disponibilité régionale peuvent filtrer la liste candidate avant que la qualité entre dans la conversation.
Là où cela échoue le plus souvent
La paralysie du choix se définit lorsque plusieurs candidats n’ont pas de positionnement clair. Les équipes découvrent seulement en cours de planification que le modèle choisi n’est pas disponible dans leur région ou pour leur SKU. Ou une projection de coût révèle que le nouveau modèle est matériellement plus coûteux sur le trafic réel.
Ce que vous apportez
Les benchmarks sont calculés sur des jeux de données publics . Par conséquent, traitez le classement comme un filtre plutôt que la ligne de fin et confirmez la liste abrégée par rapport à votre propre charge de travail. Pour la projection des coûts, c’est la même chose : la vue mensuelle provient de vos propres journaux de tokens, ce qui est simple une fois que vous disposez des données de trafic.
Phase 3 : Adaptation
L’objectif de la phase d’adaptation est de rendre la charge de travail efficace sur le nouveau modèle. Rejouez d’abord la charge de travail existante à l’identique (pour isoler les changements de comportement pilotés par le modèle), diagnostiquez ce qui a changé, puis revoyez sa conception de manière itérative. Un résultat réussi est une comparaison de comportement côte à côte par rapport au trafic réel ou représentatif, avec chaque modification suivie.
Adapter, c’est bien plus qu’une simple qu’éditer des prompts
Les prompts sont l’interface la plus visible, mais une migration en touche généralement quatre autres :
-
Paramètres.
temperature,top_p,max_tokens, et les contrôles de l’effort de raisonnement ne correspondent pas exactement d’une génération à l’autre, et les familles de modèles plus récentes peuvent ne pas prendre en charge certains paramètres. - Définitions d’outils. Vous devrez peut-être reformuler ou renforcer les noms d’arguments, les descriptions et les champs obligatoires qui ont guidé l’ancien modèle de manière fiable.
- Schémas de sortie. Les modèles diffèrent de la façon dont ils adhèrent à la sortie structurée. Vous devrez peut-être ajouter des contraintes explicites à un schéma que l’ancien modèle satisfait de manière lâche, ou vous pouvez enfin appliquer un schéma.
- Appel de code. Différences entre l’interface de l’API et le SDK (Chat Completions versus Responses, format du streaming et champs de requête nouveaux ou renommés). Vous devrez peut-être également mettre à jour l’analyse en aval qui a supposé l’ancienne forme de réponse.
Pour les charges de travail agentiques et les workflow, le travail sur les schémas et les appels d’outils l’emporte souvent sur le travail sur les prompts.
Éléments à prendre en compte
- Relisez sans modification avant de régler. Exécutez votre configuration actuelle sur le modèle cible sans aucune modification. Cette approche vous aide à séparer le comportement que le modèle a changé par rapport aux modifications que vous introduisez et vous donne une ligne de base.
- Regardez ce qui change réellement. Le niveau de verbosité, la profondeur du raisonnement, le respect du format de sortie structuré, le format des appels d’outil, le comportement de refus et la variabilité de la latence changent tous fréquemment.
- Relisez les traces réelles pour détecter les régressions liées aux appels d’outils. Champs supplémentaires, arguments renommés et surface de séquencement modifiée uniquement dans les traces réelles, pas dans les benchmarks à tour unique.
- Suivez vos modifications. La réingénierie de prompt est facile à faire et facile à perdre. Conservez l’original et enregistrez ce qui a changé et pourquoi.
Fonctionnalités de la fonderie
Trois fonctionnalités Foundry prennent en charge cette phase :
- L’optimiseur de prompts est le bouton Optimiser situé juste en dessous du champ des instructions système dans l’aire de test de l’agent. Il restructure vos instructions à l’aide de bonnes pratiques d’ingénierie rapide, montre le raisonnement par paragraphe pour chaque modification et prend en charge une boucle itération : ajoutez une suggestion telle que « conserver exactement le schéma JSON » et re-optimiser. Disponible uniquement dans Foundry, pas Azure OpenAI.
- L’optimisation de l’agent ajuste les instructions, les outils et la sélection de modèles ensemble pour les charges de travail de l’agent. Disponible uniquement dans Foundry, pas Azure OpenAI.
- Le simulateur génère des entrées synthétiques et contradictoires lorsque vous n’avez pas de données de production à relire.
Là où cela échoue le plus souvent
Pour les charges de travail embarquées et destinées au produit, cette phase prend généralement le plus de temps, car la boucle de diagnostic est manuelle : les équipes réexécutent les prompts, comparent les écarts et consignent rarement ce qu’elles ont modifié ni pourquoi.
Ce que vous apportez
- Commencez par les optimiseurs, puis vérifiez. Ils appliquent des meilleures pratiques générales dans une seule passe plutôt que de s’adapter à votre jeu de données, et ils ajustent le texte d’instruction plutôt que les définitions d’outils ou les schémas de sortie. Considérez le résultat comme une base solide : copiez d’abord votre prompt initial (il n’y a pas d’historique des versions), puis réévaluez-le à l’aide de votre jeu de données figé avant de vous fier à cette modification.
- Planifiez un travail pratique supplémentaire pour les déplacements inter-familles. Il n’existe pas de processus « optimiser pour le modèle cible X » ; passer d’une famille de modèles à une autre implique donc une traduction délibérée des prompts et des schémas.
- Enregistrez le trafic avant d’en avoir besoin. La relecture ne vaut que par la qualité de votre capture, et la capture du contenu nécessite une activation explicite et n’est jamais rétroactive.
Phase 4 : Valider
L’objectif de la phase de validation est de déterminer si la charge de travail adaptée est sécurisée pour être fournie en la scoringant par rapport à une rubrique de qualité sur un jeu de données organisé. La rubrique peut être basée sur des règles, basées sur des références, un LLM en tant que juge, un examen humain ou un cadre spécifique au domaine. Un résultat réussi consiste à fournir une suite d’évaluation approuvée, exécutée sur un jeu de données figé, que l’équipe d’application et tous les réviseurs croient.
Validate est une phase, mais elle comporte deux points de contact ; ne la considérez donc pas comme un événement unique en fin de ligne :
- Préparez-vous tôt. Figez le jeu de données et les critères de réussite dans Avant de migrer, avant d’adapter. Le moment où ces changements changent, votre source et votre cible arrêtent d’être comparables.
- Porte tardive, en deux passes. Tout d’abord, exécutez le modèle actuel sur l’ensemble figé pour établir une base de référence source, le nombre que vous devez battre. Attribuez ensuite une note à la cible sur le même ensemble et décidez.
Éléments à prendre en compte
- Conservez le jeu de données et les critères gelés. Il s’agit de la discipline la plus importante dans le processus de maintien des résultats comparables.
- Mesurez les trois dimensions qui correspondent à la validation finale : la qualité (scores de l’évaluateur ou du réviseur), la latence (délai jusqu’au premier jeton et débit, limités à l’appel que vous migrez) et le coût (coût des jetons d’entrée et de sortie par requête).
- Associez la grille d’évaluation à la charge de travail. Une rubrique de synthèse clinique, une assertion de séquencement d’appel d’outils pour les agents ou des signaux de rétroaction utilisateur préexistants peuvent être plus significatifs qu’un score générique.
- Considérez ce jalon comme un signal pour les équipes nativement IA. Au lieu d’une réussite/d’un échec unique, l’évaluation s’exécute en continu, sur chaque validation et fusionne avec Déploiement.
Fonctionnalités de la fonderie
Deux fonctionnalités Foundry prennent en charge cette phase :
- Azure AI Evaluation SDK comprend plus de 30 évaluateurs intégrés, couvrant l’ancrage factuel, la pertinence, la recherche, la cohérence, la fluidité, les métriques fondées sur des références (F1, BLEU et ROUGE), la sécurité, les agents et les évaluateurs Azure OpenAI. Il comprend également un LLM personnalisé servant de juge pour des grilles d’évaluation propres à la tâche.
- L’évaluation du portail exécute les mêmes évaluateurs sur des cibles de modèle, d’agent, de jeu de données et de trace.
Exécutez le même ensemble d’évaluateurs sur à la fois la source et la cible dans le jeu de données gelé afin que les résultats soient comparables.
| Dimension | Ce qu'il faut mesurer | Where |
|---|---|---|
| Qualité | Scores de l’évaluateur sur la source et la cible | Azure SDK d’évaluation IA, évaluation du portail |
| Latency | Temps jusqu’au premier token et débit | Classement des benchmarks, métriques opérationnelles |
| Cost | Coût du jeton d’entrée et de sortie par requête | Sorties d’évaluation, tarification des modèles |
Là où cela échoue le plus souvent
La plupart des équipes n’ont pas de suite d’évaluation, et celles qui en ont une l’ont souvent conçue elles-mêmes. Pour les charges de travail réglementées, un examen obligatoire de gestion humaine ou de qualité se trouve en haut et devient le goulot d’étranglement. Ces migrations se bloquent à Validate, pas à Adapter.
Ce que vous apportez
Les évaluateurs sont prêts à s’exécuter, mais l’organisation d’un jeu de test pertinent sur le domaine à partir de votre propre trafic de production est un travail pratique pour les charges de travail de modèle (non agent). C’est pourquoi l’étape de préparation est vite rentabilisée.
Phase 5 : Déploiement
L’objectif de cette phase est de déployer progressivement la configuration validée en production : d’abord dans les environnements hors production, puis via un pourcentage pondéré ou de contrôle de validité, avant un déploiement plus large. Tout au long, regardez la latence en direct, les erreurs et, dans l’idéal, la qualité par rapport à la base de référence de pré-migration. Ensuite, validez ou annulez. Une issue favorable repose sur une exposition progressive du trafic via un trafic fantôme, pondéré ou de contrôle de validité sur un signal de qualité en temps réel qui ne se limite pas à la latence et aux erreurs, et sur une possibilité de retour arrière préservée.
Éléments à prendre en compte
- Connaissez votre type de déploiement. Votre type de déploiement détermine la mécanique : les déploiements de famille standard peuvent effectuer une mise à niveau automatique selon une planification que vous contrôlez. Les déploiements provisionnés, par lot et affinés migrent manuellement. Le tableau suivant présente les mécanismes par type.
- Préservez une possibilité de retour arrière. Conservez l’ancien déploiement accessible jusqu’à ce que vous soyez confiant. Des décisions de retour en arrière imposées par une date limite de dépréciation plutôt que par des éléments concrets sont un signal d’alarme indiquant que vous avez commencé trop tard.
- Lorsque vous ne pouvez pas utiliser de contrôle de validité, utilisez le mode fantôme ou miroir. Les flux réglementés (PHI, transactions financières) ne peuvent souvent pas exposer un nouveau modèle au trafic réel des clients. L’équivalent exécute le nouveau modèle sur les entrées de production hors connexion et compare les sorties à l’ancien modèle sans affecter les utilisateurs.
- Surveillez les régressions non détectées par l’évaluation hors ligne. La latence réelle des utilisateurs et le comportement dans les cas limites ne peuvent se manifester qu’en charge de production.
Mécanismes de migration par type de déploiement
| Type de déploiement | Approche de migration | Quota |
|---|---|---|
| Standard, Standard global, Standard de la zone de données | Mise à niveau automatique selon un calendrier progressif. Contrôler le minutage avec versionUpgradeOption (OnceNewDefaultVersionAvailable, OnceCurrentVersionExpiredou NoAutoUpgrade). Le traitement prioritaire suit le même chemin. |
Effectue automatiquement le basculement |
| Approvisionné | Manuel : sur place (le trafic se déplace sur une fenêtre de 20 à 30 minutes) ou côte à côte (nouveau déploiement, décalage du trafic, suppression de l’ancien). | Vérifiez d’abord le quota de modèle cible |
| Batch | En parallèle : déployez le nouveau modèle, soumettez à nouveau les tâches, puis mettez l’ancien déploiement hors service. | Assurez-vous de disposer d’un quota pour le modèle cible |
| Affiné (hors de portée pour cet article) | Pas de mise à niveau automatique ; calendrier distinct de retrait pour l’entraînement et le déploiement. Réajuster ou effectuer une distillation sur le modèle de base de remplacement. | Assurez-vous de disposer d’un quota pour le modèle cible |
Une fois le trafic basculé, configurez l’évaluation continue pour évaluer un pourcentage échantillonné du trafic de production dans le tableau de bord Observabilité Foundry, relié aux traces pour l’analyse des causes profondes, ainsi que des alertes Azure Monitor lorsque la qualité baisse.
Là où cela échoue le plus souvent
Les régressions de qualité manquées par l’évaluation hors connexion apparaissent sous la charge de production. Les décisions de retour en arrière sont souvent imposées par une date limite de dépréciation plutôt que prises sur la base de faits concrets, ce qui indique que la migration a commencé trop tard.
Ce que vous apportez
Le routage pondéré entre deux déploiements s’effectue au niveau de votre propre passerelle ou de la couche d’application, et la période de retour en arrière relève d’un choix délibéré consistant à maintenir l’ancien déploiement actif pendant une certaine période (les équipes embarquées souhaitent généralement environ 30 jours). Les deux valent la peine d’être conçus une seule fois et réutilisés pour chaque migration.
Phase 6 : Mettre hors service
L’objectif de la phase de mise hors service est de décommissionner l’ancien déploiement, de libérer de la capacité, d’archiver les artefacts d’évaluation et de répercuter ce changement dans la documentation destinée aux clients, les pages marketing, les procédures opérationnelles du support et les journaux d’audit lorsque leur conservation est requise. À la fin, l’ancien déploiement a disparu, le nombre de déploiements diminue, et les enseignements sont reportés au cycle suivant.
Éléments à prendre en compte
- Traitez la retraite comme la gouvernance, pas seulement le nettoyage. Pour les charges de travail réglementées, les obligations de rétention peuvent nécessiter la conservation des artefacts pendant des années.
- Vérifiez que la source a bien disparu. Vérifiez que l’ancienne version est supprimée, puis supprimez le déploiement afin qu’il cesse de consommer de la capacité.
- Mettez les enseignements à profit pour la suite. Réintégrez les traces de production récentes dans votre jeu de données de référence afin que la migration suivante coûte moins cher au démarrage.
Là où cela échoue le plus souvent
Les équipes font l’impasse sur la mise hors service, ce qui entraîne une accumulation de déploiements zombies. Les équipes qui ne sont pas activement mises hors service effectuent beaucoup plus de déploiements en direct que leurs homologues, et la plupart de ces éléments sont des débris structurels provenant des migrations antérieures. Une sous-étape manquée courante est la communication : la documentation marketing et produit fait toujours référence à l’ancien modèle après l’échange.
Ce que vous apportez
Le tableau de bord d’observabilité montre le nombre de déploiements en baisse, mais décider quels déploiements sont toujours porteurs est un jugement que votre équipe effectue. Faites en sorte que la mise hors service soit une tâche suivie explicite plutôt qu’un espoir.
La migration est rarement binaire
Les migrations réelles sont souvent fractionnées : une partie d’une charge de travail s’exécute sur le nouveau modèle, tandis qu’un chemin sensible à la latence ou à risque plus élevé reste sur l’ancien, parfois pendant des semaines. Prévoyez un déploiement partiel et un retour arrière partiel plutôt qu’une bascule unique de l’ancien modèle vers le nouveau. La mise hors service intervient souvent plusieurs semaines ou plusieurs mois après le déploiement, et ces anciens déploiements qui persistent sont précisément ce qui apparaît comme de la prolifération.
Contenu connexe
- Comprendre les calendriers de dépréciation et de prise en charge dans la stratégie de cycle de vie et de prise en charge des modèles Foundry
- Vérifier les dates de mise hors service et les remplacements dans la planification de mise hors service du modèle
- Découvrez quels éléments sont déjà mis hors service dans les modèles Microsoft Foundry mis hors service
- Comparer les modèles candidats avec les benchmarks de modèle et les classements
- Adaptez les prompts à un nouveau modèle avec Optimisez les prompts avec Prompt Optimizer
- Valider la qualité avant de passer en exécutant des évaluations à partir du portail Foundry
- Surveiller la charge de travail migrée avec observabilité dans l’IA générative