Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
S’applique à :✅ point de terminaison pour les analyses SQL et entrepôt de données dans Microsoft Fabric
Important
Cette fonctionnalité est en version préliminaire.
Le clustering de données dans Fabric Data Warehouse organise les données pour accélérer les performances des requêtes et réduire l’utilisation du calcul. Ce tutoriel décrit les étapes de création de tables avec clustering de données, de la création de tables en cluster à la vérification de leur efficacité.
Prerequisites
- Un compte de locataire Microsoft Fabric avec un abonnement actif.
- Vérifiez que vous disposez d’un espace de travail avec Microsoft Fabric : Créer un espace de travail.
- Vérifiez que vous avez déjà créé un entrepôt. Pour créer un entrepôt, reportez-vous à Créer un entrepôt dans Microsoft Fabric.
- Compréhension de base des données T-SQL et interrogation des données.
Importer des exemples de données
Ce tutoriel utilise l’exemple de jeu de données NY Taxi. Pour importer les données des taxis NY dans votre entrepôt. Utilisez le didacticiel Charger des données d'exemple dans un entrepôt de données.
Créez une table avec le regroupement de données
Pour ce tutoriel, nous avons besoin de deux copies de la table NYTaxi : la copie régulière de la table telle qu’importée à partir du didacticiel et une copie qui utilise le clustering de données. Utilisez la commande suivante pour créer une table à l’aide CREATE TABLE AS SELECT de (CTAS), basée sur la table NYTaxi d’origine :
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
Note
L'exemple suppose que le nom de table est attribué au jeu de données NY Taxi, dans le didacticiel "Charger des exemples de données dans Data Warehouse". Si vous avez utilisé un autre nom pour votre table, ajustez la commande à remplacer nyctlc par votre nom de table.
Cette commande crée une copie exacte de la table NYTaxi d’origine, mais avec un regroupement de données sur la colonne lpepPickupDatetime. Ensuite, nous utilisons cette colonne pour l’interrogation.
Rechercher des données
Exécutez une requête sur la table NYTaxi et répétez exactement la même requête sur la table NYTaxi_With_DataClustering pour la comparaison.
Note
Pour cette analyse, il est utile d’examiner les performances du cache à froid des deux exécutions, c’est-à-dire sans utiliser les fonctionnalités de mise en cache de Fabric Data Warehouse. Par conséquent, exécutez chaque requête exactement une fois avant d’examiner les résultats dans Query Insights.
Nous utilisons une requête qui est souvent répétée dans l’entrepôt. Cette requête calcule le montant moyen des tarifs par année entre les dates 2008-12-31 et 2014-06-30:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
Note
L’option d’étiquette utilisée dans cette requête est utile lorsque nous comparons les détails de la requête de la table contre celle qui utilise le regroupement de données plus tard à l'aide des vues Query Insights.
Ensuite, nous répétons exactement la même requête, mais sur la version de la table qui utilise le clustering de données :
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
La deuxième requête utilise l’étiquette Clustered pour nous permettre d’identifier cette requête ultérieurement avec Query Insights.
Vérifier l’efficacité du clustering de données
Après avoir configuré le clustering, vous pouvez évaluer son efficacité à l’aide de Query Insights. Query Insights dans Fabric Data Warehouse capture les données d’exécution des requêtes historiques et les agrège en insights actionnables, tels que l’identification de requêtes longues ou fréquemment exécutées.
Dans ce cas, nous utilisons Query Insights pour comparer la différence entre les données analysées entre les cas standard et cluster.
Utilisez la requête suivante :
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
Cette requête extrait les détails de la exec_requests_history vue. Pour plus d’informations, consultez queryinsights.exec_requests_history (Transact-SQL).
La requête filtre les résultats de la manière suivante :
- Récupère uniquement les lignes qui contiennent le
NYTaxitexte dans le nom de la commande (comme utilisé dans les requêtes de test) - Récupère uniquement les lignes où la valeur d’étiquette était normale ou en cluster
Note
La disponibilité des détails de votre requête peut prendre quelques minutes dans Query Insights. Si votre requête Query Insights ne retourne aucun résultat, réessayez après quelques minutes.
En exécutant cette requête, nous observons les résultats suivants :

Les deux requêtes ont un nombre de lignes de 6 et des heures d’envoi similaires. La Clustered requête indique total_elapsed_time_ms 1794, allocated_cpu_time_ms 1676 et data_scanned_remote_storage_mb 77,519. La Regular requête indique total_elapsed_time_ms 2651, allocated_cpu_time_ms 2600 et data_scanned_remote_storage_mb 177,700. Ces nombres montrent que même si les deux requêtes ont retourné les mêmes résultats, la Clustered version a utilisé environ 36% moins de temps processeur que la version et analysé environ 56% moins de données sur le Regular disque. Aucun cache n’a été utilisé dans l’une ou l’autre exécution de requête. Il s’agit de résultats significatifs pour réduire le temps d’exécution des requêtes et la consommation des ressources, et faire de la lpepPickupDatetime colonne un candidat fort pour le clustering de données.
Note
Il s’agit d’une petite table, avec environ 76 millions de lignes et 2 Go de volume de données. Même si cette requête retourne seulement six lignes sur son agrégation (une pour chaque année dans la plage), elle analyse environ 8,3 millions de lignes dans la plage de dates fournie avant l’agrégation des résultats. Les données de production réelles avec des volumes de données plus volumineux peuvent fournir des résultats plus significatifs. Vos résultats peuvent varier en fonction de la taille de capacité, des résultats mis en cache ou de la concurrence pendant les requêtes.
Choisissez les colonnes de regroupement parmi votre charge de travail
Pour les tables de production, utilisez des motifs de requête observés au lieu de deviner quelles colonnes regrouper. La capacité opérationnelle de la sqldw-cli compétence analyse l’historique de Query Insights, classe les schémas de requêtes récurrentes par données scannées à distance, et identifie les colonnes utilisées dans WHERE les prédicats.
Avant de commencer, installez Skills pour Fabric, assurez-vous que l’entrepôt a fait l’objet d’une activité de requête récente et confirmez que vous disposez du rôle Contributeur dans l’espace de travail, ou d’un rôle supérieur. Ensuite, ouvrez la ligne de commande GitHub Copilot et utilisez une invite comme celle-ci :
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
La compétence identifie les schémas de requête ayant le plus grand impact de balayage, extrait les tables et les colonnes de filtres de ces requêtes, et classe les candidats au regroupement. Consultez les recommandations avec ces directives :
- Privilégiez les colonnes qui filtrent de façon répétée de grandes tables et utilisent des valeurs de cardinalité moyennes à élevées, telles que les dates ou les identifiants.
- Privilégiez les colonnes utilisées dans des prédicats de plage sélectifs ou d’égalité dans la clause
WHERE. - Ne sélectionnez pas uniquement les colonnes parce qu’elles apparaissent dans des conditions de jointure par égalité. Ces conditions ne bénéficient pas du regroupement de données.
- N’utilisez pas plus de quatre colonnes de regroupement, et n’ajoutez pas plus de colonnes que la charge de travail requise.
Par exemple, considérons un entrepôt e-commerce qui Sales.SalesOrder contient 1,5 milliard de lignes et Sales.OrderLine 6 milliards de lignes. Après avoir analysé les requêtes récurrentes, la compétence peut renvoyer les recommandations suivantes :
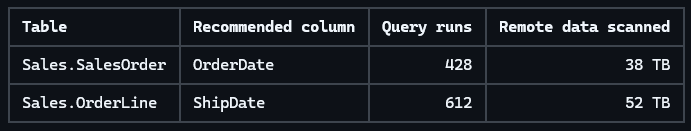
Les colonnes de date sont de fortes candidatures car elles filtrent les plus grandes tables, supportent les prédicats de plage commune, et offrent plus d’opportunités de saut de fichiers que les colonnes de faible cardinalité telles que OrderStatus ou SalesRegion.
La sqldw-cli capacité opérationnelle est en lecture seule. Il recommande des colonnes mais ne crée ni ne remplace les tableaux. Après avoir examiné la recommandation, utilisez CTAS pour créer une copie groupée du tableau :
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
Comparez les charges de travail groupées et non regroupées pour vérifier l’effet. Après avoir validé la table clusterée, renomme la table originale puis renomme la table clusterée avec son nom d’origine :
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
Le tableau d’origine reste disponible sous Sales.SalesOrder_old pour la restauration. Vérifiez les charges de travail dépendantes et la nouvelle table avant de supprimer la table originale. Lorsque vous n’avez plus besoin de la copie de restauration, supprimez-la :
DROP TABLE Sales.SalesOrder_old;
Contenu connexe
- Regroupement de données dans Fabric Data Warehouse
- Informations sur les requêtes dans l'Entrepôt de Données Fabric
- Surveiller l’entrepôt de données Fabric
- Utiliser des étiquettes de requête dans Fabric Data Warehouse
- Compétence en opérations d’entrepôt sqldw-cli
- Installez les compétences pour Fabric