Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Lorsque des agents déclaratifs sont utilisés dans l’expérience Copilot dans Microsoft 365 Apps, ils peuvent interagir avec le document ouvert. Par défaut, les agents peuvent lire l’intégralité du document ouvert. Les utilisateurs peuvent fournir uniquement une section sélectionnée du document ouvert à l’agent, et les agents peuvent insérer des images dans le document ouvert.
Cet article traite de l’interaction avec les documents par les agents déclaratifs et non de la prise en charge du package de plug-in complet dans Word ou PowerPoint. Pour le modèle de plug-in plus large, consultez Plug-ins pour Microsoft 365 Copilot.
Remarque
L’accès à la sélection de document est uniquement pris en charge dans Word. L’accès à l’intégralité du document ouvert et l’insertion d’images sont pris en charge dans Word et PowerPoint.
Accéder à l’intégralité du document ouvert
Lorsque l’utilisateur fait référence au document ouvert dans son invite, le contenu du document est automatiquement ajouté à l’invite, ce qui permet à l’agent d’y accéder sans autre action de l’utilisateur. Par exemple, l’utilisateur peut inviter l’agent avec « Résumer ce document » ou « Rechercher des éléments d’action dans ce fichier ».
Format du document
Le format des informations fournies à l’agent varie en fonction du type de fichier.
Pour les documents Word, le contexte fourni à l’agent se compose entièrement de contenu en texte brut, y compris des titres, des paragraphes de corps et des éléments de liste. Le flux logique du document est conservé par le biais d’un tronçonnage séquentiel, ce qui permet à l’agent de déduire la structure du document en fonction de modèles textuels. Les éléments non textuels tels que les tableaux, les graphiques, les images, la mise en forme des pages et le style ne sont pas capturés. Les mentions de ces objets visuels ainsi que des métadonnées adjacentes sont disponibles dans le cadre du contexte, mais l’agent n’a pas accès à leur contenu réel.
Pour les présentations PowerPoint, le contexte fourni à l’agent inclut tous les titres de diapositives visibles, le corps du texte et les descriptions aplaties des tableaux et des images, le cas échéant. Le flux des diapositives et la narration logique sont conservés grâce à l’indexation séquentielle. Les éléments non textuels tels que les images, les graphiques complexes, les conceptions d’arrière-plan, les transitions, les liens hypertexte et les notes détaillées du présentateur ne sont pas capturés. Par conséquent, bien que l’agent puisse raisonner sur le contenu textuel et les descriptions de haut niveau des éléments visuels, il n’a pas accès aux médias enrichis, aux dispositions visuelles détaillées et aux données graphiques structurées.
Utilisation du document ouvert dans votre assistant
Les agents déclaratifs ont accès au document ouvert par défaut. Aucune modification n’est requise pour votre agent pour activer la prise en charge de cette fonctionnalité.
Utilisation du document ouvert dans les plug-ins API
Si votre agent inclut des plug-ins d’API en tant qu’actions personnalisées, l’agent décide de la quantité du document ouvert à envoyer à l’API en fonction de la description de votre API et des instructions données à l’agent. Pour plus d’informations, voir Considérations relatives aux plug-ins d’API pour le contenu des documents.
Sélection de documents Access
La fonctionnalité de sélection de document permet aux utilisateurs de fournir la section actuellement sélectionnée du document ouvert à l’agent déclaratif. L’utilisateur peut interroger l’agent sur la sélection ou lui demander de prendre des mesures en fonction de celle-ci.
Par exemple, un utilisateur travaille sur un document de description de tâche et souhaite ajouter une image générée par l’IA au document pour ajouter un aspect visuel. L’utilisateur commence par sélectionner une section du document comme contexte pour l’image. La sélection d’une section du document active le bouton Ajouter une sélection dans le volet de conversation Copilot.
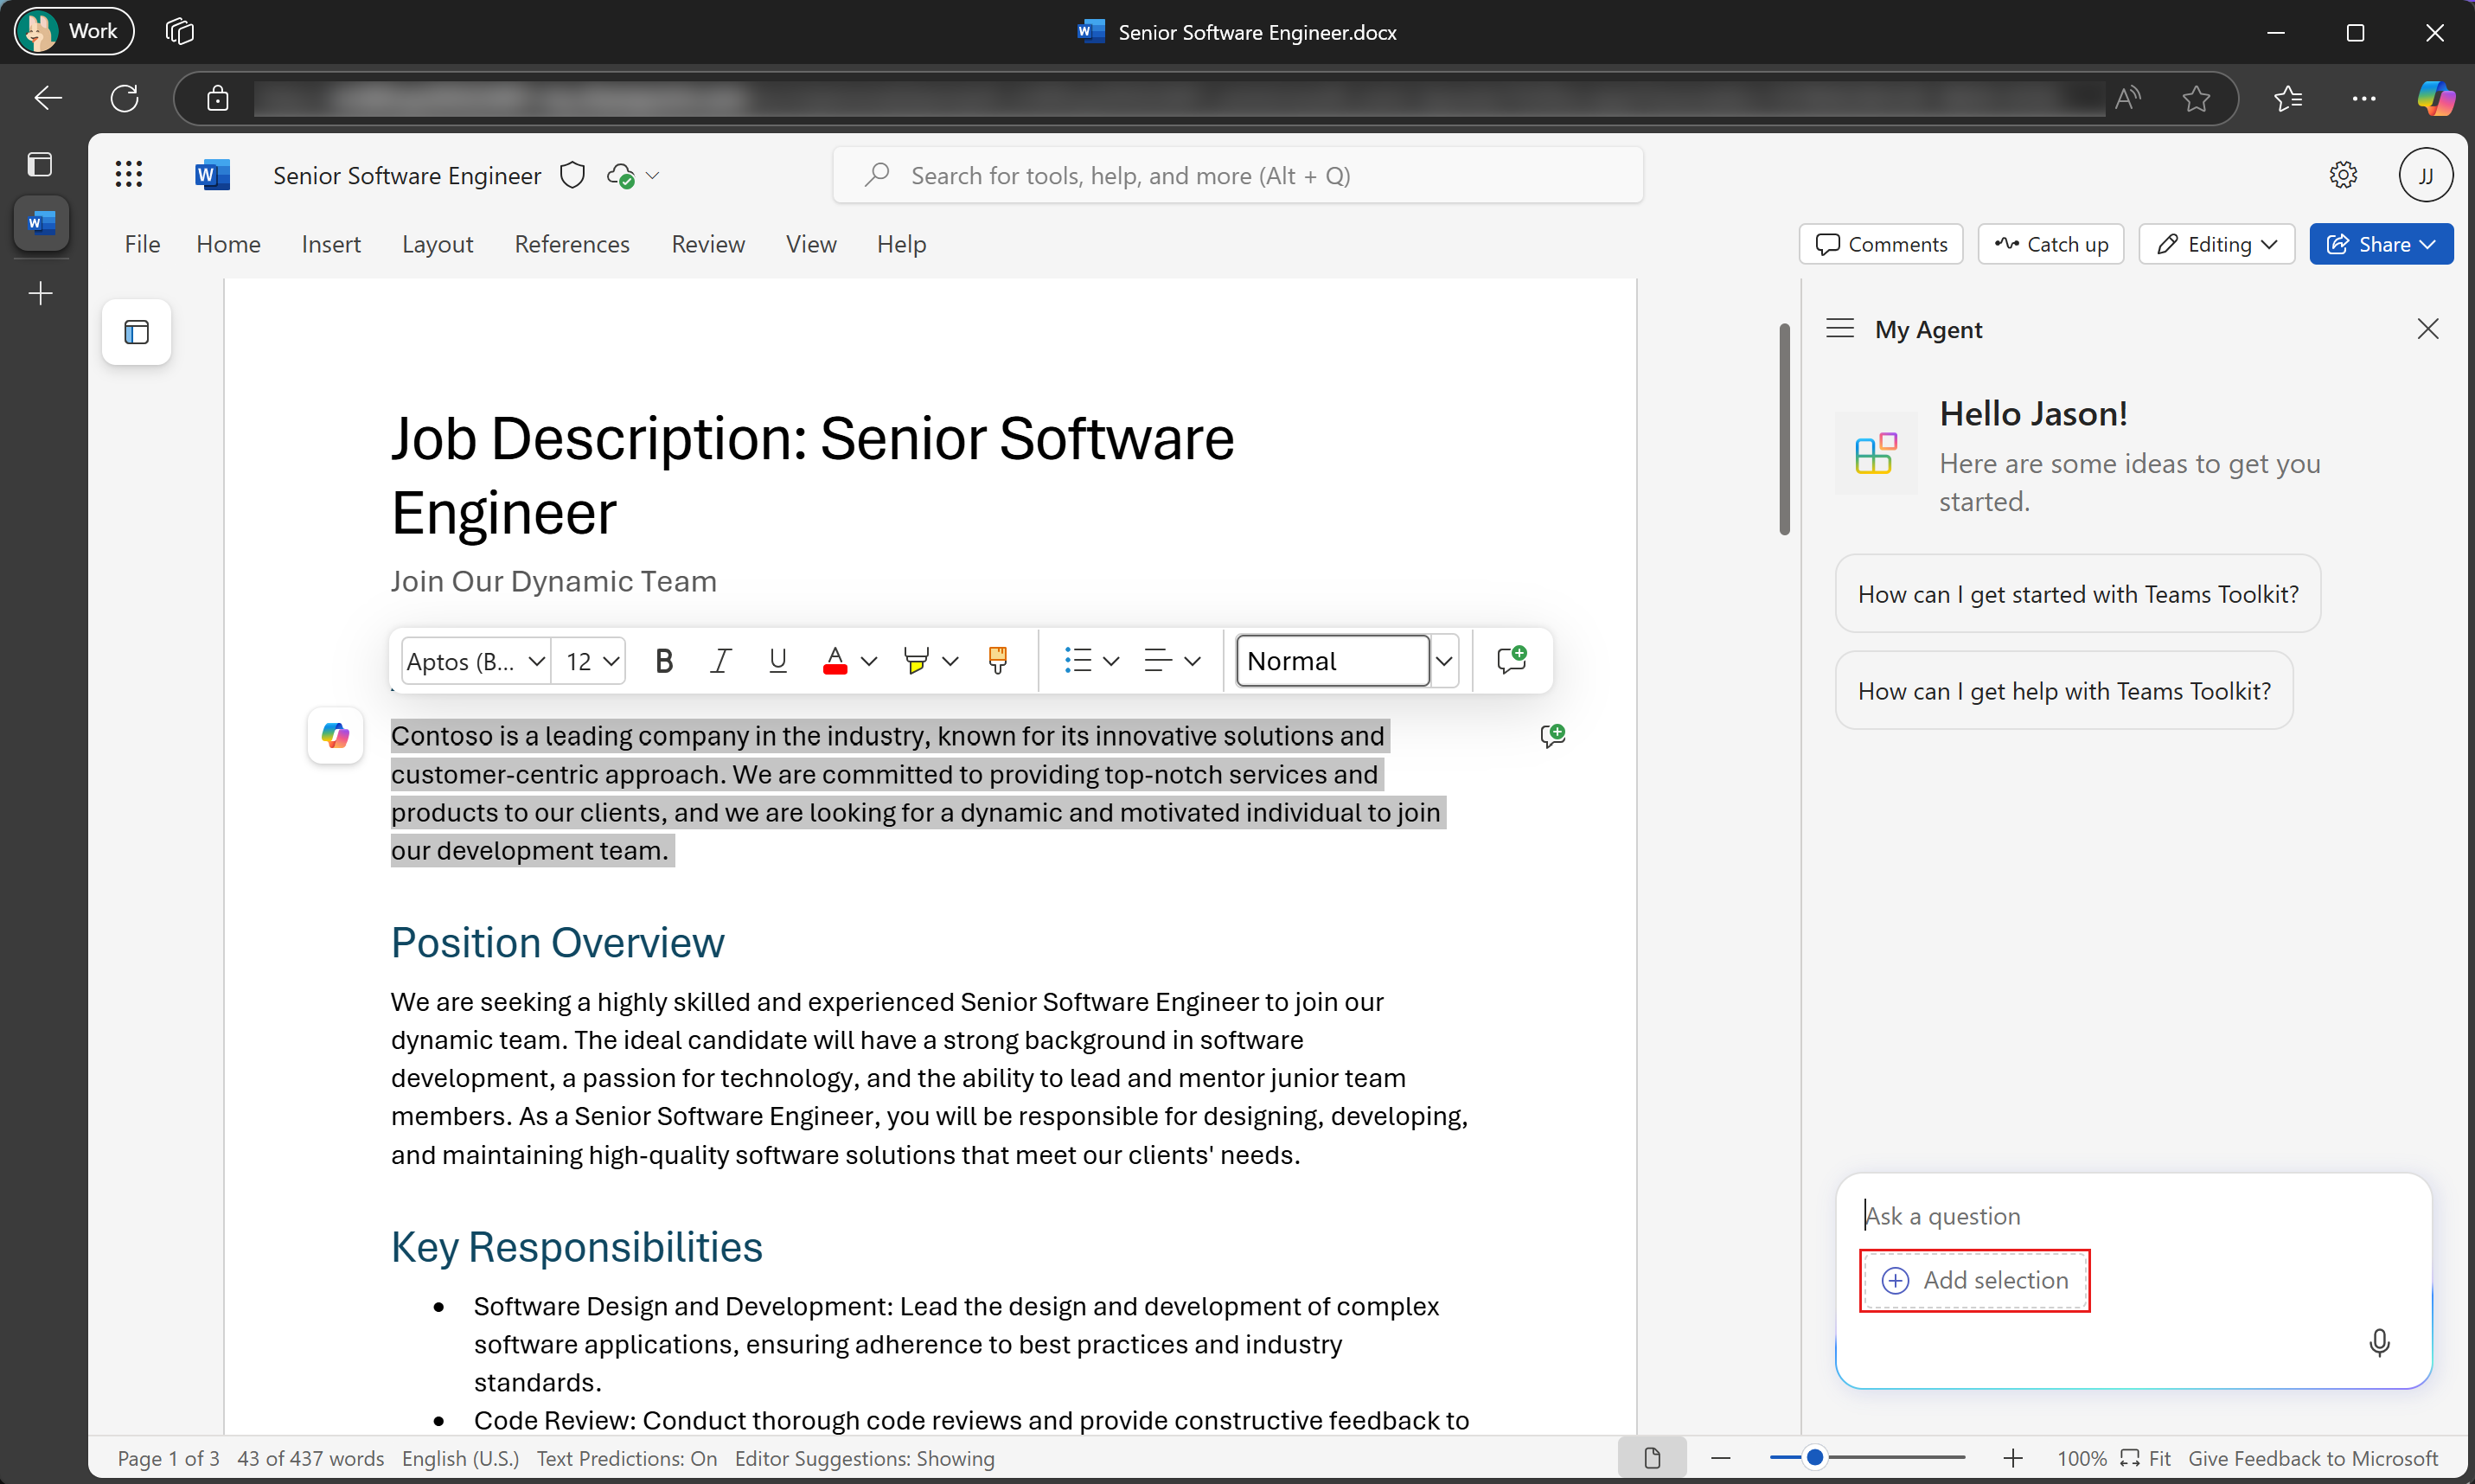
L’utilisateur sélectionne Ajouter une sélection , puis demande à l’agent de générer une image basée sur la sélection.
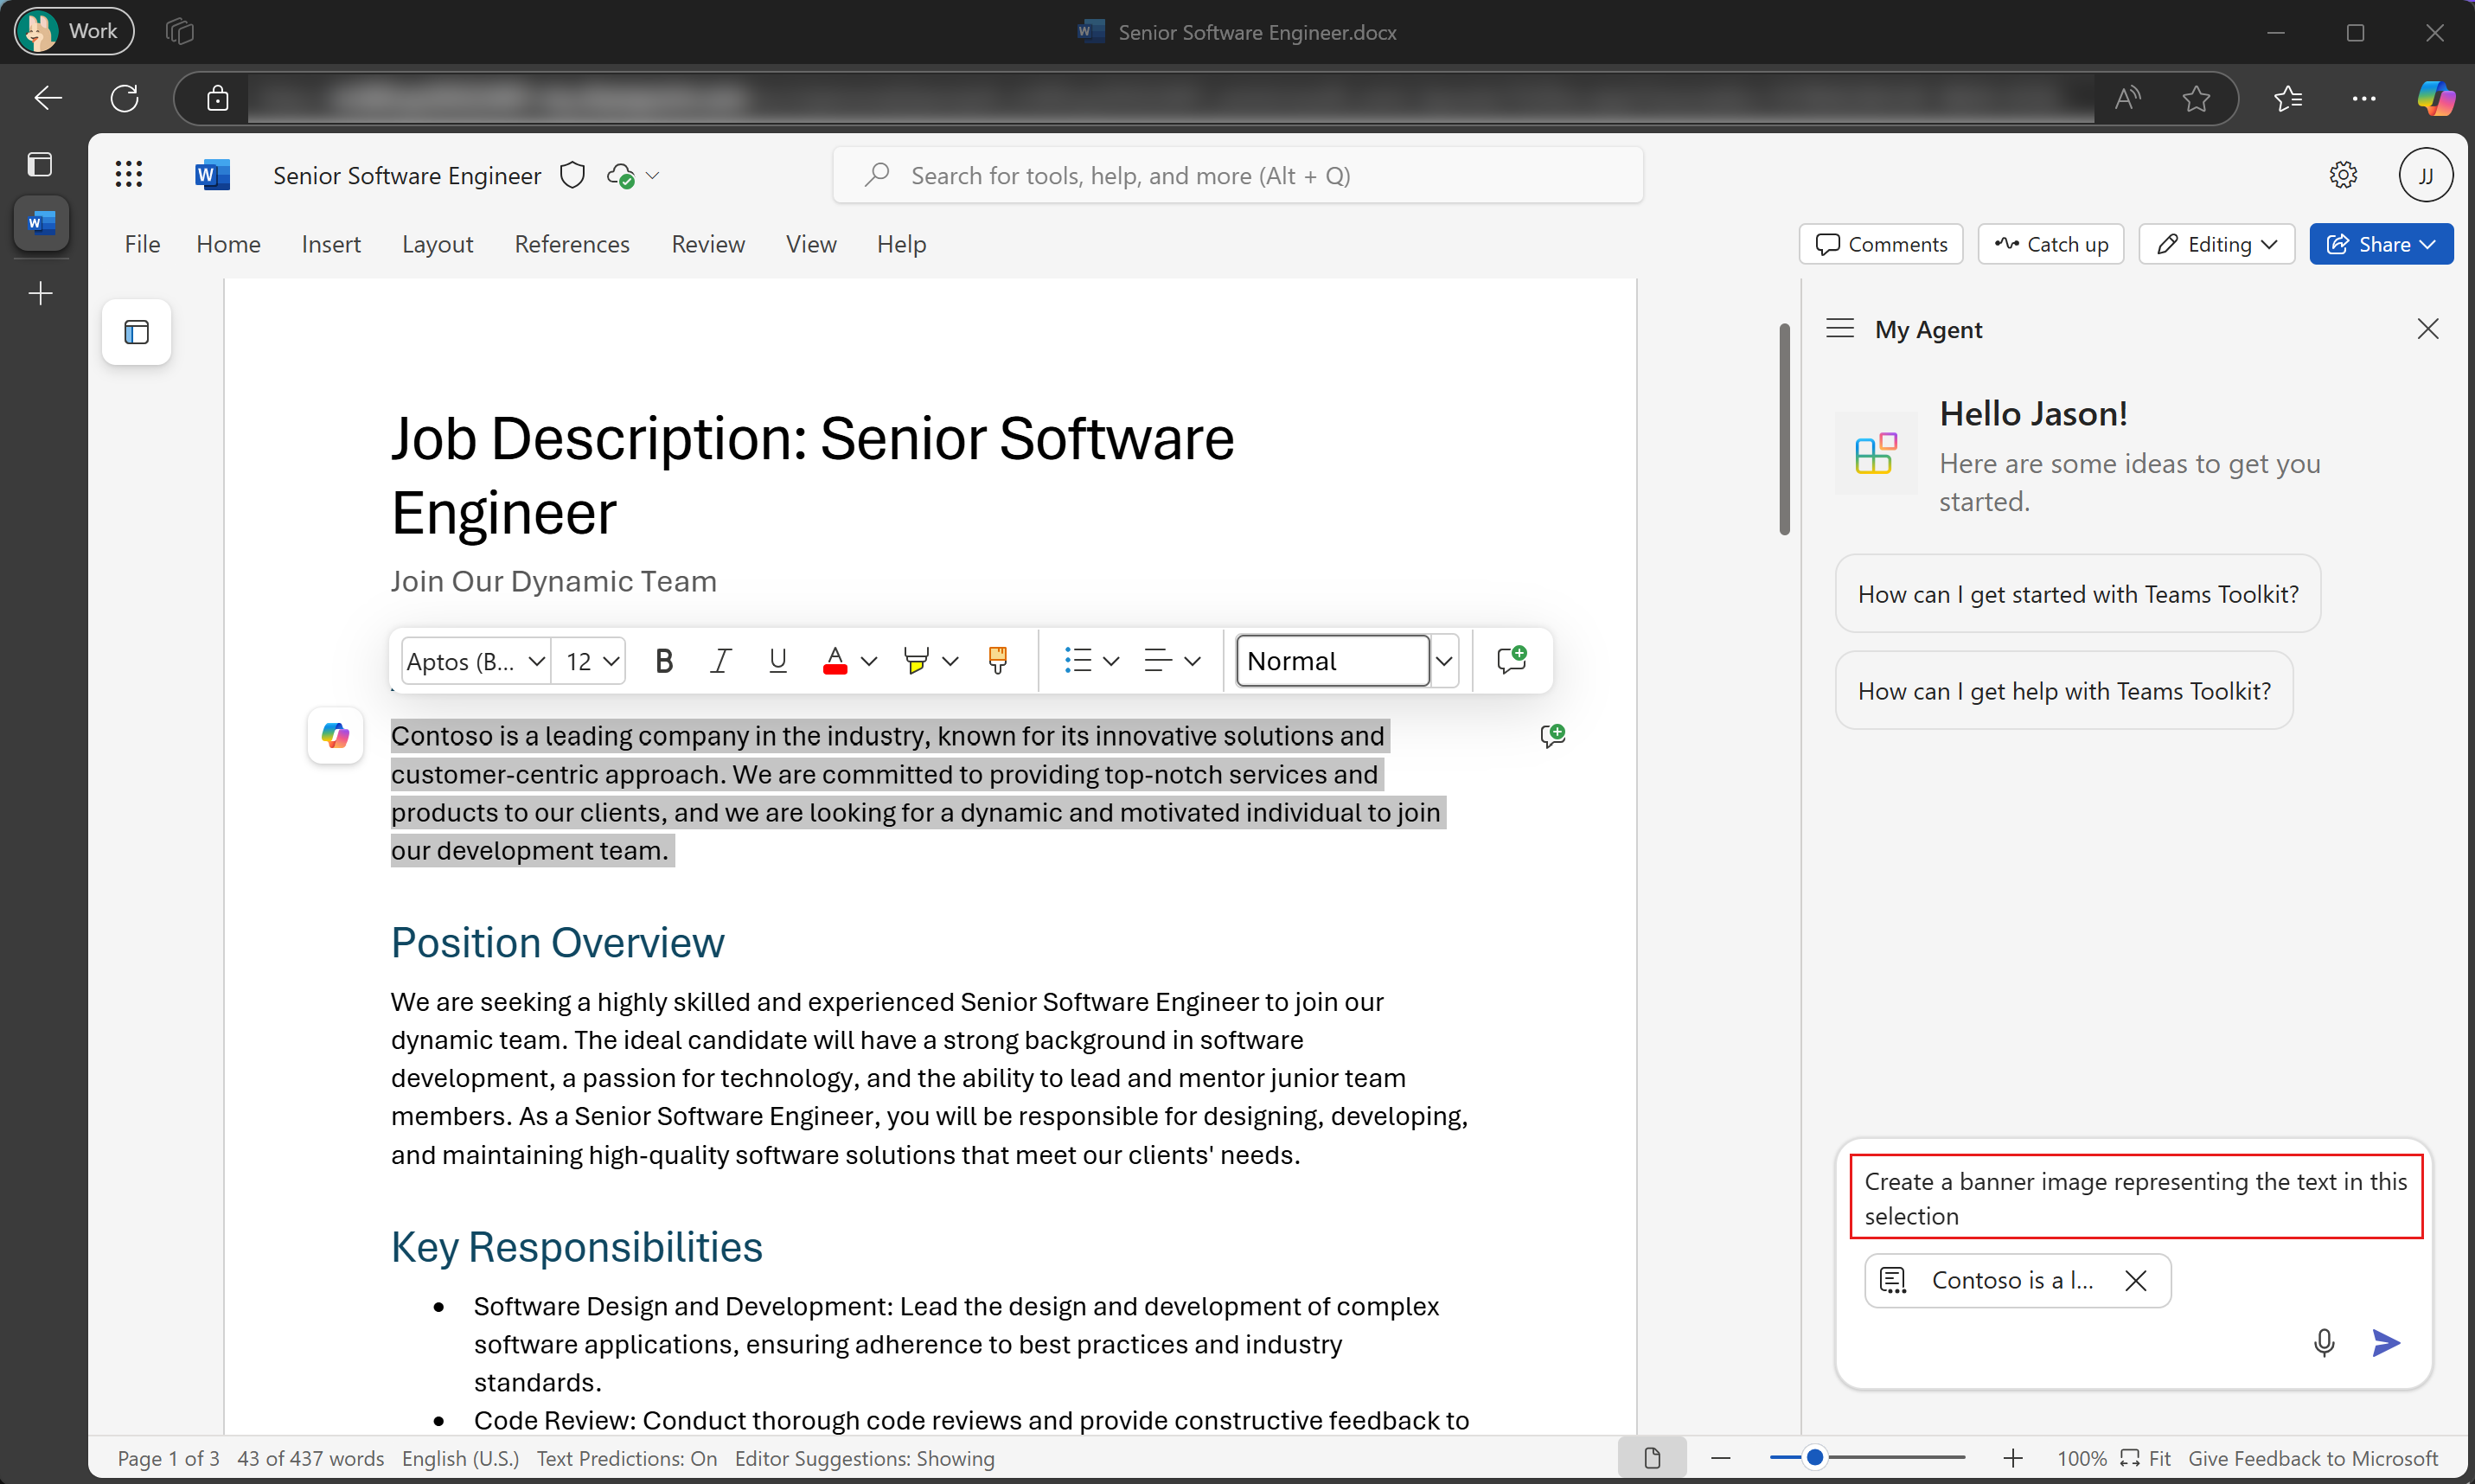
L’agent génère des images et répond à l’utilisateur.
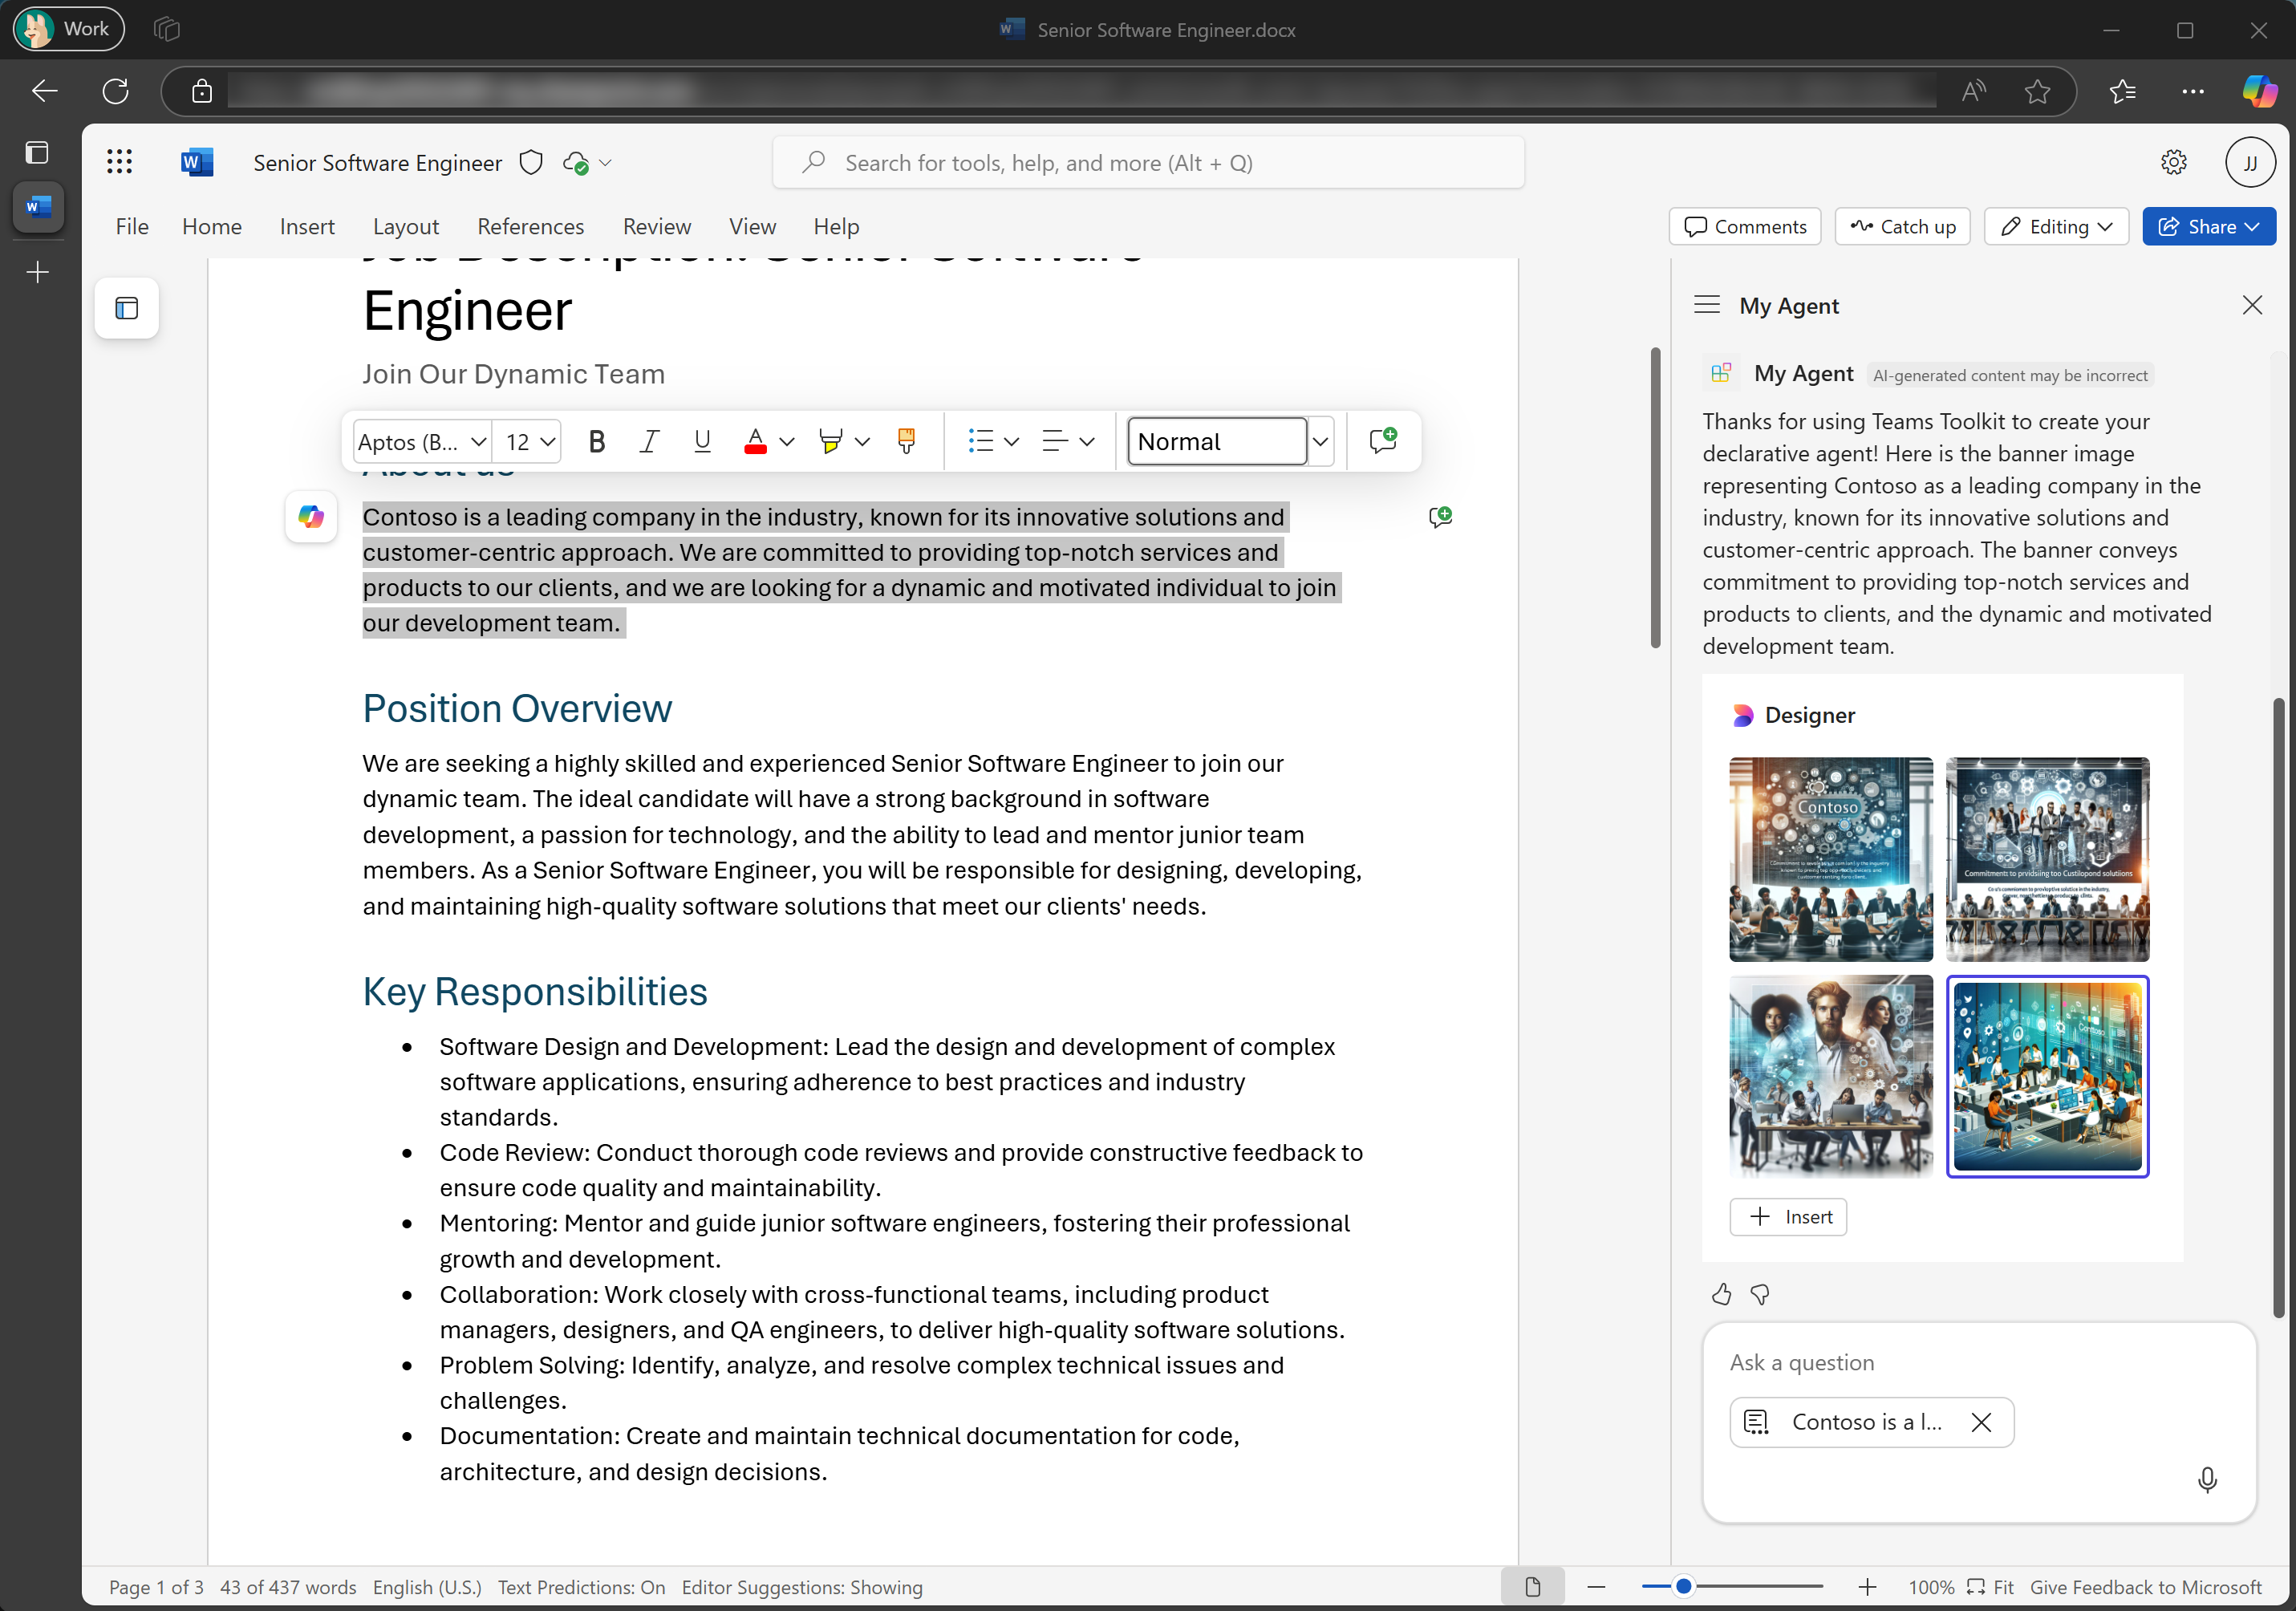
Utilisation de la sélection de document dans votre agent
Les agents déclaratifs ont accès à la sélection des documents par défaut. Aucune modification n’est requise pour votre agent pour activer la prise en charge de cette fonctionnalité.
Utilisation de la sélection de document dans les plug-ins d’API
Si votre agent inclut des plug-ins d’API en tant qu’actions personnalisées, l’agent peut fournir la sélection de document à l’API. L’agent traduit la sélection de document en fonction des spécifications de votre API.
Considérations relatives aux plug-ins d’API pour le contenu des documents
Pour l’ensemble du document ou de la sélection de l’utilisateur, l’agent décide de la meilleure façon de transmettre les données à un plug-in d’API. Vous devez vous assurer que la sélection du document ou de l’utilisateur est traduit correctement pour votre API.
- Commencez par tester votre agent sans lui ajouter d’instructions particulières. Dans la plupart des cas, l’agent doit traduire le contenu du document ou la sélection de l’utilisateur de manière appropriée pour votre API sans configuration supplémentaire.
- Si votre agent ne traduit pas correctement pour votre API, ajoutez des instructions dans le manifeste d’état du
reasoningplug-in pour indiquer à l’agent sur quel formulaire choisir. - Testez différentes sélections pour vérifier que votre agent gère correctement différents types et longueurs de contenu.
Voici quelques exemples d’instructions pour influencer la façon dont l’agent traduit le contenu du document ou la sélection de l’utilisateur. Les instructions réelles nécessaires pour obtenir le résultat souhaité dépendent de votre agent et de votre API.
Exemple d’intercommunication textuelle
You **MUST** pass the exact user's current selection without any modifications as part of the `text` param.
Exemple de résumé/transformation
You **MUST** pass the short, summarized version of the user's current selection as `prompt`
instead of the entire selected document context.
Exemple d’extraction structurée
You **MUST** pass the structured version of the user's current selection as part of the `data` param.
You should get the required context from the user's current selection based on the user's query and
**MUST** structure the context in JSON format.
Insertion d’images
La fonctionnalité d’insertion d’images permet aux utilisateurs d’insérer des images à partir de l’agent dans le document ouvert. L’image peut être insérée à la position actuelle du curseur, en haut du document ou en bas du document.
Par exemple, un agent qui récupère des images à partir d’un référentiel d’images externe peut montrer à l’utilisateur un bouton pour insérer l’image.
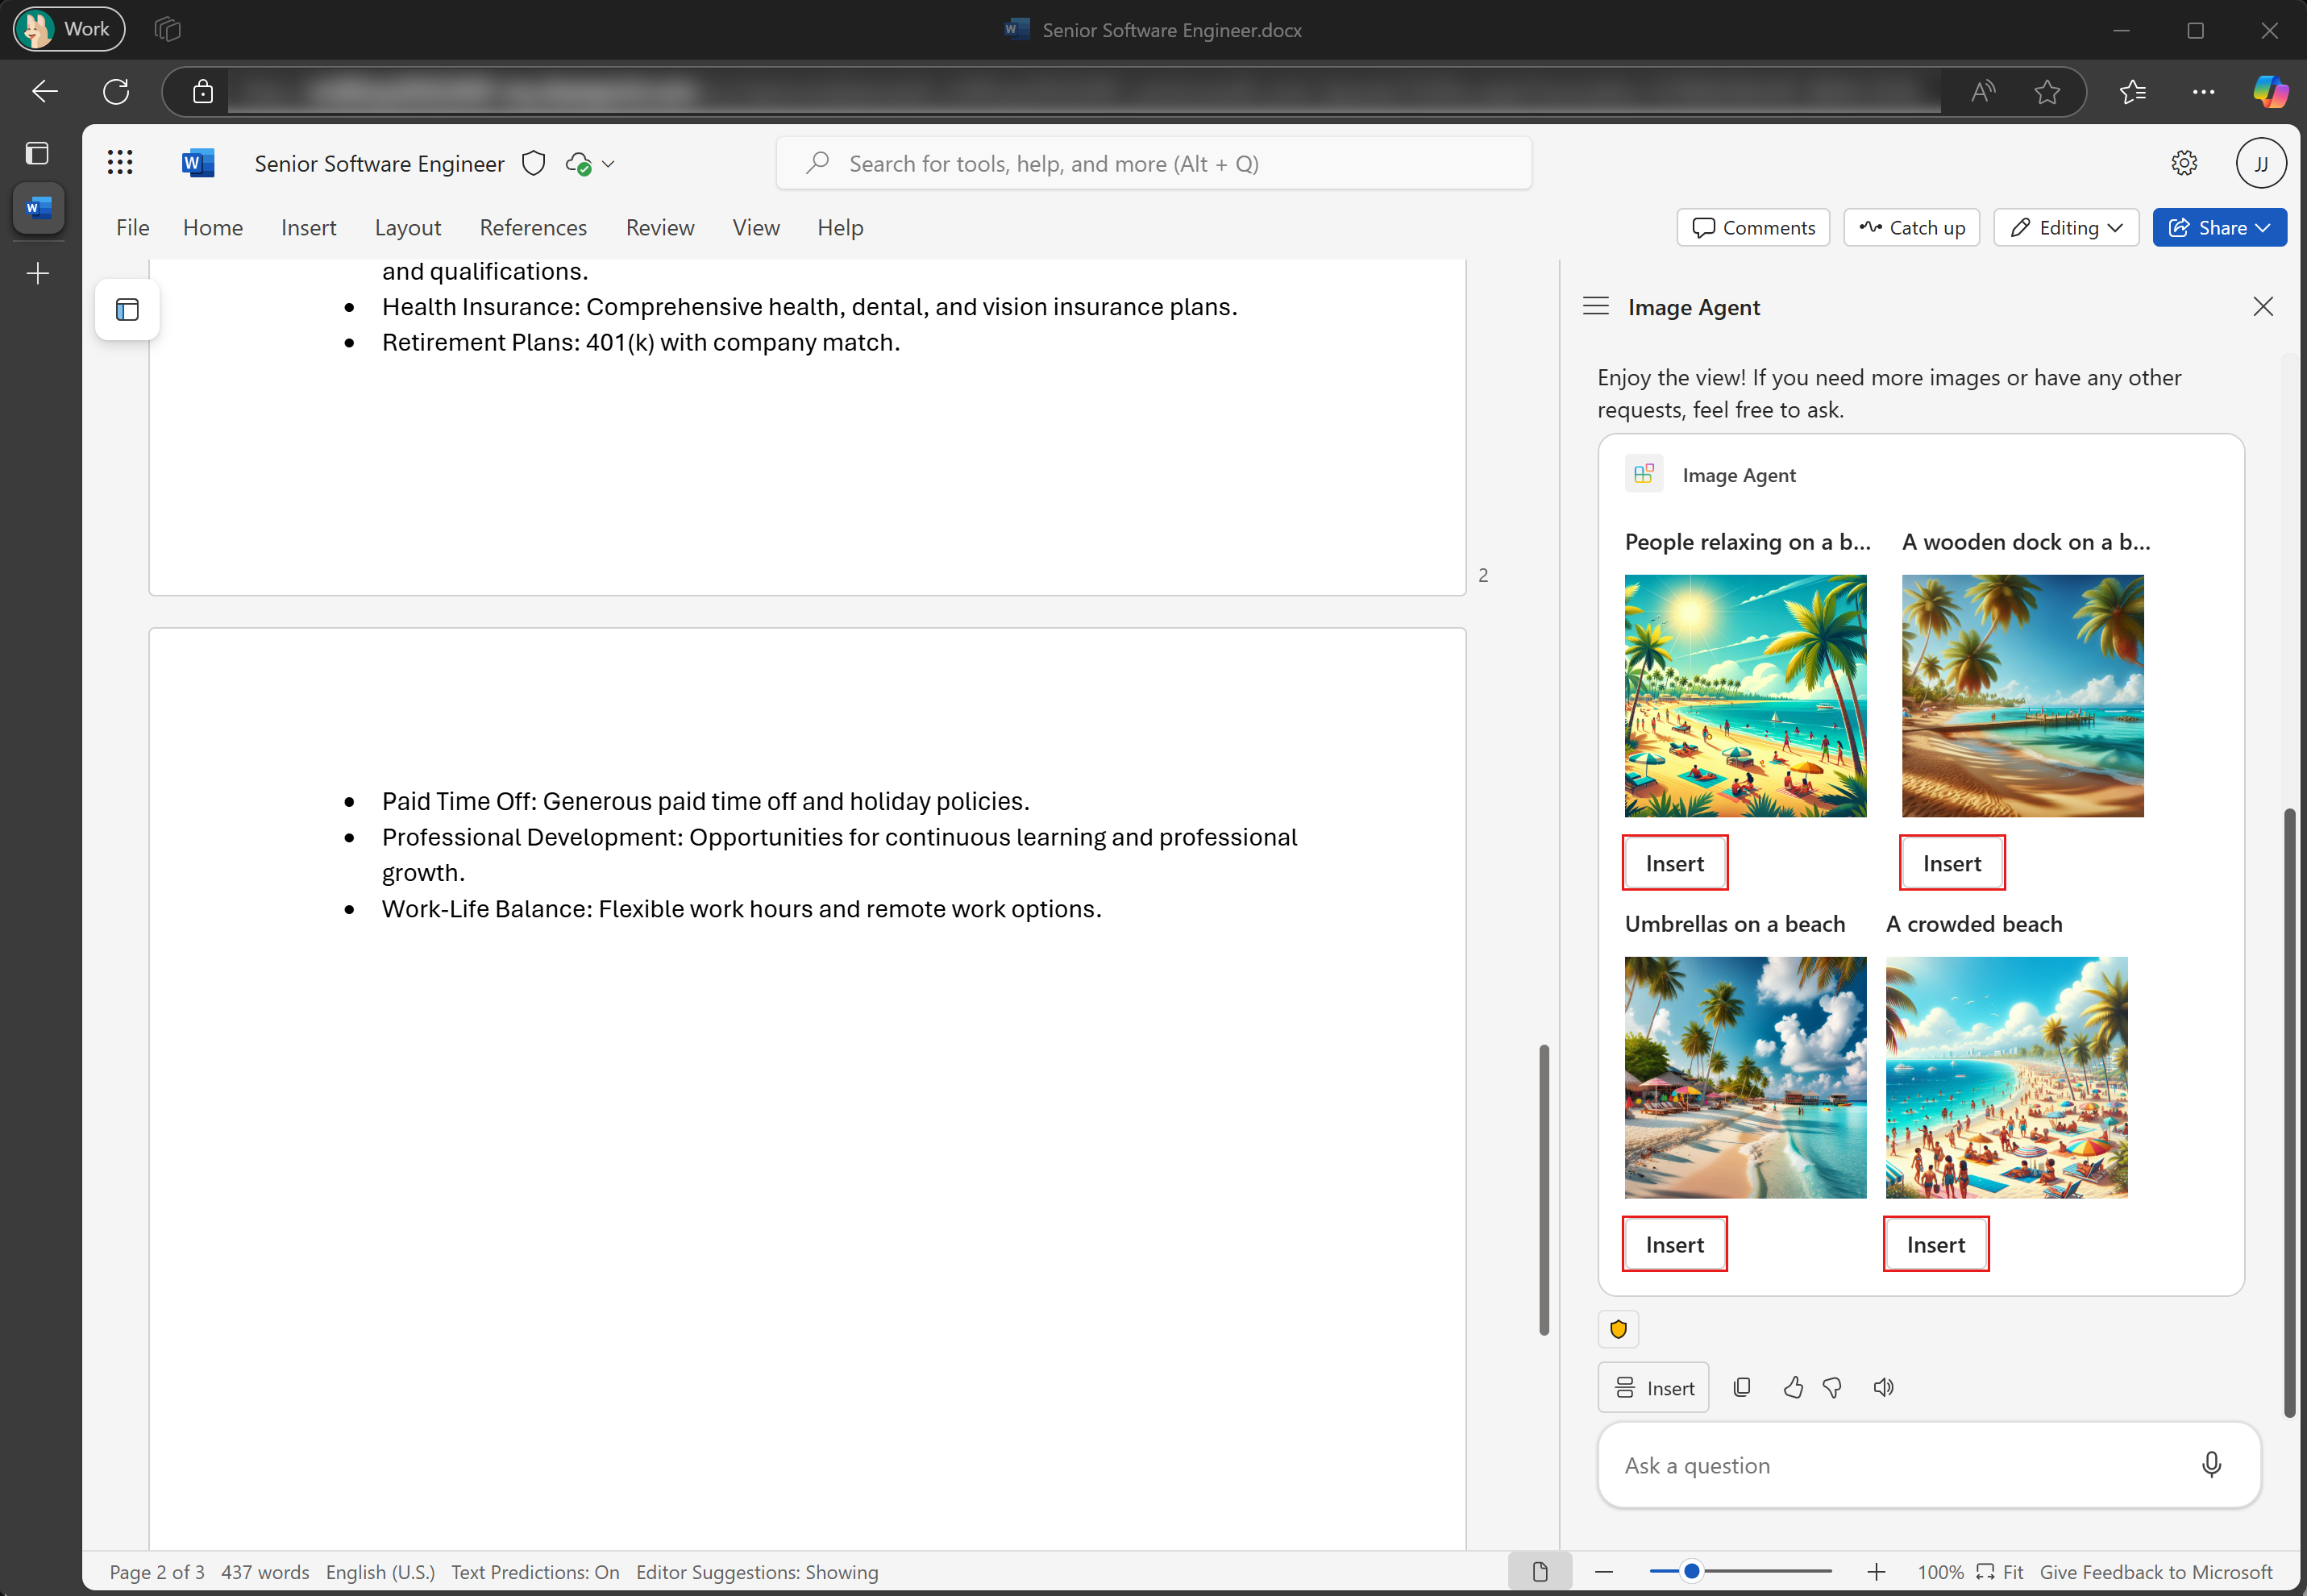
Insertion d’images à partir de votre agent
L’activation de l’insertion d’images dans un agent déclaratif nécessite un plug-in d’API qui utilise des modèles de réponses de carte adaptative. Le modèle de carte adaptative inclut une Action.InsertImage action que l’utilisateur sélectionne pour insérer l’image.
{
  "type": "ActionSet",
  "actions": [
    {
      "type": "Action.InsertImage",
      "title": "Insert",
      "altText": "An image of people on the beach",
      "url": "https://contoso.com/images/beach.jpeg",
      // fallback MUST be set to "drop"
      "fallback": "drop",
      // Other valid values: "Top", "Bottom"
      "insertPosition": "Selection"
    }
  ]
}
Remarque
Les types d’image pris en charge sont .bmp, .gif, .jpeg, .jpg et .png.