Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
S’applique à : SQL ServerAzure SQL DatabaseAzure SQL Managed InstanceBase de données SQL dans Microsoft Fabric
Le moteur de base de données SQL Server traite les requêtes sur diverses architectures de stockage des données, telles que des tables locales, des tables partitionnées et des tables distribuées sur plusieurs serveurs. Les sections suivantes expliquent comment le Moteur de base de données traite les requêtes et optimise la réutilisation des requêtes grâce à la mise en cache des plans d’exécution.
Les exemples de code de cet article utilisent les bases de données d’exemple AdventureWorks2025, AdventureWorksDW2025 ou AdventureWorksLT2025, que vous pouvez télécharger à partir du dépôt GitHub Azure Data SQL Samples Repository.
Modes d'exécution
Le Moteur de base de données SQL Server peut traiter Transact-SQL instructions (T-SQL) en utilisant deux modes de traitement distincts :
- Exécution en mode ligne
- Exécution en mode batch
Exécution en mode ligne
L’exécution en mode ligne est une méthode de traitement des requêtes utilisée avec les tables et index rowstore, où les données sont stockées sous forme de lignes. Lorsqu’une requête est exécutée et accède aux données dans les tables et index de rowstore, les opérateurs de l’arbre d’exécution et les opérateurs enfants lisent chaque ligne requise, à travers toutes les colonnes spécifiées dans le schéma d’objets. À partir de chaque ligne lue, le Moteur de base de données récupère alors les colonnes requises pour l’ensemble de résultats, comme référencées par une instruction SELECT, un prédicat JOIN ou un prédicat de filtre.
Remarque
L’exécution en mode ligne est très efficace pour les scénarios OLTP, mais elle peut être moins efficace lors de l’analyse de grandes quantités de données, par exemple dans les scénarios de Data Warehousing.
Exécution en mode batch
L’exécution en mode batch est une méthode de traitement des requêtes qui traite plusieurs lignes ensemble (d’où le terme batch). Chaque colonne d’un batch est stockée sous forme de vecteur dans une zone distincte de la mémoire : ainsi, le traitement en mode batch est basé sur les vecteurs. Le traitement en mode batch utilise également des algorithmes optimisés pour les ensembles d’instructions avancés et le débit mémoire accru des processeurs modernes.
L’exécution en mode batch était à l’origine intégrée et optimisée autour du format de stockage columnstore. À partir de SQL Server 2019 (15.x) et dans Azure SQL Database, l'exécution en mode batch ne nécessite pas d'index columnstore. Pour plus d’informations, consultez Mode batch sur rowstore.
Le traitement en mode batch fonctionne sur des données compressées lorsque cela est possible, et il élimine l’opérateur d’échange utilisé par l’exécution en mode ligne. Le résultat est un meilleur parallélisme et des performances plus rapides.
Lorsqu’une requête s’exécute en mode batch et accède aux données dans des index columnstore, les opérateurs de l’arbre d’exécution et les opérateurs enfants lisent plusieurs lignes ensemble dans des segments de colonne. Le Moteur de base de données ne lit que les colonnes requises pour le résultat, référencées dans une SELECT instruction, un JOIN prédicat ou un prédicat de filtre. Pour plus d’informations sur les index columnstore, consultez Architecture des index columnstore.
Remarque
L’exécution en mode batch est très efficace pour les scénarios de data warehousing où elle peut lire et agréger de grandes quantités de données.
Traitement des instructions SQL
Le traitement d’une seule instruction T-SQL est la manière la plus basique dont le Moteur de base de données exécute les instructions T-SQL. Les étapes suivantes illustrent le processus de base en traitant une seule SELECT instruction qui ne fait référence qu’aux tables de base locales (sans vues ni tables distantes).
Priorité des opérateurs logiques
Lorsque vous utilisez plus d’un opérateur logique dans une affirmation, NOT est évalué d’abord, puis AND, et enfin OR. Les opérateurs arithmétiques et bit à bit sont traités avant les opérateurs logiques. Pour plus d’informations, consultez Priorité de l’opérateur.
Dans l’exemple suivant, la condition de couleur s’applique au modèle produit 21, et non au modèle produit 20, car AND a la préséance sur OR.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
L’utilisation de parenthèses, même lorsqu’elles ne sont pas obligatoires, peut améliorer la lisibilité des requêtes et réduire le risque d’erreur due à la priorité de l’opérateur. L’exemple suivant est plus lisible que le précédent et a la même signification.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
Vous pouvez modifier la signification de la requête en ajoutant des parenthèses pour forcer l'évaluation de OR en premier. La requête suivante recherche uniquement les produits rouges dans les modèles 20 et 21.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
Optimiser les instructions SELECT
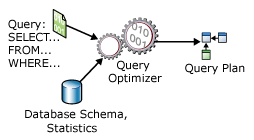
Une instruction SELECT est non procédurale ; elle ne précise pas les étapes exactes à suivre par le serveur de base de données pour extraire les données demandées. Ce comportement déclaratif signifie que le serveur de base de données doit analyser l’instruction et la base de données afin de déterminer la manière la plus efficace d’extraire les données demandées. Ce processus est appelé optimisation du plan de requête. Le composant qui effectue cette tâche est l’Optimiseur de requêtes. L’entrée de l’optimiseur de requêtes se compose de la requête, du schéma de la base de données (définitions d’objets) et des statistiques d’objets. La sortie de l’optimiseur de requêtes est un plan d’exécution de requête, parfois appelé plan de requête ou plan d’exécution. Le contenu d’un plan d’exécution est décrit plus en détail dans la mise en cache et la réutilisation du plan d’exécution.
Le diagramme suivant illustre les entrées et sorties de l’optimiseur de requêtes lors de l’optimisation d’une seule SELECT instruction :
Une SELECT instruction ne définit que :
- le format de l'ensemble de résultats. Il est principalement spécifié dans la liste de sélection. Toutefois, d’autres clauses telles que
ORDER BYetGROUP BYinfluencent également la syntaxe finale du jeu de résultats. - les tables contenant les données source. Ceci est spécifié dans la clause
FROM. - la manière dont les tables sont reliées de façon logique pour les besoins de l’instruction
SELECT. Ceci est défini dans l’expression de jointure, qui peut apparaître dans la clauseWHEREou dans une clauseONsuivantFROM. - Les conditions auxquelles doivent répondre les lignes des tables sources afin de correspondre à l’instruction
SELECT. Elles sont spécifiées dans les clausesWHEREetHAVING.
Un plan d’exécution de requête définit :
L’ordre d’accès aux tables sources.
En général, le serveur de base de données peut accéder aux tables de base dans de nombreux ordres pour constituer le jeu de résultats. Par exemple, si l’instruction
SELECTfait référence à trois tables, le serveur de base de données accédera d’abord àTableA, utilisera les données deTableApour extraire les lignes correspondantes deTableB, puis utilisera les données deTableBpour extraire les données deTableC. Les autres séquences dans lesquelles le serveur de bases de données peut accéder aux tables sont les suivantes :TableC,TableB,TableAou
TableB,TableA,TableCou
TableB,TableC,TableAou
TableC,TableA,TableBLes méthodes utilisées pour extraire les données des différentes tables.
Il existe également différentes méthodes d'accès aux données dans chaque table. Si seules quelques lignes avec des valeurs de clé spécifiques sont requises, le serveur de base de données peut rapidement rechercher les lignes ou scanner une petite plage d’index. Si toutes les lignes de la table sont requises, le serveur de base de données peut à la place scanner l’ensemble de la table ou de l’index. Si toutes les lignes d’une table sont requises mais qu’il existe un index dont les colonnes clés sont dans un ordre particulier
ORDER BY, effectuer un balayage d’index au lieu d’un balayage de table peut éviter un tri séparé de l’ensemble de résultats. Si une table est très petite, les scans complets peuvent être la méthode la plus efficace pour presque tous les accès à la table.Les méthodes utilisées pour effectuer les calculs, et filtrer, agréger et trier les données des différentes tables.
Lorsque les données sont extraites de tables, différentes méthodes effectuent des calculs sur les données, comme le calcul de valeurs scalaires, et agrègent et trient les données telles que définies dans le texte de la requête. Par exemple, lors de l’utilisation d’une clause
GROUP BYouORDER BY, et comment filtrer les données, par exemple lors de l’utilisation d’une clauseWHEREouHAVING.
Le processus de sélection d'un plan d'exécution parmi plusieurs possibles est appelé optimisation. L'optimiseur de requête est un des composants les plus importants du moteur de base de données. Bien que l’optimiseur de requêtes utilise une certaine surcharge pour analyser la requête et sélectionner un plan, ce coût est généralement compensé plusieurs fois lorsque l’optimiseur de requêtes choisit un plan d’exécution efficace. Prenons l'exemple de deux entreprises de construction à qui l'on confie des plans identiques pour une maison. Si une entreprise passe quelques jours au début à planifier la construction de la maison, et que l’autre commence à construire sans planification, c’est probablement la société qui prend le temps de planifier son projet qui terminera en premier.
L’optimiseur de requêtes est un optimiseur basé sur le coût. À chaque plan d'exécution possible est associé un coût exprimé en termes de quantité de ressources informatiques utilisées. L'optimiseur de requêtes doit analyser les plans possibles et opter pour celui dont le coût estimé est le plus faible. Certaines requêtes complexes comportent des milliers de plans d’exécution possibles. Dans ce cas, l'optimiseur de requêtes n'analyse pas toutes les combinaisons possibles. Il recourt alors à des algorithmes sophistiqués afin de trouver un plan d'exécution dont le coût se rapproche raisonnablement du minimum possible.
L’optimiseur de requêtes ne choisit pas nécessairement le plan d’exécution avec le coût estimé le plus bas. Il trouve un plan avec un coût estimé raisonnable dans le temps imparti à l’optimisation. Un plan d’exécution parallèle pourrait utiliser plus de ressources qu’un plan en série tout en réduisant le temps écoulé estimé.
L’optimiseur de requêtes SQL Server s’appuie sur les statistiques lorsqu’il estime les coûts en ressources des différentes méthodes d’extraction d’informations d’une table ou d’un index. Les statistiques sont conservées pour les colonnes et les index, et contiennent des informations sur la densité1 des données sous-jacentes. Ces informations indiquent la sélectivité des valeurs dans un index ou une colonne particulière. Par exemple, dans une table représentant des voitures, plusieurs voitures proviennent du même constructeur mais chacune a un numéro d'identification unique. Un index sur le numéro d'identification du véhicule est plus sélectif qu'un index sur le constructeur, car le numéro d'identification du véhicule a une plus faible densité que le constructeur. Si les statistiques d’index ne sont pas à jour, l’optimiseur de requête peut ne pas effectuer le meilleur choix pour l’état actuel de la table. Pour plus d'informations sur les densités, consultez Statistiques.
1 La densité définit la distribution des valeurs uniques qui existent dans les données ou le nombre moyen des valeurs en double pour une colonne donnée. Lorsque la densité diminue, la sélectivité d’une valeur augmente.
L’optimiseur de requêtes est important car il permet au serveur de base de données de s’adapter dynamiquement aux conditions changeantes dans la base de données sans nécessiter l’intervention d’un développeur ou d’un administrateur de base de données. Cette fonctionnalité permet aux développeurs de se concentrer sur le fait de décrire le résultat final de la requête. Ils peuvent faire confiance au Query Optimizer pour construire un plan d’exécution efficace, adapté à l’état de la base de données, à chaque fois que le plan de requête d’une instruction est optimisé.
Remarque
SQL Server Management Studio propose trois options pour afficher les plans d’exécution :
- Le Plan d’Exécution Estimé, qui est le plan compilé, tel que produit par l’Optimiseur de requêtes.
- Le Plan d’exécution réel, qui est le même que le plan compilé plus son contexte d’exécution. Ce contexte inclut les informations d’exécution disponibles après l’exécution terminée, telles que les avertissements d’exécution ou, dans les versions plus récentes du Moteur de base de données, le temps écoulé et le temps CPU utilisé lors de l’exécution.
- Les Live Query Statistics, qui sont les mêmes que le plan compilé plus son contexte d’exécution. Ce contexte inclut les informations d’exécution pendant l’exécution et est mis à jour toutes les secondes. Les informations à l’exécution incluent, par exemple, le nombre réel de lignes circulant à travers les opérateurs.
Traiter une instruction SELECT
Le Moteur de base de données traite une seule SELECT instruction en suivant ces étapes :
- L’analyseur examine l’instruction
SELECTet la décompose en unités logiques telles que mots clé, expressions, opérateurs et identificateurs. - Un arbre de requêtes, parfois appelé arbre de séquence, est construit pour décrire les étapes logiques nécessaires à la transformation des données sources dans le format requis par l’ensemble de résultats.
- L’optimiseur de requêtes analyse différentes façons d’accéder aux tables sources. Il sélectionne la série d’étapes qui restitue les résultats le plus rapidement tout en utilisant moins de ressources. Il met à jour l’arbre de requêtes pour enregistrer cette série exacte d’étapes. La version optimisée finale de l'arbre de requêtes est nommée plan d'exécution.
- Le moteur relationnel commence à exécuter le plan. Lorsqu’il traite les étapes nécessitant des données des tables de base, il demande les jeux de lignes requis au moteur de stockage.
- Le moteur relationnel traite les données retournées du moteur de stockage dans le format défini pour le jeu de résultats et retourne ce jeu au client.
Assemblage de constantes et évaluation d’expression
Le moteur de base de données évalue quelques expressions constantes à l’avance pour améliorer les performances des requêtes. Cette technique d’optimisation utilisée par l’optimiseur de requêtes vise à simplifier les expressions au moment de la compilation plutôt qu’à l’exécution. Il implique l’évaluation des expressions constantes pendant la compilation des requêtes afin que le plan d’exécution résultant soit plus efficace. Ce processus est appelé évaluation constante. Une constante est un littéral T-SQL, tel que 3, 'ABC', '2025-12-31', 1.0e3, ou 0x12345678. Par exemple, effectuez cette requête :
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Ici, 30 * 12 est une expression constante. Le Moteur de base de données évalue cette expression lors de la compilation et peut réécrire la requête en interne comme suit :
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Expressions pouvant être assemblées
Le Moteur de base de données utilise une évaluation constante avec les types d’expressions suivants :
- Expressions arithmétiques, telles que
1 + 1et5 / 3 * 2, ne contenant que des constantes. - Expressions logiques telles que
1 = 1et1 > 2 AND 3 > 4ne contenant que des constantes. - Fonctions intégrées que le Moteur de base de données considère comme repliables, notamment
CASTetCONVERT. En général, une fonction intrinsèque est évaluable si elle dépend uniquement de ses entrées et non d’autres informations contextuelles, telles queSETles options, les paramètres de langue, les options de base de données et les clés de chiffrement. Les fonctions non déterministes ne sont pas pliables. Les fonctions intégrées déterministes peuvent être assemblées, à quelques exceptions près. - Méthodes déterministes des types CLR définis par l’utilisateur et des fonctions CLR à valeurs scalaires déterministes définies par l’utilisateur. Pour plus d’informations, consultez Assemblage de constantes pour les fonctions et les méthodes CLR définies par l’utilisateur.
Remarque
Les objets volumineux constituent une exception. Si le type de sortie du processus de folding est un type d’objet volumineux (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json ou xml), le moteur de base de données ne réduit pas l'expression.
Expressions ne pouvant pas être assemblées
Aucun des autres types d'expressions n'est réductible. En particulier, les types d'expressions suivants ne sont pas repliables :
- Expressions non constantes, par exemple une expression dont le résultat dépend de la valeur d'une colonne.
- Expressions dont les résultats dépendent d'une variable locale ou d'un paramètre, par exemple
@x. - Fonctions non déterministes.
- Fonctions T-SQL définies par l’utilisateur.
- Expressions dont les résultats dépendent de paramètres de langue.
- Expressions dont les résultats dépendent des
SEToptions. - Expressions dont les résultats dépendent d'options de configuration du serveur.
Exemples d'expressions constantes réductibles et non réductibles
Considérez la requête suivante :
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Si l’option PARAMETERIZATION de base de données n’est pas définie sur FORCED pour cette requête, l’expression 117.00 + 1000.00 est évaluée et remplacée par son résultat, 1117.00, avant que la requête ne soit compilée. Les avantages de cette évaluation constante incluent :
- L'expression n'a pas à être évaluée à chaque exécution.
- La valeur de l’expression après son évaluation est utilisée par l’optimiseur de requêtes pour estimer la taille de l’ensemble de résultats de la portion de la requête
TotalDue > 117.00 + 1000.00.
En revanche, si dbo.f est une fonction scalaire définie par l'utilisateur, l'expression dbo.f(100) n'est pas simplifiée, car le Moteur de base de données ne simplifie pas les expressions impliquant des fonctions définies par l'utilisateur, même si elles sont déterministes. Pour plus d’informations sur la paramétrisation, voir Paramétrisation forcée.
Évaluation d’expression
Certaines expressions qui ne sont pas assemblées, mais dont les arguments (qu’il s’agisse de paramètres ou de constantes) sont connus au moment de la compilation, sont évaluées pendant l’optimisation par l’estimateur de la taille de l’ensemble de résultats (cardinalité) inclus dans l’optimiseur.
Par exemple, les fonctions intégrées et opérateurs spéciaux suivants sont évalués lors de la compilation si leurs données d’entrée sont connues : UPPER, LOWER, RTRIM, DATEPART( YY only ), GETDATE, CAST et CONVERT. Les opérateurs suivants sont également évalués au moment de la compilation si toutes leurs données d'entrée sont connues :
- Opérateurs arithmétiques :
+,-,*,/, unaire- - Opérateurs logiques :
AND,OR,NOT - Opérateurs de comparaison :
<,>,<=,>=,<>LIKE,IS NULLIS NOT NULL
L’optimiseur de requête n’évalue aucune autre fonction ni aucun autre opérateur pendant l’estimation de cardinalité.
Exemples d'évaluation d'expression au moment de la compilation
Envisageons la procédure stockée suivante :
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Pendant l’optimisation de l’instruction SELECT de cette procédure, l’optimiseur de requête tente d’évaluer la cardinalité attendue du jeu de résultats pour la condition OrderDate > @d + 1. L’expression @d + 1 n’est pas assemblée, puisque @d est un paramètre. Toutefois, la valeur de ce paramètre est connue au moment de l'optimisation. Cette valeur permet à l’optimiseur de requêtes d’estimer avec précision la taille de l’ensemble de résultats, ce qui l’aide à sélectionner un bon plan de requête.
Considérez maintenant un exemple similaire à celui précédent, sauf qu’une variable @d2 locale remplace @d + 1 dans la requête et que l’expression est évaluée dans une SET instruction au lieu de la requête.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Lorsque l'SELECTinstruction dans MyProc2 est optimisée dans le Moteur de base de données, la valeur de @d2 n'est pas connue. Par conséquent, l’optimiseur de requêtes utilise une estimation par défaut de la sélectivité de OrderDate > @d2 (dans ce cas 30 %).
Traiter les autres instructions
Les étapes de base pour traiter une SELECT instruction s’appliquent à d’autres instructions T-SQL telles que INSERT, UPDATE, et DELETE. Les instructions DELETE et UPDATE instructions doivent toutes deux cibler l’ensemble des lignes à modifier ou à supprimer. Le processus d’identification de ces lignes est le même que celui utilisé pour identifier les lignes sources qui participent au jeu de résultats d’une instruction SELECT . Les UPDATE deux instructions et INSERT peuvent contenir des instructions intégrées SELECT qui fournissent les valeurs de données à mettre à jour ou à insérer.
Même les instructions du Langage de Définition de Données (DDL), telles que CREATE PROCEDURE ou ALTER TABLE, se résolvent en une série d’opérations relationnelles sur les tables de catalogue système et parfois (comme ALTER TABLE ADD COLUMN) sur les tables de données.
Tables de travail
Le moteur relationnel peut avoir besoin de construire une table de travail pour effectuer une opération logique spécifiée dans une instruction T-SQL. Les tables de travail sont des tables internes qui contiennent des résultats intermédiaires. Les tables de travail sont générées pour certaines requêtes GROUP BY, ORDER BY, ou UNION . Par exemple, si une clause ORDER BY fait référence à des colonnes que ne couvre aucun index, le moteur relationnel pourrait devoir générer une table de travail pour trier l’ensemble de résultats dans l’ordre demandé. En outre, les tables de travail sont parfois utilisées comme fichiers d'attente pour le stockage temporaire du résultat de l'exécution d'une partie d'un plan de requête. Les tables de travail sont créées dans tempdb, puis supprimées automatiquement quand elles ne sont plus nécessaires.
Résolution d'affichage
Le processeur de requête du Moteur de base de données traite différemment les vues indexées et non indexées :
- La base de données stocke les lignes d’une vue indexée dans le même format qu’une table. Si l’optimiseur de requêtes décide d’utiliser une vue indexée dans un plan de requête, il traite la vue indexée de la même manière qu’une table de base.
- Seule la définition d'une vue non indexée est stockée, tandis que les lignes de la vue ne le sont pas. L’optimiseur de requêtes intègre la logique de la définition de la vue dans le plan d’exécution qu’il construit pour l’instruction T-SQL qui fait référence à la vue non indexée.
La logique utilisée par l’Optimiseur de requêtes pour décider quand utiliser une vue indexée est similaire à celle qu’il utilise pour décider quand utiliser un index sur une table. Si les données dans la vue indexée couvrent tout ou partie de l’instruction T-SQL, et que l’optimiseur de requête détermine qu’un index sur la vue est le chemin d’accès à faible coût, il choisit l’index, que la requête fasse référence ou non à la vue par son nom.
Lorsqu’une instruction T-SQL fait référence à une vue non indexée, l’analyseur et l’optimiseur de requêtes analysent la source à la fois de l’instruction T-SQL et de la vue, puis les fusionnent en un seul plan d’exécution. L’instruction T-SQL et la vue n’ont pas de plans séparés.
Imaginons par exemple la vue suivante :
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Sur cette base, ces deux instructions T-SQL effectuent les mêmes opérations sur les tables de base et produisent les mêmes résultats :
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
La fonctionnalité Showplan de SQL Server Management Studio (SSMS) montre que le moteur relationnel construit le même plan d’exécution pour ces SELECT deux instructions.
Utiliser des indicateurs avec des vues
Si vous placez des indications sur des vues dans une requête, elles peuvent entrer en conflit avec d’autres indications découvertes lorsque la vue est développée pour accéder à ses tables de base. Lorsque ce conflit survient, la requête renvoie une erreur. Imaginons par exemple la vue suivante, dont la définition contient un indicateur de table :
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Imaginons maintenant que vous saisissez cette requête :
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
La requête échoue, car l’indication SERIALIZABLE dans la vue Person.AddrState se propage à la fois aux tables Person.Address et Person.StateProvince de la vue lorsqu’elle est étendue. Cependant, le développement de la vue révèle également l’indicateur NOLOCK sur Person.Address. La requête résultante est incorrecte parce que les indicateurs SERIALIZABLE et NOLOCK sont en conflit.
Les PAGLOCKindices , NOLOCK, ROWLOCK, TABLOCK, et TABLOCKX de table entrent en conflit, tout comme les HOLDLOCKindices , NOLOCK, READCOMMITTED, REPEATABLEREAD, et SERIALIZABLE de table.
Les indices peuvent se propager à travers les niveaux des vues imbriquées. Imaginons par exemple une requête qui applique l’indicateur HOLDLOCK sur une vue v1. Lorsqu’on développe v1, on constate que cette vue v2 fait partie de sa définition. La définition dev2inclut un indicateur NOLOCK sur l’une de ses tables de base. Cependant, cette table hérite également de l’indicateur HOLDLOCK de la requête sur la vue v1. La requête échoue parce que les indicateurs NOLOCK et HOLDLOCK sont en conflit.
Lorsque vous utilisez l’indication FORCE ORDER dans une requête contenant une vue, la position de la vue dans la construction ordonnée détermine l’ordre des jointures des tables dans la vue. Par exemple, la requête suivante effectue une sélection dans trois tables et une vue :
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
Et View1 est défini comme montré dans l’exemple suivant :
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
L’ordre de jointure dans le plan de requête est Table1, Table2, TableA, TableB, Table3.
Résoudre des index sur les vues
Comme pour tout index, le Moteur de base de données choisit d'utiliser une vue indexée dans son plan de requête uniquement si l'optimiseur de requêtes juge qu'il est avantageux de le faire.
Vous pouvez créer des vues indexées dans n’importe quelle édition du Moteur de base de données. Dans certaines éditions, l’optimiseur de requêtes prend automatiquement en compte la vue indexée, tandis que dans d’autres, il faut utiliser l’indicateur de table NOEXPAND. L’utilisation automatique d’une vue indexée par l’Optimiseur de requêtes n’est prise en charge que dans certaines éditions de SQL Server.
Remarque
Azure SQL Database et Azure SQL Managed Instance prennent en charge l’utilisation automatique des vues indexées sans spécifier l’indicateur NOEXPAND .
L’optimiseur de requêtes utilise une vue indexée lorsque les conditions suivantes sont remplies :
- Ces options de session sont activées à
ON:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
- L’option de session
NUMERIC_ROUNDABORTest définie surOFF. - L’Optimiseur de requêtes trouve une correspondance entre les colonnes d’index de la vue et les éléments de la requête, tels que :
- Prédicats de condition de recherche dans la clause
WHERE - Opérations de jointure
- Fonctions d’agrégation
- Clauses
GROUP BY - Références de table
- Prédicats de condition de recherche dans la clause
- Le coût estimé de l'utilisation de l'index est le plus faible de tous les mécanismes d'accès envisagés par l'optimiseur de requête.
- Dans la requête, vous devez appliquer le même ensemble d'indicateurs à chaque table que vous référencez, soit directement, soit en développant une vue afin d'accéder à ses tables sous-jacentes, et qui correspond à une référence de table dans la vue indexée.
Remarque
Les indicateurs READCOMMITTED et READCOMMITTEDLOCK sont toujours considérés comme des indicateurs différents dans ce contexte, indépendamment du niveau d’isolation de la transaction en cours.
En dehors des exigences relatives aux indicateurs de table et aux options SET, l’optimiseur de requête emploie ces mêmes règles pour déterminer si l’index d’une table couvre une requête. Vous n’avez pas besoin de spécifier autre chose dans la requête pour qu’une vue indexée soit utilisée.
Une requête ne doit pas obligatoirement référencer explicitement une vue indexée dans la clause FROM pour que l’optimiseur de requête utilise la vue indexée. Si la requête contient des références à des colonnes dans des tables de base qui sont également présentes dans la vue indexée, et si l’optimiseur de requête estime que l’emploi de la vue indexée offre le mécanisme d’accès le moins coûteux, il choisit la vue indexée, un peu comme il choisit les index des tables de base lorsque ceux-ci ne sont pas directement référencés dans une requête. L’optimiseur de requête peut choisir la vue lorsqu’elle contient des colonnes qui ne sont pas référencées par la requête, à condition que cette dernière offre l’option la moins coûteuse pour couvrir une ou plusieurs colonnes spécifiées dans la requête.
L’optimiseur de requête traite une vue indexée référencée dans la clause FROM comme une vue standard. L'optimiseur de requête développe la définition de la vue dans la requête au début du processus d'optimisation. Ensuite, la mise en correspondance des éléments de la vue indexée est réalisée. La vue indexée peut être utilisée dans le plan d’exécution final sélectionné par l’optimiseur de requête ou, sinon, le plan peut matérialiser les données nécessaires à partir de la vue en accédant aux tables de base référencées par celle-ci. L’optimiseur de requête choisit la solution la plus économique.
Utiliser des indicateurs avec les vues indexées
Vous pouvez empêcher l’utilisation d’index de vue pour une requête à l’aide de l’indicateur de requête EXPAND VIEWS ou recourir à l’indicateur de table NOEXPAND afin d’imposer l’utilisation d’un index pour une vue indexée spécifiée dans la clause FROM d’une requête. Toutefois, vous devez laisser l'optimiseur de requête déterminer dynamiquement les meilleures méthodes d'accès à utiliser pour chaque requête. Limitez l’utilisation des indicateurs EXPAND et NOEXPAND aux cas spécifiques où les tests ont démontré qu’ils améliorent les performances de façon significative.
L’option
EXPAND VIEWSordonne à l’optimiseur de requête de ne pas utiliser des index de vue pour toute la requête.Lorsque vous spécifiez
NOEXPANDpour une vue, l’Optimiseur de requêtes envisage d’utiliser n’importe lequel des index définis sur la vue.NOEXPANDspécifié avec la clauseINDEX()facultative force l’optimiseur de requête à utiliser les index spécifiés. Vous pouvez spécifierNOEXPANDuniquement pour une vue indexée et vous ne pouvez pas la spécifier pour une vue qui n’est pas indexée. L’utilisation automatique d’une vue indexée par l’Optimiseur de requêtes n’est prise en charge que dans certaines éditions de SQL Server.Remarque
Azure SQL Database et Azure SQL Managed Instance prennent en charge l’utilisation automatique des vues indexées sans spécifier l’indicateur
NOEXPAND.
Lorsque ni NOEXPAND ni EXPAND VIEWS ne sont spécifiés dans une requête qui contient une vue, celle-ci est développée de manière à permettre l’accès aux tables sous-jacentes. Si la requête qui compose la vue contient des indicateurs de table, ceux-ci sont propagés aux tables sous-jacentes. (Ce processus est expliqué plus en détail dans la résolution de la vue.) Tant que l’ensemble des indications existant sur les tables sous-jacentes de la vue est identique, la requête peut être associée à une vue indexée. La plupart du temps, ces indices correspondent, car ils sont hérités directement de la vue. Toutefois, si la requête référence des tables au lieu de vues et que les indicateurs appliqués directement à ces tables ne sont pas identiques, cette requête ne peut pas être mise en correspondance avec une vue indexée. Si les indicateurs INDEX, PAGLOCK, ROWLOCK, TABLOCKX, UPDLOCKou XLOCK s’appliquent aux tables référencées dans la requête une fois la vue développée, la requête ne peut pas être mise en correspondance avec la vue indexée.
Si un indicateur de table de la forme INDEX ( index_val [ ,...n] ) référence une vue dans une requête et que vous ne spécifiez pas l’indicateur NOEXPAND , l’indicateur d’index est ignoré. Pour spécifier l’utilisation d’un index particulier, utilisez NOEXPAND.
En général, lorsque l’optimiseur de requête associe une vue indexée à une requête, il applique toutes les indications spécifiées sur les tables ou vues de la requête directement à la vue indexée. Si l’optimiseur de requêtes choisit de ne pas utiliser de vue indexée, il propage les indications directement vers les tables référencées dans la vue. Pour plus d’informations, voir Résolution d’affichage. Cette propagation ne s’applique pas aux indicateurs de jointure. Ils ne sont appliqués qu'à leur emplacement initial dans la requête. L’optimiseur de requêtes ne prend pas en compte les indications de jointure lorsqu’il associe les requêtes aux vues indexées. Si un plan de requête utilise une vue indexée qui correspond à une partie d'une requête contenant un indicateur de jointure, celui-ci n'est pas utilisé dans le plan.
L’utilisation d’indicateurs n’est pas autorisée dans les définitions de vues indexées. Le Moteur de base de données ignore les indications à l’intérieur des définitions de vues indexées lors de leur maintien, ou lors de l’exécution de requêtes utilisant des vues indexées.
Pour plus d’informations, consultez Hints de table.
Résoudre des vues distribuées partitionnées
Le processeur de requête du Moteur de base de données optimise les performances des vues partitionnées distribuées. L'aspect le plus important des performances d'une vue distribuée partitionnée est de minimiser la quantité de données à transférer entre des serveurs membres.
Le Moteur de base de données construit des plans intelligents et dynamiques qui utilisent efficacement les requêtes distribuées pour accéder aux données provenant de tables membres distantes :
- Le processeur de requêtes utilise d’abord OLE DB pour récupérer les définitions des contraintes de vérification de chaque table membre. Cette méthode permet au processeur de requête de cartographier la distribution des valeurs clés à travers les tables membres.
- Le Processeur de requêtes compare les plages de clés spécifiées dans une clause d’instruction
WHERET-SQL à la carte qui montre comment les lignes sont distribuées dans les tables membres. Le processeur de requêtes construit ensuite un plan d’exécution de requêtes qui utilise des requêtes distribuées pour récupérer uniquement les lignes distantes nécessaires à la complétion de l’instruction T-SQL. Le plan d’exécution est également conçu de manière à ce que tout accès aux tables membres distantes, que ce soit pour les données ou les métadonnées, soit retardé jusqu’à ce que les informations soient requises.
Par exemple, prenons un système où une table de Customers est partitionnée entre Server1 (CustomerID de 1 à 3299999), Server2 (CustomerID de 3300000 à 6599999) et Server3 (CustomerID de 6600000 à 9999999).
Étudiez le plan d’exécution qui est construit pour chaque requête exécutée sur Server1 :
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
Le plan d’exécution pour cette requête extrait les lignes avec des valeurs de clés CustomerID de 3200000 à 3299999 de la table membre locale et émet une requête distribuée pour récupérer les lignes dont les valeurs de clés sont comprises entre 3300000 et 3400000 de Server2.
Le Moteur de base de données Query Processor peut également intégrer une logique dynamique dans les plans d'exécution des requêtes pour les instructions T-SQL dont les valeurs clés ne sont pas connues au moment où le plan doit être construit. Prenons par exemple cette procédure stockée :
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
Le Moteur de base de données ne peut pas prédire quelle valeur clé est fournie par le paramètre @CustomerIDParameter à chaque exécution de la procédure. Comme la valeur de la clé ne peut pas être prédite, le processeur de requête ne peut pas non plus prédire à quelle table membre il doit accéder. Pour gérer ce cas, le Moteur de base de données construit un plan d’exécution avec une logique conditionnelle, appelée filtres dynamiques, pour contrôler à quelle table membre est accédée, en fonction de la valeur du paramètre d’entrée. En supposant que la GetCustomer procédure stockée ait été exécutée sur Server1, la logique du plan d’exécution peut être représentée comme montré dans la sortie suivante :
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
Le Moteur de base de données construit parfois ce type de plans d'exécution dynamiques même pour des requêtes non paramétrées. L’optimiseur peut paramétrer une requête pour que le plan d’exécution puisse être réutilisé. Si l’Optimiseur de requêtes paramétrise une requête référençant une vue partitionnée, il ne peut plus supposer que les lignes requises proviennent d’une table de base spécifiée. Il doit ensuite utiliser des filtres dynamiques dans le plan d’exécution.
Exécution d'une procédure stockée et d'un déclencheur
Le Moteur de base de données ne stocke que la source des procédures stockées et des déclencheurs. Quand une procédure stockée ou un déclencheur est exécuté pour la première fois, la source est compilée dans un plan d'exécution. Si la procédure stockée ou le déclencheur doit à nouveau être exécuté alors que le plan d'exécution se trouve encore en mémoire, le moteur relationnel détecte le plan existant et le réutilise. Si le plan est évincé de la mémoire, un nouveau plan est construit. Ce processus est similaire à celui suivi par le Moteur de base de données pour toutes les instructions T-SQL. Le principal avantage de performance des procédures stockées et des déclencheurs dans le Moteur de base de données par rapport aux lots de T-SQL dynamique est que leurs instructions T-SQL sont toujours les mêmes. Par conséquent, le moteur relationnel les associe facilement à n'importe quel plan d'exécution existant. Les plans des procédures stockées et des déclencheurs sont faciles à réutiliser.
Le plan d'exécution des procédures stockées et des déclencheurs est exécuté séparément du plan d'exécution du traitement qui appelle la procédure stockée ou qui active le déclencheur. Cette séparation permet une plus grande réutilisation des plans d’exécution des procédures stockées et des déclencheurs.
Mise en cache et réutilisation du plan d’exécution
Le Moteur de base de données utilise la mémoire pour stocker à la fois les plans d’exécution et les tampons de données. Le pourcentage de mémoire alloué aux plans d’exécution ou aux tampons de données est ajusté dynamiquement, selon l’état du système. La partie de la mémoire qui stocke les plans d’exécution s’appelle le plan cache.
Magasins du cache des plans
Le cache du plan dispose de deux espaces de stockage pour tous les plans compilés.
- Le stockage de cache des plans d’objets (OBJCP), pour les plans liés aux objets persistants, tels que les procédures stockées, fonctions et déclencheurs.
- Le cache SQL Plans (SQLCP), destiné aux plans liés à des requêtes autoparamétrées, dynamiques ou préparées.
La requête suivante fournit des informations sur l’utilisation de la mémoire pour ces deux magasins de cache :
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
Le cache de plans comporte deux magasins supplémentaires qui ne stockent pas de plans :
- Le stockage de cache Bound Trees (PHDR), pour les structures de données utilisées lors de la compilation des plans pour les vues, contraintes et valeurs par défaut. Ces structures sont appelées bound trees ou algebrizer trees.
- Le stockage de cache des procédures stockées étendues (XPROC), pour des procédures système prédéfinies, comme sp_executesql ou xp_cmdshell. Ces procédures stockées utilisent une DLL au lieu d’instructions T-SQL. La structure mise en cache ne contient que le nom de la fonction et le nom DLL où la procédure est implémentée.
Composantes du plan d’exécution
Les plans d’exécution du Moteur de base de données comportent les principaux composants suivants :
Plan compilé (ou plan de requête)
Le plan de requête produit par le processus de compilation est principalement une structure de données réentrantes en lecture seule utilisée par un nombre quelconque d’utilisateurs. Il stocke des informations sur les éléments suivants :
Les opérateurs physiques qui mettent en œuvre l'opération décrite par des opérateurs logiques.
L’ordre de ces opérateurs, qui détermine l’ordre dans lequel les données sont accessibles, filtrées et agrégées.
Le nombre de lignes estimées qui transitent par les opérateurs.
Remarque
Le plan de requête stocke également des informations sur les objets statistiques utilisés pour l’estimation de la cardinalité.
Les objets de prise en charge qui doivent être créés, par exemple des tables de données ou des fichiers de travail dans
tempdb.
Le plan de requête ne stocke aucune information sur le contexte de l’utilisateur ni d’informations d’exécution. Le Moteur de base de données détermine le nombre de threads de travail à chaque fois qu’il récupère un plan depuis le cache du plan. Un plan parallèle mis en cache peut également s’exécuter en série.
Contexte d’exécution
Chaque utilisateur qui exécute actuellement la requête dispose d’une structure de données qui contient les données spécifiques à son exécution, telles que les valeurs des paramètres. Cette structure de données est appelée le contexte d’exécution. Les structures de données du contexte d’exécution sont réutilisées, mais pas leur contenu. Si un autre utilisateur exécute la même requête, les structures de données sont réinitialisées avec le contexte du nouvel utilisateur.
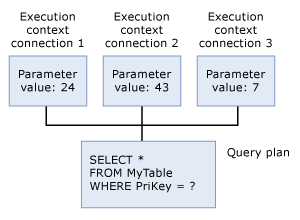
Réutiliser des plans pour des instructions identiques
Lorsque le Moteur de base de données exécute une instruction T-SQL, il examine d’abord le cache des plans pour vérifier qu’un plan d’exécution existant pour la même instruction T-SQL existe. L’instruction T-SQL est considérée comme correspondant à une instruction existante si elle correspond littéralement à une instruction T-SQL déjà exécutée avec un plan mis en cache, caractère par caractère. Le Moteur de base de données réutilise tout plan existant qu’il trouve, évitant ainsi la surcharge de la recompilation de l’instruction T-SQL. S’il n’existe pas de plan d’exécution, le Moteur de base de données génère un nouveau plan d’exécution pour la requête.
Remarque
Le cache de plans ne conserve pas les plans d’exécution pour certaines instructions T-SQL, comme les instructions d’opérations en bloc fonctionnant sur le rowstore ou les instructions contenant de grands littéraux de chaînes. Ces plans existent uniquement pendant que la requête est en cours.
Le Moteur de base de données utilise un algorithme efficace pour trouver les plans d’exécution existants pour une instruction T-SQL spécifique. Dans la plupart des systèmes, les ressources minimales utilisées par ce scan sont inférieures à celles économisées en réutilisant des plans existants au lieu de compiler chaque instruction T-SQL.
Les algorithmes pour faire correspondre les nouvelles instructions T-SQL aux plans d’exécution existants et inutilisés dans le cache de plans exigent que toutes les références d’objets soient entièrement qualifiées. Par exemple, supposons que Person soit le schéma par défaut pour l’utilisateur exécutant les SELECT instructions suivantes. Bien que cet exemple ne nécessite pas que vous qualifiiez pleinement la table Person pour être exécutée, cela signifie que la deuxième instruction ne correspond pas à un plan existant, mais la troisième correspond :
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Modifier l’une des options suivantes SET pour une exécution donnée affecte la capacité à réutiliser les plans, car le Moteur de base de données effectue l’évaluation constante et ces options influencent les résultats de ces expressions :
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Mise en cache de plusieurs plans pour la même requête
Les requêtes et les plans d’exécution sont identifiables de manière unique dans le moteur de base de données, à l’instar d’une empreinte digitale :
- Le hachage de plan de requête est une valeur de hachage binaire calculée sur le plan d’exécution pour une requête donnée et utilisée pour identifier de manière unique des plans d’exécution semblables.
- Le hachage de requête est une valeur de hachage binaire calculée sur le texte T-SQL d’une requête, et sert à identifier de manière unique les requêtes.
Vous pouvez récupérer un plan compilé depuis le cache du plan en utilisant un plan handle. Cet identifiant transitoire reste constant uniquement tant que le plan reste dans le cache. Le handle de plan est une valeur de hachage dérivée du plan compilé de l’ensemble du lot. Le handle de plan pour un plan compilé reste le même même si une ou plusieurs instructions du lot sont recompilées.
Remarque
Si vous compilez un plan pour un lot au lieu d’une seule instruction, vous pouvez utiliser le handle du plan et les décalages des instructions pour obtenir le plan pour chaque instruction dans le lot.
Le sys.dm_exec_requests DMV contient les colonnes statement_start_offset et statement_end_offset pour chaque dossier. Ces colonnes font référence à l’instruction en cours d’exécution d’un lot ou objet persisté actuellement en cours d’exécution. Pour plus d’informations, voir sys.dm_exec_requests.
Le sys.dm_exec_query_stats DMV contient également ces colonnes pour chaque dossier. Ces colonnes font référence à la position d’une instruction au sein d’un lot ou d’un objet persisté. Pour plus d’informations, voir sys.dm_exec_query_stats.
Le texte T-SQL réel d’un lot est stocké dans un espace mémoire séparé du cache plan, appelé cache SQL Manager (SQLMGR). Vous pouvez récupérer le texte T-SQL d’un plan compilé depuis le cache SQL Manager en utilisant un descripteur SQL. Cet identifiant transitoire reste constant uniquement tant qu’au moins un plan qui y fait référence reste dans le cache du plan. Le handle SQL est une valeur de hachage dérivée de l’ensemble du texte du lot, et il est garanti d’être unique pour chaque lot.
Remarque
Comme un plan compilé, le texte T-SQL est stocké par lot, y compris les commentaires. Le descripteur SQL contient le hachage MD5 de l’ensemble du texte du lot et est garanti d’être unique pour chaque lot.
La requête suivante fournit des informations sur l’utilisation de la mémoire pour le cache SQL Manager :
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Il existe une relation un-à-plusieurs entre un handle SQL et les descripteurs de plan. Cette condition se produit lorsque la clé de cache des plans compilés est différente. Cette différence peut survenir en raison d’un changement d’options SET entre deux exécutions du même lot.
Examinez la procédure stockée suivante :
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Vérifiez ce que vous pouvez trouver dans le cache du plan en utilisant la requête suivante :
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Voici le jeu de résultats.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Exécutez maintenant la procédure stockée avec un paramètre différent, sans autre modification du contexte d’exécution :
EXECUTE usp_SalesByCustomer 8;
GO
Vérifiez encore ce que vous pouvez trouver dans le cache du plan. Voici le jeu de résultats.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Remarquez que la usecounts valeur augmente à 2, ce qui signifie que le même plan mis en cache est réutilisé as-is, car les structures de données du contexte d’exécution sont réutilisées. Changez maintenant l’option SET ANSI_DEFAULTS et exécutez la procédure stockée en utilisant le même paramètre.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Vérifiez encore ce que vous pouvez trouver dans le cache du plan. Voici le jeu de résultats.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Notez qu'il y a maintenant deux entrées dans le résultat de la DMV sys.dm_exec_cached_plans :
- La
usecountscolonne montre la valeur1dans le premier enregistrement. Cette valeur représente le plan exécuté une fois avecSET ANSI_DEFAULTS OFF. - La
usecountscolonne montre la valeur2dans le second enregistrement. Cette valeur représente le plan exécuté avecSET ANSI_DEFAULTS ON, car il a été exécuté deux fois. - La valeur
memory_object_addressdifférente fait référence à une entrée de plan d’exécution différente dans le cache du plan. Toutefois, la valeursql_handleest la même pour les deux entrées, car elles font référence au même lot.- L’exécution avec
ANSI_DEFAULTSdéfini àOFFa un nouveauplan_handle, et il est disponible pour être réutilisé pour les appels ayant le même ensemble d’optionsSET. Le nouvel identifiant de plan est nécessaire car le contexte d’exécution a été réinitialisé en raison de la modification des optionsSET. Mais ce changement ne déclenche pas de recompilation : les deux entrées font référence au même plan et à la même requête, comme en témoignent les mêmes valeursquery_plan_hashetquery_hash.
- L’exécution avec
Cette situation signifie que vous avez deux entrées de plan dans le cache correspondant au même lot. Cela souligne l’importance de s’assurer que les options SET affectant le cache du plan sont les mêmes lorsque les mêmes requêtes sont exécutées à plusieurs reprises. Cette approche optimise la réutilisation du plan et maintient la taille du cache du plan à son minimum requis.
Conseil
Un piège courant est que différents clients peuvent avoir des valeurs par défaut différentes pour les SET options. Par exemple, une connexion établie via SQL Server Management Studio fixe QUOTED_IDENTIFIER automatiquement à ON, tandis que SQLCMD fixe QUOTED_IDENTIFIER à OFF. Exécuter les mêmes requêtes depuis ces deux clients donne plusieurs plans (comme décrit dans l’exemple précédent).
Supprimer les plans d’exécution du cache du plan
Les plans d’exécution restent dans le cache des plans tant qu’il y a assez de mémoire pour les stocker. Lorsque la pression mémoire existe, le Moteur de base de données SQL Server utilise une approche basée sur le coût pour décider quels plans d’exécution retirer du cache des plans. Pour prendre une décision basée sur les coûts, le Moteur de base de données SQL Server augmente et diminue une variable de coût courante pour chaque plan d’exécution en fonction des facteurs suivants.
Lorsqu’un processus utilisateur insère un plan d’exécution dans le cache, le processus utilisateur fixe le coût courant égal au coût de compilation initial de la requête. Pour les plans d’exécution ad hoc, le processus utilisateur fixe le coût actuel à zéro. Ensuite, chaque fois qu’un processus utilisateur référence un plan d’exécution, il réinitialise le coût actuel au coût de compilation initial. Pour les plans d’exécution ad hoc, le processus utilisateur augmente le coût courant. Pour tous les plans, la valeur maximale du coût actuel correspond au coût de compilation d'origine.
Lorsque la pression de mémoire existe, le Moteur de base de données SQL Server retire les plans d’exécution du cache des plans. Pour identifier les plans à supprimer, le moteur de base de données SQL Server examine plusieurs fois l’état de chaque plan d’exécution et supprime des plans lorsque leur coût actuel est nul. Un plan d’exécution avec un coût actuel nul n’est pas supprimé automatiquement lorsqu’il y a une pression mémoire. Elle n'est supprimée que lorsque le Moteur de base de données SQL Server examine le plan et que le coût actuel est nul. Lors de l’examen d’un plan d’exécution, le moteur de base de données SQL Server pousse le coût actuel vers la valeur zéro en réduisant le coût actuel si aucune requête n’utilise actuellement le plan.
Le Moteur de base de données SQL Server continue d’examiner les plans d’exécution jusqu’à ce qu’il supprime suffisamment de plans pour satisfaire les besoins en mémoire. En cas de sollicitation élevée de la mémoire, un plan d'exécution peut voir son coût augmenter et diminuer à plusieurs reprises. Lorsque la pression mémoire n’existe plus, le Moteur de base de données SQL Server cesse de diminuer le coût actuel des plans d’exécution inutilisés. Tous les plans d’exécution restent dans la cache des plans, même si leur coût est nul.
Le moteur de base de données SQL Server utilise le moniteur de ressources et des threads de worker utilisateur pour libérer de la mémoire dans le cache de plans en réponse à une sollicitation élevée de la mémoire. Le moniteur des ressources et les threads de travail utilisateur peuvent examiner simultanément des plans pour réduire le coût actuel de chaque plan d’exécution inutilisé. Le moniteur de ressources supprime des plans d’exécution du cache de plan lorsqu'il existe une pression de mémoire globale. Il libère de la mémoire afin d'appliquer les stratégies en matière de mémoire système, de mémoire de processus, de mémoire du pool de ressources et de taille maximale pour tous les caches.
La taille maximale de tous les caches dépend de la taille du pool de mémoires tampons et ne peut pas dépasser la quantité maximale de mémoire du serveur. Pour plus d’informations sur la configuration de la mémoire maximale du serveur, voir le paramètre max server memory dans sp_configure.
Les threads de travail utilisateur suppriment des plans d’exécution du cache du plan en cas de sollicitation élevée de la mémoire d’un cache unique. Ils appliquent les stratégies de taille maximale de cache unique et de nombre maximal d'entrées de cache unique.
Les exemples suivants illustrent les plans d’exécution qui sont supprimés du cache du plan :
- Un plan d'exécution est fréquemment référencé de sorte que son coût n'est jamais égal à zéro. Le plan reste dans le cache du plan et n’est pas supprimé sauf s’il y a une pression mémoire et que le coût actuel est nul.
- Un plan d'exécution ad hoc est inséré, et il n'est pas référencé à nouveau avant l'apparition d'une pression sur la mémoire. Puisque les plans ad hoc sont initialisés avec un coût courant de zéro, lorsque le Moteur de base de données SQL Server examine le plan d’exécution, il détecte le coût courant nul et retire le plan du cache du plan. Le plan d’exécution ad hoc reste dans le cache du plan sans coût actuel lorsque la pression mémoire n’existe pas.
Pour supprimer manuellement un seul plan ou l’ensemble des plans du cache, utilisez DBCC FREEPROCCACHE. Vous pouvez aussi utiliser DBCC FREESYSTEMCACHE pour effacer n’importe quel cache, y compris le cache-plan. SQL Server 2016 (13.x) et versions ultérieures, utilisez ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE pour vider le cache de procédure (plan) de la base de données dans le contexte de la base de données active.
Un changement de certains paramètres de configuration via sp_configure et reconfigure entraîne également la suppression des plans du cache des plans. Vous trouverez la liste de ces paramètres de configuration dans la section Notes de l’article DBCC FREEPROCCACHE. Lorsque vous effectuez ce changement de configuration, le message informationnel suivant est écrit dans le journal d’erreurs :
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Recompiler les plans d'exécution
Certaines modifications dans une base de données peuvent rendre un plan d’exécution inefficace ou invalide. Le moteur de base de données détecte ces changements et marque le plan comme non valide. Il faut donc recompiler un nouveau plan pour la prochaine connexion qui exécute la requête. Les conditions qui invalident un plan incluent :
- Modifications d’une table ou d’une vue référencée par la requête (
ALTER TABLEetALTER VIEW). - Modifications d’une seule procédure, qui supprimeraient tous les plans de cette procédure du cache (
ALTER PROCEDURE). - Les modifications apportées à des index utilisés par le plan d'exécution.
- Mises à jour des statistiques utilisées par le plan d’exécution, qu’elles soient explicitement générées par une instruction telle que
UPDATE STATISTICSou générées automatiquement. - La suppression d'un index utilisé par le plan d'exécution.
- Un appel explicite à
sp_recompile. - Un nombre important de modifications de clés (générées par les instructions
INSERTouDELETEdes autres utilisateurs qui modifient une table référencée par la requête). - Pour les tables contenant des déclencheurs, si le nombre de lignes des tables inserted ou deleted augmente de manière significative.
- Exécuter une procédure stockée à l’aide de l’option
WITH RECOMPILE.
La plupart des recompilations sont nécessaires soit pour la correction des instructions, soit pour obtenir des plans d’exécution potentiellement plus rapides.
Lorsqu’une instruction dans un lot déclenche une recompilation, seule cette instruction est recompilée, pas l’ensemble du lot. Cette règle s’applique, que le lot soit soumis via une procédure stockée, un déclencheur, un lot ad hoc ou une instruction préparée.
La recompilation au niveau des instructions bénéficie aux performances car, dans la plupart des cas, un petit nombre d’instructions provoque des recompilations et leurs pénalités associées, en termes de temps CPU et de verrouillages. Ces pénalités sont donc évitées pour les autres énoncés du lot qui ne nécessitent pas de recompilation.
L’événement sql_statement_recompile étendu (XEvent) signale les recompilations de niveau instruction. Cet événement XEvent se produit lorsqu’une recompilation au niveau de l’instruction est requise par n’importe quel type de lot. Cette exigence inclut les procédures stockées, les déclencheurs, les lots ad hoc et les requêtes. Les lots peuvent être soumis via plusieurs interfaces, notamment sp_executesql, SQL dynamique, méthodes Prepare ou méthodes Execute.
La recompile_cause colonne de sql_statement_recompile XEvent contient un code entier qui indique la raison de la recompilation. La liste suivante contient les raisons possibles :
- Options de curseur modifiées
- Compilation différée
- Autorisation
FOR BROWSEmodifiée -
OPTION (RECOMPILE)demandé - Plan paramétré vidé
- Vue partitionnée modifiée
- Plan affectant la version de base de données modifié
- Environnement de notification de requête modifié
- Plan manquant dans le Magasin des requêtes
- Échec de forçage de plan de Magasin des requêtes
- Stratégie de forçage de plan de Magasin des requêtes modifiée
- Ensemble de lignes à distance modifié
- Schéma modifié
-
SEToption modifiée - Statistiques modifiées
- Table temporaire modifiée
Remarque
Lorsque vous définissez l’option AUTO_UPDATE_STATISTICS de base de données à ON, les requêtes sont recompilées lorsqu’elles ciblent des tables ou des vues indexées dont les statistiques sont mises à jour ou dont les cardinalités changent significativement depuis la dernière exécution. Ce comportement s’applique aux tables standard définies par l'utilisateur, aux tables temporaires, ainsi qu'aux tables "inserted" et "deleted" créées par des déclencheurs DML.
Définir AUTO_UPDATE_STATISTICS sur OFF arrête ces recompilations, mais les statistiques obsolètes dégradent généralement les performances des requêtes plus que les recompilations. Pour plus d’informations, consultez l’option AUTO_UPDATE_STATISTICS . Les tables insérées et supprimées des déclencheurs DML INSTEAD OF sont créées dans tempdb, donc elles suivent le réglage AUTO_UPDATE_STATISTICS de tempdb.
Utiliser des paramètres explicites pour la réutilisation du plan
L’utilisation de paramètres, y compris des paramètres nommés dans les applications ADO.NET et les marqueurs de paramètres dans les applications OLE DB et ODBC, peut augmenter la réutilisation des plans d’exécution.
Avertissement
Validez toujours les entrées utilisateur en testant leur type, leur longueur, leur format et leur plage. Pour plus d’informations, consultez Injection SQL.
La seule différence entre les deux instructions SELECT suivantes porte sur les valeurs comparées dans la clause WHERE :
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
La seule différence entre les plans d’exécution de ces requêtes est la valeur stockée pour la comparaison avec la colonne ProductSubcategoryID . Bien que l'objectif soit que le Moteur de base de données reconnaisse toujours que les instructions génèrent essentiellement le même plan et réutilise les plans, le Moteur de base de données ne détecte parfois pas cette similarité dans des instructions T-SQL complexes.
Séparer les constantes de l’instruction T-SQL en utilisant des paramètres aide le moteur relationnel à reconnaître les plans identiques. Utilisez les paramètres de la manière suivante :
En T-SQL, utilisez
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Cette méthode est recommandée pour les scripts T-SQL, procédures stockées ou déclencheurs qui génèrent dynamiquement des instructions SQL.
ADO.NET avec
SqlClientutilise des paramètres nommés, tels que@Parm. OLE DB et ODBC utilisent des marqueurs de paramètres. Les marqueurs de paramètres sont des points d’interrogation (?) qui remplacent une constante dans une instruction SQL et sont liés à une variable de programme. Dans une application ODBC, vous pourriez par exemple procéder comme suit :Permet
SQLBindParameterde lier une variable entière au premier marqueur de paramètre dans une instruction SQL.Placez la valeur de type entier dans la variable.
Exécuter l’instruction en spécifiant le marqueur de paramètre (
?) :SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
Le fournisseur OLE DB Native Client de SQL Server et le pilote ODBC de SQL Server Native Client utilisent
sp_executesqlpour envoyer des instructions à SQL Server lorsque des marqueurs de paramètres sont utilisés dans les applications.Écrire des procédures stockées, conçues pour utiliser des paramètres.
Si vous n’intégrez pas explicitement des paramètres dans la conception de vos applications, vous pouvez aussi compter sur l’Optimiseur de requêtes pour paramétrer automatiquement certaines requêtes en utilisant le comportement par défaut de la paramétrisation simple. Vous pouvez également forcer l’optimiseur de requête à paramétrer l’ensemble des requêtes de la base de données en attribuant la valeur PARAMETERIZATION à l’option ALTER DATABASE de l’instruction FORCED.
Paramétrisation simple
Dans le Moteur de base de données, l’utilisation de paramètres ou de marqueurs de paramètres dans les instructions T-SQL augmente la capacité du moteur relationnel à faire correspondre les nouvelles instructions T-SQL avec les plans d’exécution existants et déjà compilés.
Avertissement
Validez toujours les entrées utilisateur en testant leur type, leur longueur, leur format et leur plage. Pour plus d’informations, consultez Injection SQL.
Si une instruction T-SQL est exécutée sans paramètres, le Moteur de base de données paramètre l’instruction en interne afin d’augmenter la possibilité de la faire correspondre à un plan d’exécution existant. Ce processus s’appelle la paramétrisation. Par défaut, c’est la paramétrisation simple, et vous pouvez activer la paramétrisation forcée pour une base de données.
Considérons cet énoncé :
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Vous pouvez spécifier la valeur 1 à la fin de l’instruction comme paramètre. Le moteur relationnel construit le plan d’exécution pour ce lot comme si vous spécifiiez un paramètre à la place de la valeur 1. Grâce à cette simple paramétrisation, le Moteur de base de données reconnaît que les deux instructions suivantes génèrent essentiellement le même plan d’exécution et réutilise le premier plan pour la seconde instruction :
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Lors du traitement d’instructions T-SQL complexes, le moteur relationnel peut avoir du mal à déterminer quelles expressions peuvent être paramétrées. Pour augmenter la capacité du moteur relationnel à associer des instructions T-SQL complexes à des plans d’exécution existants et inutilisés, spécifiez explicitement les paramètres en utilisant soit sp_executesql, soit des marqueurs de paramètres.
Remarque
Lorsque vous utilisez les opérateurs arithmétiques +, -, *, / ou % pour effectuer la conversion implicite ou explicite des valeurs constantes int, smallint, tinyint ou bigint en types de données float, real, decimal ou numeric, le moteur de base de données applique des règles spécifiques pour calculer le type et la précision des résultats d’expression. Ces règles diffèrent selon que la requête est paramétrée ou non. Par conséquent, dans certains cas, des expressions similaires dans les requêtes peuvent produire des résultats différents.
Sous le comportement par défaut de paramétrisation simple, le Moteur de base de données paramétrise une classe relativement petite de requêtes. Toutefois, vous pouvez attribuer la valeur PARAMETERIZATION à l’option ALTER DATABASE de la commande FORCEDpour spécifier que toutes les requêtes d’une base de données soient paramétrables, sous réserve de certaines contraintes. Ce changement peut améliorer les performances des bases de données qui subissent un volume élevé de requêtes simultanées en réduisant la fréquence des compilations de requêtes.
Une autre solution consiste à spécifier que ne soient paramétrables qu'une requête et toutes autres requêtes dont la syntaxe ne se différencie que par les valeurs des paramètres.
Conseil
Lorsque vous utilisez une solution de cartographie objet-relationnelle (ORM) telle qu’Entity Framework (EF), les requêtes applicatives comme les arbres manuels de requêtes LINQ ou certaines requêtes SQL brutes peuvent ne pas être paramétrées. Cette limitation impacte la réutilisation du plan et la capacité à suivre les requêtes dans le Magasin des requêtes. Pour plus d’informations, consultez Mise en cache et paramétrage des requêtes EF et Requêtes SQL EF brutes.
Paramétrisation forcée
Vous pouvez redéfinir le comportement par défaut de paramétrisation simple du Moteur de base de données en spécifiant que les instructions SELECT, INSERT, UPDATE et DELETE d’une base de données soient toutes paramétrées, sous réserve de certaines limitations. Activez la paramétrisation forcée en définissant l’option PARAMETERIZATION à FORCED dans l’instruction ALTER DATABASE. La paramétrisation forcée peut améliorer les performances de certaines bases de données en réduisant la fréquence des compilations et recompilations des requêtes. Les bases de données qui peuvent tirer profit du paramétrage forcé sont généralement des bases de données devant gérer un nombre important de requêtes simultanées émanant de sources telles que des applications de point de vente.
Lorsque vous définissez l’option PARAMETERIZATION à FORCED, toute valeur littérale apparaissant dans une instruction SELECT, INSERT, UPDATE ou DELETE, soumise sous n’importe quelle forme, est convertie en paramètre lors de la compilation de la requête. Les littéraux apparaissant dans les constructions de requêtes suivantes font toutefois exception :
- Déclarations
INSERT...EXECUTE. - Les instructions internes au corps de procédures stockées, de déclencheurs ou de fonctions définies par l’utilisateur. Le Moteur de base de données réutilise déjà les plans de requête pour ces routines.
- Des requêtes préparées qui sont déjà paramétrées dans l’application cliente.
- Les instructions contenant des appels de méthode XQuery, où la méthode apparaît dans un contexte nécessitant généralement que ses arguments soient paramétrés (clause
WHERE, par exemple). Si la méthode figure dans un contexte où le paramétrage de ses arguments n'est pas requis, le reste de l'instruction est paramétré. - Instructions à l’intérieur d’un curseur T-SQL. (Les instructions
SELECTà l’intérieur des curseurs API sont paramétrables.) - Constructions de requêtes déconseillées.
- Toute instruction qui s’exécute dans le contexte de
ANSI_PADDINGou deANSI_NULLS, défini surOFF. - Les instructions contenant plus de 2 097 littéraux pouvant être paramétrables.
- Les instructions faisant référence à des variables comme
WHERE T.col2 >= @bb. - Les instructions contenant l’indicateur de requête
RECOMPILE. - Les déclarations contenant une clause
COMPUTE. - Les déclarations contenant une clause
WHERE CURRENT OF.
Les clauses de requête suivantes ne sont pas paramétrées. Dans de tels cas, seules les clauses ne sont pas paramétrables. D'autres clauses au sein de la même requête peuvent être l'objet d'un paramétrage forcé.
- L’
<select_list>de toute déclarationSELECT. Cette liste comprendSELECTdes listes de sous-requêtes etSELECTdes listes à l’intérieur des instructionsINSERT. - Les instructions
SELECTde sous-requêtes apparaissant dans une instructionIF. - Les clauses
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOouFOR XMLd’une requête. - Les arguments, qu’il s’agisse d’un argument direct ou d’une sous-expression, des opérateurs
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXMLouFULLTEXT. - Les arguments pattern et escape_character d’une clause
LIKE. - L’argument style d’une clause
CONVERT. - Des constantes entières dans une clause
IDENTITY. - Les constantes spécifiées à l'aide de la syntaxe d'extension ODBC.
- Les expressions de constantes pouvant être évaluées lors de la compilation et qui sont des arguments des opérateurs
+,-,*,/et%. Lorsqu’il s’agit d’examiner l’éligibilité à la paramétrisation forcée, le Moteur de base de données considère une expression comme étant réductible à une constante lorsque l’une des conditions suivantes est vraie :- l'expression ne contient pas de colonnes, de variables ou de sous-requêtes ;
- l’expression contient une clause
CASE.
- Arguments pour les clauses d’indicateur d’optimisation de requête, y compris l’argument number_of_rows de l’indicateur d’optimisation de requête
FAST, l’argument number_of_processors de l’indicateur d’optimisation de requêteMAXDOP, et l’argument number de l’indicateur d’optimisation de requêteMAXRECURSION.
La paramétrisation se produit au niveau des instructions T-SQL individuelles. En d'autres termes, les instructions individuelles d'un traitement sont paramétrables. Après compilation, une requête paramétrée s’exécute dans le contexte du lot dans lequel elle a été initialement soumise. Si un plan d’exécution pour une requête est mis en cache, vous pouvez déterminer si la requête a été paramétrée en référençant la sql colonne de la sys.syscacheobjects vue de gestion dynamique. Si une requête est paramétrée, les noms et types de données des paramètres précèdent le texte du lot soumis dans cette colonne, comme dans (@1 TINYINT).
Remarque
Les noms des paramètres sont arbitraires. Les utilisateurs ou applications ne devraient pas se fier à un ordre de nommage particulier. De plus, les éléments suivants peuvent changer entre les versions de SQL Server et les mises à niveau de cumulative update (CU) : les noms des paramètres, le choix des littéraux paramétrés et l’espacement dans le texte paramétré.
Types de données des paramètres
Lorsque le Moteur de base de données paramétrise les littéraux, les paramètres sont convertis en types de données suivants :
- Les littéraux entiers dont la taille correspondrait autrement au type de données int paramètrent en int. Les grands littéraux entiers qui font partie de prédicats impliquant tout opérateur de comparaison (incluant
<,<=,=,!<,>,>=,<>,!>,!=,ALL,SOME,BETWEEN,ANYetIN) paramètrent en numeric(38,0). Les littéraux plus grands qui ne font pas partie de prédicats impliquant des opérateurs de comparaison sont paramétrés comme numérique dont la précision est juste assez grande pour supporter sa taille et dont le nombre de décimales est de 0. - Les littéraux numériques en virgule fixe, qui font partie de prédicats impliquant des opérateurs de comparaison, sont paramétrés comme numérique dont la précision est de 38 et dont le nombre de décimales est juste assez grand pour prendre en charge sa taille. Des littéraux numériques à virgule fixe qui ne font pas partie de prédicats impliquant des opérateurs de comparaison sont paramétrés comme numérique, dont la précision et l’échelle sont juste assez grandes pour supporter leur taille.
- Les littéraux numériques en virgule flottante sont paramétrés en float(53).
- Les littéraux de chaînes non Unicode paramétrent varchar(8000) si le littéral tient dans 8 000 caractères, et varchar(max) s’il est plus grand que 8 000 caractères.
- Les littéraux de chaînes Unicode sont paramétrés en nvarchar(4000) si le littéral tient dans 4 000 caractères Unicode, et en nvarchar(max) si le littéral dépasse 4 000 caractères.
- Les littéraux binaires paramètrent en varbinary(8000) si le littéral tient dans 8 000 octets. Si elle dépasse 8 000 octets, elle est convertie en varbinary(max).
- Les littéraux monétaires se paramètrent en money.
Principes d'utilisation du paramétrage forcé
Considérez les points suivants lorsque vous définissez l’option PARAMETERIZATION à FORCED:
- La paramétrisation forcée transforme les constantes littérales d’une requête en paramètres lors de la compilation d’une requête. Par conséquent, l'optimiseur de requête peut opter pour des plans d'exécution de requêtes non optimisés. Plus spécifiquement, il est moins probable que l'optimiseur de requête établisse une correspondance avec une vue indexée ou un index d'une colonne calculée. Il peut également opter pour des plans non optimisés dans le cas de requêtes soumises pour des tables partitionnées ou des vues partitionnées et distribuées. N’utilisez pas de paramétrisation forcée pour les environnements qui dépendent fortement de vues indexées et d’index sur des colonnes calculées. En général, seuls les professionnels expérimentés des bases de données devraient utiliser cette
PARAMETERIZATION FORCEDoption après avoir déterminé qu’elle n’affecte pas négativement les performances. - Les requêtes distribuées qui font référence à plusieurs bases de données sont éligibles pour le paramétrage forcé pour autant que l’option
PARAMETERIZATIONait la valeurFORCEDdans la base de données dont le contexte fait l’objet de la requête. - Définir l’option
PARAMETERIZATIONsurFORCEDvide tous les plans de requête du cache de plans d’une base de données, sauf ceux qui sont actuellement en train de compiler, de recompiler ou de s’exécuter. Les plans de requête qui sont en cours de compilation ou d’exécution lors de la modification du paramètre sont paramétrés la prochaine fois que la requête s’exécute. - Définir cette
PARAMETERIZATIONoption est une opération en ligne qui ne nécessite aucun verrou exclusif au niveau de la base de données. - Le paramètre actuel de l’option
PARAMETERIZATIONest conservé en cas de rattachement ou de restauration d’une base de données.
Vous pouvez remplacer le comportement de paramétrisation forcée en spécifiant que la paramétrisation simple doit être tentée sur une seule requête, ainsi que sur toute autre requête syntaxiquement équivalente mais ne différant que par leurs valeurs de paramètres. À l'inverse, vous pouvez spécifier que le paramétrage forcé soit tenté sur seul jeu de requêtes de syntaxe équivalente, même en cas de désactivation de l'option de paramétrage forcé dans la base de données. Utilisez des guides de plan à cet effet.
Remarque
Quand l’option PARAMETERIZATION est définie avec la valeur FORCED, le rapport des messages d’erreur peut ne pas être le même que quand l’option PARAMETERIZATION est définie avec la valeur SIMPLE : davantage de messages d’erreur peuvent être signalés avec le paramétrage forcé qu’avec le paramétrage simple et les numéros de ligne où interviennent les erreurs peuvent ne pas être corrects.
En cas d’activation du paramétrage forcé, il est toujours possible d’utiliser le paramétrage simple. Par exemple, la requête suivante ne peut être paramétrée conformément aux règles de paramétrage forcé :
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Elle peut toutefois être paramétrée conformément aux règles de paramétrage simple. En cas de tentative infructueuse de paramétrage forcé, le paramétrage simple est activé.
Préparation des instructions SQL
Le Moteur de base de données prend en charge la préparation des instructions T-SQL avant l’exécution. Si une application doit exécuter plusieurs fois une instruction T-SQL, elle peut utiliser l’API de la base de données pour :
- Préparer la déclaration une seule fois. Cette étape compile l’instruction T-SQL en un plan d’exécution.
- Exécutez le plan d’exécution précompilé chaque fois que l’instruction doit être exécutée. Cette approche empêche de recompiler l’instruction T-SQL à chaque exécution après la première fois. La préparation et l'exécution des instructions sont contrôlées par les fonctions et les méthodes API. Le fournisseur OLE DB SQL Server Native Client et le pilote ODBC de SQL Server Native Client prennent en charge le modèle de préparation/exécution d’instructions T-SQL. Lors d’une demande de préparation, le fournisseur ou le pilote envoie l’instruction à SQL Server avec une demande de préparation de l’instruction. Le moteur de base de données compile un plan d’exécution et renvoie un identificateur pour ce plan au fournisseur ou au pilote. Pour toute requête d'exécution, le fournisseur ou le pilote envoie au serveur une requête d'exécution du plan associé au descripteur.
Les instructions préparées ne peuvent pas créer d'objets temporaires dans le Moteur de base de données. Les instructions préparées ne peuvent pas faire référence à des procédures stockées du système qui créent des objets temporaires, tels que des tables temporaires. Ces procédures doivent être exécutées directement.
Une utilisation excessive du modèle préparation/exécution peut dégrader les performances. Si une instruction n’est exécutée qu’une seule fois, l’exécution directe ne nécessite qu’un seul aller-retour réseau vers le serveur. Préparer et exécuter une instruction T-SQL exécutée une seule fois nécessite un aller-retour réseau supplémentaire : un aller-retour pour préparer l’instruction et un aller-retour pour l’exécuter.
Préparer une requête est plus efficace si vous utilisez des marqueurs de paramètres. Par exemple, supposons que vous demandez occasionnellement à une application d’extraire des informations sur un produit à partir de l’exemple de base de données AdventureWorksLT2025 . Il existe deux façons dont l’application peut accomplir cette tâche.
En utilisant la première approche, l’application peut exécuter une requête distincte pour chaque produit demandé :
SELECT *
FROM Production.Product
WHERE ProductID = 63;
En utilisant la seconde approche, l’application effectue les opérations suivantes :
Prépare une instruction SQL contenant un marqueur de paramètre (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Lier une variable de programme au marqueur de paramètres.
Chaque fois que vous avez besoin d'informations sur un produit, l'application remplit la variable liée avec la valeur de la clé et exécute l'instruction.
La seconde approche est plus efficace si l’instruction est exécutée plus de trois fois.
Dans le Moteur de base de données, le modèle prépare/execute n’a pas d’avantage significatif en termes de performance par rapport à l’exécution directe, en raison de la manière dont le Moteur de base de données réutilise les plans d’exécution. Le Moteur de base de données dispose d’algorithmes efficaces pour associer les instructions T-SQL actuelles aux plans d’exécution générés pour les exécutions précédentes de la même instruction T-SQL. Si une application exécute plusieurs fois une instruction T-SQL avec des marqueurs de paramètres, le Moteur de base de données réutilise le plan d’exécution de la première exécution pour la seconde et les exécutions suivantes (sauf si le plan est supprimé du cache des plans). Le modèle de préparation et d'exécution offre encore d'autres avantages :
- Trouver un plan d’exécution grâce à un handle d’identification est plus efficace que les algorithmes utilisés pour associer une instruction T-SQL à des plans d’exécution existants.
- L’application peut contrôler quand le plan d’exécution est créé et quand il est réutilisé.
- Le modèle de préparation et d’exécution peut être transféré à d’autres bases de données, y compris des versions antérieures de SQL Server.
Sensibilité du paramètre
La sensibilité aux paramètres, également appelée sniffing des paramètres, désigne un processus dans lequel le Moteur de base de données renifle les valeurs actuelles des paramètres lors de la compilation ou de la recompilation, puis les transmet à l’optimiseur de requêtes afin d’aider potentiellement à générer des plans d’exécution de requêtes plus efficaces.
Les valeurs de paramètres sont détectées pendant la compilation ou la recompilation pour les types de lots suivants :
- Procédures stockées
- Requêtes soumises via
sp_executesql - Requêtes préparées
Pour plus d’informations sur le dépannage des problèmes de parameter sniffing, voir :
- Examinez et résolvez les problèmes de sensibilité aux paramètres.
- Utiliser des paramètres explicites pour la réutilisation du plan
- Optimisation du plan de sensibilité aux paramètres
- Résoudre les problèmes liés aux plans d’exécution sensibles aux paramètres dans les requêtes d’Azure SQL Database
- Résoudre les problèmes de requêtes liés aux plans d’exécution de requêtes sensibles aux paramètres dans Azure SQL Managed Instance
Lorsqu’une requête dans le Moteur de base de données utilise l’indication OPTION (RECOMPILE), l’optimiseur de requête transforme les paramètres et variables locales en constantes de compilation pouvant être évaluées à la compilation et réduites à des littéraux. Lors de la compilation, l’optimiseur connaît et peut utiliser les valeurs d’exécution actuelles des paramètres et des variables locales telles qu’elles existent juste avant cette instruction. L’indication OPTION (RECOMPILE) permet à l’optimiseur de générer un plan de requête plus optimal, adapté aux valeurs spécifiques, et de tirer parti des meilleurs index sous-jacents à l’exécution. Pour les paramètres, ce processus ne fait pas référence aux valeurs passées initialement au lot ou à la procédure stockée, mais à leurs valeurs au moment de la recompilation. Ces valeurs peuvent être modifiées dans la procédure avant d’atteindre l’énoncé qui inclut RECOMPILE. Ce comportement peut améliorer les performances des requêtes avec des données d’entrée très variables ou déséquilibrées, au prix de la compilation de la requête à chaque exécution. Ce coût peut être élevé. Évitez d’utiliser l’indice RECOMPILE sans évaluer son impact sur toute la charge de travail.
Variables locales et estimations de cardinalité
Lorsqu'une requête utilise des variables locales, le Moteur de base de données ne peut pas inspecter leurs valeurs au moment de la compilation, il estime donc la cardinalité en utilisant les statistiques ou heuristiques disponibles. Si des statistiques existent, il utilise généralement la valeur All Density (également appelée densité moyenne) de l’histogramme statistique pour estimer le nombre de lignes correspondant au prédicat. Cependant, si aucune statistique n’est disponible pour la colonne, le Moteur de base de données revient sur des estimations heuristiques, comme supposer 10% de sélectivité pour les prédicats d’égalité, et 30% pour les inégalités et les plages. Ces estimations pourraient conduire à des plans d’exécution moins précis. Voici un exemple de requête qui utilise une variable locale.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
Dans ce cas, le Moteur de base de données n'utilise pas la valeur 100 pour optimiser la requête. Elle utilise une estimation générale.
Traitement de requêtes en parallèle
Le Moteur de base de données fournit des requêtes parallèles pour optimiser l’exécution des requêtes et les opérations d’indexation pour les ordinateurs disposant de plus d’un microprocesseur (CPU). Comme le Moteur de base de données peut effectuer une requête ou une opération d’indexation en parallèle en utilisant plusieurs threads de travail du système d’exploitation, l’opération se termine rapidement et efficacement.
Lors de l’optimisation des requêtes, le Moteur de base de données recherche des requêtes ou des opérations d’index qui pourraient bénéficier d’une exécution parallèle. Pour ces requêtes, le Moteur de base de données insère des opérateurs d’échange dans le plan d’exécution des requêtes afin de préparer la requête à une exécution parallèle. Un opérateur d'échange est un opérateur dans un plan d'exécution de requêtes qui assure la gestion du processus, la redistribution des données et le contrôle de flux. L’opérateur d’échange inclut les opérateurs logiques Distribute Streams, Repartition Streams, et Gather Streams comme sous-types, dont un ou plusieurs peuvent apparaître dans la sortie Showplan du plan de requête pour une requête parallèle.
Important
Certaines structures entravent la capacité du Moteur de base de données à utiliser le parallélisme sur l'ensemble du plan d'exécution, ou sur certaines parties du plan d'exécution.
Les constructions qui empêchent le parallélisme sont les suivantes :
| Construction | Descriptif |
|---|---|
| Fonctions UDF scalaires | Pour plus d’informations sur les fonctions définies par l’utilisateur scalaires, voir Créer des fonctions définies par l’utilisateur. À partir de SQL Server 2019 (15.x), le Moteur de base de données SQL Server peut incorporer ces fonctions en ligne et débloquer l’utilisation du parallélisme lors du traitement des requêtes. Pour plus d’informations sur l’inlining scalaire UDF, voir Traitement intelligent des requêtes dans les bases de données SQL. |
| Requête à distance | Pour plus d’informations sur Remote Query, voir Référence de l’opérateur de showplan logique et physique. |
| Curseurs dynamiques | Pour plus d’informations sur les curseurs, voir DECLARE CURSOR. |
| Requêtes récursives | Pour plus d’informations sur la récursion, consultez Guidelines for Defining and Using Recursive Common Table Expressions et la récursion en T-SQL. |
| Fonctions table à instructions multiples (MSTVF) | Pour plus d’informations sur les MSTVF, voir Créer des fonctions définies par l’utilisateur (Moteur de base de données). |
TOP mot clé |
Pour plus d’informations, voir TOP. |
Un plan d’exécution de requête peut contenir l’attribut NonParallelPlanReason dans l’élément QueryPlan qui décrit pourquoi le parallélisme n’a pas été utilisé. Les valeurs de cet attribut peuvent notamment être les suivantes :
| NonParallelPlanReason Valeur | Descriptif |
|---|---|
MaxDOPSetToOne |
Degré maximal de parallélisme fixé à 1. |
EstimatedDOPIsOne |
Le degré estimé de parallélisme est 1. |
NoParallelWithRemoteQuery |
Le parallélisme n’est pas pris en charge pour les requêtes distantes. |
NoParallelDynamicCursor |
Les plans parallèles ne sont pas disponibles pour les curseurs dynamiques. |
NoParallelFastForwardCursor |
Les plans parallèles ne sont pas pris en charge pour les curseurs à avance rapide. |
NoParallelCursorFetchByBookmark |
Plans parallèles non pris en charge pour les curseurs extraits par signet. |
NoParallelCreateIndexInNonEnterpriseEdition |
La création d’index parallèles n’est pas prise en charge pour les éditions hors Entreprise. |
NoParallelPlansInDesktopOrExpressEdition |
Plans parallèles non pris en charge pour les éditions Desktop et Express. |
NonParallelizableIntrinsicFunction |
La requête fait référence à une fonction intrinsèque non parallélisable. |
CLRUserDefinedFunctionRequiresDataAccess |
Parallélisme non pris en charge pour une fonction CLR définie par l’utilisateur qui requiert l’accès aux données. |
TSQLUserDefinedFunctionsNotParallelizable |
La requête fait référence à une fonction T-SQL définie par l’utilisateur qui n’était pas parallélisable. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Les transactions de table de variables ne prennent pas en charge les transactions imbriquées parallèles. |
DMLQueryReturnsOutputToClient |
La requête DML retourne la sortie au client et n’est pas parallélisable. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
Combinaison non prise en charge de plans d'exécution série et parallèle pour une seule construction d’index en ligne. |
CouldNotGenerateValidParallelPlan |
Échec de la vérification du plan parallèle, rétablissement en série. |
NoParallelForMemoryOptimizedTables |
Le parallélisme n'est pas pris en charge pour les tables OLTP en mémoire référencées. |
NoParallelForDmlOnMemoryOptimizedTable |
Parallélisme non pris en charge pour DML sur une table OLTP en mémoire. |
NoParallelForNativelyCompiledModule |
Parallélisme non pris en charge pour les modules référencés compilés en mode natif. |
NoRangesResumableCreate |
Échec de la génération de la plage pour une opération de création pouvant être reprise. |
Une fois les opérateurs d'échange insérés, vous obtenez un plan d'exécution de requêtes en parallèle. Un plan d’exécution de requêtes en parallèle peut utiliser plusieurs threads de travail. Un plan d’exécution en série utilisé par requête (série) non parallèle n’utilise qu’un seul thread de travail pour son exécution. Le nombre réel de threads de travail utilisés par une requête parallèle est déterminé lors de l’initialisation de l’exécution du plan de requête et dépend de la complexité du plan et du degré de parallélisme.
Le degré de parallélisme (DOP) spécifie le nombre maximal de processeurs pouvant être utilisés pour exécuter une tâche parallèle. Le DOP n’indique pas le nombre total de threads de travail utilisés par une requête. La limite de degré de parallélisme est définie par tâche. Il ne s’agit pas d’une limite par demande ou par requête. Cela signifie que lors d’une exécution de requête parallèle, une requête unique peut générer plusieurs tâches qui sont affectées à un planificateur. Plus de processeurs que ce que spécifie MAXDOP peuvent être utilisés simultanément à un moment donné de l’exécution de la requête, lorsque différentes tâches sont exécutées simultanément. Pour plus d’informations, consultez le guide d’architecture des threads et des tâches.
L’optimiseur de requêtes n’utilise pas de plan d’exécution parallèle pour une requête si l’une des conditions suivantes est vraie :
Le plan d’exécution série est trivial, ou ne dépasse pas le paramètre de seuil de coût pour le parallélisme.
Le plan d’exécution en série a un coût de sous-arborescence estimé inférieur à n’importe quel plan d’exécution parallèle exploré par l’optimiseur.
La requête contient des opérateurs scalaires ou relationnels qui ne peuvent être exécutés en parallèle. Certains opérateurs peuvent entraîner l'exécution d'une section du plan de requête ou de la totalité du plan en mode série.
Remarque
Le coût total estimé de la sous-arborescence dans un plan parallèle peut être inférieur au seuil de coût défini pour le parallélisme. En d’autres termes, le coût total estimé du sous-arbre du plan sériel le dépassait, et le plan d’interrogation avec le coût total estimé du sous-arbre le plus bas était choisi.
Degré de parallélisme (DOP)
Le Moteur de base de données détecte automatiquement le meilleur degré de parallélisme pour chaque instance d’une exécution parallèle de requêtes ou d’une opération de définition de données d’index (DDL). Il détermine cette valeur en se basant sur les critères suivants :
Que SQL Server fonctionne sur un ordinateur équipé de plusieurs microprocesseurs ou CPUs, tel qu'un ordinateur à multitraitement symétrique (SMP, symmetric multiprocessing). Seuls les ordinateurs dotés de plusieurs processeurs peuvent utiliser des requêtes en parallèle.
Si le nombre de threads de travail disponibles est suffisant. Chaque requête ou opération d’index nécessite un certain nombre de threads de travail. Pour être exécuté, un plan parallèle nécessite plus de threads de travail qu’un plan série, le nombre de threads de travail nécessaires allant de pair avec le degré de parallélisme. Lorsque l'exigence de thread worker du plan parallèle pour un degré spécifique de parallélisme ne peut pas être satisfaite, le Moteur de base de données SQL Server diminue automatiquement le degré de parallélisme, ou exécute le plan parallèle en série.
Le type de requête ou d’opération d’index exécuté. Les requêtes qui utilisent fortement les cycles microprocesseur et les opérations d'index qui créent ou reconstruisent un index, ou qui suppriment un index cluster, sont les candidates idéales pour un plan parallèle. Par exemple, les jointures de grandes tables, les agrégations importantes et le tri d'ensembles de résultats volumineux s'y prêtent bien. Les requêtes basiques, souvent présentes dans les applications de traitement transactionnel, montrent que la coordination supplémentaire nécessaire pour exécuter une requête en parallèle l’emporte sur l’amélioration potentielle des performances. Pour faire la distinction entre les requêtes qui tirent profit du parallélisme et les autres, le moteur de base de données SQL Server compare le coût estimé de l’exécution de la requête ou de l’opération d’index à la valeur cost threshold for parallelism. Les utilisateurs peuvent modifier la valeur par défaut de
5en utilisant sp_configure si un test approprié révèle qu’une valeur différente convient mieux à la charge de travail en cours.S’il y a un nombre suffisant de lignes à traiter. Si l'optimiseur de requête détermine que le nombre de lignes est trop faible, il n'introduit pas d'opérateurs d'échange pour distribuer les lignes. Par conséquent, ces opérateurs sont exécutés en série. L'exécution des opérateurs dans un plan série permet d'éviter que les coûts de démarrage, de distribution et de coordination dépassent les bénéfices d'une exécution en parallèle.
Que des statistiques actuelles soient disponibles. Si le degré le plus élevé de parallélisme n'est pas possible, des degrés inférieurs sont envisagés avant que le plan parallèle ne soit abandonné. Par exemple, lorsque vous créez un index regroupé sur une vue, les statistiques ne peuvent pas être calculées, car l’index regroupé n’existe pas encore. Dans ce cas, le moteur de base de données SQL Server est incapable de garantir le degré de parallélisme le plus élevé pour l’opération d’index. Toutefois, certains opérateurs, tels que le tri et l'analyse, peuvent malgré tout bénéficier de l'exécution en parallèle.
Remarque
Les opérations d’index parallèles ne sont disponibles que dans les éditions Entreprise, Developer et Evaluation de SQL Server.
Lors de l’exécution, le moteur de base de données SQL Server détermine si la charge de travail actuelle du système et les informations de configuration décrites ci-dessus permettent une exécution parallèle. Si c’est le cas, le moteur de base de données SQL Server détermine le nombre optimal de threads de travail et répartit l’exécution du plan parallèle parmi ces derniers. Quand une requête ou une opération d’index commence à s’exécuter en parallèle sur plusieurs threads de travail, un nombre identique de threads de travail est utilisé jusqu’à ce que l’opération soit terminée. Le moteur de base de données SQL Server réexamine le nombre optimal de threads de travail chaque fois qu’un plan d’exécution est récupéré à partir du cache de plans. Par exemple, une exécution d’un plan parallèle mis en cache peut s’exécuter en série, une exécution ultérieure du même plan peut utiliser trois threads ouvriers, et une troisième exécution peut utiliser quatre threads ouvriers.
Les opérateurs Update et Delete d’un plan d’exécution de requêtes parallèles sont exécutés en série, mais la clause WHERE d’une instruction UPDATE ou DELETE peut être exécutée en parallèle. Les modifications réelles des données sont ensuite appliquées en série à la base de données.
À partir du niveau de compatibilité de base de données 110, l’instruction SELECT ... INTO peut être exécutée en parallèle. D’autres types d’opérateurs d’insertion fonctionnent de la même manière que dans les versions précédentes.
À partir du niveau de compatibilité de la base de données 130, l’instruction INSERT ... SELECT peut être exécutée en parallèle lors de l’insertion dans des tas ou des index columnstore en cluster (CCI), et en utilisant l’indicateur TABLOCK. Les insertions dans des tables temporaires locales (identifiées par le préfixe #) et les tables temporaires globales (identifiées par les préfixes ##) sont également activées pour le parallélisme grâce à l’indice TABLOCK. Pour plus d’informations, consultez INSERT.
Les curseurs statiques et les curseurs pilotés par jeux de clés peuvent être complétés par des plans d'exécution parallèle. Cependant, le comportement des curseurs dynamiques ne peut être fourni que par une exécution en série. L'optimiseur de requête génère toujours un plan d'exécution en série pour une requête qui fait partie d'un curseur dynamique.
Remplacer les degrés de parallélisme
Le degré maximal de parallélisme définit le nombre de processeurs à utiliser lors l’exécution des plans parallèles. Vous pouvez définir cette configuration à différents niveaux :
Au niveau serveur, en utilisant l’option de configuration du serveur degré maximal de parallélisme (
MAXDOP).S'applique à : SQL Server
SQL Server 2019 (15.x) a introduit des recommandations automatiques pour configurer l’option de configuration du serveur
MAXDOPlors du processus d’installation. L’interface utilisateur du programme d’installation vous permet d’accepter les paramètres recommandés ou d’entrer vos propres valeurs. Pour plus d’informations, consultez la page Configuration du moteur de base de données - MaxDOP.Au niveau de la charge de travail, en utilisant l’option
MAX_DOPde configuration du groupe de charge de travail Resource Governor.S'applique à : SQL Server
Au niveau de la base de données, en utilisant la
MAXDOPconfiguration délimitée à la base de données.S’applique à : SQL Server, Azure SQL Database et Azure SQL Managed Instance
Au niveau de la requête ou de l’instruction d’index, en utilisant
MAXDOPouMAXDOPl’option d’index. Par exemple, vous pouvez utiliser l’optionMAXDOPpour contrôler, en augmentant ou en diminuant, le nombre de processeurs dédiés à une opération d’indexation en ligne. De cette façon, vous pouvez équilibrer les ressources utilisées par une opération d’indexation avec celles des utilisateurs simultanés.S’applique à : SQL Server, Azure SQL Database et Azure SQL Managed Instance
Définir l’option max degree of parallelism sur 0 (par défaut) permet au Moteur de base de données d’utiliser tous les processeurs disponibles jusqu’à un maximum de 64 processeurs dans une exécution parallèle du plan. Bien que le Moteur de base de données fixe une cible d’exécution de 64 processeurs logiques lorsque l’option MAXDOP est définie à 0, vous pouvez définir manuellement une valeur différente si nécessaire. Définir MAXDOP sur 0 pour les requêtes et les index permet au Moteur de base de données d’utiliser tous les processeurs disponibles jusqu’à un maximum de 64 processeurs pour les requêtes ou index donnés dans une exécution parallèle de plans.
MAXDOP n’est pas une valeur imposée pour toutes les requêtes parallèles, mais plutôt une cible provisoire pour toutes les requêtes éligibles au parallélisme. Cela signifie que si pas assez de threads de travail sont disponibles à l’exécution, une requête peut s’exécuter avec un degré de parallélisme inférieur à celui de l’option MAXDOP de configuration serveur.
Conseil
Pour plus d’informations, consultez les recommandations MAXDOP pour les directives de configuration de MAXDOP MAXDOP au niveau du serveur, de la base de données, de la requête ou de l’indicateur.
Exemple de requête en parallèle
La requête suivante compte le nombre de commandes passées dans un trimestre spécifique, à partir du 1er avril 2024, et dans lesquelles au moins une ligne de la commande a été reçue par le client après la date convenue. Cette requête affiche le nombre de ce type de commandes groupées par priorité de commande et triées en ordre de priorité croissant.
Cet exemple utilise des noms de tables et de colonnes théoriques.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Supposons que les index suivants soient définis dans les tables lineitem et orders :
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Voici un plan d'exécution en parallèle possible, généré pour la requête illustrée précédemment :
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
L’illustration suivante montre un plan de requête exécuté avec un degré de parallélisme égal à 4 et impliquant une jonction à deux tables.
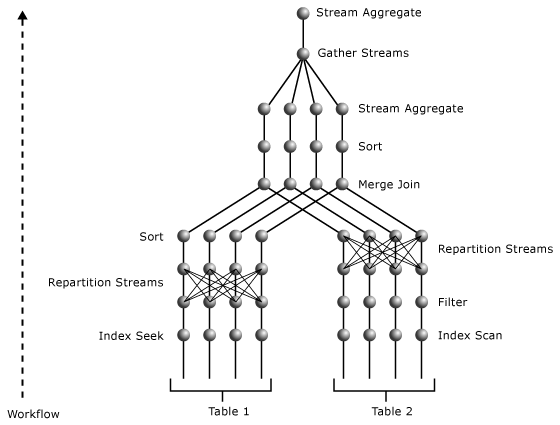
Le plan en parallèle comprend trois opérateurs de parallélisme. L’opérateur Index Seek de l’index o_datkey_ptr et l’opérateur Index Scan de l’index l_order_dates_idx sont exécutés en parallèle, Ce processus produit plusieurs flux exclusifs, qui peuvent être déterminés à partir des opérateurs de parallélisme les plus proches au-dessus de l’Index Scan, et des opérateurs Index Seek, respectivement. Les deux opérateurs repartissent le type d’échange. Ils réorganisent les données entre les flux et produisent le même nombre de flux sur leur sortie qu’ils en ont sur leur entrée. Ce nombre de flux est égal au degré de parallélisme.
L’opérateur de parallélisme au-dessus de l’opérateur l_order_dates_idx Index Scan repartitionne ses flux d’entrée en utilisant la valeur de L_ORDERKEY comme clé. De cette façon, toutes les valeurs identiques de L_ORDERKEY se retrouvent dans un même flux de sortie. Au même moment, les flux de sortie gèrent l’ordre de la colonne L_ORDERKEY afin qu’elle réponde aux conditions d’entrée de l’opérateur Merge Join.
L’opérateur de parallélisme au-dessus de l’opérateur Recherche d’Index repartitionne ses flux d’entrée en utilisant la valeur de O_ORDERKEY. Comme son entrée n’est pas triée sur les valeurs de la colonne O_ORDERKEY et que cette colonne est la colonne de jointure dans l’opérateur Merge Join, l’opérateur Tri entre les opérateurs de parallélisme et Merge Join s’assure que l’entrée est triée pour l’opérateur Merge Join sur les colonnes de jointure. L’opérateur Sort, tout comme l’opérateur Merge Join, est exécuté en parallèle.
Le premier opérateur de parallélisme rassemble les résultats de plusieurs flux en un seul flux. Les agrégations partielles effectuées par l’opérateur Stream Aggregate situé sous l’opérateur de parallélisme sont ensuite accumulées dans une seule valeur SUM pour chaque valeur différente de O_ORDERPRIORITY dans l’opérateur Stream Aggregate qui se trouve au-dessus de l’opérateur de parallélisme. Parce que ce plan comporte deux segments d’échange, avec un degré de parallélisme égal à 4, il utilise huit threads de travail.
Pour plus d’informations sur les opérateurs utilisés dans cet exemple, voir la Logical and physical showplan operator reference.
Opérations d'indexation parallèles
Les plans de requête pour les opérations d’index qui créent ou reconstruisent un index, ou qui suppriment un index en cluster, peuvent supporter des opérations parallèles multithread sur des ordinateurs disposant de plusieurs processeurs.
Remarque
Les opérations d’index parallèles ne sont disponibles qu’en édition Enterprise.
Moteur de base de données utilise les mêmes algorithmes pour déterminer le degré de parallélisme (le nombre total de threads de travail séparés à exécuter) pour les opérations d’index, comme pour d’autres requêtes. L’option de configuration degré maximal de parallélisme du serveur fixe le degré maximal de parallélisme pour une opération d’index. Vous pouvez outrepasser la valeur max degree of parallelism des opérations d’index individuelles en définissant l’option d’index MAXDOP dans les instructions CREATE INDEX, ALTER INDEX, DROP INDEX et ALTER TABLE.
Lorsque le Moteur de base de données SQL Server construit un plan d’exécution d’index, le nombre d’opérations parallèles est fixé à la valeur la plus basse parmi ces valeurs :
- Le nombre de processeurs, ou CPU, dans l’ordinateur.
- Le numéro spécifié dans l’option
max degree of parallelismde configuration du serveur. - Le nombre de CPU qui ne dépassent pas déjà un seuil de travail effectué pour les threads worker SQL Server.
Par exemple, sur un ordinateur disposant de huit processeurs, mais où max degree of parallelism est défini à 6, l’opération d’indexation n’utilise pas plus de six threads de travail parallèles. Si cinq des processeurs de l’ordinateur dépassent le seuil d'activité de SQL Server lors de l'établissement d’un plan d’exécution d’index, ce plan spécifie uniquement trois threads de travailleurs parallèles.
Les principales phases d’une opération d’indice parallèle incluent :
- Un thread de travail de coordination analyse rapidement et de façon aléatoire la table pour évaluer la distribution des clés d’index. Le thread de travail de coordination établit les frontières de clés qui créent un nombre de plages de clés égal au degré des opérations parallèles, où chaque plage de clés est estimée couvrir un nombre similaire de lignes. Par exemple, s’il y a quatre millions de lignes dans le tableau et que le degré de parallélisme est 4, le thread de travail coordinateur détermine les valeurs clés qui délimitent quatre ensembles de lignes comportant 1 million de lignes dans chaque ensemble. Si le thread de travail coordinateur ne peut pas établir suffisamment de plages de clés pour utiliser tous les CPU, il réduit en conséquence le degré de parallélisme.
- Le thread de travail de coordination répartit un nombre de threads de travail égal au degré d’opérations parallèles, et attend que ces threads de travail terminent leur travail. Chaque thread de travail analyse la table de base en utilisant un filtre qui extrait uniquement les lignes avec des valeurs de clé situées dans la plage affectée au thread de travail. Chaque thread de travail construit une structure d’index pour les lignes contenues dans sa plage de clés. Dans le cas d’un index partitionné, chaque thread de travail génère un nombre spécifié de partitions. Les partitions ne sont pas partagées entre les threads de travail.
- Une fois que tous les threads de travail parallèles sont terminés, le thread de travail coordinateur relie les sous-unités d’index en un seul index. Cette phase s'applique uniquement aux opérations d'index hors ligne.
Les instructions SQL individuelles CREATE TABLE ou ALTER TABLE peuvent avoir plusieurs contraintes nécessitant la création d’un index. Ces opérations de création d'index multiples sont exécutées en série, bien que chaque opération de création d'index individuelle puisse être une opération parallèle sur un ordinateur doté de plusieurs UC.
Architecture des requêtes distribuées
Le Moteur de base de données prend en charge deux méthodes pour référencer des sources de données OLE DB hétérogènes dans les instructions T-SQL :
Noms de serveurs liés
Utilisez les procédures stockées système
sp_addlinkedserveretsp_addlinkedsrvloginpour attribuer un nom de serveur à une source de données OLE DB. Vous pouvez référencer des objets dans ces serveurs liés dans des instructions T-SQL avec des noms en quatre parties. Par exemple, si le nom d’un serveur liéDeptSQLSrvrest défini par rapport à une autre instance de SQL Server, l’instruction suivante fait référence à une table de ce serveur :SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Vous pouvez également spécifier le nom du serveur lié dans une
OPENQUERYinstruction pour ouvrir un ensemble de lignes depuis la source de données OLE DB. Vous pouvez alors référencer cet ensemble de lignes comme une table dans les instructions T-SQL.Noms de connecteurs appropriés
Pour des références peu fréquentes à une source de données, spécifiez les fonctions
OPENROWSETouOPENDATASOURCEavec les informations nécessaires pour se connecter au serveur lié. Vous pouvez alors référencer le jeu de lignes de la même manière que vous référencez une table dans les instructions T-SQL :SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
Le Moteur de base de données utilise OLE DB pour communiquer entre le moteur relationnel et le moteur de stockage. Le moteur relationnel décompose chaque instruction T-SQL en une série d’opérations sur des jeux de lignes OLE DB que le moteur de stockage ouvre à partir des tables de base. Ce processus signifie que le moteur relationnel peut également ouvrir des jeux de lignes OLE DB de base sur n’importe quelle source de données OLE DB.
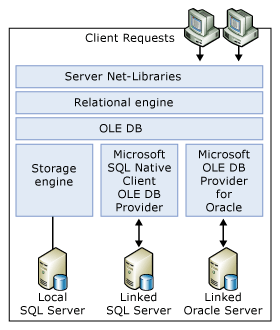
Le moteur relationnel utilise l'API OLE DB pour ouvrir les ensembles de lignes sur les serveurs liés, pour extraire les lignes et pour gérer les transactions.
Pour chaque source de données OLE DB à laquelle vous accédez en tant que serveur lié, le serveur exécutant SQL Server doit avoir un fournisseur OLE DB. L’ensemble des opérations T-SQL que vous pouvez utiliser sur une source de données OLE DB spécifique dépend des capacités du fournisseur OLE DB.
Pour chaque instance de SQL Server, les membres du rôle serveur fixe sysadmin peuvent activer ou désactiver l’utilisation de noms de connecteurs ad hoc pour un fournisseur OLE DB en utilisant la propriété SQL Server DisallowAdhocAccess. Lorsque vous activez l’accès ad hoc, tout utilisateur connecté à cette instance peut exécuter des instructions T-SQL contenant des noms de connecteurs ad hoc, faisant référence à n’importe quelle source de données sur le réseau accessible par le fournisseur OLE DB. Pour contrôler l’accès aux sources de données, les membres du rôle de serveur fixe sysadmin peuvent désactiver l’accès ad hoc pour ce fournisseur OLE DB, limitant ainsi les utilisateurs uniquement aux sources de données référencées par des noms de serveurs liés définis par les administrateurs. Par défaut, ce type d’accès ad hoc est activé pour le fournisseur OLE DB pour SQL Server, mais désactivé pour tous les autres fournisseurs OLE DB.
Les requêtes distribuées peuvent permettre aux utilisateurs d’accéder à une autre source de données (par exemple, des fichiers, des sources de données non relationnelles comme Active Directory, etc.) en utilisant le contexte de sécurité du compte Windows sous lequel le service SQL Server s’exécute. SQL Server emprunte correctement l’identité du nom de connexion pour les noms de connexion Windows. Cependant, cette usurpation n'est pas possible pour les identifiants de connexion SQL Server. Cette limitation peut potentiellement permettre à un utilisateur de requête distribuée d'accéder à une autre source de données pour laquelle il n'a pas d'autorisations, mais le compte sous lequel le service SQL Server s'exécute dispose, lui, des autorisations. Utilisez sp_addlinkedsrvlogin pour définir les connexions spécifiques autorisées à accéder au serveur lié correspondant. Ce contrôle n’est pas disponible pour les noms ad hoc, il faut donc être prudent lorsque vous activez un fournisseur OLE DB pour un accès ad hoc.
Lorsque c’est possible, le Moteur de base de données délègue des opérations relationnelles telles que les jointures, filtres, projections, tris et opérations de regroupement à la source de données OLE DB. Le Moteur de base de données n’est pas configuré par défaut pour analyser la table de base dans SQL Server et effectuer lui-même les opérations relationnelles. Le Moteur de base de données interroge le fournisseur OLE DB pour déterminer le niveau de grammaire SQL qu’il supporte et, sur la base de ces informations, envoie autant d’opérations relationnelles que possible au fournisseur.
Le Moteur de base de données spécifie un mécanisme permettant à un fournisseur OLE DB de renvoyer des statistiques indiquant comment les valeurs clés sont distribuées au sein de la source de données OLE DB. Ce mécanisme permet au Moteur de base de données Query Optimizer de mieux analyser la répartition des données dans la source de données selon les exigences de chaque instruction T-SQL, augmentant ainsi la capacité du Query Optimizer à générer des plans d’exécution optimaux.
Traitement des requêtes sur des tables et index partitionnés
Le Moteur de base de données prend en charge le traitement des requêtes adapté aux partitions pour les tables et index partitionnés. Cette section décrit comment le processeur de requête gère les objets partitionnés, comment interpréter les plans d’exécution impliquant le partitionnement, et les meilleures pratiques pour améliorer les performances des requêtes sur les objets partitionnés.
Remarque
Les tables et index partitionnés sont pris en charge dans l’édition standard de SQL Server, à partir de SQL Server 2016 (13.x) avec Service Pack 1.
Nouvelle opération de recherche sensible aux partitions
Dans le Moteur de base de données, le processeur de requête voit en interne une table partitionnée comme un index multicolonne avec PartitionID pour colonne principale.
PartitionID est une colonne calculée cachée utilisée en interne pour représenter l’ ID de la partition contenant une ligne spécifique. Par exemple, supposons que la table T, définie comme T(a, b, c), soit partitionnée sur une colonne a, et ait un index regroupé sur une colonne b. Cette table partitionnée est traitée comme une table non partitionnée avec le schéma T(PartitionID, a, b, c) et un index regroupé sur la clé composite (PartitionID, b). Cette représentation permet à l’Optimiseur de requêtes d’effectuer des opérations de recherche basées sur PartitionID sur toute table ou tout index partitionné.
L'élimination de partition est maintenant réalisée dans cette opération de recherche.
De plus, l’Optimiseur de requêtes est étendu de sorte qu’une opération de recherche ou de balayage avec une condition puisse être effectuée sur PartitionID (comme colonne de tête logique) et éventuellement d’autres colonnes clés d’index. Le processeur de requête effectue alors une recherche de second niveau, avec une condition différente, sur une ou plusieurs colonnes supplémentaires, pour chaque valeur distincte qui répond à la qualification de l’opération de recherche de premier niveau. Cette opération, appelée partition skip scan, permet à l’optimiseur de requêtes d’effectuer une opération de recherche ou de balayage basée sur une condition pour déterminer les partitions auxquelles accéder, et une opération de recherche d’index de second niveau au sein de cet opérateur pour retourner des lignes de ces partitions qui remplissent une condition différente. Examinez, par exemple, la requête suivante.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Pour cet exemple, supposons que la table T, définie comme T(a, b, c), soit partitionnée sur la colonne a, et ait un index regroupé sur la colonne b. La fonction de partition suivante définit les frontières de partition pour la table T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Pour résoudre la requête, le processeur de requêtes effectue une opération de recherche de premier niveau pour rechercher chaque partition contenant des lignes répondant à la condition T.a < 10. Cette opération identifie les partitions auxquelles il faut accéder. Dans chaque partition identifiée, le processeur de requête effectue alors une recherche de second niveau dans l’index regroupé sur la colonne b pour trouver les lignes qui remplissent la condition T.b = 2 et T.a < 10.
L’illustration suivante est une représentation logique de l’opération de partition skip scan. Elle montre la table T avec des données dans les colonnes a et b. Les partitions sont numérotées de 1 à 4 et les limites de partition sont indiquées par des lignes verticales en pointillé. Une opération de recherche de premier niveau sur les partitions (non illustrée dans l’illustration) détermine que les partitions 1, 2 et 3 remplissent la condition de recherche implicite par le partitionnement défini pour la table et le prédicat sur la colonne a (T.a < 10). Le chemin parcouru par la recherche de second niveau est illustré par la ligne courbe. Essentiellement, l’opération cherche dans chacune de ces partitions des lignes qui remplissent la condition b = 2. Le coût total de l’opération est le même que celui de trois recherches d’indices distinctes.
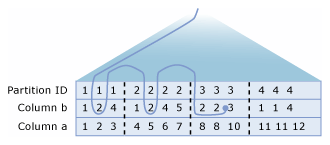
Affichage d'informations de partitionnement dans les plans d'exécution de requêtes
Examinez les plans d’exécution des requêtes sur des tables et index partitionnés en utilisant les instructions T-SQL SET SHOWPLAN_XMLSET ou SET STATISTICS XML, ou en utilisant le plan d’exécution graphique dans SSMS. Par exemple, vous pouvez afficher le plan d’exécution à l’instant de la compilation en sélectionnant Afficher le plan d’exécution estimé dans la barre d’outils Éditeur de requête et le plan d’exécution à l’exécution en sélectionnant Inclure le plan d’exécution réel.
En utilisant ces outils, vous pouvez trouver les informations suivantes :
- Les opérations telles que les scans, recherches, insertions, mises à jour, fusions et suppressions qui accèdent à des tables ou index partitionnés.
- les partitions auxquelles accède la requête Par exemple, les plans d’exécution au moment de l’exécution incluent le nombre total de partitions consultées et les plages de partitions contiguës consultées.
- Lorsqu’une opération de partition skip scan est utilisée dans une opération de recherche ou de balayage pour récupérer des données d’une ou plusieurs partitions.
Améliorations apportées aux informations de partition
Le Moteur de base de données fournit des informations de partitionnement améliorées pour les plans d’exécution à la fois en temps de compilation et en temps d’exécution. Les plans d'exécution fournissent désormais les informations suivantes :
- Un attribut optionnel
Partitionedindiquant qu’un opérateur, tel qu’une recherche, un scan, une insertion, une mise à jour, une fusion ou une suppression, est effectué sur une table partitionnée. - Un nouvel élément
SeekPredicateNewavec un sous-élémentSeekKeysqui inclutPartitionIDcomme la colonne clé d’index principale et des conditions de filtrage qui spécifient les recherches de plage surPartitionID. La présence de deuxSeekKeyssous-éléments indique un saut de partition surPartitionID. - Des informations de résumé qui indiquent le nombre total de partitions ayant fait l'objet d'un accès. Ces informations sont uniquement disponibles dans les plans au moment de l'exécution.
Pour démontrer comment cette information est affichée dans la sortie graphique du plan d'exécution et dans celle du Showplan XML, prenez en compte la requête suivante sur la table partitionnée fact_sales. Cette requête met à jour les données dans deux partitions.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
L’illustration suivante montre les propriétés de l’opérateur Clustered Index Seek dans le plan d’exécution du runtime pour cette requête. Pour voir la définition de la fact_sales table et la définition de la partition, voir Exemple.
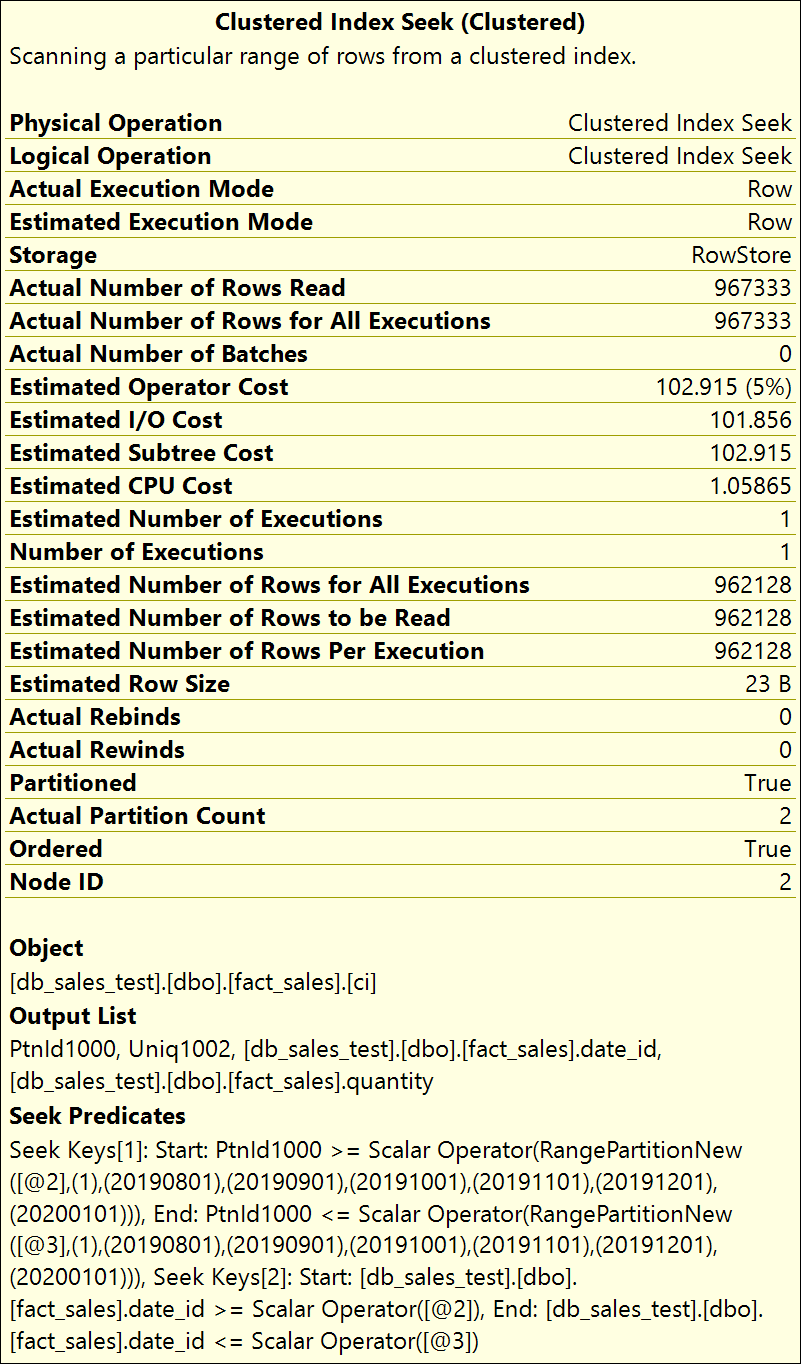
Attribut partitionné
Quand un opérateur comme Index Seek est exécuté sur une table ou un index partitionné, l’attribut Partitioned apparaît dans le plan au moment de la compilation et au moment de l’exécution, et a pour valeur True (1). L’attribut ne s’affiche pas lorsqu’il est réglé à False (0).
L’attribut Partitioned peut apparaître dans les opérateurs physiques et logiques suivants :
- Balayage de table
- Analyse d’index
- Recherche d’index
- Insérer
- Mise à jour
- Supprimer
- Fusionner (Merge)
Comme montré dans l’illustration précédente, cet attribut apparaît dans les propriétés de l’opérateur dans lequel il est défini. Dans la sortie XML Showplan, cet attribut apparaît comme Partitioned="1" dans le nœud RelOp de l’opérateur dans lequel il est défini.
Nouveau prédicat de recherche
Dans la sortie XML Showplan, l’élément SeekPredicateNew apparaît dans l’opérateur dans lequel il est défini. Il peut contenir jusqu’à deux occurrences du sous-élément SeekKeys. Le premier élément SeekKeys spécifie l’opération de recherche de premier niveau au niveau de l’ID de partition de l’index logique. C’est-à-dire que cette opération de recherche détermine les partitions auxquelles il faut accéder pour satisfaire aux conditions de la requête. Le deuxième SeekKeys point spécifie la recherche de second niveau qui se produit dans chaque partition identifiée dans la recherche de premier niveau.
Résumé des informations sur les partitions
Dans les plans au moment de l'exécution, les informations de résumé sur les partitions fournissent le nombre des partitions ayant fait l'objet d'un accès et l'identité des partitions ayant réellement fait l'objet d'un accès. Vous pouvez utiliser ces informations pour vérifier que la requête accède aux bonnes partitions et que toutes les autres partitions sont ignorées.
Les informations suivantes sont fournies : Actual Partition Countet Partitions Accessed.
Actual Partition Count est le nombre total de partitions auxquelles la requête a accédé.
Partitions Accessed, dans XML Showplan output, est l’information de résumé de partition qui apparaît dans le nouvel RuntimePartitionSummary élément du RelOp nœud de l’opérateur dans lequel elle est définie. L’exemple suivant affiche le contenu de l’élément RuntimePartitionSummary , indiquant que deux partitions au total font l’objet d’un accès (partitions 2 et 3).
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Afficher les informations de partition en utilisant d’autres méthodes de showplan
Les méthodes de plan d’exécution de requêtes SHOWPLAN_ALL, SHOWPLAN_TEXTet STATISTICS PROFILE ne signalent pas les informations sur les partitions décrites dans cet article, avec toutefois l’exception suivante. Dans le cadre du prédicat SEEK , les partitions devant faire l’objet d’un accès sont identifiées par un prédicat de plage sur la colonne calculée qui représente l’ID de partition. L’exemple suivant affiche le prédicat SEEK pour un opérateur Clustered Index Seek . Les partitions 2 et 3 font l'objet d'un accès et l'opérateur de recherche filtre les lignes qui répondent à la condition date_id BETWEEN 20190802 AND 20190902.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Interpréter les plans d'exécution pour les amas partitionnés
Un segment de mémoire partitionné est traité comme un index logique sur l’ID de partition. Dans un plan d’exécution, l’élimination de partitions sur un tas partitionné est représentée par un opérateur Table Scan avec un prédicat SEEK sur l’identifiant de partition. L’exemple suivant montre les informations fournies du Showplan :
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Interprétation des plans d’exécution pour les jointures en colocation
La colocation de jointure peut se produire lorsque deux tables sont partitionnées à l'aide de la même fonction de partitionnement ou d'une fonction de partitionnement équivalente et que les colonnes de partitionnement des deux côtés de la jointure sont spécifiées dans la condition de jointure de la requête. L'optimiseur de requête peut générer un plan où les partitions de chaque table avec des ID de partition identiques sont jointes séparément. Les jointures en colocation peuvent être plus rapides que les autres jointures car elles peuvent nécessiter moins de mémoire et occasionner un temps de traitement inférieur. L’optimiseur de requête choisit un plan en colocation ou non en fonction des estimations de coût.
Dans un plan en colocation, la jointure Nested Loops lit une ou plusieurs partitions de table ou d’index jointes en interne. Les nombres dans les opérateurs Constant Scan représentent les numéros de partition.
Lorsque des plans parallèles pour des jointures en colocation sont générés pour des tables ou des index partitionnés, un opérateur Parallelism apparaît entre les opérateurs de jointure Constant Scan et Nested Loops . Dans ce cas, chacun des threads de travail du côté extérieur de la jointure lit et opère sur une partition distincte.
L'illustration suivante montre un plan de requête parallèle pour une jointure en colocation.
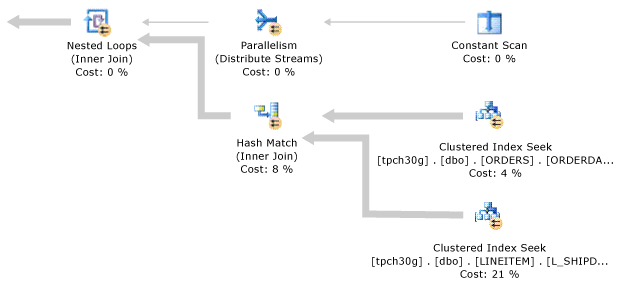
Stratégie d'exécution de requête parallèle pour les objets partitionnés
Le processeur de requêtes utilise une stratégie d'exécution parallèle pour les requêtes qui sélectionnent parmi des objets partitionnés. Dans le cadre de la stratégie d’exécution, le processeur de requêtes détermine les partitions de table requises pour la requête et la proportion de threads de travail à allouer à chaque partition. Dans la plupart des cas, le processeur de requêtes alloue un nombre de threads de travail égal ou presque égal à chaque partition, puis il exécute la requête en parallèle sur les partitions. Les paragraphes suivants expliquent l’allocation des threads de travail de manière détaillée.
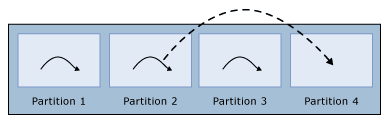
Si le nombre de threads de travail est inférieur au nombre de partitions, le processeur de requêtes affecte chaque thread de travail à une partition différente, laissant initialement une ou plusieurs partitions sans thread de travail affecté. Lorsqu’un thread worker termine son exécution sur une partition, le processeur de requête l’assigne à la partition suivante jusqu’à ce que chaque partition se voie attribuer un seul thread travailleur. Cette affectation est le seul cas où le processeur de requête réalloue des threads de travail vers d’autres partitions.
Montre le thread de travail réaffecté une fois terminé. Si le nombre de threads de travail est égal au nombre de partitions, le processeur de requêtes assigne un thread de travail à chaque partition. Quand un thread de travail se termine, il n’est pas réaffecté à une autre partition.
Si le nombre de threads de travail est supérieur au nombre de partitions, le processeur de requêtes alloue une quantité égale de threads de travail à chaque partition. Si le nombre de threads worker n’est pas un multiple exact du nombre de partitions, le processeur de requête alloue un thread worker supplémentaire à certaines partitions afin d’utiliser tous les threads worker disponibles. S’il n’y a qu’une seule partition, tous les threads de travail sont assignés à cette partition. Dans le diagramme suivant, il y a quatre partitions et 14 threads de travail. Chaque partition a trois threads de travail assignés, et deux partitions ont un thread de travail supplémentaire, pour un total de 14 assignations de threads de travail. Lorsqu'un worker thread se termine, il n'est pas attribué à nouveau à une autre partition.
Bien que les exemples précédents suggèrent une manière simple d’allouer les threads de travail, la stratégie réelle est plus complexe et prend en compte d’autres variables qui apparaissent lors de l’exécution de requêtes. Par exemple, si la table est partitionnée et possède un index regroupé sur une colonne A et qu’une requête possède le prédicat WHERE A IN (13, 17, 25), le processeur de requête alloue un ou plusieurs fils d’exécution à chacune de ces trois valeurs de recherche (A = 13, A = 17 et A = 25) au lieu de chaque partition de table. Il suffit d’exécuter la requête dans les partitions contenant ces valeurs, et si tous ces prédicats de recherche se trouvent dans la même partition de table, tous les threads de travail sont assignés à la même partition de table.
Pour prendre un autre exemple, supposons que la table ait quatre partitions sur colonne A avec des points frontières (10, 20, 30), un index sur une colonne B, et que la requête ait une clause WHERE B IN (50, 100, 150)de prédicat . Comme les partitions de table sont basées sur les valeurs de A, les valeurs de B peuvent apparaître dans n’importe quelle partition de table. Ainsi, le processeur de requête recherche chacune des trois valeurs de B (50, 100, 150) dans chacune des quatre partitions de table. Le processeur de requête attribue proportionnellement les threads de travail afin de pouvoir exécuter chacun de ces 12 scans de requête en parallèle.
Partitions de table basées sur colonne A |
Recherche la colonne B dans chaque partition de table |
|---|---|
Partition du tableau 1 : A < 10 |
B = 50, B = 100, B = 150 |
Partition du tableau 2 : A >= 10 AND A < 20 |
B = 50, B = 100, B = 150 |
Partition du tableau 3 : A >= 20 AND A < 30 |
B = 50, B = 100, B = 150 |
Partition du tableau 4 : A >= 30 |
B = 50, B = 100, B = 150 |
Bonnes pratiques
Pour améliorer la performance des requêtes qui accèdent à une grande quantité de données provenant de grandes tables et index partitionnés, suivez ces meilleures pratiques :
Agrégez par bandes chaque partition sur plusieurs disques. Cette approche est particulièrement pertinente lors de l’utilisation de disques durs mécaniques.
Dans la mesure du possible, utilisez un serveur avec suffisamment de mémoire principale pour prendre en charge les partitions faisant l'objet d'un accès fréquent ou toutes les partitions afin de réduire le coût des E/S.
Si les données que vous interrogez ne rentrent pas en mémoire, compressez les tables et les index pour réduire le coût d’E/S.
Utilisez un serveur avec des processeurs rapides et autant de noyaux de processeur que^possible selon vos moyens pour tirer parti des capacités de traitement de requête parallèle.
Assurez-vous que le serveur possède une bande passante de contrôleur d'E/S suffisante.
Créez un index cluster sur chaque grande table partitionnée pour tirer parti des optimisations d'analyse d'arbre B (B-tree).
Lorsque vous chargez en masse des données dans des tables partitionnées, suivez les recommandations de bonnes pratiques du livre blanc, Le Guide de Performance du Chargement des Données.
Exemple
L'exemple suivant crée une base de données de test contenant une table unique avec sept partitions. Pour visualiser les informations de partitionnement pour les plans à la compilation et à l’exécution, utilisez les outils décrits dans Afficher les informations de partitionnement dans les plans d’exécution des requêtes lors de l’exécution des requêtes dans cet exemple.
Remarque
Cet exemple insère plus d'un million de lignes dans la table. En fonction de votre matériel, l'exécution de cet exemple peut prendre plusieurs minutes. Avant d'exécuter cet exemple, vérifiez que l'espace disque dont vous disposez est supérieur à 1,5 Go.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Contenu connexe
- Guide de référence des opérateurs logiques et physiques du plan d’exécution de requêtes
- Aperçu des événements étendus
- Meilleures pratiques pour la supervision des charges de travail avec le Magasin des requêtes
- Estimation de la cardinalité (SQL Server)
- Traitement de requêtes intelligent dans les bases de données SQL
- Priorités des opérateurs (Transact-SQL)
- Vue d’ensemble du plan d’exécution
- Centre de performances pour le moteur de base de données SQL Server et Azure SQL Database