Résoudre les doublons et les valeurs nulles
Conseil / Astuce
Pour plus d’informations, consultez l’onglet Texte et images !
Les problèmes de qualité des données tels que les enregistrements en double et les valeurs Null peuvent compromettre vos processus d’analyse et d’aval. Si les doublons proviennent de charges de données simultanées ou de valeurs null apparaissent en raison de données sources incomplètes, la résolution de ces problèmes est une responsabilité essentielle pour les ingénieurs de données travaillant dans Azure Databricks.
Dans cette unité, vous allez apprendre à identifier et résoudre les valeurs dupliquées, manquantes et null à l’aide des approches SQL et PySpark.
Identifier les enregistrements en double
Avant de pouvoir supprimer des doublons, vous devez les trouver. Les doublons se produisent généralement lorsque le même enregistrement apparaît plusieurs fois dans une table, souvent en raison de problèmes d’intégration de données, d’ingestion répétée ou d’opérations d’écriture simultanées.
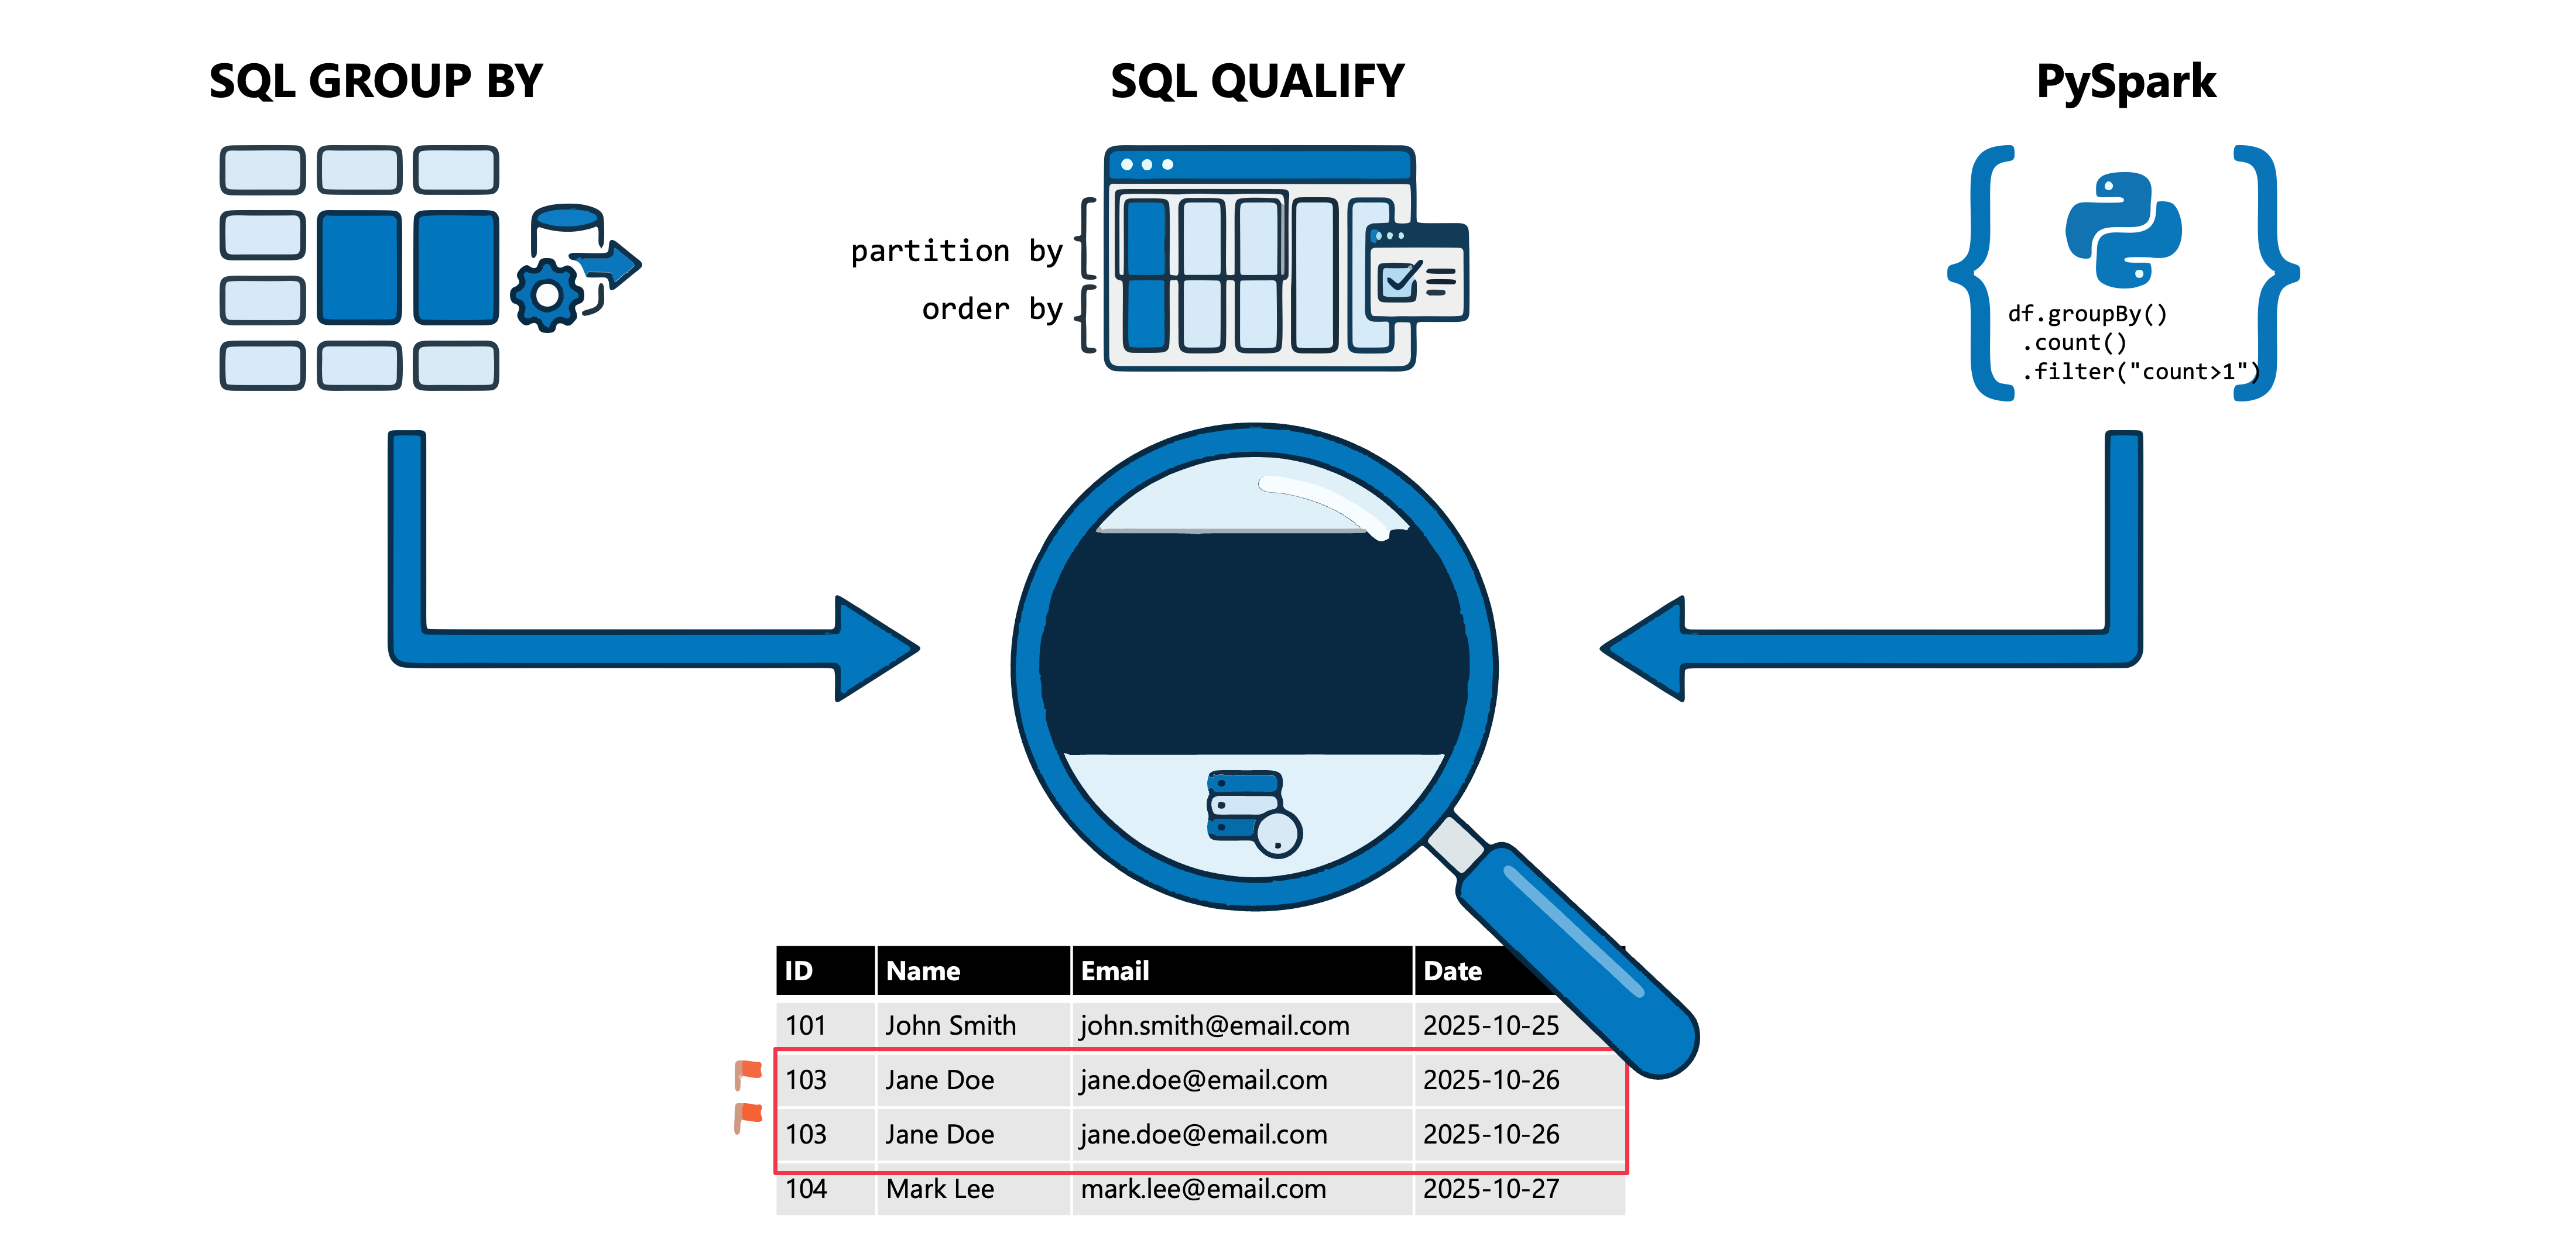
Utiliser GROUP BY et HAVING pour rechercher des doublons
La façon la plus simple d’identifier les doublons consiste à regrouper les enregistrements et à compter les occurrences. La HAVING clause filtre les résultats groupés pour afficher uniquement les valeurs qui apparaissent plusieurs fois.
SELECT
    customer_id,
    email,
    COUNT(*) AS occurrence_count
FROM sales.customers
GROUP BY customer_id, email
HAVING COUNT(*) > 1
ORDER BY occurrence_count DESC;
Cette requête retourne toutes les combinaisons de customer_id et email qui apparaissent plusieurs fois dans le tableau, ce qui vous aide à comprendre l’ampleur de la duplication.
Utiliser QUALIFIER avec les fonctions de fenêtre
La clause QUALIFY fournit une approche plus simple en filtrant directement les résultats des fonctions de fenêtre, sans nécessiter de sous-requêtes. Cette approche est particulièrement utile lorsque vous devez voir les lignes dupliquées réelles, pas seulement les nombres.
SELECT *
FROM sales.customers
QUALIFY COUNT(*) OVER (PARTITION BY customer_id, email) > 1;
Cette requête peut retourner des résultats tels que :
| customer_id | Messagerie électronique | nom | date_de_création | status |
|---|---|---|---|---|
| 1001 | jane@contoso.com | Jane Doe | 2024-01-15 | Active |
| 1001 | jane@contoso.com | Jane D. | 2024-03-20 | Active |
| 1002 | bob@fabrikam.com | Bob Smith | 2024-02-10 | En attente |
| 1002 | bob@fabrikam.com | Robert Smith | 11/02/2024 | Active |
Avec ce modèle, vous obtenez toutes les colonnes des lignes dupliquées, ce qui facilite l’examen de la source de duplication.
Rechercher des doublons à l’aide de PySpark
Dans PySpark, vous pouvez utiliser des fonctions de fenêtre combinées avec le filtrage pour identifier les enregistrements en double :
from pyspark.sql.functions import count
from pyspark.sql.window import Window

window_spec = Window.partitionBy("customer_id", "email")

duplicates_df = (
    df.withColumn("row_count", count("*").over(window_spec))
    .filter("row_count > 1")
    .drop("row_count")
)

display(duplicates_df)
Vous pouvez également utiliser la exceptAll() méthode pour comparer le DataFrame d’origine à une version dédupliquée :
df_duplicates = df.exceptAll(df.dropDuplicates(["customer_id", "email"]))
display(df_duplicates)
La exceptAll() méthode effectue une différence définie qui conserve les doublons. Elle retourne toutes les lignes du premier DataFrame qui ne se trouvent pas dans le second DataFrame, tout en conservant les doublons. Voici comment cela fonctionne :
-
df.dropDuplicates(["customer_id", "email"])crée un DataFrame avec une ligne par combinaison unique -
exceptAll()compare le DataFrame d’origine à cette version dédupliquée - Pour chaque combinaison unique, une occurrence est « mise en correspondance » et supprimée, en laissant uniquement les doublons supplémentaires
Par exemple, si le client 1001 apparaît trois fois dans le DataFrame d’origine et une fois dans la version dédupliquée, exceptAll() retourne deux lignes (occurrences supplémentaires).
Note
Contrairement à except(), qui supprime toutes les lignes correspondantes et retourne des résultats distincts, exceptAll() conserve la structure avec doublons. Si vous avez trois lignes identiques dans l’original et l’autre dans l’ensemble dédupliqué, exceptAll() retourne exactement deux lignes.
Supprimer les enregistrements dupliqués
Une fois que vous avez identifié des doublons, vous pouvez choisir une stratégie de résolution en fonction de vos besoins en données.
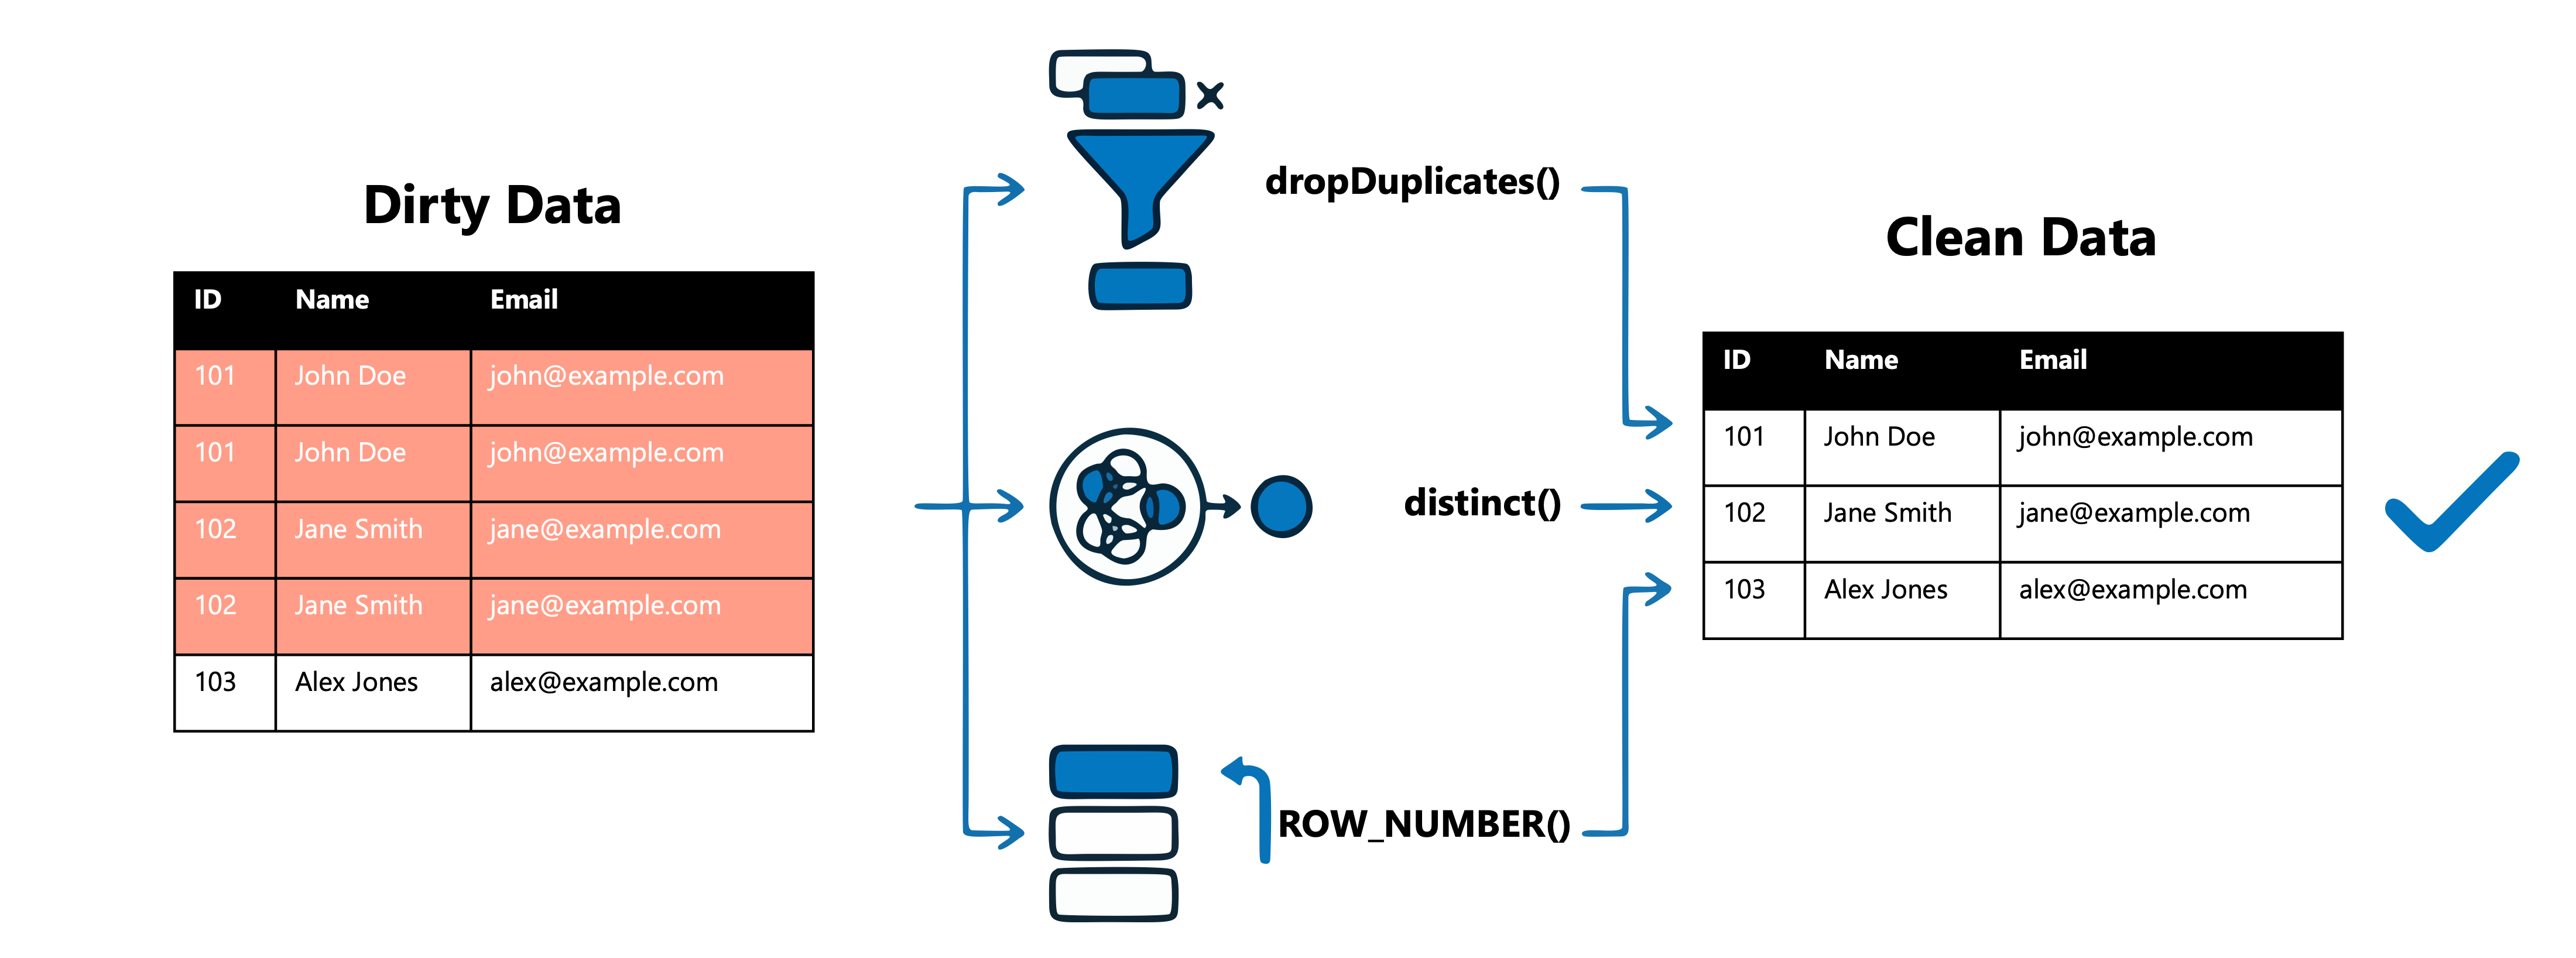
Supprimer des doublons dans PySpark
La dropDuplicates() méthode supprime les lignes dupliquées en fonction des colonnes spécifiées et conserve une ligne pour chaque combinaison. Lorsque les lignes diffèrent dans d’autres colonnes, il n’est pas garanti que la ligne conservée soit toujours la même :
df_clean = df.dropDuplicates(["customer_id", "email"])
Pour une déduplication de ligne complète sur toutes les colonnes, utilisez distinct():
df_unique = df.distinct()
Conserver des lignes spécifiques à l’aide de ROW_NUMBER
Lorsque vous avez besoin de contrôler le doublon à conserver, utilisez-le ROW_NUMBER()QUALIFY pour sélectionner des enregistrements en fonction de critères tels que la mise à jour la plus récente :
SELECT *
FROM sales.customers
QUALIFY ROW_NUMBER() OVER (
    PARTITION BY customer_id
    ORDER BY updated_at DESC
) = 1;
Cette requête partitionne les enregistrements par customer_id, les trie par updated_at dans l'ordre décroissant et conserve uniquement l'enregistrement le plus récemment mis à jour pour chaque client.
Gérer les valeurs Null et manquantes
Les valeurs Null représentent des données manquantes ou inconnues. Selon vos besoins d’analyse, vous devrez peut-être supprimer des lignes avec des valeurs Null, les remplacer par des valeurs par défaut ou utiliser l’imputation statistique.
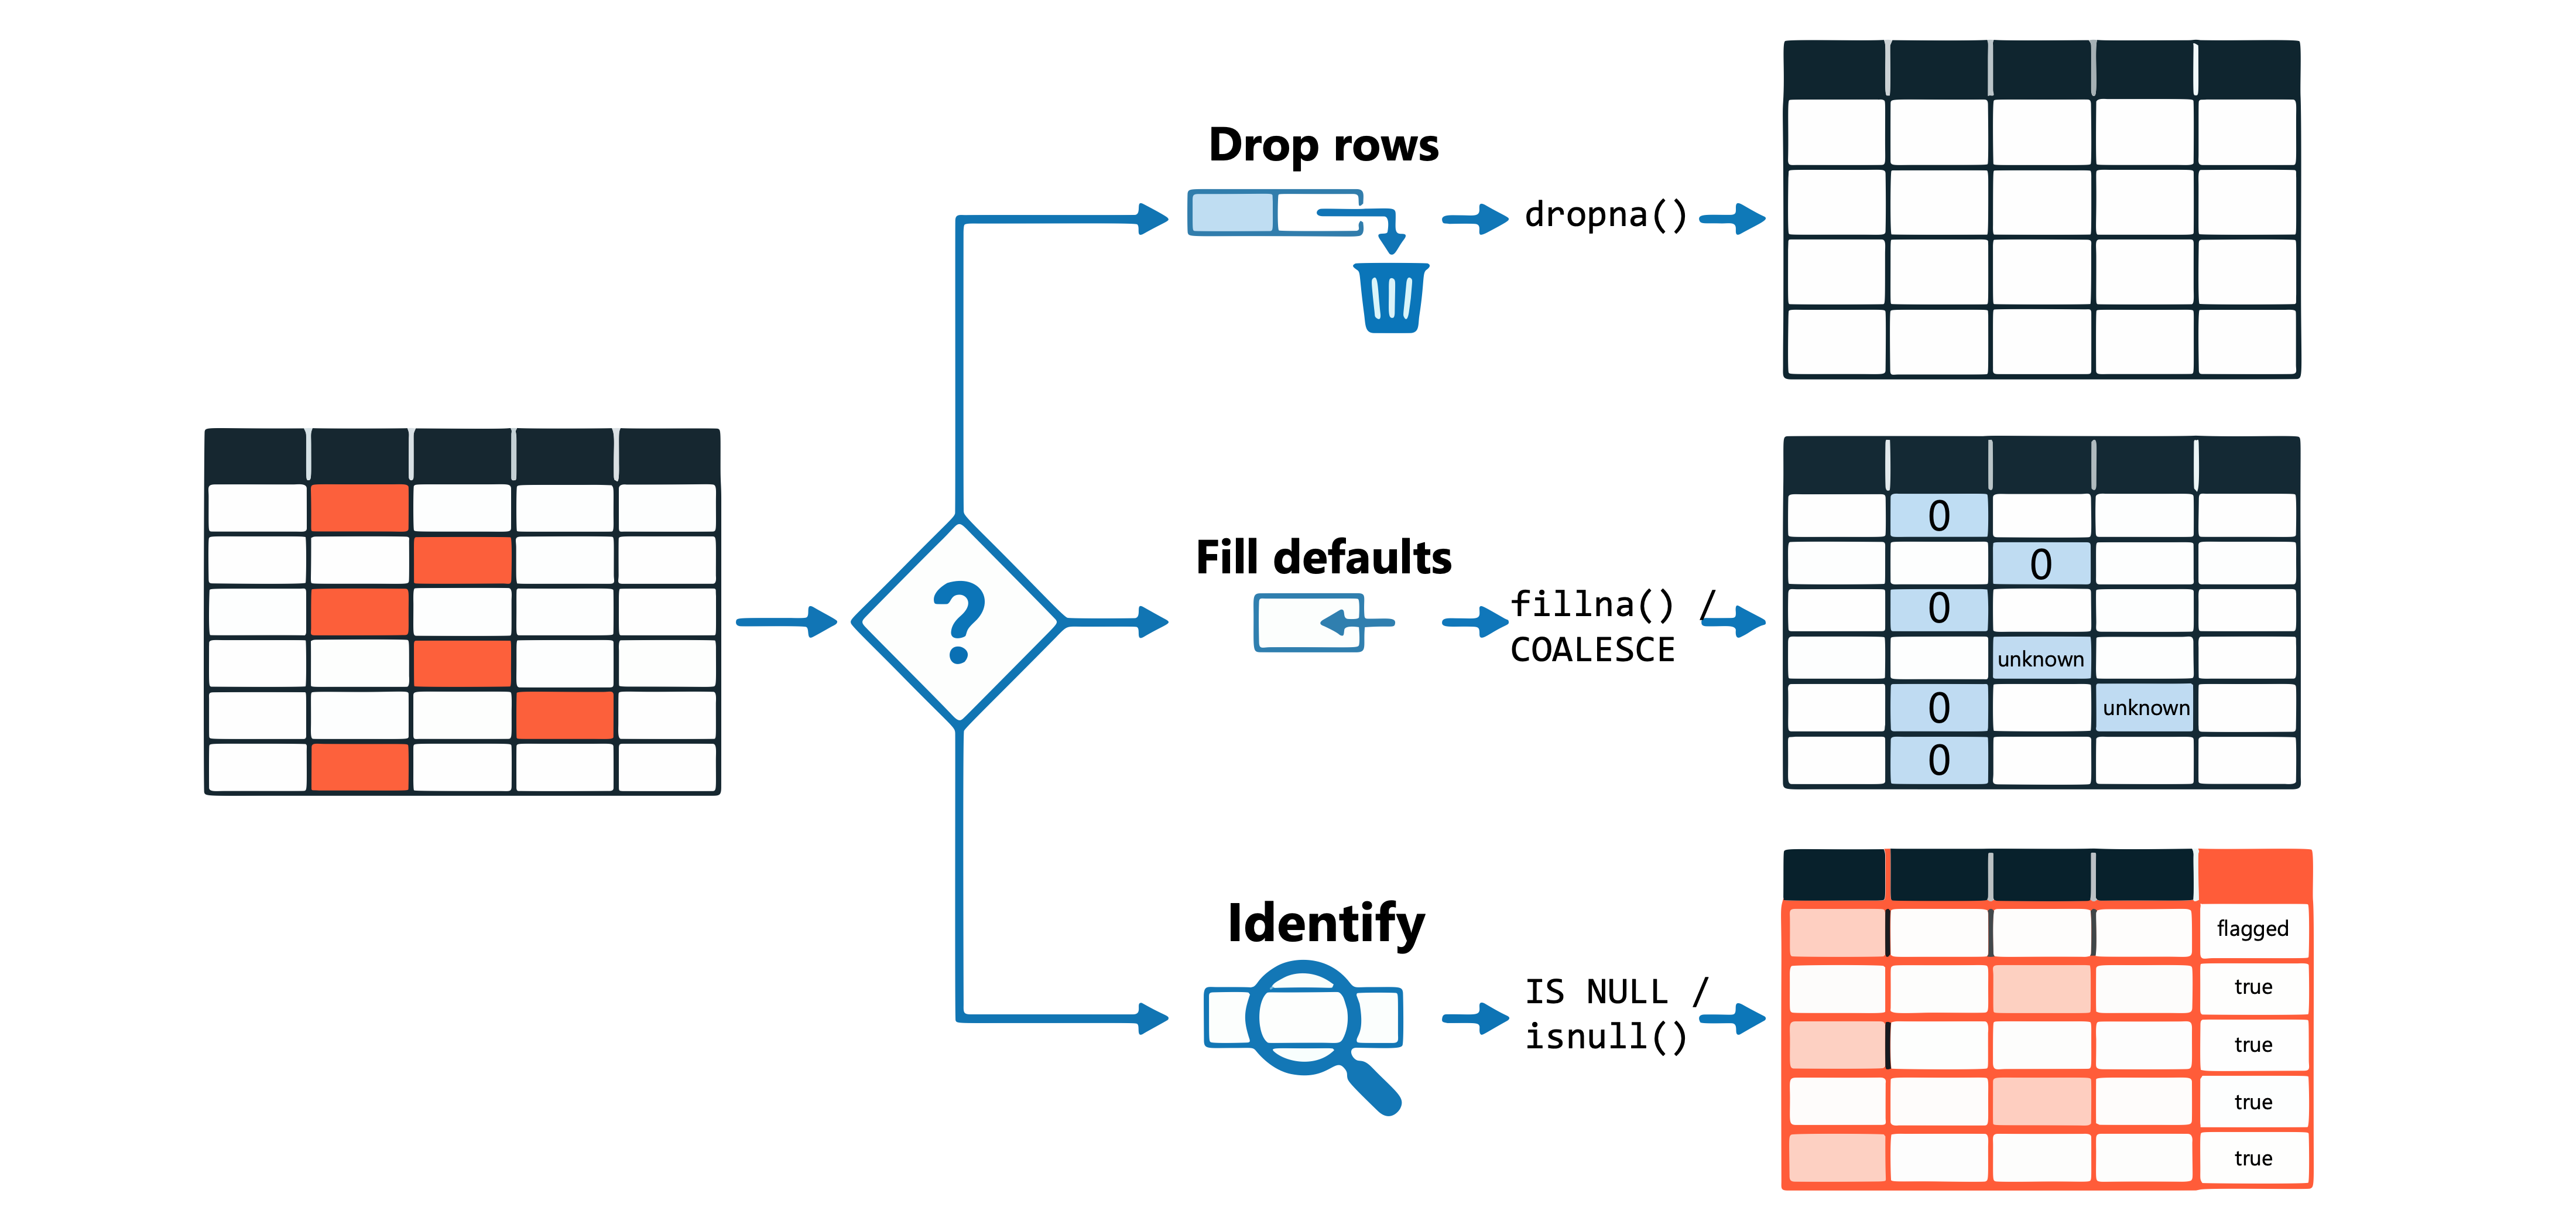
Identifier les valeurs Null
Utilisez la fonction isnull() ou l'opérateur IS NULL pour rechercher des enregistrements avec des valeurs manquantes.
SELECT *
FROM sales.transactions
WHERE amount IS NULL
   OR customer_id IS NULL;
Pour compter les valeurs nulles par colonne :
SELECT
    COUNT(*) AS total_rows,
    COUNT(*) - COUNT(amount) AS null_amount_count,
    COUNT(*) - COUNT(customer_id) AS null_customer_count
FROM sales.transactions;
Supprimer des lignes avec des valeurs Null
Dans PySpark, la dropna() méthode supprime les lignes contenant des valeurs Null :
# Drop rows where any column is null
df_clean = df.dropna()

# Drop rows where all columns are null
df_clean = df.dropna(how="all")

# Drop rows where specific columns are null
df_clean = df.dropna(subset=["customer_id", "amount"])
Le how paramètre contrôle le comportement : "any" supprime les lignes avec au moins une valeur Null (valeur par défaut), tandis que "all" les lignes sont supprimées uniquement lorsque toutes les colonnes spécifiées sont null.
Remplir des valeurs null avec des valeurs par défaut
La fillna() méthode remplace les valeurs null par les valeurs par défaut spécifiées :
# Fill null values with a single value (applies only to columns whose data type matches)
df_filled = df.fillna(0)

# Fill specific columns with different values
df_filled = df.fillna({
    "amount": 0,
    "status": "Unknown",
    "quantity": 1
})
Dans SQL, utilisez la COALESCE fonction pour fournir des valeurs par défaut :
SELECT
    customer_id,
    COALESCE(amount, 0) AS amount,
    COALESCE(status, 'Unknown') AS status
FROM sales.transactions;
Choisir la bonne stratégie
La stratégie de gestion null appropriée dépend de votre contexte de données :
| Scénario | Approche recommandée |
|---|---|
| Valeurs nulles dans les champs obligatoires tels que les identificateurs | Supprimer les lignes |
| Valeurs nulles dans les champs numériques pour l’agrégation | Remplir avec zéro ou moyenne |
| Nulls dans les champs catégoriels facultatifs | Remplir avec un espace réservé comme « Inconnu » |
| Valeurs Null qui faussent l’analyse | Supprimer ou remplir en fonction des connaissances de domaine |
Conseil / Astuce
Documentez vos décisions de gestion des valeurs nulles. Les analystes futurs doivent comprendre pourquoi certaines valeurs ont été remplacées ou supprimées pour interpréter correctement les résultats des requêtes.
Comprendre comment identifier et résoudre ces problèmes de qualité des données vous prépare à créer des pipelines de données plus fiables. Avec des données propres, vos transformations et analyses en aval produisent des résultats fiables.