Transformer des données avec des jointures et des opérateurs ensemblistes
Conseil / Astuce
Pour plus d’informations, consultez l’onglet Texte et images !
Les flux de travail d’ingénierie des données nécessitent souvent la combinaison d’informations provenant de plusieurs jeux de données. Les jointures combinent des tables horizontalement en faisant correspondre des lignes sur des colonnes associées, tandis que les opérateurs d'ensemble combinent les tables verticalement en ajoutant, en croisant ou en excluant des lignes. Comprendre quand utiliser chaque approche vous aide à créer des pipelines de transformation efficaces.
Dans cette unité, vous allez apprendre à joindre des tables en fonction des relations et à appliquer des opérateurs set pour combiner des jeux de données avec des schémas correspondants.
Combiner des tables avec des jointures
Les jointures fusionnent des lignes provenant de deux tables en fonction d'une colonne associée. Le type de jointure détermine les lignes qui apparaissent dans le résultat et la façon dont les lignes sans correspondance sont gérées.
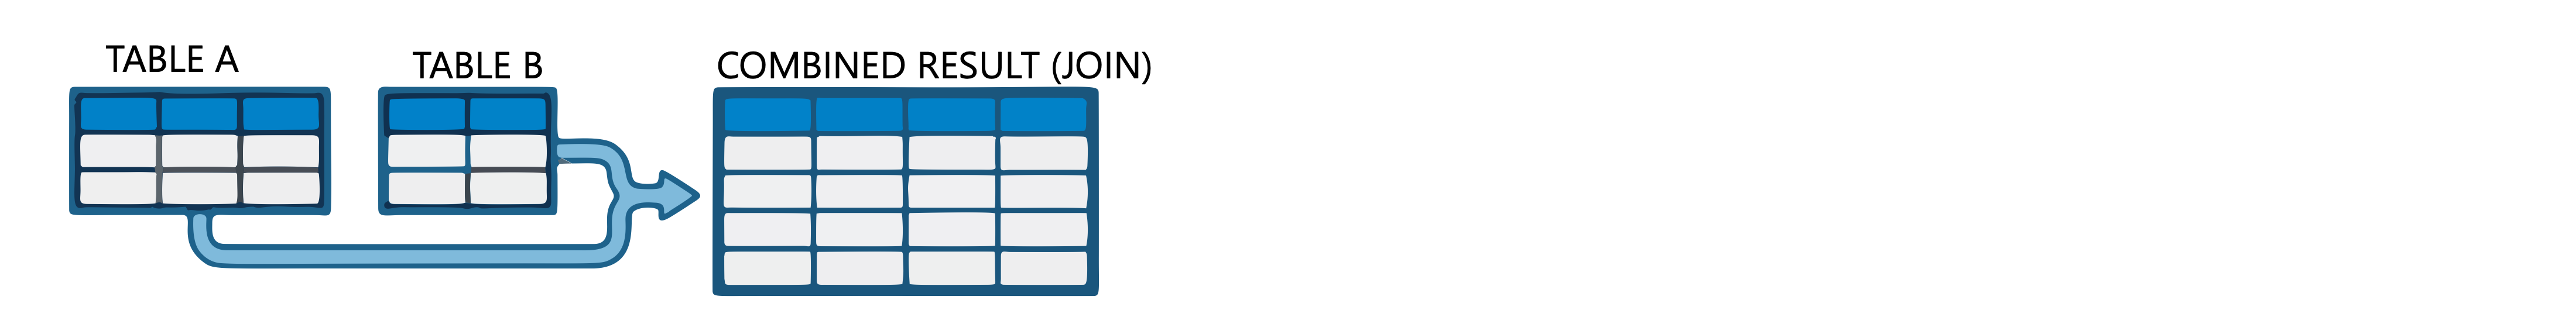
Comprendre les types de jointure
Chaque type de jointure sert un objectif spécifique dans la transformation des données :

| Type de jointure | Descriptif | Cas d’utilisation |
|---|---|---|
INNER |
Retourne uniquement les lignes correspondantes des deux tables | Lier des commandes avec des clients valides |
LEFT |
Retourne toutes les lignes de la table de gauche ; ajoute des valeurs NULL pour la table de droite lorsqu'il n'y a pas de correspondance. | Inclure tous les clients, même sans commandes |
RIGHT |
Retourne toutes les lignes de la table de droite ; ajoute des valeurs NULL pour la table de gauche lorsqu’aucune correspondance n’est trouvée. | Inclure tous les services, même sans employés |
FULL |
Retourne toutes les lignes des deux tables ; ajoute des valeurs NULL pour les non-correspondances | Combiner des jeux de données pour trouver des lacunes de l’un ou l’autre côté |
SEMI |
Retourne les lignes de table de gauche qui ont des correspondances dans la table de droite | Filtrer les clients qui ont passé des commandes |
ANTI |
Retourne les lignes de table de gauche qui n’ont aucune correspondance dans la table de droite | Rechercher les clients qui n’ont jamais passé de commandes |
CROSS |
Retourne le produit cartésien de toutes les lignes | Générer toutes les combinaisons possibles |
Joindre des tables avec SQL
La JOIN clause combine des tables en fonction d’une condition spécifiée avec ON ou USING. Les exemples suivants utilisent les tables employee et department :
CREATE TEMP VIEW employee(id, name, deptno) AS
    VALUES (105, 'Chloe', 5),
           (103, 'Paul',  3),
           (101, 'John',  1),
           (102, 'Lisa',  2),
           (104, 'Evan',  4),
           (106, 'Amy',   6);

CREATE TEMP VIEW department(deptno, deptname) AS
    VALUES (3, 'Engineering'),
           (2, 'Sales'),
           (1, 'Marketing');
Pour faire correspondre les employés à leurs services, utilisez une jointure interne :
-- Inner join: only employees with matching departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
INNER JOIN department d ON e.deptno = d.deptno;
Une jointure interne renvoie uniquement trois lignes : les employés dont les numéros de service existent dans la table des services. Les employés des départements 4, 5 et 6 n’apparaissent pas parce que ces services ne figurent pas dans la table des services.
Lorsque vous devez inclure tous les employés, indépendamment des correspondances de service, utilisez une jointure externe gauche :
-- Left join: all employees, NULL for missing departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
LEFT JOIN department d ON e.deptno = d.deptno;
Cela renvoie les six employés. Ceux sans services correspondants affichent NULL dans la deptname colonne.
Joindre des DataFrames à PySpark
La méthode de join() PySpark fournit les mêmes fonctionnalités. Le how paramètre spécifie le type de jointure :
df_employee = spark.table("employee")
df_department = spark.table("department")

# Inner join
df_inner = df_employee.join(
    df_department,
    on=df_employee.deptno == df_department.deptno,
    how="inner"
)
display(df_inner)
Pour les jointures externes gauche, droite ou complète, modifiez le how paramètre :
# Left join: keep all employees
df_left = df_employee.join(
    df_department,
    on="deptno",
    how="left"
)

# Full outer join: keep all rows from both tables
df_full = df_employee.join(
    df_department,
    on="deptno",
    how="full"
)
Lorsque la colonne de jointure porte le même nom dans les deux DataFrames, transmettez le nom de la colonne sous forme de chaîne. Cette approche évite les colonnes dupliquées dans le résultat.
Filtrer des données avec des jointures semi et anti
Les semi-jointures et les jointures anti filtrent les données en fonction de l’existence dans une autre table. Une semi-jointure renvoie les lignes de la table de gauche qui ont des correspondances, sans inclure les colonnes de la table de droite :
-- Find employees who belong to listed departments
SELECT *
FROM employee
LEFT SEMI JOIN department ON employee.deptno = department.deptno;
Une jointure anti retourne l’inverse : lignes sans correspondances :
-- Find employees in departments not listed
SELECT *
FROM employee
LEFT ANTI JOIN department ON employee.deptno = department.deptno;
Dans PySpark, utilisez how="semi" ou how="anti":
# Employees with matching departments
df_semi = df_employee.join(df_department, on="deptno", how="semi")

# Employees without matching departments
df_anti = df_employee.join(df_department, on="deptno", how="anti")
Combiner des lignes avec des opérateurs ensemblistes
Les opérateurs d'ensemble opèrent verticalement, en combinant des lignes de requêtes ayant la même structure de colonnes. Contrairement aux jointures, les opérateurs ensemblistes ne correspondent pas à des conditions : ils empilent ou comparent des jeux de résultats entiers.
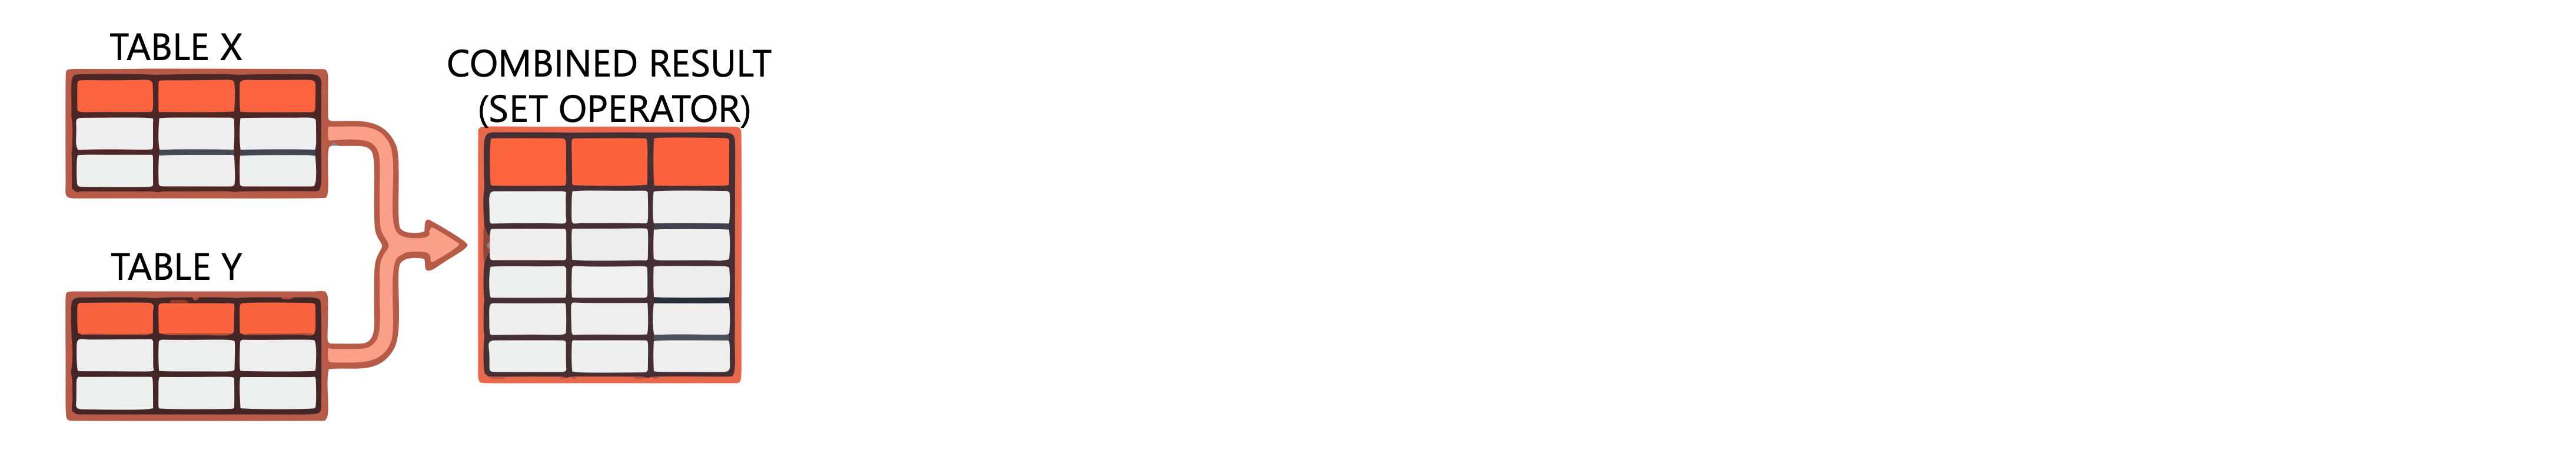
Comprendre les opérateurs d'ensemble
Azure Databricks prend en charge trois opérateurs d'ensemble :
| Operator | Descriptif | Comportement |
|---|---|---|
UNION |
Combinez les lignes des deux requêtes | Supprime les doublons par défaut ; utiliser ALL pour les conserver |
INTERSECT |
Retourne des lignes qui existent dans les deux requêtes | Seules les lignes correspondantes apparaissent |
EXCEPT |
Retourne les lignes de la première requête qui ne sont pas dans la seconde. | Supprime les doublons par défaut |
Les deux requêtes doivent avoir le même nombre de colonnes avec des types de données compatibles.
Fusionner des jeux de données avec UNION
UNION ajoute des lignes d’une requête à une autre. Par défaut, il supprime les doublons :
-- Combine active and archived customers (no duplicates)
SELECT customer_id, name, email FROM active_customers
UNION
SELECT customer_id, name, email FROM archived_customers;
Pour conserver toutes les lignes, y compris les doublons, utilisez UNION ALL:
-- Combine all rows, keeping duplicates
SELECT customer_id, name, email FROM active_customers
UNION ALL
SELECT customer_id, name, email FROM archived_customers;
Utilisez UNION ALL quand vous savez qu’il n’y a pas de doublons ou quand les doublons sont significatifs. Il offre de meilleures performances car il ignore l’étape de déduplication.
Dans PySpark, utilisez-le union() pour combiner des DataFrames. Notez que PySpark union() se comporte comme UNION ALL: il conserve les doublons :
df_active = spark.table("active_customers")
df_archived = spark.table("archived_customers")

# Combine both tables (keeps duplicates)
df_combined = df_active.union(df_archived)

# Remove duplicates if needed
df_distinct = df_active.union(df_archived).distinct()
Rechercher des lignes communes avec INTERSECT
INTERSECT retourne uniquement les lignes qui apparaissent dans les deux requêtes. Cela permet d’identifier les données qui se chevauchent :
-- Find customers in both active and archived tables
SELECT customer_id FROM active_customers
INTERSECT
SELECT customer_id FROM archived_customers;
Cette requête identifie les clients qui apparaissent dans les deux tables, utiles pour les vérifications de qualité des données ou l’identification des enregistrements qui ont besoin d’un rapprochement.
Exclure les lignes avec EXCEPT
EXCEPT retourne des lignes de la première requête qui n'existent pas dans la seconde. Cela permet d’identifier les lacunes ou les enregistrements uniques :
-- Find active customers not in the archived table
SELECT customer_id FROM active_customers
EXCEPT
SELECT customer_id FROM archived_customers;
Vous pouvez également utiliser MINUS comme synonyme pour EXCEPT:
-- Same result using MINUS syntax
SELECT customer_id FROM active_customers
MINUS
SELECT customer_id FROM archived_customers;
Comme UNION, les deux INTERSECT et EXCEPT suppriment les doublons par défaut. Ajoutez ALL pour conserver les doublons si nécessaire.
Conseil / Astuce
Lors du chaînage des opérations sur les ensembles, n'oubliez pas que INTERSECT a une priorité plus élevée que UNION et EXCEPT. Utilisez des parenthèses pour contrôler l’ordre d’évaluation.
Choisir entre les jointures et définir des opérateurs
Le choix entre les jointures et les opérateurs de définition dépend de votre objectif de transformation. Les jointures combinent horizontalement les colonnes des tables associées, tandis que les opérateurs d'ensemble combinent verticalement les lignes.
Utilisez des jointures lorsque vous devez :
- Enrichir les enregistrements en ajoutant des colonnes à partir de tables associées
- Faire correspondre des enregistrements en fonction de relations de clé
- Filtrer les données en fonction de l’existence dans une autre table (jointures semi/anti)
Utilisez des opérateurs ensemblistes lorsque vous devez :
- Ajouter des enregistrements à partir de plusieurs sources avec des schémas identiques
- Rechercher des enregistrements communs entre les jeux de données
- Identifier les enregistrements uniques à un jeu de données
Ces deux approches constituent la base des pipelines de transformation de données efficaces. Dans l’unité suivante, vous allez découvrir comment charger des données transformées dans des tables cibles dans le catalogue Unity.