Déboguer le flux de données de mappage
Pendant la génération des flux de données de mappage, vous pouvez surveiller de manière interactive comment s’exécutent les transformations de données et ainsi les déboguer. Pour utiliser cette fonctionnalité, il est d’abord nécessaire d’activer la fonctionnalité « Débogage du flux de données ».
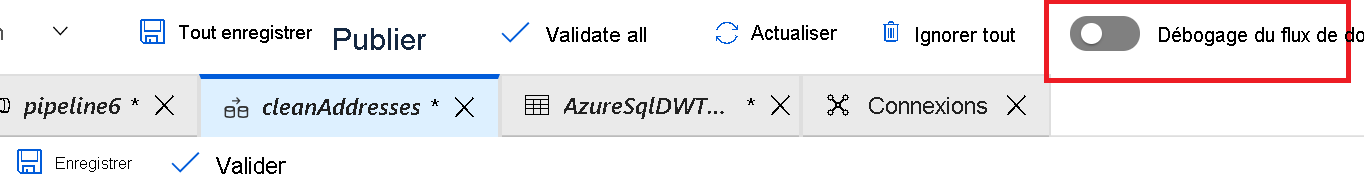
La sélection de Debug provisionne les clusters Spark nécessaires pour interagir avec les transformations de mappage Data Flow. Lorsque vous activez le débogage, vous êtes invité à sélectionner le runtime d’intégration dont vous avez besoin dans l’environnement. Si vous sélectionnez AutoResolveIntegrationRuntime, un cluster avec huit cœurs et une durée de vie par défaut de 60 minutes démarre. Vous pouvez choisir un TTL plus élevé si vous souhaitez autoriser plus de temps d’inactivité avant l’expiration de la session.
Remarque
Le démarrage du cluster prend généralement de 5 à 7 minutes. Avec ce mode et les clusters Spark en cours d’exécution, vous pouvez créer votre flux de données étape par étape et afficher les données pendant qu’elles s’exécutent dans chaque phase de transformation.
Un onglet Aperçu des données est disponible en mode Débogage qui vous permet d’afficher les données à chaque étape du pipeline. Vous pouvez voir les données après chaque transformation. L’aperçu des données permet également d’effectuer des actions sur les données, telles que l’affichage de statistiques descriptives, la modification du type de données d’une colonne ou la suppression d’une colonne.
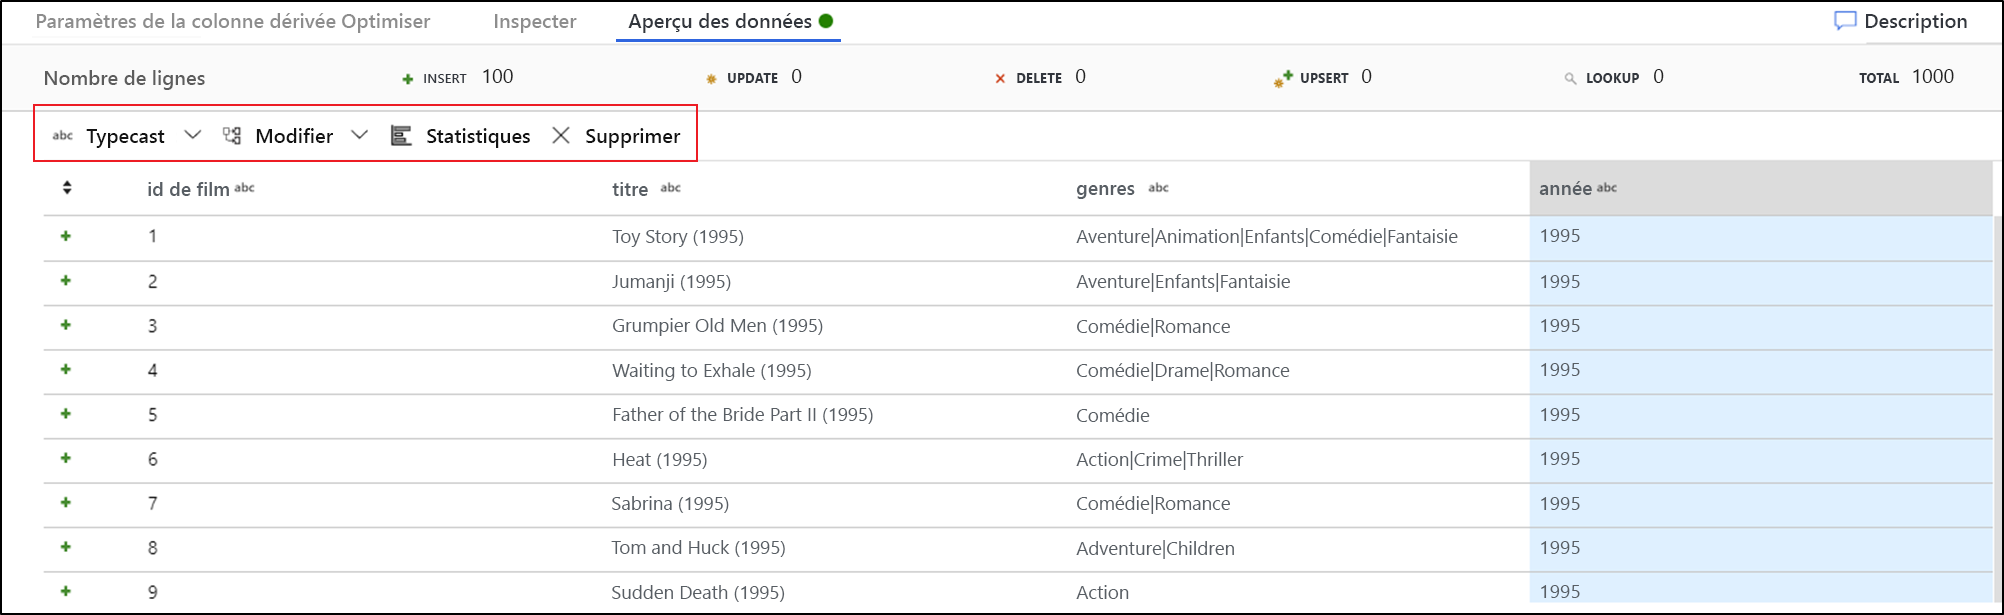
Enfin, vous pouvez utiliser les paramètres de débogage pour contrôler le nombre de lignes retournées dans l’aperçu des données.
Remarque
Il est recommandé de limiter le nombre de lignes au minimum nécessaire pour confirmer que les données sont correctes. Plus le jeu de données est grand, plus il faut de temps pour retourner les résultats. Vous pouvez également utiliser les paramètres de débogage pour spécifier les valeurs de paramètre qui doivent être utilisées pendant l’exécution du pipeline.
La session de débogage vous est facturée à l'heure tant qu'elle est en cours d'exécution, y compris pendant la durée de vie (TTL). Désactivez le commutateur de débogage une fois le débogage terminé afin que le cluster Spark puisse s'arrêter.