Choisir un format de tableau de données
Tip
Pour plus d’informations, consultez l’onglet Texte et images !
Les ingénieurs données sont confrontés à une décision critique au début de chaque pipeline de données : quel format de table doit stocker vos données ? Ce choix affecte les performances des requêtes, la fiabilité des transactions, l’interopérabilité avec d’autres plateformes et la maintenance à long terme de votre architecture lakehouse.
Azure Databricks prend en charge plusieurs formats de stockage, chacun conçu pour différents scénarios. Comprendre leurs différences vous aide à sélectionner le format approprié pour vos besoins spécifiques.
Comprendre les formats de fichiers et les formats de table
Avant de comparer les options, il est important de faire la distinction entre les formats de fichier et les formats de table. Un format de fichier tel que Parquet, CSV ou JSON définit la façon dont les données sont stockées physiquement sur le disque. Un format de tableau tel que Delta Lake ou Apache Iceberg s’appuie sur des formats de fichiers en ajoutant une couche de métadonnées qui suit les transactions, les modifications de schéma et les emplacements des fichiers de données.
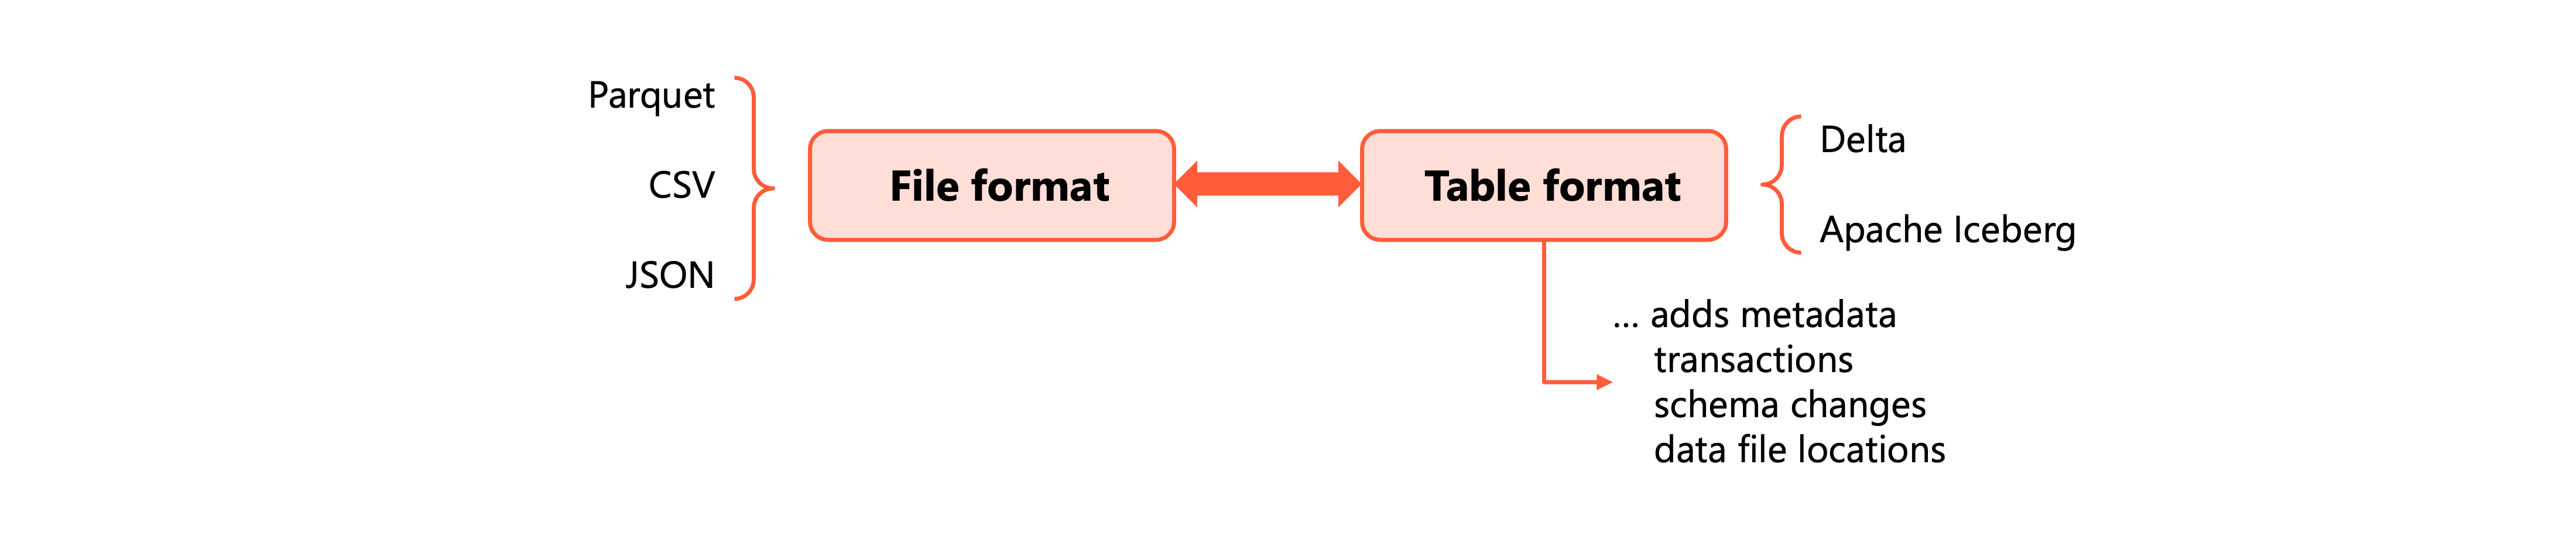
Delta Lake et Apache Iceberg utilisent Parquet comme format de fichier sous-jacent. La principale différence réside dans la couche de métadonnées qui permet des fonctionnalités avancées telles que les transactions ACID, le voyage dans le temps et l’évolution du schéma.
Comment Parquet stocke les données différemment
Parquet utilise le stockage en colonnes plutôt que le stockage basé sur des lignes. Cette différence fondamentale a un impact significatif sur les performances des requêtes analytiques.
Dans les formats basés sur des lignes comme CSV, les données sont organisées par enregistrement. La lecture d’une seule colonne nécessite l’analyse de chaque ligne du fichier. Dans les formats columnar comme Parquet, les données de chaque colonne sont stockées ensemble. Lorsqu’une requête ne nécessite que des colonnes spécifiques, Parquet lit uniquement ces colonnes et ignore entièrement le reste.
Parquet organise les données en groupes de lignes, chacun contenant des blocs de colonnes. Chaque segment de colonne stocke les statistiques, y compris les valeurs minimales et maximales pour ce segment de données. Lorsque vous exécutez une requête avec une condition de filtre, le moteur de requête vérifie d’abord ces statistiques. Si la valeur du filtre se trouve en dehors de la plage minimale/maximale d’un groupe de lignes, le moteur ignore la lecture de cette section entière.
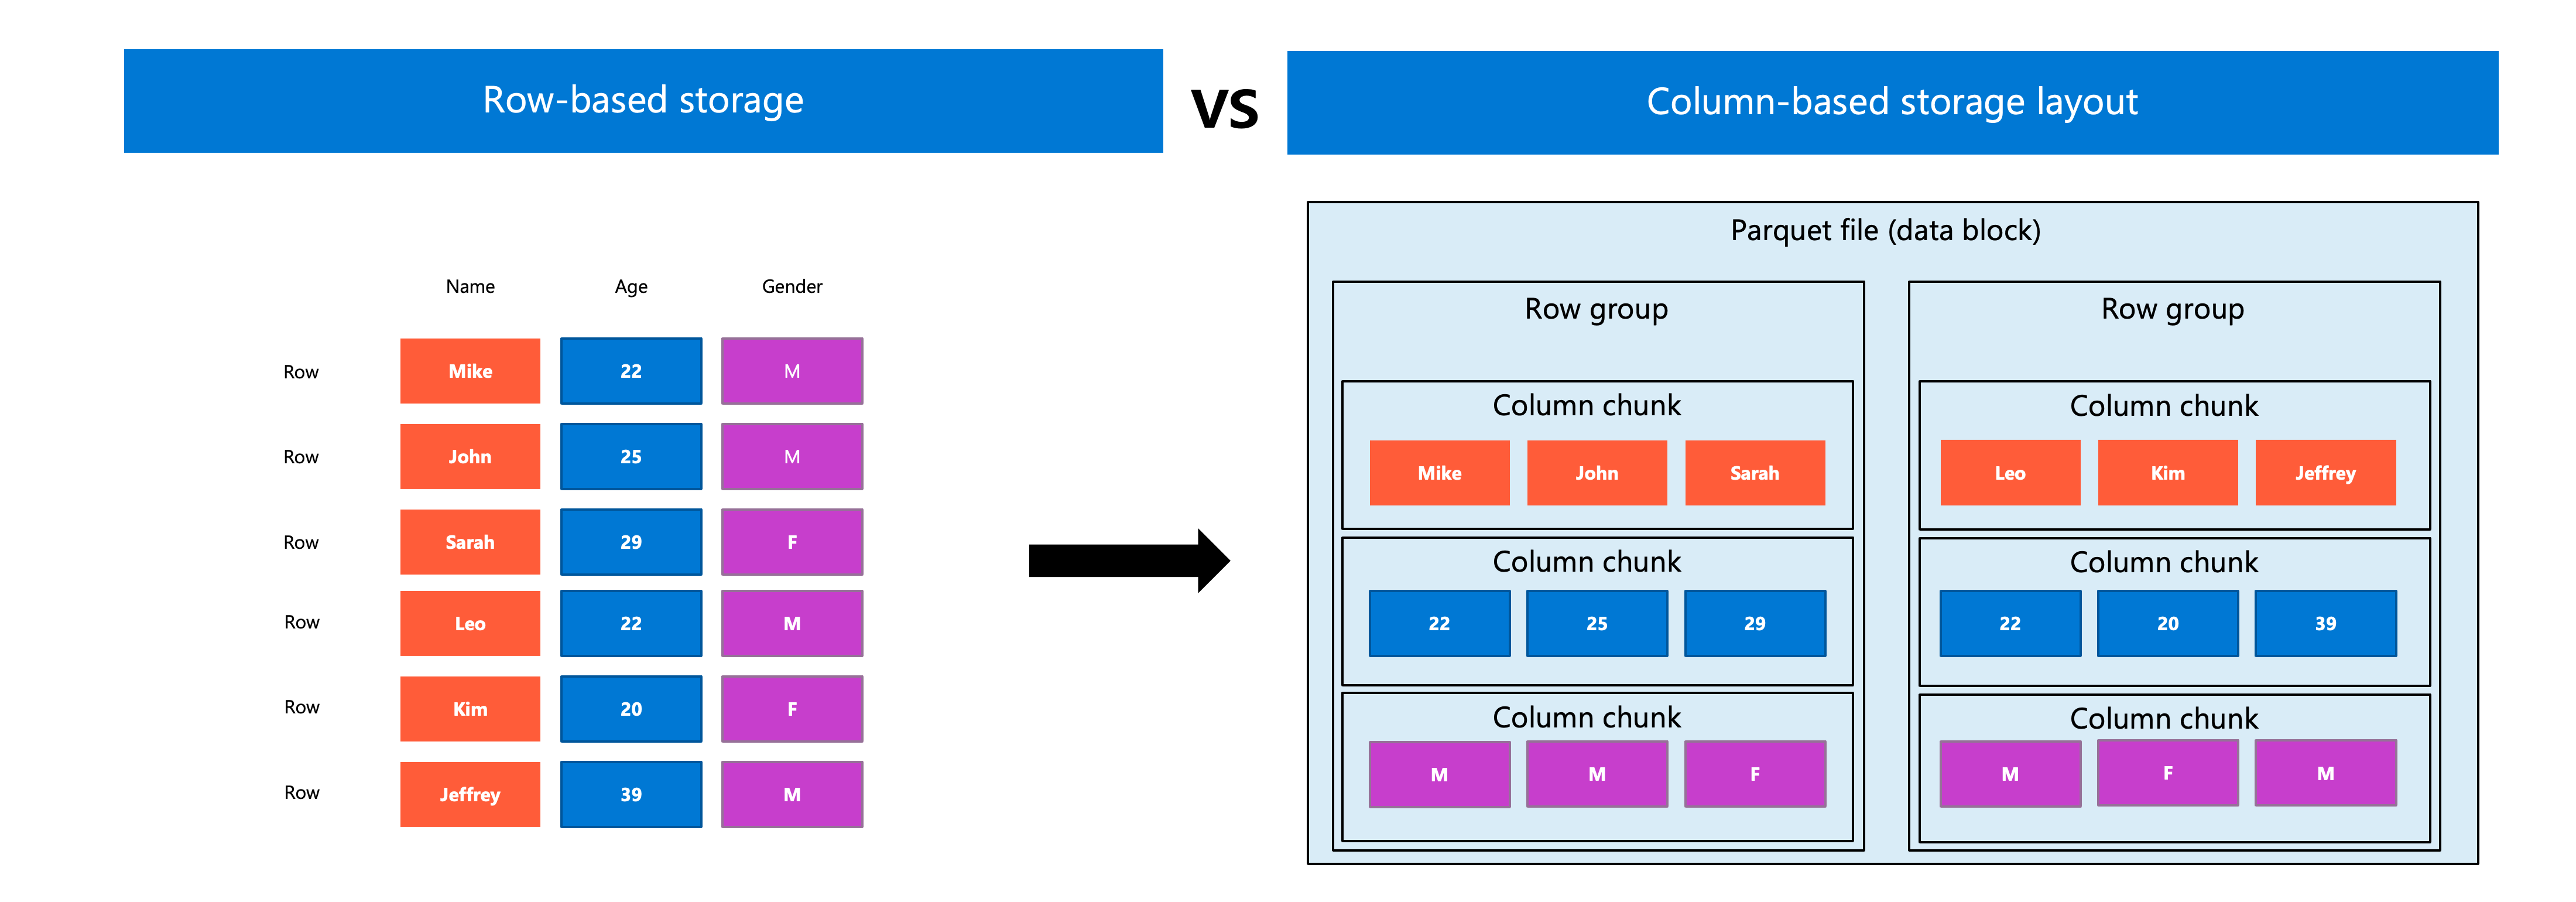
Cette approche columnar fournit deux techniques d’optimisation qui améliorent considérablement les performances d’analyse :
- Élagage des colonnes : le moteur ne lit que les colonnes auxquelles votre requête fait référence, réduisant considérablement les E/S.
- Pushdown des prédicats : les conditions de filtrage sont évaluées sur les statistiques de colonnes avant la lecture des données, ce qui permet d’ignorer entièrement les groupes de lignes non pertinents.
Pour les charges analytiques qui accèdent généralement à un sous-ensemble de colonnes sur de nombreuses lignes, Parquet surpasse largement les formats orientés ligne.
Delta Lake comme format par défaut
Delta Lake est le format de stockage par défaut pour toutes les tables dans Azure Databricks. Lorsque vous créez une table sans spécifier de format, Azure Databricks utilise automatiquement Delta Lake.
Delta Lake étend les fichiers Parquet avec un journal des transactions qui enregistre chaque modification apportée à votre table. Ce fichier journal permet plusieurs fonctionnalités que Parquet à lui seul ne fournit pas :
Transactions ACID : plusieurs lecteurs et enregistreurs simultanés peuvent accéder à la même table sans altération des données. Chaque transaction s'achève complètement ou n'a pas d'effet.
Voyage dans le temps : interrogez les versions précédentes de votre table à l’aide des horodatages ou des numéros de version. Annulez les modifications si nécessaire.
Mise en œuvre et évolution du schéma : la table valide les données entrantes par rapport à son schéma défini, empêchant les données endommagées ou incompatibles d’entrer dans votre lakehouse. Lorsque les exigences changent, vous pouvez ajouter de nouvelles colonnes, modifier des types de données ou renommer des colonnes sans réécrire les données existantes.
Traitement par lots unifié et diffusion en continu : utilisez la même table qu’une source de traitement par lots et une source de diffusion en continu ou un récepteur.
Delta Lake s’intègre profondément à la plateforme Azure Databricks. Les fonctionnalités telles que le clustering liquide et l’optimisation prédictive sont disponibles pour les tables Delta Lake et Apache Iceberg gérées dans le Unity Catalog. Toutefois, le flux de données modifiées est spécifique à Delta Lake et s’appuie sur son journal des transactions.
Pour la plupart des scénarios dans Azure Databricks, Delta Lake est le choix recommandé. Il offre les avantages en matière de performances de Parquet avec des garanties transactionnelles requises par les systèmes de données de production.
Apache Iceberg pour les scénarios multiplateformes
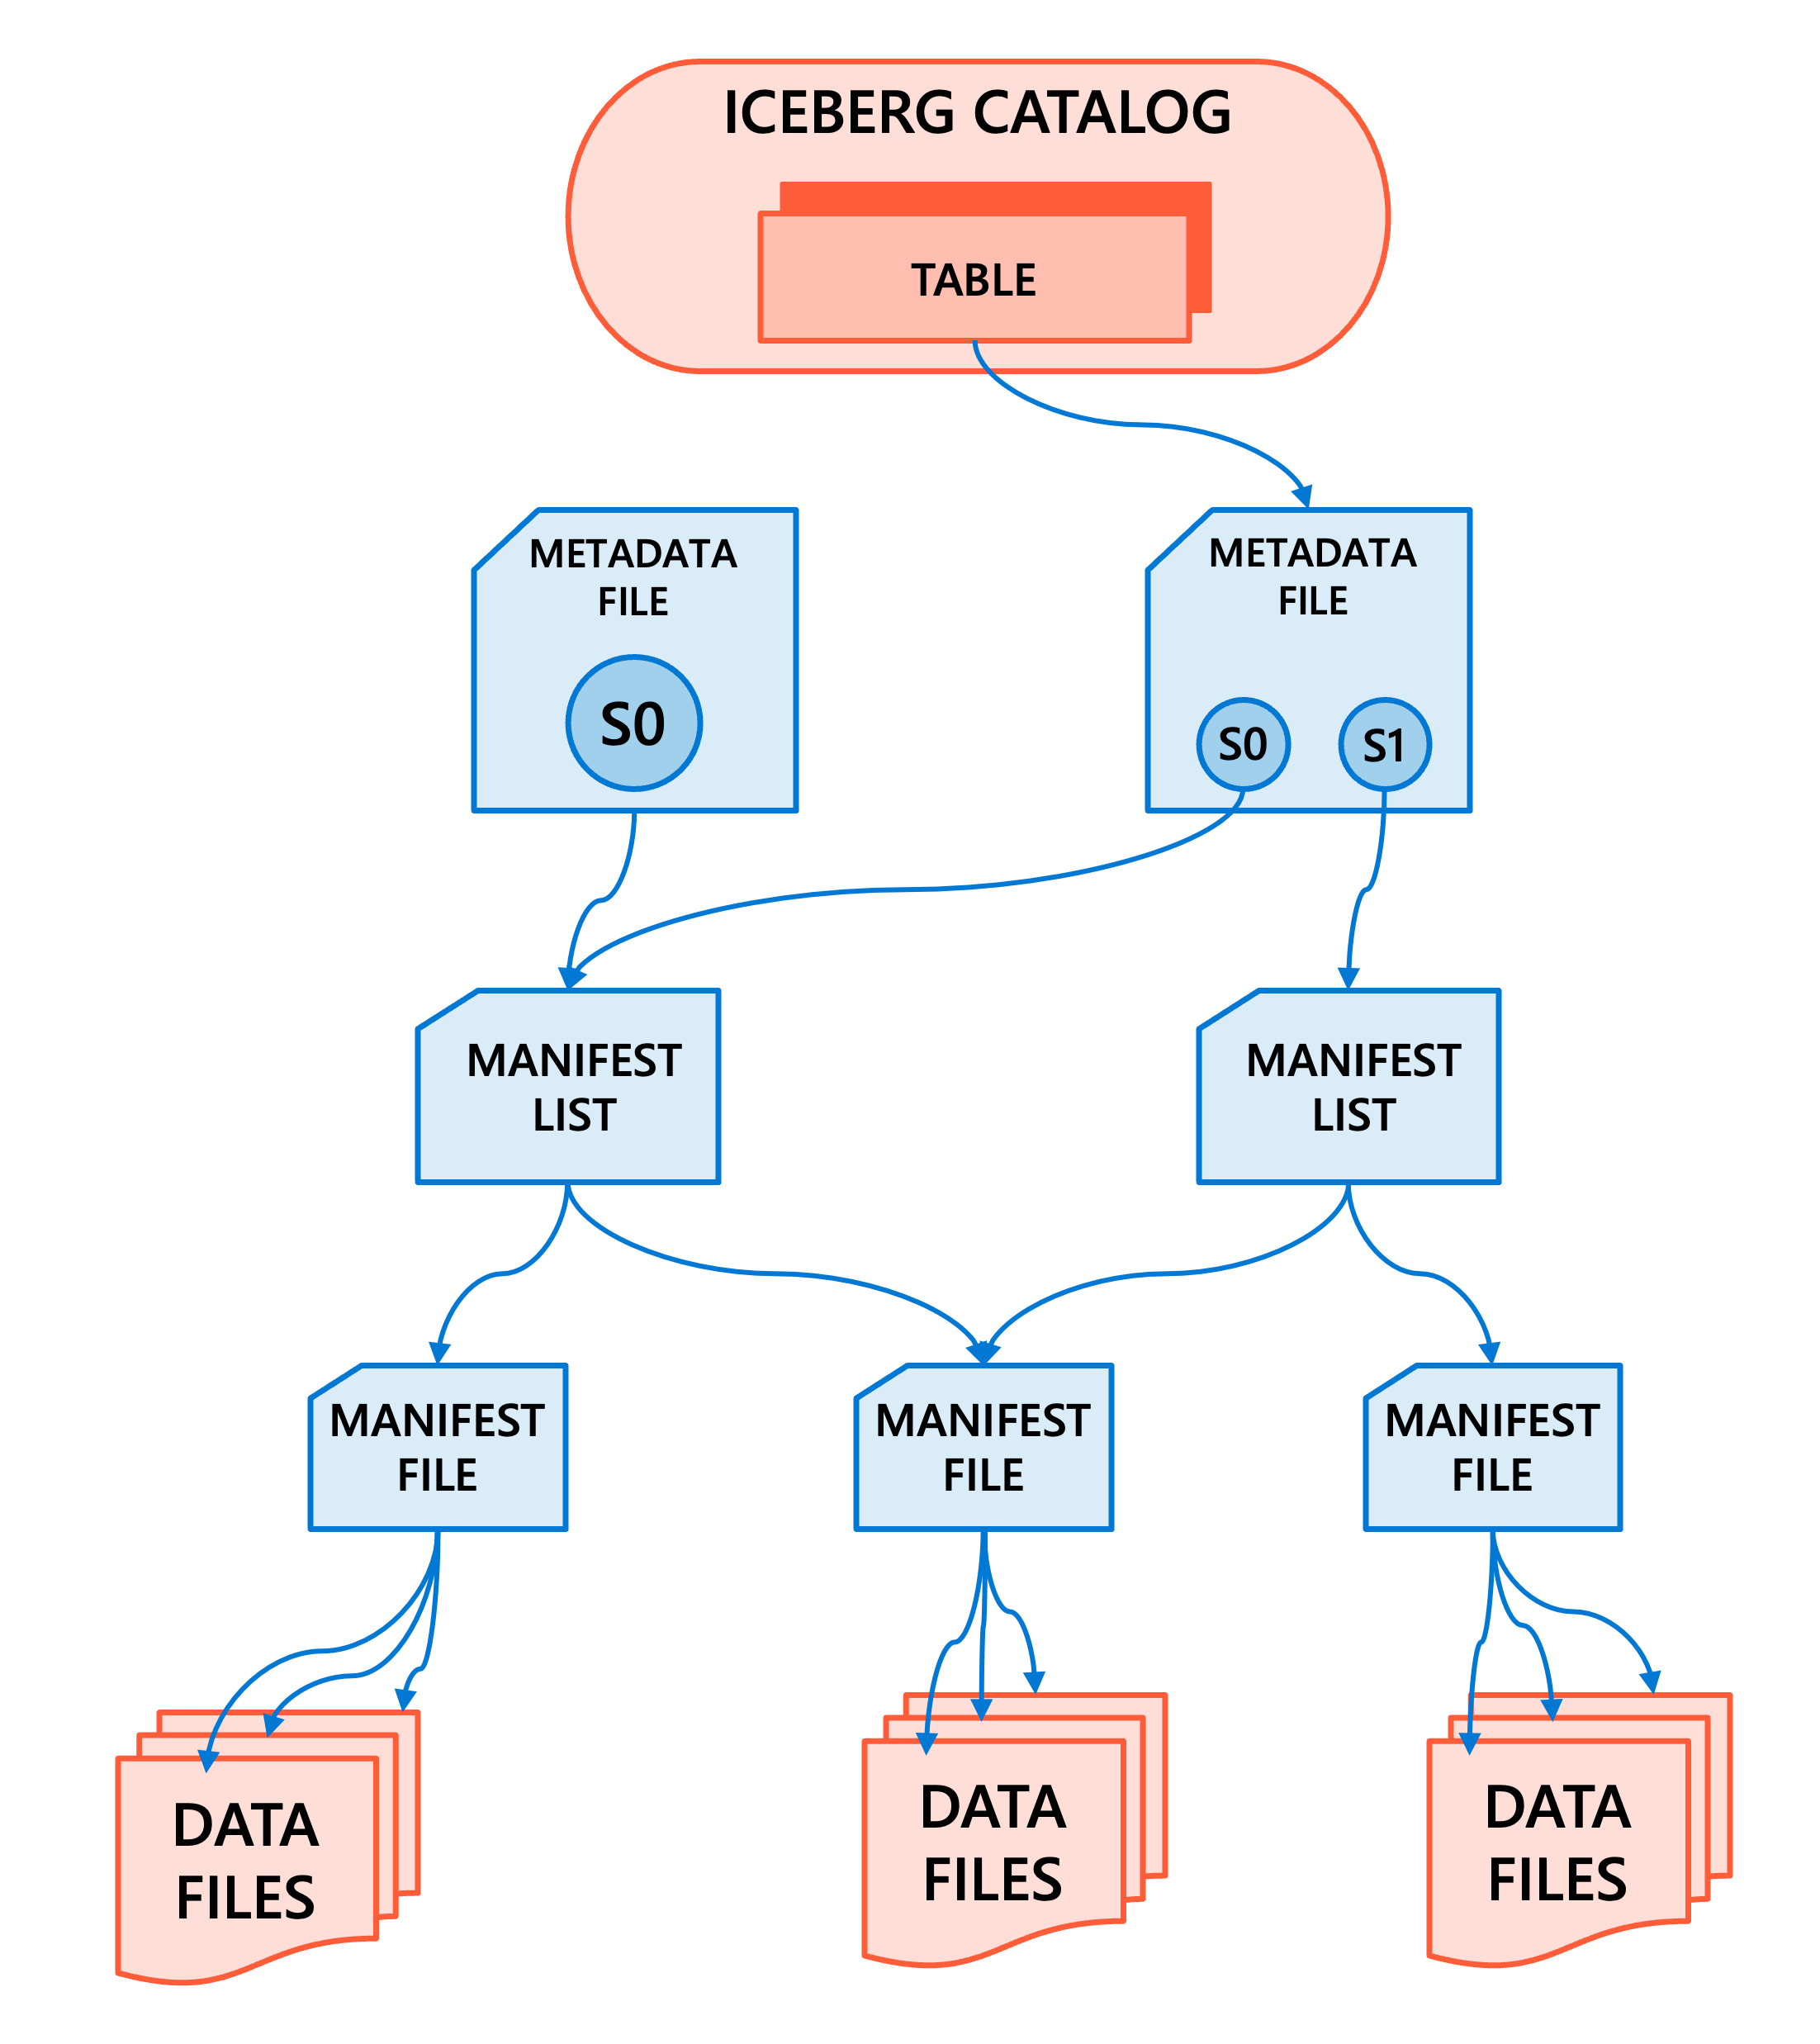
Apache Iceberg est un autre format de table ouvert pris en charge par Azure Databricks pour les tables gérées et étrangères. Comme Delta Lake, Iceberg fournit des transactions ACID, l’évolution de schéma et des capacités de time travel, le tout construit au-dessus de fichiers Parquet.
La structure logique hiérarchique et bien définie d’Iceberg le rend hautement flexible, prenant en charge l’évolutivité et les optimisations avancées. Il prend en charge l’éruning manifeste, les statistiques au niveau du fichier, le partitionnement masqué et l’évolution de la partition.
La principale raison de choisir Iceberg est l’interopérabilité. Iceberg est largement adopté dans l'écosystème de données, y compris les plateformes comme Snowflake, Amazon Athena, Trino, Apache Spark et Apache Flink. Si votre organisation exécute des charges de travail sur plusieurs plateformes qui doivent lire et écrire les mêmes tables, Iceberg fournit un format commun à toutes les plateformes.
Unity Catalog peut gérer directement les tables Iceberg, ce qui permet à Azure Databricks de servir de catalogue Iceberg pour les moteurs externes. Vous pouvez également lire les tables Iceberg gérées par d’autres catalogues tels que AWS Glue ou Snowflake Horizon Catalog via des connexions de table étrangère.
Envisagez Iceberg lorsque :
- Vos données doivent être accessibles par plusieurs moteurs de traitement en dehors d’Azure Databricks.
- Votre organisation a standardisé sur Iceberg pour le partage de données multiplateforme.
- Vous intégrez des systèmes qui ne prennent pas en charge Delta Lake.
Pour les charges de travail qui s’exécutent principalement dans Azure Databricks, Delta Lake reste le format recommandé en raison de ses fonctionnalités d’intégration et d’optimisation de plateforme plus approfondies.
Quand les formats basés sur des lignes s’appliquent
Csv et JSON restent des choix valides pour des scénarios spécifiques, même s’ils sont moins efficaces pour les analyses à grande échelle.
Utilisez CSV ou JSON quand :
- Vous recevez des données de systèmes externes dans ces formats en tant que zone d’atterrissage initiale.
- Vous avez besoin de données lisibles par l’homme pour le débogage ou l’inspection rapide.
- Vous intégrez des systèmes qui prennent uniquement en charge les formats textuels.
- Les volumes de données sont suffisamment petits pour que les différences de performances soient négligeables.
Pour le stockage persistant des données analytiques, convertissez les fichiers CSV ou JSON entrants en tables Delta Lake pendant l’ingestion. Cette conversion capture les gains d’efficacité du stockage en colonnes tout en ajoutant des garanties transactionnelles.
Appliquer des critères de décision
La sélection d’un format de tableau dépend de vos besoins spécifiques. Commencez par Delta Lake comme choix par défaut, puis évaluez les alternatives uniquement lorsque des contraintes spécifiques les nécessitent.
| Considération | Lac Delta | Apache Iceberg | CSV/JSON |
|---|---|---|---|
| Performances d’analyse | Excellent | Excellent | Pauvre |
| Transactions ACID | Oui | Oui | Non |
| Voyage dans le temps | Oui | Oui | Non |
| Intégration d’Azure Databricks | Profond | Soutenu | Élémentaire |
| Compatibilité multiplateforme | Croissant | Paysage | Universal |
| Recommandé pour la production | Oui | Oui (lorsque l’interopérabilité est requise) | Non (zone d’atterrissage uniquement) |
Votre choix dépend également des normes organisationnelles. Si votre équipe d’architecture a établi des conventions pour les formats de table, alignez-vous sur ces décisions pour maintenir la cohérence dans votre plateforme de données.