Évaluer l’IA générative
Les évaluations sont des évaluations systématiques des performances, de la fiabilité et de la sécurité des applications d’IA génératives. Ils vous aident à vérifier si une application produit des réponses utiles, ancrées et conformes aux stratégies dans les scénarios qui comptent le plus pour vos utilisateurs.
Les évaluations sont cruciales pour plusieurs raisons :
- Assurance qualité : ils permettent de s’assurer que les systèmes IA répondent à la norme attendue pour l’utilité, la clarté et la fiabilité.
- Validation de la sécurité : Elle identifie les comportements dangereux ou non conformes à la politique avant qu'ils n'atteignent les utilisateurs finaux.
- Comparaison des changements : ces outils permettent de comparer les modifications de requête, de récupération, de modèle et d’outil sur la base de preuves plutôt que d’anecdotes.
- Confiance des utilisateurs : les applications évaluées de manière cohérente sont plus faciles à améliorer et plus faciles à approuver pour les parties prenantes.
Évaluations assistées par l’IA dans Microsoft Foundry
Les applications ia génératives ont généralement besoin de plusieurs métriques. Dans le portail Foundry, les évaluateurs intégrés sont organisés en trois groupes de haut niveau : Agent, Qualité et Sécurité. Dans le catalogue complet, ces groupes s’étendent en familles d’évaluateurs telles que la qualité générale, la similarité textuelle, RAG, les risques et la sécurité et les évaluateurs d’agents. Cette structure vous permet de tester différents modes d’échec au lieu de traiter l’évaluation comme un score de précision unique.
Les évaluateurs assistés par l’IA dans le catalogue de qualité, ainsi que de nombreux évaluateurs d’agent, ont besoin d’une connexion Azure OpenAI avec un modèle GPT déployé qui prend en charge l’achèvement des conversations. Les évaluateurs de sécurité et Groundedness Pro utilisent plutôt les services d’évaluation hébergés par Microsoft. Ils ne dépendent donc pas d’un déploiement de modèle de juge. Cette distinction affecte les prérequis, la planification des coûts et les évaluateurs que vous pouvez exécuter dans une région donnée.
Évaluer avec Microsoft Foundry
Utilisez le portail Foundry lorsque vous souhaitez un flux de travail guidé. Le flux du portail actuel vous permet de choisir une cible d’évaluation (Agent, Modèle ou Jeu de données), de charger ou de générer un jeu de données, de sélectionner des évaluateurs intégrés ou personnalisés, de confirmer le mappage des données et d’inspecter les résultats dans le portail.
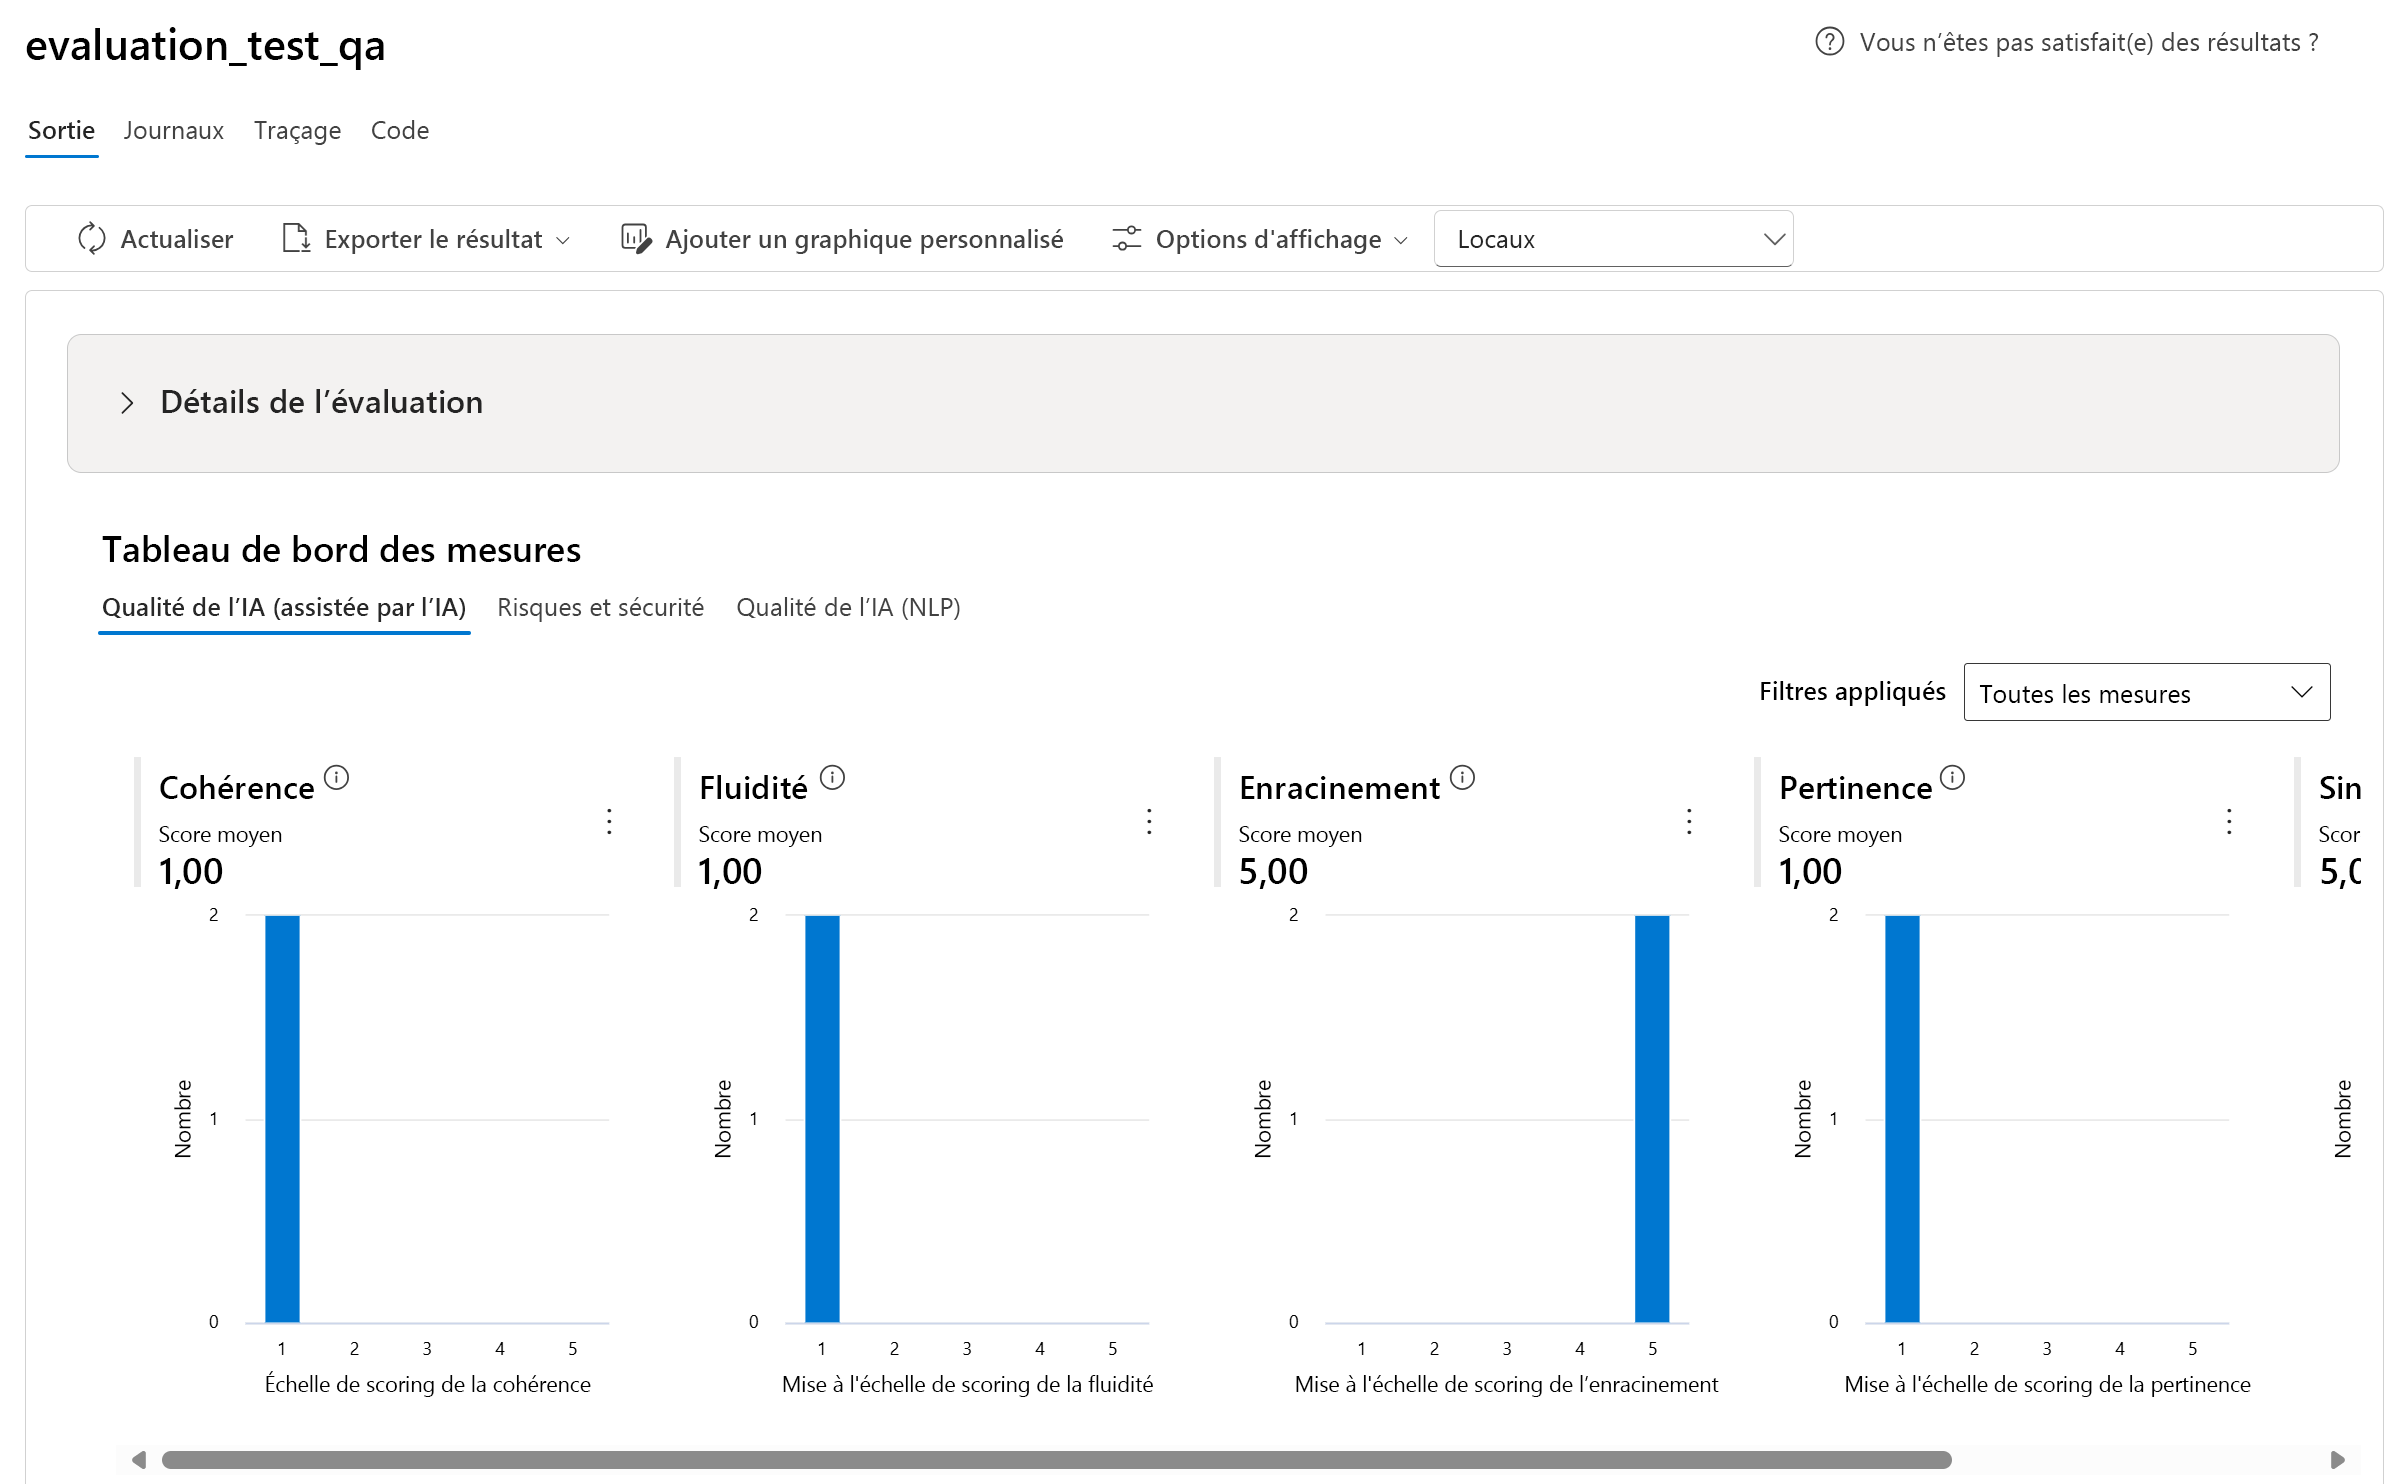
L’image montre un tableau de bord d’évaluation avec des détails d’exécution et un résumé des métriques. Le tableau de bord comprend des graphiques pour plusieurs évaluateurs, vous permet de filtrer les métriques et fournit des vues de qualité et de sécurité. Ce type de page de résultats vous permet de voir la tendance globale d’une exécution avant d’inspecter les paires d’invites et de réponses individuelles.
Une fois l’exécution terminée, passez en revue les métriques d’agrégation et les résultats au niveau des lignes. Les métriques d’agrégation indiquent la tendance générale, tandis que les résultats au niveau ligne montrent les invites qui ont échoué, les scores et les étiquettes qu'elles ont reçus, ainsi que la raison pour laquelle l’évaluateur les a ainsi marqués.
Utiliser des flux de travail sdk pour l’automatisation
Utilisez des flux de travail sdk lorsque vous avez besoin d’une automatisation reproductible, d’un test de prédéploiement à grande échelle ou d’une intégration CI/CD. Les conseils d’évaluation cloud actuels prennent en charge les évaluations de jeux de données JSONL ou CSV, les évaluations de cibles de modèle, les évaluations de cibles d’agent, les évaluations des réponses de l’agent (par ID de réponse), les évaluations de données synthétiques (aperçu) et les évaluations d’équipe rouge. Ces exécutions sont stockées dans votre projet Foundry afin de pouvoir les consulter dans le portail en même temps que d’autres évaluations, et vous pouvez également les planifier ou configurer une évaluation continue sur des réponses échantillonnaires de l’agent de production.
Étant donné que l’évaluation cloud est actuellement en préversion et que certaines fonctionnalités d’évaluation ont une prise en charge spécifique à la région, confirmez les termes actuels de la préversion, les régions prises en charge et les limites opérationnelles avant de l’utiliser comme porte de mise en production.
Quel que soit l’outil que vous choisissez, combinez l’évaluation automatisée avec une révision humaine ciblée. Un petit échantillon représentatif examiné par des humains expose souvent des problèmes de tonalité, des réponses incomplètes ou des résultats trompeurs mais plausibles que les scores agrégés peuvent masquer.
Tip
Pour connaître les procédures actuelles, consultez Exécuter des évaluations à partir du portail Microsoft Foundry, Exécuter des évaluations dans le cloud à l’aide du Kit de développement logiciel (SDK) Microsoft Foundry, afficher les résultats de l’évaluation dans le portail Microsoft Foundry, ainsi que les limites de débit, le support régional et les fonctionnalités d’entreprise à des fins d’évaluation.