Réseaux neuronaux convolutifs
- 15 minutes
Dans l’unité précédente, nous avons appris à définir un réseau neuronal multicouche générique. Dans cette unité, nous allons découvrir les réseaux neuronaux convolutionnels (CNN), qui sont conçus pour la vision par ordinateur.
La vision par ordinateur est différente de la classification générique, car lorsque nous essayons de trouver un certain objet dans l’image, nous analysons l’image à la recherche de modèles spécifiques et de leurs combinaisons . Par exemple, lorsque nous recherchons un chat, nous pouvons d’abord rechercher des lignes horizontales, qui peuvent former des moustaches, puis certaines combinaisons de moustaches peuvent nous dire qu’il s’agit en fait d’une image d’un chat. La position et la présence de certains motifs sont importantes. Pour extraire des modèles, nous allons utiliser la notion de filtres convolutionnels.
Mais tout d’abord, chargez toutes les dépendances et définissons les fonctions d’assistance que nous allons utiliser :
import keras
import tensorflow as tf
import matplotlib.pyplot as plt
import numpy as np


def plot_convolution(data, t, title=''):
    t = tf.constant(t, dtype=tf.float32)
    t = tf.reshape(t, [*t.shape, 1, 1])
    fig, ax = plt.subplots(len(data), 2)
    fig.suptitle(title, fontsize=16)
    for i in range(len(data)):
        d = tf.reshape(tf.constant(data[i], dtype=tf.float32), [1, *data[i].shape, 1])
        ax[i][0].imshow(data[i])
        ax[i][1].imshow(tf.nn.conv2d(d, t, [1, 1, 1, 1], 'SAME')[0, ..., 0])


def plot_results(hist):
    plt.figure(figsize=(12, 4))
    plt.subplot(1, 2, 1)
    plt.plot(hist.history['accuracy'], label='Training acc')
    plt.plot(hist.history['val_accuracy'], label='Validation acc')
    plt.legend()
    plt.subplot(1, 2, 2)
    plt.plot(hist.history['loss'], label='Training loss')
    plt.plot(hist.history['val_loss'], label='Validation loss')
    plt.legend()


def display_dataset(dataset, labels=None, n=10, classes=None):
    fig, ax = plt.subplots(1, n)
    for i in range(n):
        ax[i].imshow(dataset[i])
        ax[i].axis('off')
        if labels is not None:
            # Handle both scalar labels (e.g. MNIST) and array labels (e.g. CIFAR-10)
            lbl = int(labels[i][0]) if np.ndim(labels[i]) > 0 else int(labels[i])
            ax[i].set_title(classes[lbl] if classes is not None else str(lbl))
Nous allons maintenant charger le jeu de données MNIST :
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()
x_train = x_train.astype(np.float32) / 255.0
x_test = x_test.astype(np.float32) / 255.0
Filtres convolutionnels
Les filtres convolutionnels sont de petites fenêtres qui s’exécutent sur chaque pixel de l’image et calculent la moyenne pondérée des pixels voisins. Elles sont définies par des matrices de coefficients de poids. Voyons les exemples d’application de deux filtres convolutionnels différents sur nos chiffres manuscrits MNIST :
plot_convolution(x_train[:5], [[-1., 0., 1.], [-1., 0., 1.], [-1., 0., 1.]], 'Vertical edge filter')
plot_convolution(x_train[:5], [[-1., -1., -1.], [0., 0., 0.], [1., 1., 1.]], 'Horizontal edge filter')
# Expected output: Two sets of images showing original digits alongside the result of applying vertical and horizontal edge filters
Le premier filtre est appelé filtre de bord vertical, et il est défini par la matrice suivante : $$ \left( \begin{matrix} -1 & 0 & 1 \ -1 & 0 & 1 \ -1 & 0 &1 \ \end{matrix} \right) $$ Lorsque ce filtre glisse sur une région relativement uniforme de pixels, la somme pondérée produite par la convolution est proche de 0, parce que les poids positifs et négatifs s’annulent. Lorsqu’elle rencontre un bord vertical (où les intensités de pixels changent fortement de gauche à droite), la convolution produit une valeur positive ou négative importante. C’est pourquoi dans les images ci-dessus, vous pouvez voir les bords verticaux mis en surbrillance par des valeurs élevées et basses, tandis que les bords horizontaux sont lissés.
Une chose opposée se produit lorsque nous appliquons un filtre de bord horizontal : les lignes horizontales sont amplifiées, tandis que les lignes verticales sont moyennées.
Dans la vision par ordinateur classique, plusieurs filtres ont été appliqués à l’image pour générer des fonctionnalités, qui ont ensuite été utilisées par l’algorithme Machine Learning pour créer un classifieur. Dans le deep learning, nous construisons des réseaux qui apprennent les meilleurs filtres convolutionnels pour résoudre le problème de classification par eux-mêmes.
Pour ce faire, nous introduisons des couches convolutionnelles.
Couches convolutives
Les couches convolutionnelles sont définies à l’aide de Conv2D la classe. Nous devons spécifier les éléments suivants :
-
filters- nombre de filtres à utiliser. Nous allons utiliser 9 filtres différents, ce qui donnera au réseau de nombreuses opportunités d’explorer les filtres qui fonctionnent le mieux pour notre scénario. -
kernel_sizeest la taille de la fenêtre glissante. Généralement, les filtres 3x3 ou 5x5 sont utilisés.
Le CNN le plus simple ne contient qu’une seule couche convolutionnelle. Étant donné la taille d’entrée 28x28, après l’application de neuf filtres 5x5, nous allons finir par un tenseur de 24x24x9. La dimension spatiale est plus petite, car la valeur par défaut padding='valid' signifie qu’aucun remplissage n’est ajouté et qu’il n’y a que 24 positions où une fenêtre glissante de taille 5 peut s’ajuster à moins de 28 pixels (28 − 5 + 1 = 24). L’utilisation padding='same' conserverait les dimensions spatiales en ajoutant un remplissage zéro autour de l’entrée.
Après la convolution, nous aplatons les 24×24×9 tensoriels en un seul vecteur de taille 5184, puis ajoutons une couche dense pour produire 10 classes. La relu fonction d’activation est appliquée après la couche convolutionnelle pour introduire une non-linéarité.
model = keras.Sequential([
    keras.layers.Input(shape=(28, 28, 1)),
    keras.layers.Conv2D(filters=9, kernel_size=(5, 5), activation='relu'),
    keras.layers.Flatten(),
    keras.layers.Dense(10)
])

model.compile(loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])

model.summary()
# Expected output: Model summary showing a Conv2D layer, Flatten, and Dense(10) with ~52k parameters
Vous pouvez voir que ce réseau contient environ 52 000 paramètres pouvant être formés (234 dans la couche convolutionnelle + 51 850 dans la couche dense), par rapport à environ 80 000 dans des réseaux multicouches entièrement connectés. Les réseaux convolutionnels généralisent mieux, ce qui nous permet d’obtenir de bons résultats sur des jeux de données plus petits.
Note
Dans la plupart des cas pratiques, nous voulons appliquer des couches convolutionnelles aux images de couleur. Par conséquent, Conv2D la couche s’attend à ce que l’entrée soit de la forme $H\times W\times C$, où $H$ et $W$ sont la hauteur et la largeur de l’image, et $C$ est le nombre de canaux de couleur. Pour les images de nuances de gris, nous avons besoin de la même forme avec $C=1$.
Nous devons remodeler nos données avant de commencer l’entraînement :
x_train_c = np.expand_dims(x_train, 3)
x_test_c = np.expand_dims(x_test, 3)
hist = model.fit(x_train_c, y_train, validation_data=(x_test_c, y_test), epochs=3)
# Expected output: Training for 3 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 3 epochs
Comme vous pouvez le constater, nous sommes en mesure d’obtenir une précision plus élevée avec moins d’itérations par rapport aux réseaux complètement connectés de l’unité précédente. Toutefois, l’entraînement lui-même nécessite davantage de ressources et peut être plus lent sur les ordinateurs non GPU.
Visualisation des couches convolutionnelles
Nous pouvons également visualiser les poids de nos couches convolutionnelles entraînées pour essayer d’avoir un certain sens de ce qui se passe :
fig, ax = plt.subplots(1, 9)
l = model.layers[0].weights[0]
for i in range(9):
    ax[i].imshow(l[..., 0, i])
    ax[i].axis('off')
# Expected output: 9 small images showing the learned 5x5 convolutional filter weights
Vous pouvez voir que certains de ces filtres semblent capables de reconnaître certains traits obliques, tandis que d'autres paraissent aléatoires.
CNNs à couches multiples et couches de regroupement
Tout d’abord, les couches convolutionnelles recherchent des motifs primitifs, tels que des lignes horizontales ou verticales. Nous pouvons appliquer d’autres couches convolutionnelles sur celles-ci pour rechercher des modèles de niveau supérieur, tels que des formes primitives. Ensuite, des couches convolutionnelles peuvent combiner ces formes dans certaines parties de l’image, jusqu’à l’objet final que nous essayons de classifier.
Dans ce cas, nous pouvons également appliquer une astuce : réduire la taille spatiale de l’image. Une fois que nous avons détecté qu’il y a un trait horizontal dans une fenêtre glissante 3x3, il n’est pas si important à quel pixel exact il s’est produit. Ainsi, nous pouvons réduire la taille de l’image, ce qui est réalisé grâce à l’une des couches de regroupement :
- Le regroupement moyen prend une fenêtre glissante (par exemple, 2 x 2 pixels) et calcule une moyenne de valeurs dans la fenêtre
- Max Pooling remplace la fenêtre par la valeur maximale. L'idée derrière le max pooling est de détecter la présence d’un certain motif dans la fenêtre glissante.
Ainsi, dans un CNN typique, il y aurait plusieurs couches convolutionnelles, avec des couches de regroupement entre elles pour diminuer les dimensions de l’image. Nous augmenterions également le nombre de filtres, car à mesure que les modèles deviennent plus avancés , il existe des combinaisons plus intéressantes possibles que nous devons rechercher.
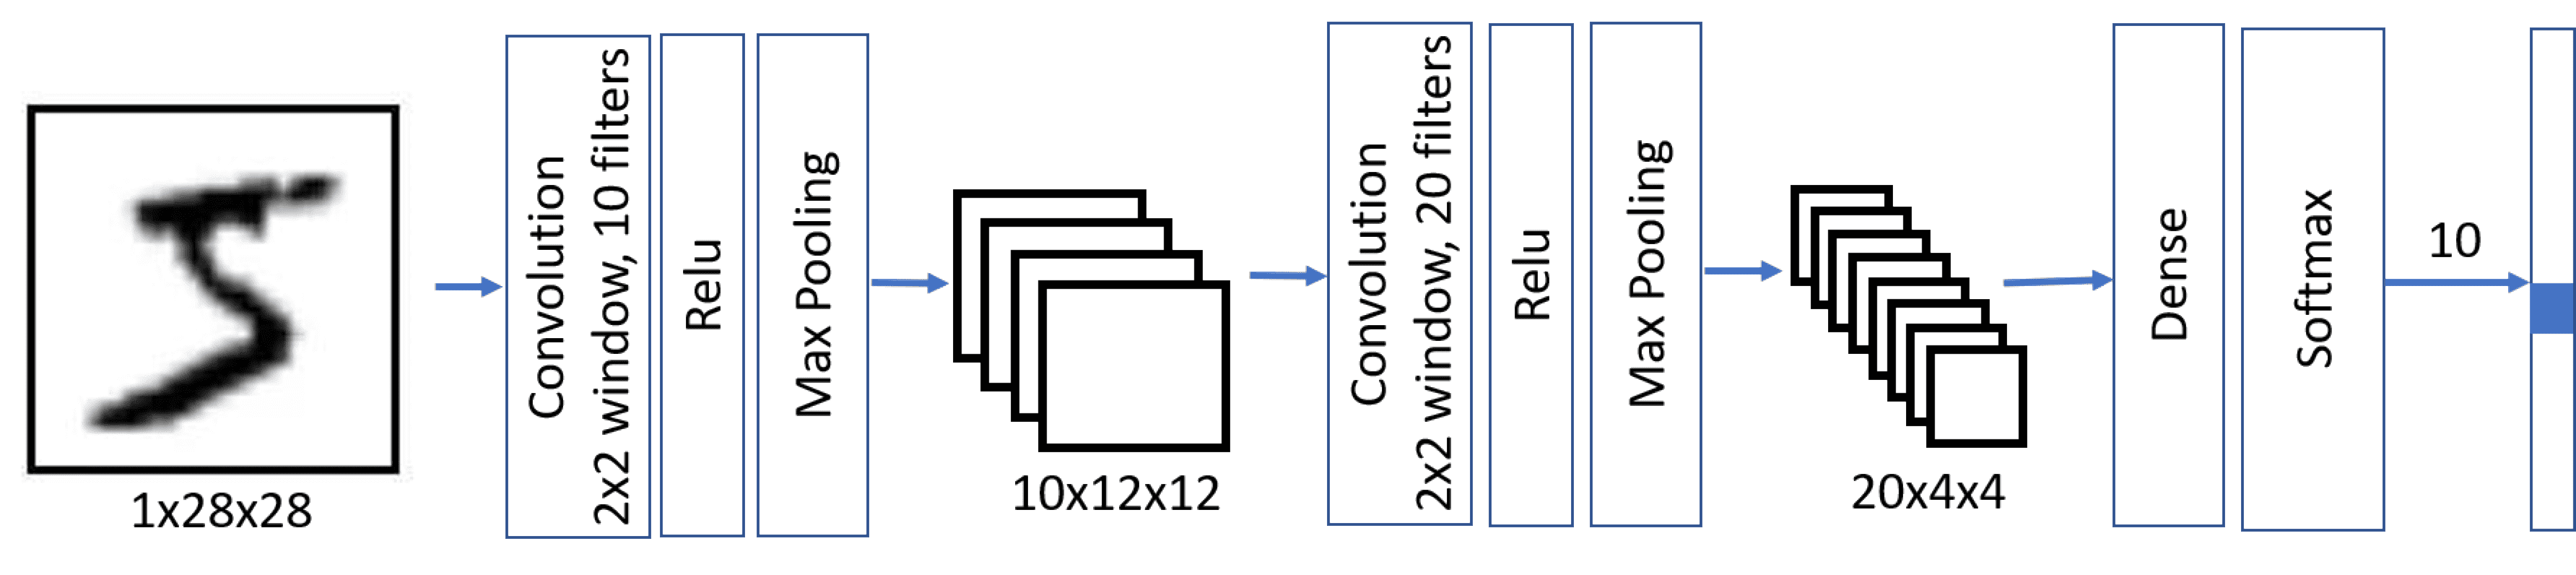
Cette architecture est également appelée architecture pyramidale en raison de la diminution des dimensions spatiales et de l’augmentation des dimensions des caractéristiques/filtres.
model = keras.Sequential([
    keras.layers.Input(shape=(28, 28, 1)),
    keras.layers.Conv2D(filters=10, kernel_size=(5, 5), activation='relu'),
    keras.layers.MaxPooling2D(),
    keras.layers.Conv2D(filters=20, kernel_size=(5, 5), activation='relu'),
    keras.layers.MaxPooling2D(),
    keras.layers.Flatten(),
    keras.layers.Dense(10)
])

model.compile(loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])

model.summary()
# Expected output: Model summary showing Conv2D, MaxPooling, Conv2D, MaxPooling, Flatten, Dense with ~8.5k parameters
Notez que le nombre de paramètres pouvant être entraînés (~8,5K) est considérablement plus petit que dans les cas précédents. Cela se produit parce que les couches convolutionnelles en général ont peu de paramètres et la dimensionnalité de l’image avant d’appliquer la couche dense finale est réduite.
hist = model.fit(x_train_c, y_train, validation_data=(x_test_c, y_test), epochs=3)
# Expected output: Training for 3 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 3 epochs
Notez que nous sommes en mesure d’obtenir une précision plus élevée avec plusieurs couches, et qu’il a besoin d’un plus petit nombre d’époques. Cela signifie qu’une architecture réseau plus sophistiquée a besoin de moins de données pour déterminer ce qui se passe et pour extraire des modèles génériques de nos images. Toutefois, chaque époque implique davantage de calcul en raison des opérations convolutionnelles supplémentaires, de sorte que l’entraînement est plus rapide avec un GPU.
Jouer avec des images réelles à partir du jeu de données CIFAR-10
Bien que notre problème de reconnaissance de chiffres manuscrits puisse sembler un problème simple, nous sommes maintenant prêts à entreprendre une tâche plus sérieuse. Examinons un jeu de données plus avancé d’images de différents objets, appelé CIFAR-10. Il contient 60 000 images 32 x 32, divisées en 10 classes.
Note
À partir de ce stade, nous rechargeons x_train, y_trainet x_testy_test avec le jeu de données CIFAR-10, en remplaçant les données MNIST utilisées précédemment dans cette unité. Les variables x_train_cx_test_c étendues ne sont plus nécessaires.
(x_train, y_train), (x_test, y_test) = keras.datasets.cifar10.load_data()
x_train = x_train.astype(np.float32) / 255.0
x_test = x_test.astype(np.float32) / 255.0
classes = ('plane', 'car', 'bird', 'cat',
           'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
display_dataset(x_train, y_train, classes=classes)
# Expected output: A row of 10 CIFAR-10 images with their class labels
Une architecture CNN classique est LeNet, proposée par Yann LeCun à l’origine pour la reconnaissance de chiffres manuscrites. Adaptons-le à la CIFAR-10. Il suit les mêmes principes que nous avons décrits ci-dessus, la principale différence étant 3 canaux de couleur d’entrée au lieu de 1.
model = keras.Sequential([
    keras.layers.Input(shape=(32, 32, 3)),
    keras.layers.Conv2D(filters=6, kernel_size=5, strides=1, activation='relu'),
    keras.layers.MaxPooling2D(pool_size=2, strides=2),
    keras.layers.Conv2D(filters=16, kernel_size=5, strides=1, activation='relu'),
    keras.layers.MaxPooling2D(pool_size=2, strides=2),
    keras.layers.Flatten(),
    keras.layers.Dense(120, activation='relu'),
    keras.layers.Dense(84, activation='relu'),
    keras.layers.Dense(10)
])

model.summary()
# Expected output: Model summary showing the LeNet architecture with Conv2D, MaxPooling, Dense layers
L’entraînement de ce réseau prend un certain temps et doit être effectué sur le calcul avec GPU.
model.compile(optimizer='adam', loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])
hist = model.fit(x_train, y_train, validation_data=(x_test, y_test), epochs=10)
# Expected output: Training for 10 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 10 epochs
La précision que nous avons pu obtenir avec seulement quelques cycles d’entraînement est assez correcte. N’oubliez pas que notre problème est beaucoup plus difficile que la classification des chiffres MNIST. Obtenir au-dessus de 60% précision est une bonne réalisation dans un temps de formation si court, bien que les modèles de pointe puissent atteindre plus de 95% sur CIFAR-10 à l’aide d’architectures plus approfondies, d’augmentation des données et d’une formation plus longue.
Takeaways
Dans cette unité, nous avons appris le concept principal derrière les réseaux neuronaux vision par ordinateur - réseaux convolutionnels. Les architectures réelles qui alimentent la classification d’images, la détection d’objets et même les réseaux de génération d’images sont toutes basées sur des réseaux CNN, juste avec plus de couches et quelques astuces d’entraînement supplémentaires.
Vérifiez vos connaissances
Commentaires
Cette page a-t-elle été utile ?
No
Vous avez besoin d’aide pour cette rubrique ?
Vous souhaitez essayer d’utiliser Ask Learn pour clarifier ou vous guider dans cette rubrique ?