Préparer les données pour la récupération
Tip
Pour plus d’informations, consultez l’onglet Texte et images !
La recherche ne peut retrouver que les informations qui ont été rendues consultables par la recherche. Avant qu’une application RAG puisse répondre aux questions, elle a besoin d’un pipeline d’indexation qui prépare les données sources.
Le pipeline d’indexation effectue généralement les tâches suivantes :
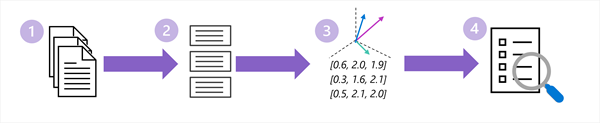
- Extrait le texte source.
- Segmente le texte en passages ciblés.
- Encode les jetons de texte en tant que vecteurs d’incorporation qui encapsulent des attributs sémantiques.
- Crée un index qui peut être utilisé pour rechercher les incorporations.
Examinons chacune de ces tâches plus en détail.
Sélectionner et traiter les données sources
Une source de connaissances RAG peut inclure des manuels de produits, des stratégies, des pages web, des enregistrements de base de données, des tickets de support ou d’autres contenus approuvés. Le processus de préparation inclut généralement les étapes suivantes :
- Chargez du contenu à partir de chaque source.
- Extrayez du texte et de la structure utiles à partir de formats tels que des fichiers PDF, des présentations, des pages web ou des tableaux.
- Nettoyez le contenu en supprimant des en-têtes répétés, du texte de navigation ou d’autres éléments qui ne sont pas utiles pour répondre aux questions.
- Ajoutez des métadonnées telles qu’un titre, une URL source, une catégorie, des autorisations d’accès et une date de dernière mise à jour.
La qualité de la source est importante. Les documents dupliqués, obsolètes ou contradictoires peuvent entraîner une mauvaise récupération et des réponses peu fiables. Les contrôles d’accès sont également essentiels : les utilisateurs doivent uniquement récupérer du contenu qu’ils sont autorisés à afficher.
Diviser le contenu en blocs
Les documents sont souvent trop volumineux pour être envoyés à un modèle en totalité. Ils sont divisés en passages plus petits appelés fragments. Chaque bloc doit contenir suffisamment de contexte pour être significatif tout en restant concentré sur une rubrique spécifique.
Par exemple, une politique de voyage peut être divisée par section en segments distincts pour les vols, les hôtels, les repas et les transports terrestres. Une question sur les limites de l’hôtel peut ensuite récupérer la section correspondante de l’hôtel sans ajouter l’intégralité de la stratégie à la prompt.
La segmentation implique un compromis :
- Les blocs trop volumineux peuvent contenir des informations non pertinentes et consommer davantage de fenêtre de contexte du modèle.
- Des blocs trop petits peuvent séparer un énoncé des en-têtes, des définitions ou d’autres informations nécessaires à sa compréhension.
Les segments se chevauchent souvent légèrement afin que le contexte important ne soit pas perdu au niveau d’une frontière.
Créer des embeddings
Les solutions RAG utilisent généralement un modèle d’incorporation pour convertir chaque segment en un vecteur numérique qui représente les caractéristiques sémantiques du contenu. Les blocs avec des significations similaires ont des incorporations proches les unes des autres dans l’espace vectoriel, même lorsqu’elles utilisent des mots différents.
Indexer les données
La solution stocke les blocs, leurs incorporations et les métadonnées utiles dans un index de recherche ou un magasin de données avec vecteur. L’index peut prendre en charge :
- Recherche de mots clés, qui est efficace lorsque des mots exacts, des identificateurs ou des codes de produit sont importants.
- Recherche vectorielle, qui recherche du contenu sémantiquement similaire.
- Recherche hybride, qui combine le mot clé et la recherche vectorielle.
La préparation des données n’est pas une tâche ponctuelle. Le pipeline d’indexation doit ajouter du nouveau contenu, mettre à jour le contenu modifié et supprimer du contenu qui n’est plus valide afin que la récupération reflète la source actuelle de vérité.