Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Usare il kit di elaborazione batch per integrare e dimensionare i carichi di lavoro nei contenitori Voce. Disponibile come contenitore, questa utilità open source facilita la trascrizione batch per un numero elevato di file audio, in qualsiasi numero di endpoint del contenitore Voce locali e basati sul cloud.
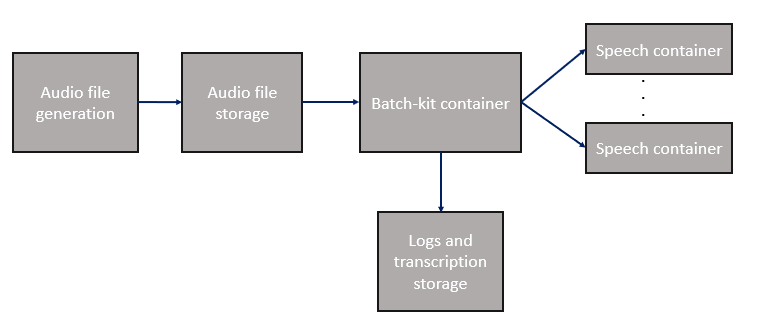
Il contenitore del kit di elaborazione batch è disponibile gratuitamente in GitHub e in Docker Hub. Vengono fatturati solo i contenitori Voce che si usano.
| Funzionalità | Descrizione |
|---|---|
| Distribuzione di file audio in batch | Inviare automaticamente un numero elevato di file a endpoint di contenitori Voce locali o basati sul cloud. I file possono trovarsi in qualsiasi volume conforme allo standard POSIX, inclusi file system di rete. |
| Integrazione dell'SDK di Voce | Passare flag comuni all'SDK di Voce, tra cui: ipotesi N migliori risultati, diarizzazione, lingua, mascheramento del contenuto volgare. |
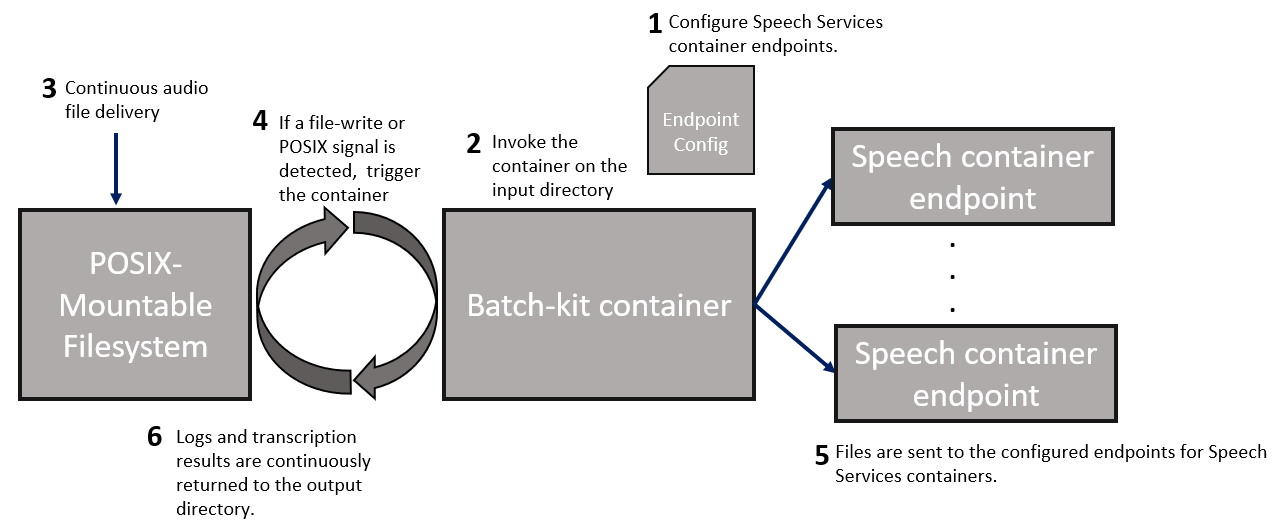
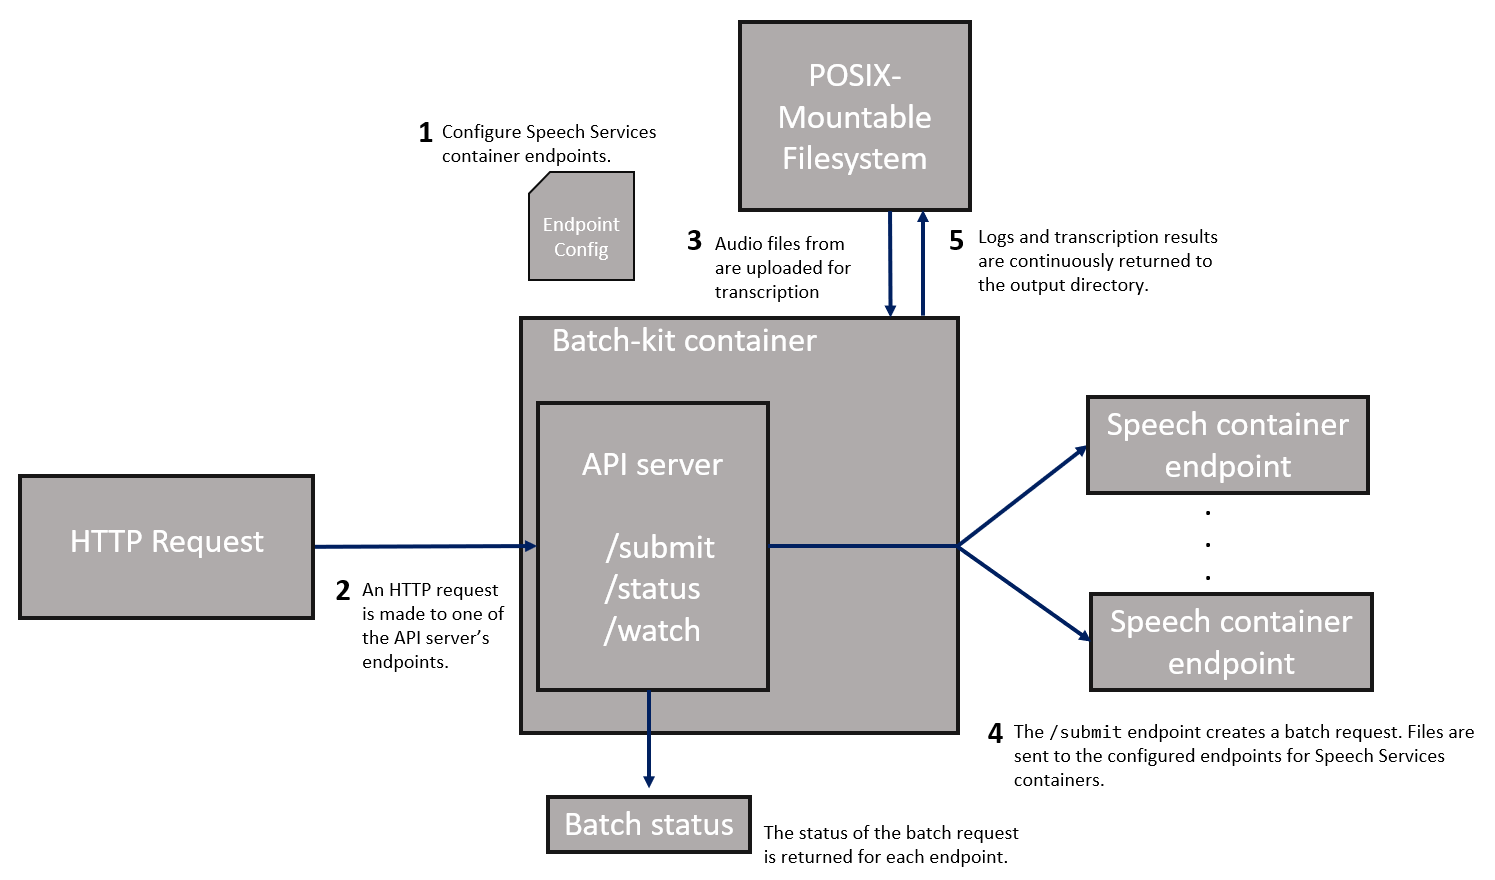
| Modalità di esecuzione | Eseguire il client batch una sola volta, in modo continuo in background o creare endpoint HTTP per i file audio. |
| Tolleranza di errore | Effettuare nuovi tentativi e continuare automaticamente la trascrizione senza perdere i progressi, distinguendo tra gli errori per cui effettuare nuovi tentativi e quelli per cui non è necessario. |
| Rilevamento della disponibilità degli endpoint | Se un endpoint non è più disponibile, il client batch continua la trascrizione, usando altri endpoint del contenitore. Quando il client è disponibile, inizia automaticamente a usare l'endpoint. |
| Swapping a caldo degli endpoint | Aggiungere, rimuovere o modificare gli endpoint del contenitore Voce durante il runtime senza interrompere l'avanzamento dell'elaborazione batch. Gli aggiornamenti sono immediati. |
| Registrazione in tempo reale | Registrare in tempo reale i tentativi di richieste, timestamp e motivi di errore, con i file di log dell'SDK di Voce per ogni file audio. |
Elaborare l'audio lungo in modo sicuro
I contenitori per il riconoscimento vocale supportano audio della durata massima di 24 ore. Segmentare qualsiasi audio più lungo di 24 ore prima di inviarlo per la trascrizione. Le dimensioni dei file non sono un sostituto affidabile per la durata perché la codifica, la frequenza di campionamento, la profondità di bit e il numero di canali determinano il numero di byte. Ad esempio, 1 GB non è una soglia di segmentazione universale.
Alcune pipeline audio usano un contatore a 32 bit per calcolare la durata. Dopo circa 37,3 ore, il contatore può andare in overflow e produrre una durata più breve, apparentemente valida. In questo caso, la trascrizione può segnalare l'esito positivo senza avvisare che il risultato viene troncato. Non è noto il punto esatto del codice in cui si verifica questo overflow.
Dopo la trascrizione, confronta la durata dell'audio originale con l'offset finale della trascrizione o con la marca temporale più recente riconosciuta. Considera un risultato che termina materialmente prima dell'audio di origine come incompleto, anche se la trascrizione segnala l'esito positivo.
Se si converte l'audio di origine in RIFF/WAV, usare questi valori per identificare dove si è verificato un overflow:
- Una lunghezza del blocco di dati WAV convertito pari a
274,568,704byte indica un overflow durante la conversione o la scrittura del file. - Una lunghezza di blocco di dati di
4,569,536,000byte o un file di dimensioni superiori a 4 GB con un'intestazione corretta indica che il file è stato scritto correttamente e che l'overflow si è verificato più avanti nella pipeline di elaborazione. Contattare il supporto tecnico Microsoft per coinvolgere il team di ingegneria in questo caso.
RF64 e Wave64 (W64) non sono soluzioni immediate per questo problema. Ogni lettore e percorso di controllo della durata nella pipeline deve supportare il formato selezionato. Ad esempio, il modulo predefinito wave Python rifiuta i file RF64.
Ottenere l'immagine del contenitore con docker pull
Usare il comando docker pull per scaricare il contenitore del kit di elaborazione batch più recente.
Note
L'esempio seguente esegue il pull di un'immagine di contenitore pubblico da Docker Hub. È consigliabile eseguire prima l'autenticazione con l'account Docker Hub (docker login) invece di effettuare una richiesta pull anonima. Per migliorare l'affidabilità quando si usa contenuto pubblico, importare e gestire l'immagine in un registro Azure Container privato.
Altre informazioni sull'uso di immagini pubbliche.
docker pull docker.io/batchkit/speech-batch-kit:latest
Configurazione dell'endpoint
Il client batch usa un file di configurazione YAML che specifica gli endpoint del contenitore locale. Scrivere l'esempio seguente in /mnt/my_nfs/config.yaml, usato negli esempi seguenti.
MyContainer1:
  concurrency: 5
  host: 192.168.0.100
  port: 5000
  rtf: 3
MyContainer2:
  concurrency: 5
  host: BatchVM0.corp.redmond.microsoft.com
  port: 5000
  rtf: 2
MyContainer3:
  concurrency: 10
  host: localhost
  port: 6001
  rtf: 4
Questo esempio YAML specifica tre contenitori voce in tre host. Il primo host viene specificato da un indirizzo IPv4, il secondo host viene eseguito nella stessa macchina virtuale del client batch e il terzo contenitore viene specificato dal nome host DNS di un'altra macchina virtuale. Il valore concurrency specifica il numero massimo di trascrizioni di file simultanee eseguibili nello stesso contenitore. Il valore rtf (Real-Time Factor) è facoltativo e può essere usato per ottimizzare le prestazioni.
Il client batch può rilevare dinamicamente se un endpoint diventa non disponibile (ad esempio, in seguito al riavvio di un contenitore o a causa di un problema di rete) e quando torna disponibile. Le richieste di trascrizione non vengono inviate ai contenitori non disponibili e il client continua a usare gli altri contenitori disponibili. È possibile aggiungere, rimuovere o modificare gli endpoint in qualsiasi momento senza interrompere l'avanzamento dell'esecuzione batch.
Eseguire il contenitore di elaborazione batch
Note
- Questo esempio usa la stessa directory (
/my_nfs) per il file di configurazione e le directory di input, output e log. Per queste cartelle è possibile usare directory ospitate o montate su NFS. - L'esecuzione del client con il flag
–helenca i parametri della riga di comando disponibili e i relativi valori predefiniti. - Il contenitore di elaborazione batch è supportato solo in Linux.
Usare il comando Docker run per avviare il contenitore. Questo comando avvia una shell interattiva all'interno del contenitore.
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs --entrypoint /bin/bash /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest
Per eseguire il client batch:
run-batch-client -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs -file_log_level DEBUG -nbest 1 -m ONESHOT -diarization None -language en-US -strict_config
Per eseguire il client batch e il contenitore in un singolo comando:
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs
Il client viene avviato. Se un file audio è stato trascritto in un'esecuzione precedente, il client ignora automaticamente il file. In caso di errori temporanei, viene effettuato un nuovo tentativo automatico di invio dei file ed è possibile distinguere gli errori per cui si desidera che il client effettui nuovi tentativi. In caso di errore di trascrizione, il client continua la trascrizione e può riprovare senza perdere lo stato di avanzamento.
Modalità di esecuzione
Il kit di elaborazione batch offre tre modalità, mediante il parametro --run-mode.
La modalità ONESHOT trascrive un singolo batch di file audio (da una directory di input e un elenco di file facoltativo) in una cartella di output.
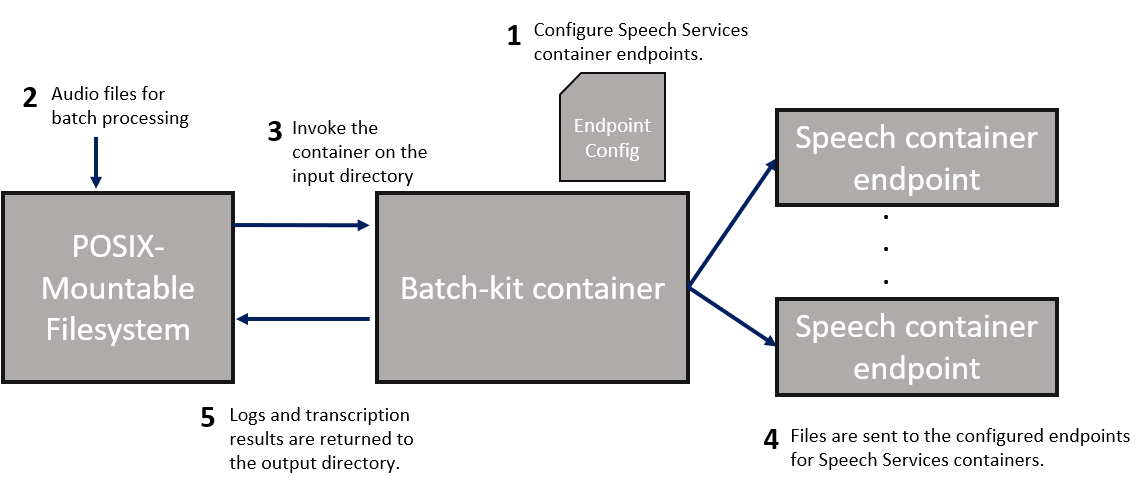
- Definire gli endpoint del contenitore Voce usati dal client batch nel file
config.yaml. - Inserire i file audio per la trascrizione in una directory di input.
- Richiamare il contenitore nella directory per iniziare l'elaborazione dei file. Se il file audio è già trascritto in un'esecuzione precedente con la stessa directory di output (stesso nome file e checksum), il client ignora il file.
- I file vengono inviati agli endpoint del contenitore del passaggio 1.
- I log e l'output del contenitore Voce vengono restituiti alla directory di output specificata.
Registrazione
Note
Il client batch può sovrascrivere periodicamente il file run.log se le dimensioni diventano eccessive.
Il client crea un file run.log nella directory specificata dall'argomento -log_folder del comando docker run. I log vengono acquisiti al livello DEBUG per impostazione predefinita. Gli stessi log vengono inviati a stdout/stderr e filtrati in base agli argomenti -file_log_level o console_log_level. Questo log è necessario solo per il debug o per inviare una traccia all'assistenza. La cartella di registrazione contiene anche i log dell'SDK di Voce per ogni file audio.
La directory di output specificata da -output_folder contiene un file run_summary.json, che viene riscritto periodicamente ogni 30 secondi o ogni volta che vengono completate nuove trascrizioni. È possibile usare questo file per controllare lo stato di avanzamento man mano che il batch procede. Contiene anche le statistiche di esecuzione finale e lo stato finale di ogni file al termine del batch. Il batch viene completato quando il processo termina correttamente.