Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Creare e gestire tabelle di ricerca separate per i dati usati di frequente dalle applicazioni nelle query quando un archivio dati non fornisce indici secondari appropriati. Questo approccio migliora le prestazioni di lettura evitando analisi complete dei dati quando le query non usano la chiave primaria o la chiave di partizione.
Contesto e problema
Molti archivi dati organizzano i dati per una raccolta di entità usando la chiave primaria. Un'applicazione può usare questa chiave per individuare e recuperare i dati. La figura seguente mostra un esempio di archivio dati che contiene informazioni sui clienti organizzate in base alla chiave primaria, ID cliente.
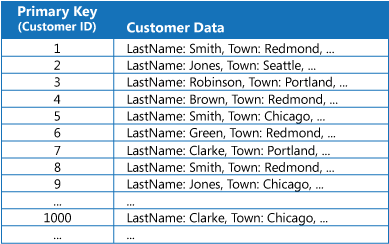
L'immagine mostra una tabella a due colonne di record dei clienti. La prima colonna, Chiave primaria (ID cliente), contiene ID cliente da 1 a 9 seguiti da puntini di sospensione, ID 1000 e altri puntini di sospensione. La seconda colonna, Customer Data, contiene i dati dei clienti costituiti da un cognome e una città seguiti da puntini di sospensione. Gli esempi visibili includono l'ID 1, che corrisponde al cognome Smith e alla città di Redmond, e l'ID 2, che corrisponde al cognome Jones e alla città di Seattle. Un'altra riga mostra Smith a Chicago, e un'altra mostra Smith a Redmond. Un'altra riga mostra Jones a Chicago.
Sebbene la chiave primaria sia utile per le query che recuperano i dati in base al valore di questa chiave, un'applicazione che deve recuperare i dati in base ad altri campi non può usare la chiave primaria per tale query. Nell'esempio dei clienti un'applicazione non può usare la chiave primaria ID cliente per recuperare i clienti se sottopone a query i dati facendo riferimento solamente al valore di qualche altro attributo, ad esempio la città in cui si trova il cliente. Per eseguire una query che fa riferimento solo alla città, l'applicazione potrebbe dover recuperare ed esaminare ogni record cliente, che può essere un processo lento.
Molti sistemi di gestione di database relazionali supportano gli indici secondari. Un indice secondario è una struttura di dati separata organizzata da uno o più campi chiave non primari (secondari). Un indice secondario indica dove vengono archiviati i dati per ogni valore indicizzato. In genere, gli elementi in un indice secondario sono ordinati in base al valore delle chiavi secondarie per consentire una ricerca rapida dei dati. Il sistema di gestione dei database gestisce in genere questi indici automaticamente.
I database relazionali consentono a più indici secondari di supportare vari modelli di query. Ad esempio, in una tabella Customers in un database relazionale in cui l'ID cliente è la chiave primaria, è utile aggiungere un indice secondario nel campo Città se l'applicazione cerca frequentemente i clienti in base alla città in cui risiedono.
Anche se gli indici secondari sono comuni nei sistemi relazionali, non tutti gli archivi dati forniscono una funzionalità equivalente. Alcuni archivi dati non contengono indici secondari, mentre altri forniscono indici che non soddisfano i requisiti di query, partizionamento o prestazioni di un carico di lavoro. In questi casi, le applicazioni devono scegliere tra analisi complete e gestione manuale degli indici.
Soluzione
Creare una tabella di indice che organizza i dati in base a una chiave specificata. Nella sezione seguente vengono descritte tre strategie comuni per strutturare una tabella di indice. Le due sezioni successive descrivono gli usi per le tabelle di indice in scenari specifici.
Strategie di strutturazione standard
Le strategie seguenti vengono comunemente usate per strutturare una tabella di indice. Scegliere una strategia in base al numero di indici secondari richiesti dallo scenario e alla natura delle query eseguite dall'applicazione.
Denormalizzazione completa
La denormalizzazione completa duplica i dati in ogni tabella di indice, ma lo organizza in base alle chiavi diverse dalla chiave primaria. La figura seguente mostra le tabelle di indice che organizzano le stesse informazioni sui clienti in base a Town e LastName.

Questa strategia funziona bene per i carichi di lavoro con un numero elevato di operazioni di lettura in cui i dati cambiano raramente. Man mano che aumenta la frequenza di aggiornamento, la gestione di ogni copia comporta un sovraccarico di elaborazione (vedere Complessità della coerenza). Per i set di dati con volumi elevati, l'archiviazione delle copie può richiedere spazio significativo.
Indice normalizzato
Una tabella di indice normalizzata organizza i dati in base alle chiavi diverse dalla chiave primaria. La tabella di indice normalizzata fa riferimento ai dati originali usando la chiave primaria anziché duplicare i dati, come illustrato nella figura seguente. I dati originali sono chiamati tabella dei fatti.
Tip
In questo caso, la tabella dei fatti indica la tabella di origine autorevole a cui fa riferimento un indice. Non implica un modello di dati dimensionale.

Questa tecnica consente di risparmiare spazio e riduce il sovraccarico della gestione dei dati duplicati. Lo svantaggio è che un'applicazione deve eseguire due operazioni di ricerca per trovare i dati usando una chiave secondaria. L'applicazione deve trovare la chiave primaria per i dati nella tabella dell'indice e quindi usare la chiave primaria per cercare i dati nella tabella dei fatti.
Denormalizzazione parziale
La denormalizzazione parziale crea tabelle di indice che duplicano campi recuperati di frequente e sono organizzate in base a chiavi diverse dalla chiave primaria. Viene fatto riferimento alla tabella dei fatti per accedere a campi a cui si accede meno frequentemente. La figura seguente mostra come i dati a cui si accede comunemente vengono duplicati in ogni tabella dell'indice.

Questa strategia bilancia i primi due approcci. È possibile recuperare rapidamente i dati per le query comuni usando una singola ricerca, mentre lo spazio e il sovraccarico di manutenzione non sono significativi quanto la duplicazione dell'intero set di dati.
Chiavi composte
Alcune applicazioni eseguono spesso query sui dati specificando una combinazione di valori, ad esempio "Trovare tutti i clienti che risiedono in Redmond e che hanno un cognome di Smith". In questo caso, creare chiavi di indice da più attributi, ad esempio gli attributi Town e LastName in questo caso.
Usare una codifica che mantiene i limiti dei componenti in modo che diverse combinazioni di valori non possano produrre la stessa chiave. Se le query dipendono dall'ordine delle chiavi, assicurarsi anche che la codifica mantenga l'ordinamento richiesto in base alle regole di confronto delle chiavi dell'archivio dati.
La figura seguente mostra una tabella di indice basata su chiavi composite. Le chiavi vengono ordinate per Town e quindi per LastName per i record con lo stesso valore per Town.
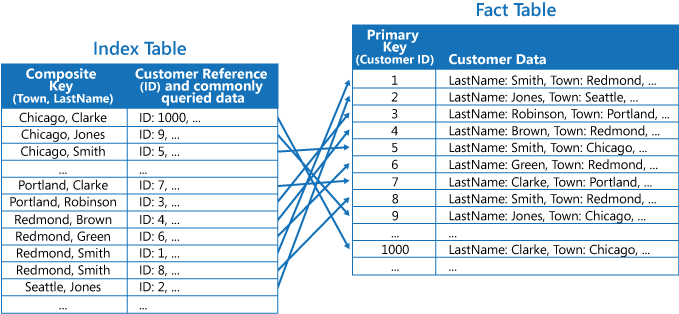
Il diagramma contiene una tabella di indice a sinistra e una tabella dei fatti a destra. La tabella dei fatti organizza i dati dei clienti in base alla chiave primaria, ID cliente. Ogni riga Dati cliente contiene un cognome del cliente, una città e un puntino di sospensione che indica altri dati. La tabella di indice è organizzata in base a una chiave composta che combina Town e LastName. La seconda colonna, Riferimento cliente (ID) e i dati richiesti più frequentemente, contiene un ID cliente e un'ellissi. Le frecce si estendono dalle righe della tabella di indice alla tabella dei fatti, con ogni freccia che punta alla riga ID cliente a cui fa riferimento tale voce di indice. Le frecce incrociate illustrano che le voci ordinate in base alla chiave composita possono fare riferimento a righe cliente in posizioni diverse nella tabella dei fatti.
Tabelle di indici su dati suddivisi in shard
Le tabelle di indice possono velocizzare le operazioni di query sui dati partizionati. Sono particolarmente utili quando viene eseguito l'hashing della chiave di partizione. La figura seguente mostra un esempio in cui la chiave di partizione è un hash dell'ID cliente. La tabella di indicizzazione organizza le voci in base ai valori non sottoposti ad hashing, Town e LastName, e memorizza per ciascuna voce la corrispondente chiave shard con hash.
Questa disposizione supporta ricerche ordinate e di intervallo sui valori non hash, fornendo al tempo stesso le informazioni di routing necessarie per recuperare ogni record dalla partizione corretta. Ad esempio, una query come "Trova tutti i clienti che risiedono in Redmond" può individuare gli elementi corrispondenti in un blocco contiguo nella tabella dell'indice. L'applicazione segue quindi i riferimenti ai dati del cliente usando le chiavi di partizione archiviate nella tabella dell'indice.

Problemi e considerazioni
Quando si decide come implementare questo modello, tenere presente quanto segue:
Sovraccarico di manutenzione. La gestione degli indici secondari può comportare un sovraccarico significativo. Analizzare e comprendere le query usate dall'applicazione. Creare tabelle di indice solo quando è probabile che vengano usate regolarmente. Non creare tabelle di indici speculative per supportare le query che un'applicazione non esegue o esegue solo occasionalmente. Man mano che cresce il numero di pattern di query, cresce anche il numero di tabelle di indice, ciascuna delle quali aumenta la complessità operativa da monitorare, gestire e sottoporre a debug. Soppesa il beneficio in termini di query di ogni tabella di indici rispetto al costo operativo associato al mantenimento di un'altra struttura di dati derivata. Esaminare periodicamente le tabelle di indicizzazione esistenti per identificare e rimuovere quelle che non vengono più interrogate.
Costi di archiviazione e velocità di trasmissione. La duplicazione dei dati in una tabella di indice aumenta i costi di archiviazione in proporzione al numero di tabelle di indice e alle dimensioni dei campi copiati. Anche la gestione di più copie dei dati comporta un impegno. Ogni operazione di scrittura in una tabella di indici consuma capacità di throughput, ad esempio in termini di transazioni rispetto ai limiti dell'account di archiviazione in Archiviazione tabelle di Azure o di unità di richiesta in Azure Cosmos DB. Il costo non riguarda solo l'archiviazione, ma anche il throughput in scrittura.
Doppia penalità di ricerca. L'implementazione di una tabella dell'indice come una struttura normalizzata che fa riferimento ai dati originali richiede che un'applicazione esegua due operazioni di ricerca per trovare i dati. La prima operazione fa una ricerca nella tabella dell'indice per recuperare la chiave primaria, mentre la seconda usa la chiave primaria per recuperare i dati.
Complessità della coerenza. Se un sistema incorpora una serie di tabelle di indice su set di dati di grandi dimensioni, la coerenza tra le tabelle di indice e i dati originali può essere difficile. Se i dati di origine e le voci di indice non possono essere aggiornati nella stessa transazione, progettare l'applicazione in base a un modello di coerenza finale. Registrare ogni modifica all’origine in modo duraturo prima di confermare la scrittura. Ad esempio, utilizzare un flusso di modifiche del database, usare il pattern Transactional Outbox per scrivere un record nella outbox nella stessa transazione della modifica ai dati di origine oppure accodare un comando prima di modificare i dati di origine. Nell'approccio basato su comandi, usa un worker per elaborare il comando e aggiornare i dati di origine e i relativi indici. Non aggiornare i dati di origine e quindi pubblicare in modo indipendente un messaggio di aggiornamento dell'indice, perché un errore tra tali operazioni può lasciare non aggiornato l'indice.
Progettare il consumer asincrono in modo che sia idempotente, perché il recapito dei messaggi e i tentativi di ritrasmissione possono fare sì che lo stesso aggiornamento venga eseguito più di una volta. Anche gli aggiornamenti per lo stesso record di origine possono arrivare in ordine non corretto. Includere una versione di origine o un numero di sequenza in ogni aggiornamento dell'indice e applicare un aggiornamento solo se è più recente della versione nell'indice. Per le eliminazioni, conservare un tombstone con versione o un limite massimo equivalente, in modo che un aggiornamento meno recente arrivato in ritardo non possa ricreare la voce dell’indice eliminata. Durante l'intervallo tra la scrittura dei dati di origine e l'aggiornamento dell'indice asincrono, le query sulla tabella di indice possono restituire riferimenti non aggiornati ai record aggiornati o eliminati nei dati di origine e possono omettere record aggiunti di recente.
Partizionamento delle tabelle degli indici. Le tabelle di indice possono a loro volta essere partizionate o suddivise tramite sharding, il che aggiunge complessità al routing delle query e richiede che la strategia di partizionamento sia allineata ai pattern di query che l'indice è progettato per supportare.
Quando usare questo modello
Usare questo modello quando un'applicazione deve spesso recuperare i dati usando una chiave diversa dalla chiave primaria (o partizione) e l'archivio dati non supporta in modo nativo gli indici secondari o i relativi indici nativi non soddisfano i requisiti di query, partizionamento o prestazioni del carico di lavoro.
Questo modello potrebbe non essere adatto quando:
I dati sono volatili. I dati cambiano così frequentemente che la frequenza di scrittura supera la frequenza con cui è possibile aggiornare in modo asincrono le tabelle degli indici. La finestra di obsolescenza aumenta finché l'indice non diventa permanentemente non aggiornato, rendendolo inefficace e facendo sì che il sovraccarico di archiviazione e di capacità effettiva necessario per mantenere la tabella dell'indice superi qualsiasi risparmio nelle query.
Sono presenti chiavi non discriminanti. Un campo selezionato come chiave secondaria per una tabella di indice non èscriminabile e può avere solo un piccolo set di valori, ad esempio un campo booleano che registra se un elemento è attivo. La tabella di indice comporta costi completi di archiviazione e di throughput, ma offre una selettività minima delle query.
I valori dei dati hanno una distribuzione asimmetrica. Il bilanciamento dei valori dei dati per un campo selezionato come chiave secondaria per una tabella di indice è altamente asimmetrico. Ad esempio, se il 90% dei record contiene lo stesso valore in un campo, la creazione e la gestione di una tabella di indice per cercare i dati in base a questo campo potrebbero creare un sovraccarico maggiore rispetto all'analisi sequenziale dei dati. Tuttavia, se le query puntano spesso a valori che rientrano nel restante 10%, questo indice può comunque essere utile.
Progettazione del carico di lavoro
Un architetto deve valutare come usare il modello di tabella degli indici nella progettazione del carico di lavoro per soddisfare gli obiettivi e i principi trattati nei pilastri di Azure Well-Architected Framework. La tabella seguente fornisce indicazioni su come questo modello supporta gli obiettivi di ogni pilastro.
| Pilastro | Come questo modello supporta gli obiettivi di pilastro |
|---|---|
| L'affidabilità consente al carico di lavoro di soddisfare le proprie destinazioni di resilienza e ripristino creando ridondanza e preservando le funzionalità durante gli errori. | La manutenzione asincrona degli indici può impedire che gli errori temporanei di aggiornamento degli indici blocchino le scritture di dati di origine. L'elaborazione idempotente, la gestione dei messaggi non recapitabili, il monitoraggio e la riconciliazione consentono di ripristinare la coerenza dell'indice dopo gli errori. - RE:07 Autoconservazione - RE:10 Monitoraggio |
| l'efficienza delle prestazioni consente al carico di lavoro soddisfare in modo efficiente le richieste tramite ottimizzazioni di ridimensionamento, dati e codice. | Le tabelle degli indici consentono di abilitare ricerche rapide nei campi chiave non primaria senza richiedere analisi complete dei dati. Per gli archivi dati shardati, le tabelle di indice possono organizzare le voci in base a valori non sottoposti ad hashing per supportare query per intervallo e di ordinamento che la sola chiave di partizione non è in grado di supportare in modo efficiente. - PE:05 Ridimensionamento e partizionamento - Prestazioni dei dati PE:08 |
Come per qualsiasi decisione di progettazione, se questo modello introduce compromessi all'interno di un pilastro, considerarli rispetto agli obiettivi degli altri pilastri.
Example
Si consideri un'applicazione che archivia informazioni sui film. Si supponga che il catalogo sia di grandi dimensioni e soggetto principalmente a operazioni di lettura, che ogni film abbia un genere primario, che le query sugli attori siano frequenti, che i dati del cast cambino di rado e che un breve ritardo nell'aggiornamento dell'indice sia accettabile. Table Storage archivia ogni entità come un insieme strutturato di proprietà con nome. Ogni entità include un PartitionKey, un RowKey e un timestamp e le entità nella stessa tabella possono avere insiemi di proprietà diversi.
Archiviazione tabelle usa una chiave primaria composita costituita da PartitionKey e RowKey. Il PartitionKey valore determina la partizione in cui viene archiviata un'entità. All'interno di una partizione, il RowKey valore identifica in modo univoco un'entità. L'archiviazione tabelle è ottimizzata per le query che specificano entrambe le chiavi o recuperano un intervallo contiguo di valori di chiave di riga all'interno di una partizione.
Tip
L'archiviazione tabelle supporta gli aggiornamenti transazionali per le entità all'interno della stessa tabella e della stessa partizione tramite transazioni di gruppo di entità. Una transazione non può estendersi su una tabella dei fatti e una tabella di indice separata. Per aggiornare atomicamente un'entità fact e le entità di indice, memorizzale nella stessa tabella con lo stesso PartitionKey. Le transazioni del gruppo di entità sono limitate a 100 entità per batch con un payload massimo di 4 MiB.
Per questo esempio, creare una tabella Azure con partizioni per ogni genere usando un identificatore di genere codificato come chiave di partizione e un identificatore di film stabile e univoco come chiave di riga. Memorizza i nomi dei generi e dei film come proprietà. Nella figura seguente vengono usati nomi leggibili al posto degli identificatori per semplificare il completamento dell'esempio.

Questo approccio è meno efficace se l'applicazione deve anche interrogare i film in base all'attore protagonista. In tal caso, creare una tabella di Azure separata che funge da tabella di indice. Usare un identificatore di attore stabile codificato come chiave di partizione e l'identificatore del film come chiave di riga. Archiviare i nomi degli attori e dei film come proprietà. Nella figura seguente vengono usati nomi leggibili al posto degli identificatori. Se in un film recita più di un attore, lo stesso film compare in più partizioni.
La figura seguente mostra la tabella indice degli attori.

Procedura dettagliata per la progettazione
La tabella film usa genere come chiave di partizione, il che significa che le query che filtrano in base al genere vengono eseguite in modo efficiente durante l'analisi delle partizioni su intervalli di chiavi di riga contigui. Tuttavia, l'archiviazione tabelle supporta solo un singolo indice clusterizzato su PartitionKey e RowKey. Non ha indici secondari. Una query come "trovare tutti i film con un attore specifico" richiede un'analisi completa della tabella in ogni partizione di genere, che è costosa su larga scala.
La tabella dell'indice degli attori ovvia a questa limitazione invertendo il modello di accesso. Ogni identificatore di attore diventa una chiave di partizione e ogni identificatore di film diventa una chiave di riga, quindi le query basate sull’attore si risolvono in efficienti ricerche nella partizione. Poiché ogni partizione contiene solo i film di un attore, la query restituisce un intervallo contiguo di entità senza analizzare dati non correlati.
Poiché le voci relative a film e attori utilizzano tabelle e chiavi di partizione separate, queste voci non possono condividere una transazione di gruppo di entità. Mantenere l'indice degli attori tramite un meccanismo asincrono e persistente di acquisizione delle modifiche e progettare l'applicazione in modo che tolleri un breve ritardo nell'aggiornamento delle query.
La tabella dell'indice applica la denormalizzazione parziale: ogni voce duplica campi di accesso comune ,ad esempio i nomi di altri attori, in modo che le query più frequenti possano essere risposte dalla tabella di indice da sole con una singola ricerca. Per i campi a cui si accede meno frequentemente, la voce include la chiave di partizione del genere dalla tabella originale dei film, consentendo una query puntuale mirata alla partizione del genere per recuperare il record completo. Questa progettazione bilancia la velocità delle query rispetto ai costi di archiviazione e al sovraccarico di manutenzione.
Passaggi successivi
Linee guida per la progettazione di query di Table Storage descrive i modelli di indici secondari che usano
PartitionKeyeRowKey, compresi gli approcci per archiviare le voci di indice nella stessa partizione o in partizioni separate.Le strategie di partizionamento dei dati illustrano come selezionare chiavi di partizione e riga in base a modelli di query, distribuzione dei dati, requisiti delle transazioni e obiettivi di scalabilità.
Le strategie di architettura per ottimizzare le prestazioni dei dati forniscono indicazioni per la valutazione di modelli di query, indici, partizioni e requisiti di monitoraggio.
I livelli di coerenza in Azure Cosmos DB descrivono i modelli di coerenza rilevanti quando si mantengono le tabelle degli indici in Azure Cosmos DB.
Risorse correlate
I modelli seguenti possono essere rilevanti anche quando si implementa questo modello:
Modello di partizionamento orizzontale. Il pattern della tabella di indice viene spesso utilizzato insieme a dati partizionati tramite shard. Il modello di partizionamento orizzontale descrive come dividere un archivio dati in un set di partizioni.
Modello della vista materializzata. Anziché indicizzare i dati per supportare query che riepilogano i dati, può essere più appropriato creare una vista materializzata dei dati. Questo modello descrive come generare viste prepopolate sui dati per supportare query di riepilogo efficienti.
Modello Outbox transazionale. Usare il modello Outbox transazionale per pubblicare le modifiche per la manutenzione asincrona degli indici in modo affidabile quando non è possibile aggiornare i dati di origine e le voci di indice in un'unica transazione.