Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Esplora dati di Azure (ADX) è una piattaforma di analisi completamente gestita per l'analisi in tempo reale dei dati di telemetria e dei log su larga scala. Questo articolo illustra il modo in cui i costi per GB inseriti vengono calcolati in Esplora dati di Azure, quali fattori lo determinano e come ottimizzare il cluster per un'efficienza dei costi. Le piattaforme di analisi dei Big Data usano modelli di determinazione prezzi diversi. Molte piattaforme si basano sui prezzi in base a fattori come volume di query, inserimento dati, durata dell'archiviazione e risorse di calcolo. Questa complessità rende difficile confrontare i prezzi tra i prodotti.
Per comprendere il costo dell'uso di Azure Data Explorer, questo articolo utilizza la metrica del costo per GB ingerito. Questa metrica è il costo totale del cluster (calcolo, archiviazione, rete e markup del servizio) diviso per i dati di dimensioni originali totali inseriti durante tale periodo.
Uno snapshot rappresentativo dei cluster ADX nel giugno 2025 viene usato per basare l'analisi di esempio. Le sezioni seguenti illustrano i risultati principali dell'analisi, illustrano quali sono le variazioni dei costi e come gli utenti possono ottimizzare i costi per GB inseriti senza compromettere le prestazioni.
Annotazioni
- Tutte le cifre sui costi in questo articolo mostrano i prezzi di listino e non includono sconti o risparmi basati sull'impegno.
- Ai fini di questa analisi di esempio, il costo per GB è espresso in Unità di costo di esempio (SCU), dove ogni SCU rappresenta un'unità di costo generica, ad esempio un centesimo uscente.
- Per i prezzi di listino e come calcolarli, vedere Calcolatore prezzi di Esplora dati di Azure.
Analisi dei costi per GB ingestiti
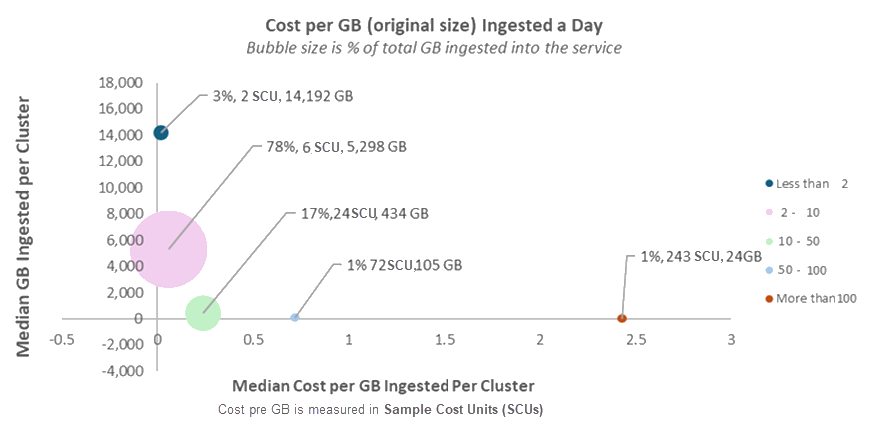
Il grafico seguente mostra i GB giornalieri medi ingeriti nelle dimensioni originali (asse Y) in relazione al costo mediano per GB ingeriti (asse X) per ogni gruppo di costi. Le dimensioni delle bolle rappresentano la quota del gruppo dei dati acquisiti nel servizio.
I costi per GB inseriti variano in base ai cluster, ma diversi modelli si distinguono:
La maggior parte dei dati (>75%) viene inserita a un costo tra 2 e 10 SCU per GB (prima degli sconti).
Meno di 5% dei dati sono inseriti a meno di 2 SCU per GB.
Anche all'interno della stessa categoria di utilizzo (o "bolla"), si noterà una variazione significativa. Ad esempio, nella bolla più grande, un cluster consuma 2 SCU per GB, mentre un altro raggiunge 10 SCU per GB. Questa è una differenza 5X. Le sezioni successive illustrano i motivi principali per questa variante.
I cluster con costi più elevati per GB sono meno comuni e in genere hanno volumi di inserimento inferiori. In generale, i volumi di dati più piccoli indicano un costo più elevato per GB.
Importante
Il grafico a bolle mostra che i costi per GB inseriti variano in base ai cluster. Questa variante non indica procedure consigliate o non valide. Riflette diversi scenari, configurazioni e modelli di utilizzo per il servizio.
Ad esempio, un cluster potrebbe conservare i dati più a lungo per la conformità, aumentando i costi di archiviazione. Un altro potrebbe usare criteri di aggiornamento che elaborano i dati durante l'inserimento, generando così un utilizzo di calcolo. Questi scenari sono scelte di progettazione intenzionali allineate a obiettivi specifici e influiscono naturalmente sul costo per GB.
Cosa influisce sul costo per GB di dati inseriti
Questi fattori chiave sono alla base delle variazioni del costo per GB inseriti per cluster:
Durata dell'archiviazione: più a lungo si archiviano i dati, maggiore è il costo. Vedere i criteri di conservazione.
Utilizzo elevato della CPU: azioni come query pesanti, elaborazione dati o trasformazioni causano un utilizzo elevato della CPU.
Impostazioni della cache: la memorizzazione nella cache aumenta le prestazioni dei dati, ma può aumentare i costi. Vedere Criteri di cache.
Utilizzo dei dati freddi: le query che accedono a questi dati avviano transazioni di lettura e aumentano i costi. Vedere cache calda e fredda.
Trasformazione e ottimizzazione dei dati: funzionalità come i criteri di aggiornamento, le viste materializzate e il partizionamento usano le risorse della CPU e possono aumentare i costi. Vedere criteri di aggiornamento, viste materializzate e partizioni.
Volume di inserimento: i cluster operano in modo più conveniente in volumi di inserimento più elevati.
Streaming vs. inserimento in coda: a seconda del caso d'uso, ciascuno ha un diverso profilo di costo. Vedere streaming e in coda.
Progettazione dello schema: le tabelle wide con molte colonne necessitano di più risorse di calcolo e archiviazione, che comportano un aumento dei costi.
Funzionalità avanzate: opzioni come follower, endpoint privati e sandbox Python usano più risorse e possono aggiungersi ai costi.
Scelta della pipeline di dati: alcuni percorsi di inserimento costano meno. Ad esempio, l'inserimento di Griglia di eventi è in genere più economico rispetto a Hub eventi.
Scalabilità automatica: i cluster senza scalabilità automatica spesso costano di più perché non modificano le dimensioni in base alla domanda.
È possibile configurare la maggior parte di questi fattori per ottimizzare le prestazioni e i costi.
Un'analisi più attenta dei fattori chiave dei costi
Questa sezione illustra i fattori chiave che influenzano il costo per GB inseriti in Esplora dati di Azure, fornendo informazioni dettagliate su come gestire e ottimizzare questi costi.
Impatto sulla conservazione dei dati sui costi
In ADX tutti i dati inseriti vengono archiviati nell'archiviazione permanente. Ogni tabella e vista materializzata dispone di criteri di conservazione che definiscono per quanto tempo vengono conservati i dati. Più i dati vengono conservati, maggiore è il costo, in base ai prezzi di Archiviazione di Azure. Quando è necessaria l'archiviazione a lungo termine, ad esempio per la conformità, il costo per GB inserito aumenta perché include spese di archiviazione in corso.
Oltre alle dimensioni dell'extent segnalate dal cluster, esistono due driver di costo aggiuntivi:
- Buffer di conservazione: per impostazione predefinita vengono archiviati 7 giorni di dati aggiuntivi per evitare perdite accidentali di dati.
- Overhead di recuperabilità: per le tabelle in cui l'impostazione di ripristinabilità è abilitata (impostazione predefinita), i dati vengono conservati per altri 14 giorni. Sono inclusi i BLOB intermedi generati durante le operazioni di merge e ricompilazione.
Dimensione del cluster
Le dimensioni del cluster sono il numero di computer (nodi) nel cluster. Ogni macchina aggiunge costi, a seconda del tipo (SKU). La scalabilità automatica regola le dimensioni del cluster in base all'utilizzo della CPU, in modo che il sistema possa ottimizzare i costi e le prestazioni evitando risorse inattive o ridondanti.
La scalabilità automatica regola le dimensioni del cluster per garantire che i dati memorizzati nella cache si adattino allo spazio SSD disponibile. Di conseguenza, una cache di grandi dimensioni può aumentare le dimensioni del cluster e, se l'utilizzo della CPU è basso, questo può comportare un costo maggiore per GB. Per altre informazioni sull'ottimizzazione delle dimensioni della cache, vedere lo strumento Informazioni dettagliate cluster della scheda Cache.
I cluster che eseguono molte query o svolgono attività che richiedono un uso intensivo della CPU, come le viste materializzate, le politiche di aggiornamento o il partizionamento, possono far scalare il cluster, aumentando il costo per GB. Si noti che queste funzionalità possono aumentare significativamente le prestazioni delle query e ridurre l'utilizzo della CPU delle query e quindi migliorare l'efficienza complessiva.
Volume di dati inseriti
Man mano che un cluster aumenta, vengono aggiunti più nodi, aumentando il costo totale. Questo costo viene distribuito in tutti i dati inseriti, quindi più dati vengono inseriti, minore è il costo per GB.
Utilizzo dei dati a bassa frequenza di utilizzo
Quando le query accedono frequentemente ai dati ad accesso sporadico archiviati su disco, causano transazioni di lettura che usano più risorse e possono aumentare il costo complessivo del cluster.
Streaming e inserimento in coda
Ogni metodo di inserimento ha caratteristiche di costo, latenza e funzionalità diverse, quindi ognuna è migliore per scenari diversi. Per i costi, l'inserimento in streaming è più economico quando si inseriscono molte tabelle di piccole dimensioni con dati complessi, mentre l'inserimento in coda è più conveniente per le tabelle di grandi dimensioni.
Suggerimento
Ottimizzare il costo per GB inserito
Controllare le configurazioni dei principali driver di costo per assicurarsi che siano in base alle esigenze del cluster e ai requisiti di servizio per garantire l'efficienza. In particolare:
- Ridurre al minimo le query sui dati freddi per ridurre le transazioni di lettura.
- Abilitare la scalabilità automatica per associare dinamicamente le dimensioni del cluster alla domanda.