Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Importante
Questa funzionalità è in versione beta.
La memoria gestita degli agenti conferisce ai tuoi agenti una memoria duratura e a lungo termine che persiste tra le conversazioni. Azure Databricks memorizza la memoria in Lakebase e gestisce per te l'archiviazione, l'indicizzazione e la ricerca semantica, così i tuoi agenti possono ricordare le preferenze degli utenti, le decisioni passate e il contesto accumulato senza che tu debba gestire un database.
Note
Durante la fase di anteprima, ti viene addebitato il costo dell'istanza Lakebase sottostante che memorizza le voci della memoria. Non sono previsti costi aggiuntivi per la memoria degli agenti gestiti in quanto tale. I prezzi possono variare man mano che l'anteprima procede.
Usa la memoria gestita quando vuoi che i tuoi agenti:
- Ricorda le preferenze, i fatti e le decisioni degli utenti nelle conversazioni separate.
- Personalizza le risposte in base a ciò che un agente ha appreso nelle sessioni precedenti.
- Condividi le conoscenze accumulate tra agenti e progetti.
- Migliorare l'accuratezza e l'efficienza nel tempo.
La memoria gestita funziona con agenti basati su qualsiasi framework. Per una cronologia di conversazioni a breve termine all'interno di un'unica interazione, usa sessioni di agente gestito.
Requisiti
- Installa Python 3.10 o superiore, per usare l'SDK AgentKit. AgentKit SDK è il client Python di Databricks per le API degli agenti che utilizzano gli esempi sottostanti. Puoi anche chiamare l'API REST direttamente da qualsiasi linguaggio, senza bisogno di Python.
Funzionamento della memoria gestita
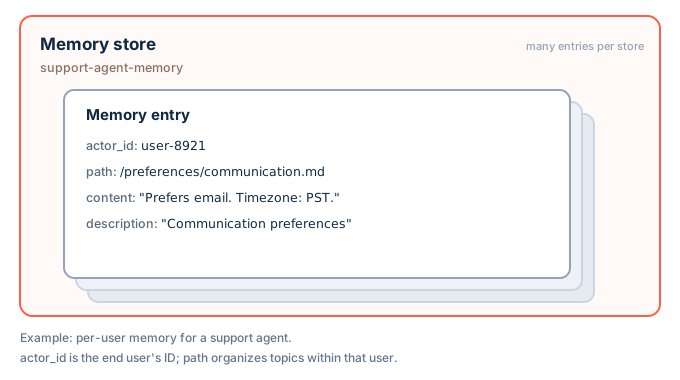
La memoria gestita ha due livelli:
- Un archivio delle memorie è il contenitore relativo all'area di lavoro per le memorie di un agente. Creare uno store fornisce automaticamente lo storage di supporto a Lakebase. Ti rivolgi a un negozio con il suo
display_name. - Una voce di memoria è un singolo contenuto presente in uno store. Ogni voce contiene un testo
contentlibero, una brevedescriptionstringa usata per il recupero e un insieme di campi che la organizzano e la suddividono:-
actor_id(richiesto): a chi appartiene la memoria, come un utente finale o un altro agente. -
session_id(opzionale): documenta da quale sessione è stata catturata la memoria, per tracciamento e provenienza. Lascialo non impostato per la memoria che non è legata a una sessione specifica. -
path(richiesto): un percorso simile a un filesystem che organizza gli elementi all'interno di un attore, come/preferences/response-style.md.
-
Un'entrata è identificata in modo unico dalla combinazione di actor_id, session_id, e path.
Recupero
Recupera la memoria in due modi:
-
Elenca le voci di un attore, facoltativamente filtrate per
session_ido un prefissopath. Usa questo per sfogliare o visualizzare un indice di ciò che un agente sa. - Cerca le voci relative a un attore con una query in linguaggio naturale. La ricerca restituisce le voci più rilevanti ordinate in base a un punteggio di pertinenza full-text (BM25).
Per iniziare
Questi esempi configurano la memoria gestita per un agente di supporto: creano uno store di memoria, salvano la preferenza dell'utente e la richiamano in una conversazione successiva. Scegli il cliente che si adatta al tuo progetto. Un display_name archivio di memoria deve essere composto da 3 a 56 caratteri, iniziare con una lettera minuscola, terminare con una lettera o un numero e contenere solo lettere minuscole, numeri e trattini.
AgentKit SDK
L'SDK AgentKit è il client Python di Databricks per le API degli agenti, distribuito nel databricks-agentbricks pacchetto. Si autentica con l'SDK di Databricks WorkspaceClient.
Installa l'SDK AgentKit:
pip install databricks-agentbricksCrea un archivio di ricordi per il tuo agente.
AgentKitClientAutenticazione con le tueWorkspaceClientcredenziali:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")Salva un ricordo dopo che l'agente ha imparato qualcosa di duraturo su un utente.
actor_idindica a chi appartiene questa memoria,pathla organizza all'interno di tale attore edescriptionmigliora il recupero:memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )Ricorda i ricordi dell'utente in una conversazione successiva con una ricerca in lingua naturale:
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)
REST API
I client chiamano l'API REST sotto /api/2.0/agents/memory-stores. Chiamalo direttamente per i linguaggi diversi da Python.
Genera un token OAuth con la CLI Databricks:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Crea un archivio di ricordi per il tuo agente:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"display_name": "support-agent-memory", "description": "Support agent memory"}'
Salva una voce nella memoria per un utente.
actor_idindica di chi è questa memoria,pathla organizza edescriptionmigliora il recupero:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'Ricorda i ricordi dell'utente con una ricerca in lingua naturale:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"actor_id": "user-123", "query": "communication preferences"}'
Dai al tuo agente strumenti di memoria
Per permettere a un agente di decidere quando salvare e richiamare memoria, avvolgi le operazioni client come strumenti e istruisci l'agente su quando usarle nel suo prompt di sistema. Imposta il actor_id codice dell'applicazione attendibile dall'identità verificata dell'utente finale. Non lasciare mai che il modello scelga quale memoria leggere o in quale scrivere.
Il seguente esempio racchiude l'SDK memory_store AgentKit di Get Started come strumenti per l'SDK degli Agenti OpenAI.
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user."""
        memory_store.add(actor_id=actor_id, path=path, content=content, description=description)
        return f"Saved memory at {path}"

    return [search_memory, save_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences and recall them when relevant.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
Lo stesso schema funziona con l'SDK Claude Agent e altri framework: avvolge le operazioni di ricerca e aggiunta dello store come tipo di strumento del framework.
Partizione e memoria sicura
All'interno di un negozio, actor_id serve a separare a chi appartengono i ricordi. Ogni elenco e ricerca è limitato a un solo actor_idparametro, quindi scegli la strategia che corrisponde a ciò che il tuo agente deve ricordare:
-
Memoria privata per ogni utente: Imposta
actor_idsull'identità verificata dell'utente finale. Ogni utente ha la propria partizione e l'agente recupera solo gli elementi di quell'utente.- Esempio: Un agente di supporto ricorda le preferenze di comunicazione di un utente e i ticket passati.
-
Memoria condivisa per un gruppo: Imposta
actor_idsu una chiave fissa che scegli, come un ID di team, progetto o organizzazione. Tutti leggono e scrivono gli stessi ricordi.- Esempio: Un agente di team ricorda un glossario condiviso di termini aziendali e convenzioni interne.
-
Memoria divisa da qualcos'altro: Costruisci
actor_iddai tuoi valori, come un tenant ID o unuser:projectcomposite.-
Esempio: Un'app multi-tenant imposta
actor_idsu{tenant}:{user}in modo che gli utenti di ciascun cliente rimangano isolati gli uni dagli altri.
-
Esempio: Un'app multi-tenant imposta
Imposta actor_id nel codice dell’applicazione dal contesto di un chiamante attendibile: l’identità verificata dell’utente finale per la memoria per utente oppure una chiave attendibile del team o del progetto per la memoria condivisa. Non lasciare mai che sia il modello a sceglierlo. Se la tua strategia dipende dall'identità dell'utente finale, rifiuta le richieste che non ne includono una invece di ripiegare su un actor_id condiviso.
Avvertimento
actor_id separa i ricordi, ma non è un controllo di accesso. Gli archivi di memoria gestiti sono limitati all’area di lavoro, quindi qualsiasi identità che possa accedere a un archivio può leggere e scrivere qualsiasi voce di tutti gli attori. Il negozio, non l'attore, è il confine di sicurezza. Per garantire un rigoroso isolamento tra tenant o utenti, crea un archivio di memoria separato per ciascun limite di isolamento.
Per consentire a un altro principal, ad esempio il service principal del tuo agente, di usare uno store, concedigli l’accesso tramite l’operazione grant-permission dello store (memory_store.grant_permission(principal_id) nell’SDK AgentKit).
Limitations
- La memoria gestita fornisce solo la memoria a lungo termine. Per la cronologia delle conversazioni a breve termine, vedi sessioni con agenti gestiti.
- La ricerca è un'operazione full-text (BM25) ordinata per rilevanza che restituisce un insieme dei primi N risultati, fino a un massimo di 100 elementi. Non supporta la paginazione né la ricerca per similarità vettoriale.
- Il controllo degli accessi è applicato a livello di negozio. Il controllo degli accessi per voce e per attore non è disponibile.
- Il negozio
display_nameè immutabile dopo la creazione. Solodescriptionpuò essere aggiornato.