Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Le metriche degli endpoint di AI Search riportano stato di salute, frequenza di query, latenza, errori per sorgente e tasso di ingestione per le ultime 169 ore. Utilizza queste metriche per monitorare gli endpoint ed eseguire il debug dei problemi. Visualizza le metriche nella scheda Metriche dell'endpoint, oppure recuperale con l'API REST, la CLI di Databricks o l'SDK di Databricks.
Usa le metriche endpoint per:
- Scopri se le query fallite provengono dall'endpoint del modello di embedding o da AI Search.
- Vedi perché le query restituiscono errori 429 (Troppe richieste).
- Controlla se le scritture in un indice avvengono contemporaneamente a picchi di latenza o errori.
Requirements
- Un endpoint di ricerca di intelligenza artificiale. Vedere Creare endpoint e indici di ricerca di intelligenza artificiale.
- Permesso per visualizzare l'endpoint. Vedere ACL degli endpoint di ricerca di intelligenza artificiale.
- Per utilizzare API, CLI o SDK, è necessaria l'autenticazione al tuo spazio di lavoro. Vedere Protezione dei dati e autenticazione.
Visualizza le metriche nell'interfaccia utente
Per visualizzare le metriche di un endpoint:
- Nella barra laterale sinistra fare clic su Calcolo.
- Fai clic sulla scheda AI Search , quindi clicca sul nome dell'endpoint.
- Nella pagina endpoint, fai clic sulla scheda Metriche .
- Seleziona un intervallo di tempo: Ultimi 15 minuti, Ultima ora, Ultime 6 ore, Ultimo giorno o Ultima settimana.
La scheda Metriche mostra i seguenti grafici:
| Chart | Cosa mostra |
|---|---|
| Stato di integrità | Lo stato di salute dell'endpoint nel tempo. |
| Concorrenza dell'endpoint | La concorrenza allocata per l'endpoint. |
| Richieste al secondo | Query al secondo, per percorso (ottimizzato e non ottimizzato). |
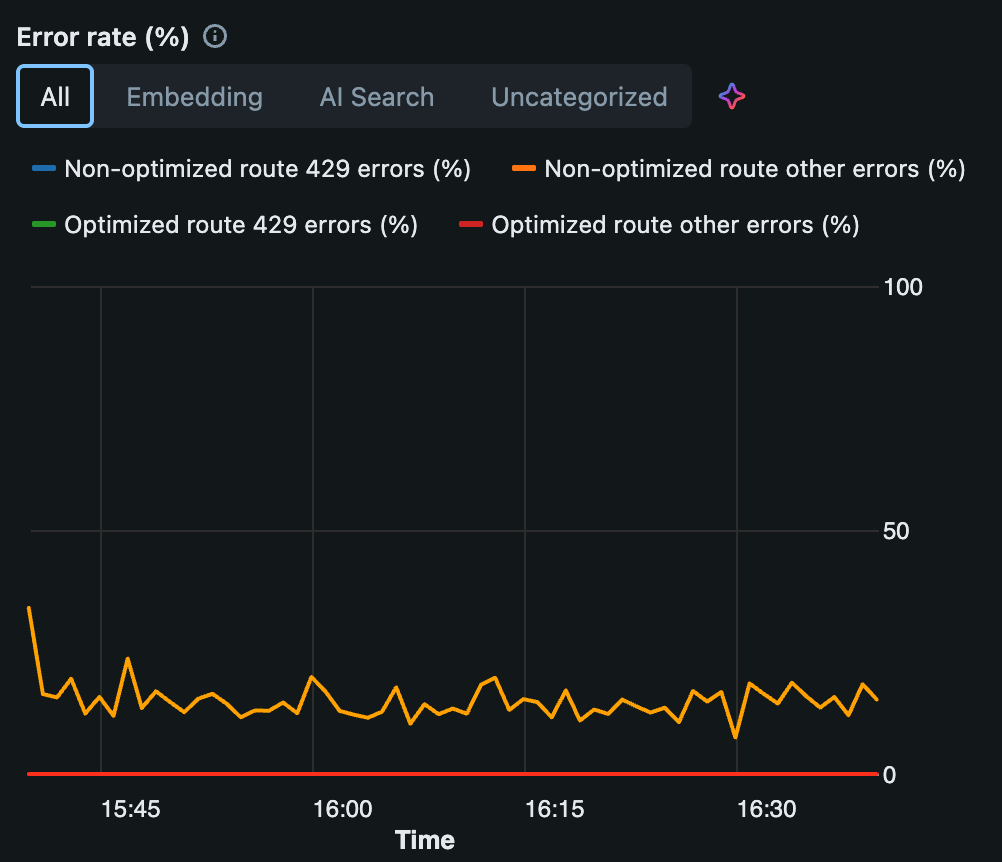
| Tasso di errore (%) | La percentuale di query che hanno restituito errori, inclusi 429 errori. Usa il filtro sorgente per vedere da dove provengono gli errori. Consulta "Filtra errori per sorgente". |
| Latenza della richiesta (ms) | Latenza delle query a p50 e p99, per percorso. Usa il filtro per tipo di query per mostrare query ANN,Hybrid o Full-text . |
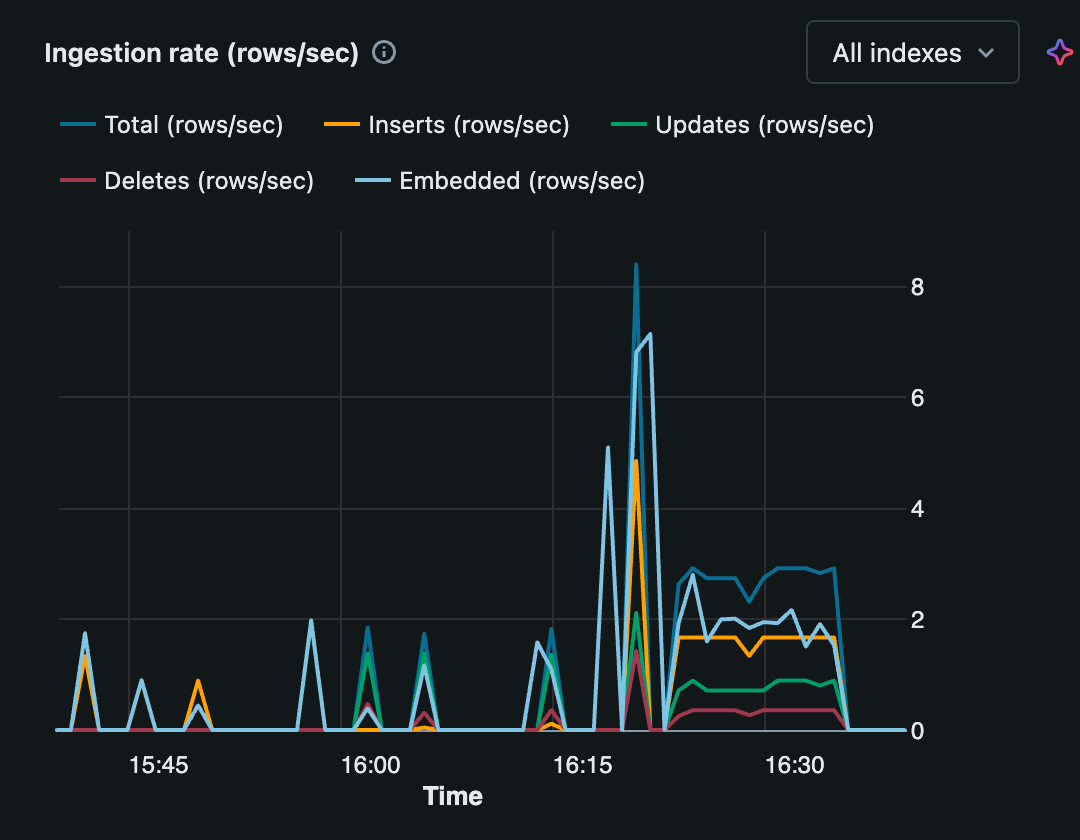
| Tasso di ingestione (righe/sec) | Righe scritte agli indici dell'endpoint al secondo, per operazione. Solo gli endpoint standard. Vedi Leggi la velocità di ingestione. Quando l'endpoint ha due o più indici, usa il filtro indice per mostrare un indice. |
L'immagine seguente mostra il grafico Tasso di errore (%) con il filtro della sorgente degli errori.
Filtra gli errori per sorgente
Nel grafico Tasso di errore (%), filtra per fonte di errore:
- Tutti: ogni richiesta fallita.
- Embedding: la chiamata all'endpoint del modello di embedding non è riuscita.
- AI Search: il fallimento è stato causato dall'endpoint AI Search o dalla richiesta stessa, come un filtro non valido o un errore di autorizzazione.
- Non categorizzato: la fonte del guasto non è stata segnalata. Questo può accadere su endpoint ottimizzati per lo storage, ad esempio quando una query va in timeout.
Gli errori verificatisi prima che il tracciamento sorgente fosse disponibile compaiono solo sotto All.
Leggi la velocità di ingestione
Il grafico Tasso di ingestione (righe/sec) mostra le righe scritte negli indici dell'endpoint tramite pipeline di sincronizzazione e tramite upsert e cancellazioni dirette:
- Inserimenti, Aggiornamenti e Cancellazioni: righe scritte, per operazione. Questi includono aggiornamenti che non modificano una riga e cancellazioni di righe che non esistono.
- Totale: la somma degli inserimenti, degli aggiornamenti e delle cancellazioni.
- Incluse: righe incluse per indici Delta Sync che utilizzano embedding gestiti da Databricks. Se una sincronizzazione si riavvia, le stesse righe contano di nuovo. Le righe incorporate non fanno parte di Total.
Una frequenza di 0 righe al secondo significa che non sono avvenute scrizioni in quell'intervallo. Non significa che l'indice sia aggiornato, e le scritture piccole e poco frequenti potrebbero non comparire.
L'immagine seguente mostra il grafico del tasso di ingestione (righe/sec) per un endpoint con indici Delta Sync.
Recupera le metriche con l'API
AI Search (precedentemente Vector Search) mantiene il nome Vector Search nel percorso API delle metriche, nel gruppo di comandi CLI e nel servizio Databricks SDK. Per recuperare le metriche in modo programmatico, invia una POST richiesta a /api/2.0/vector-search/endpoints/{name}/metrics. Il corpo della richiesta contiene:
-
start_time(obbligatorio): l'inizio dell'intervallo temporale, come timestamp RFC 3339. Deve essere nelle ultime 169 ore. -
end_time: la fine dell'intervallo temporale, come timestamp RFC 3339. Il valore predefinito è l'ora corrente. -
granularity_in_seconds: l'intervallo tra i punti dati. Il minimo è 60. Vedere Limitazioni. -
metrics: l'elenco delle metriche da restituire. Ogni voce ha unname, opzionalelabels, e, per la latenza, unpercentile. Vedi Metriche disponibili.
Ogni etichetta ha una name e una value. Il value è un'espressione regolare, non una corrispondenza esatta. Un'etichetta filtra il risultato e lo divide per quell'etichetta, quindi un valore di .+ restituisce una serie per ciascun valore dell'etichetta.
Il seguente esempio serve curl a restituire le query fallite al secondo in una finestra di un'ora, con una serie per ciascuna fonte di errore:
curl -X POST "https://<workspace-url>/api/2.0/vector-search/endpoints/my-endpoint/metrics" \
  -H "Authorization: Bearer $DATABRICKS_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "start_time": "2026-11-06T20:00:00Z",
    "end_time": "2026-11-06T21:00:00Z",
    "granularity_in_seconds": 60,
    "metrics": [
      {
        "name": "IndexRequestErrorSourceCount",
        "labels": [{ "name": "error_source", "value": ".+" }]
      }
    ]
  }'
La risposta contiene una voce in metric_values per ogni serie. Ogni timestamp è in secondi dall'epoca Unix:
{
  "metric_values": [
    {
      "metric": {
        "name": "IndexRequestErrorSourceCount",
        "labels": [{ "name": "error_source", "value": "EMBEDDING" }]
      },
      "values": [
        { "timestamp": 1793995200, "value": 0.0 },
        { "timestamp": 1793995260, "value": 1.5 }
      ]
    }
  ]
}
Il seguente esempio utilizza l'SDK Databricks per Python per restituire la latenza di query p99 per l'ultimo giorno:
from datetime import datetime, timedelta, timezone

from databricks.sdk import WorkspaceClient
from databricks.sdk.service.vectorsearch import Metric

w = WorkspaceClient()
end = datetime.now(timezone.utc)
start = end - timedelta(days=1)

response = w.vector_search_endpoints.retrieve_user_visible_metrics(
    name="my-endpoint",
    start_time=start.isoformat(),
    end_time=end.isoformat(),
    granularity_in_seconds=300,
    metrics=[Metric(name="IndexRequestLatency", percentile=0.99)],
)

for series in response.metric_values:
    print(series.metric.labels, series.values[-1])
Il databricks-ai-search pacchetto Python non include un metodo metrics. Utilizza l'SDK Databricks, la CLI Databricks o l'API REST.
Il seguente esempio utilizza la CLI Databricks per restituire le righe ingerite al secondo, con una serie per ogni operazione. Passa le metriche con --json:
databricks vector-search-endpoints retrieve-user-visible-metrics my-endpoint --json '{
  "start_time": "2026-11-06T00:00:00Z",
  "metrics": [
    {
      "name": "IndexIngestedRows",
      "labels": [{ "name": "operation", "value": ".+" }]
    }
  ]
}'
L'API non pagina. Il campo page_token della richiesta viene ignorato e la risposta non include un next_page_token. Ogni risposta restituisce tutti i punti dati in un'unica pagina.
Metriche disponibili
Metriche degli endpoint
Le metriche endpoint descrivono l'endpoint nel suo insieme e non accettano etichette.
| Metrica | Unità | Description |
|---|---|---|
EndpointHealthStatus |
Codice di stato | Lo stato endpoint: 0 PROVISIONING, 1 ONLINE, 2 OFFLINE, 3 NOT_READY, 4 RED_STATE, 5 YELLOW_STATE, 6 DELETED, 7 STOPPING, 8 STOPPED, 9 STARTING. |
EndpointConcurrency |
Conteggio | La concorrenza allocata per l'endpoint. |
Metriche di query
Le metriche di query coprono solo le richieste di query.
| Metrica | Unità | Description |
|---|---|---|
IndexRequestCount |
Richieste al secondo | Il tasso di interrogazione. |
IndexRequestLatency |
Millisecondi | Latenza delle query. Richiede percentile: uno di 0.5, 0.75, 0.9, 0.95, o 0.99. |
Entrambe le metriche accettano queste etichette:
-
request_path:NETWORK_OPTIMIZED_ROUTE(percorso ottimizzato) oppureHIGH_LATENCY_ROUTE(percorso non ottimizzato). La risposta contiene una serie per ciascun percorso. -
query_type:ANN,HYBRID, oppureFULL_TEXT. -
response_code: il codice di stato HTTP, come200o429. -
index_name: il nome completo dell'indice.
Metrica sorgente di errore
| Metrica | Unità | Description |
|---|---|---|
IndexRequestErrorSourceCount |
Query non riuscite al secondo | Query non riuscite, in base all'origine dell'errore. |
L'etichetta error_source contiene questi valori:
| Value | Nome dell'interfaccia utente | Meaning |
|---|---|---|
EMBEDDING |
Embedding | La chiamata all'endpoint del modello di embedding è fallita. |
VECTOR_SEARCH |
AI Search | Il fallimento è stato dovuto all'endpoint AI Search o alla richiesta stessa. Usare response_code per separare gli errori del chiamante come 400 o 403 da errori dell'endpoint. |
UNATTRIBUTED |
Non categorizzato | La causa del guasto non è stata segnalata. Questo può accadere su endpoint ottimizzati per lo storage, ad esempio quando una query va in timeout. |
Questa metrica accetta anche le etichette response_code, request_path, query_type e index_name.
metriche guida 429
Le metriche di guida 429 si applicano agli endpoint standard.
| Metrica | Unità | Description |
|---|---|---|
IndexRequestGuidanceCount |
Richieste al secondo | Query, in base alla causa di eventuali errori 429. |
IndexRequestGuidancePeakRate |
Richieste al secondo | La frequenza di richiesta di punta oraria sulla rotta non ottimizzata (HIGH_LATENCY_ROUTE). Esclude il traffico dei percorsi ottimizzati e non accetta etichette. |
IndexRequestGuidanceCount accetta l'etichetta failure_cause . Per una risposta diversa da 429, il valore è NONE. Per una risposta 429, il valore è uno di:
| Value | Meaning |
|---|---|
REJECTED |
L'endpoint ha respinto la query perché la sua coda di richieste era piena. |
CIRCUIT_BREAKER |
L'endpoint è rimasto a corto di memoria e ha respinto la query. |
CAPACITY_BLOCK |
L'endpoint o l'indice ha superato la sua capacità. |
PAGINATION |
Troppi contesti di paginazione aperti. |
EMBEDDING_LIMIT |
L'endpoint del modello di embedding ha applicato un limite di frequenza alla query. |
UC_LIMIT |
La query ha raggiunto un limite di frequenza di Unity Catalog. |
TIMEOUT |
La query è andata in timeout a causa di sovraccarico, di una query lenta o del warmup. |
OTHER |
Qualsiasi altro errore 429. |
IndexRequestGuidanceCount accetta anche le auth_type etichette (OAUTH, TOKEN, , oppure OTHER), num_results_bucket (LE_10 o GT_10), request_path, query_type, e index_name le etichette.
Metriche di ingestione
Le metriche di ingestione sono disponibili solo per gli endpoint standard.
| Metrica | Unità | Description |
|---|---|---|
IndexIngestedRows |
Righe al secondo | Righe scritte dalle pipeline Delta Sync e da upsert e cancellazioni Direct Vector Access. Accetta l'etichetta operation (INSERT, UPDATE, oppure DELETE) e l'etichetta index_name . |
IndexEmbeddedRows |
Righe al secondo | Righe incorporate negli indici Delta Sync che utilizzano embedding gestiti da Databricks. Una riesecuzione conta di nuovo le stesse righe. Accetta l'etichetta index_name . |
Troubleshooting
Errori del modello di embedding
Se la sorgente di errore di Embedding aumenta, verifica l'endpoint del modello di incorporamento. Per instradare le query verso un endpoint dedicato o a throughput provisionato, vedi Risoluzione degli errori 429. Per evitare la chiamata di embedding nel percorso della query, passa query_vector invece di query_text.
Errori di AI Search
Se la sorgente di errore AI Search aumenta, suddividete IndexRequestErrorSourceCount per response_code. Un codice 4xx di solito significa che la richiesta non è valida o non autorizzata. Un codice 429 significa che la query era soggetta a limitazione della frequenza. Per trovare la causa, vedi Queries return 429 errors.
Le query restituiscono 429 errori
Dividi IndexRequestGuidanceCount per failure_cause.
EMBEDDING_LIMIT punta all'endpoint del modello di incorporamento.
REJECTED, CIRCUIT_BREAKER, e TIMEOUT possono indicare il carico dell'endpoint o la pressione delle risorse. Per la scalabilità del throughput, vedi Scalare il throughput dell'endpoint AI Search con QPS elevato.
Per CAPACITY_BLOCK, controlla l'errore relativo alla capacità dell'endpoint o dell'indice. Riduci il volume di dati indicizzati o contatta il supporto Databricks per aumentare la quota.
Se auth_type visualizza TOKEN, passa a autenticazione OAuth del service principal.
Latenza o errori aumentano durante le sincronizzazioni
Confronta il grafico del tasso di ingestione (righe/sec) con la latenza delle richieste (ms) e il tasso di errore (%). Se i picchi coincidono con le scritture, programma le sincronizzazioni fuori dalle ore di punta delle query o riduci il volume di scrittura.
Il grafico di ingestione non appare
Il grafico appare solo per gli endpoint standard. L'API restituisce is not supported for this endpoint type altri tipi di endpoint e is not available in this region nelle regioni in cui le metriche di ingestione non sono disponibili.
L'API restituisce is not a valid UserVisibleMetricType
Il nome della metrica è scritto in modo errato o non è disponibile. Un nome metrico non valido fa fallire l'intera richiesta, quindi rimuovilo e riprova.
Limitations
- Le metriche sono disponibili per le ultime 169 ore. Se
start_timeè più vecchio, la richiesta fallisce. - Il minimo
granularity_in_secondsè 60. Un intervallo di 1 minuto viene restituito solo per intervalli di tempo di 1 ora o meno. Per intervalli di tempo più lunghi, l'intervallo è di 5 minuti o più. - Una serie può contenere al massimo 10.080 punti dati. Se una richiesta supera questo limite, accorcia l'intervallo temporale o aumenta
granularity_in_seconds. - Le metriche di ingestione sono disponibili solo per gli endpoint standard. Non sono disponibili per endpoint ottimizzati per lo storage.