Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Il sdp-meta progetto di Databricks Labs fornisce strumenti per generare pipeline dai metadati gestiti.
Note
Il progetto open source sdp-meta, come tutti i progetti nell'account GitHub di databrickslabs, esiste solo a scopo di esplorazione. Azure Databricks non lo supporta né fornisce contratti di servizio per tale servizio. Non inviare ticket di supporto di Azure Databricks per problemi relativi a questo progetto. In alternativa, presenta una issue su GitHub, che verrà esaminata non appena possibile.
Cos'è sdp-meta?
Le pipeline di Lakeflow consentono di specificare in modo dichiarativo una tabella e generare un flusso in una pipeline che crea la tabella e lo mantiene aggiornato man mano che cambiano i dati di origine. Tuttavia, se l'organizzazione dispone di centinaia di tabelle, la generazione e la gestione di queste pipeline richiede molto tempo e può causare procedure incoerenti.
Il progetto sdp-meta è un framework di metaprogrammazione guidato dai metadati progettato per funzionare con pipeline Lakeflow. Questo framework consente l'automazione delle pipeline di dati bronze e silver sfruttando i metadati registrati in un set di file JSON e YAML. In tempo reale, pipeline generiche leggono i tuoi metadati e costruiscono dinamicamente i flussi descritti in essi. La lavorazione del bronzo e dell'argento può funzionare in condotte separate o insieme in una pipeline combinata. Generi i metadati sulle tue pipeline, e sdp-meta genera le tue pipeline.
Con la logica centralizzata in un'unica posizione (metadati), il sistema è più veloce, riutilizzabile e più facile da gestire.
Note
Il progetto sdp-meta era precedentemente chiamato dlt-meta, dal vecchio elemento Delta Live Tables in Azure Databricks.
Delta Live Tables è stato sostituito dalle pipeline Lakeflow e sdp-meta lavora con le pipeline Lakeflow. Se stai aggiornando un'installazione esistente dlt-meta , consulta la guida alla migrazione nella documentazione sdp-meta.
Vantaggi dell'sdp-meta
Ci sono due principali casi d'uso per sdp-meta:
- Inserire e pulire semplicemente un numero elevato di tabelle.
- Applicare gli standard di progettazione dei dati tra più pipeline e utenti.
I vantaggi dell'uso di un approccio basato sui metadati includono:
- La gestione dei metadati può essere eseguita senza conoscere il codice Python o SQL.
- La gestione dei metadati, anziché il codice, richiede meno overhead e riduce gli errori.
- Il codice è generato da sdp-meta, quindi rimane coerente e ha meno codice personalizzato tra pipeline e tabelle pubblicate.
- È possibile raggruppare facilmente le tabelle in pipeline all'interno dei metadati, generando il numero di pipeline necessarie per aggiornare i dati in modo più efficiente.
Come funziona sdp-meta
L'immagine seguente mostra una panoramica del sistema sdp-meta:
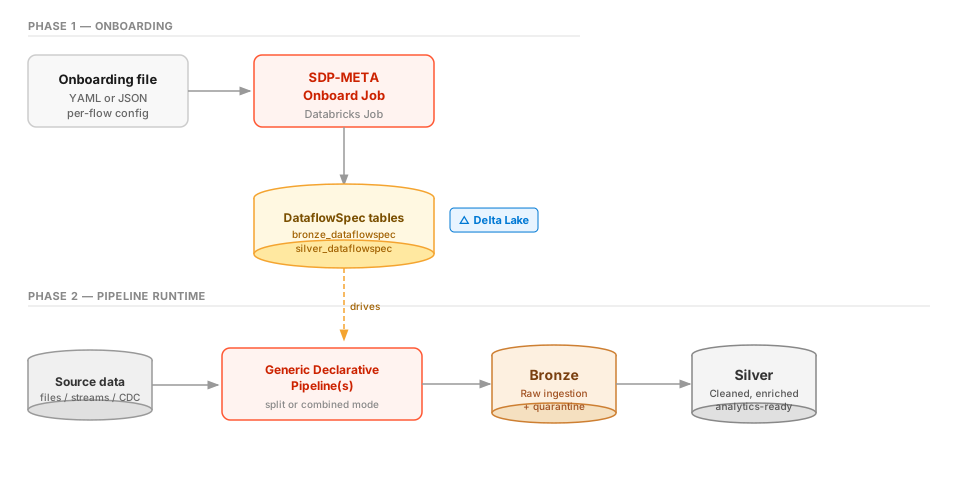
- Crei i file di metadati come input per sdp-meta, per specificare i file sorgente e output, le regole di qualità e l'elaborazione richiesta. Questi file di onboarding possono essere scritti in JSON o YAML.
- Gestisci il lavoro di onboarding sdp-meta. Il motore compila i file di onboarding in una specifica di flusso dati, chiamata DataflowSpec, e li memorizza nelle tabelle Delta (
bronze_dataflowspecesilver_dataflowspec) per un uso successivo. - In fase di esecuzione, una pipeline generica legge il DataflowSpec e costruisce dinamicamente il grafo di elaborazione bronze. Legge i tuoi dati sorgente (file, flussi o CDC) e applica le corrette aspettative di dati per corrispondere alle tue regole di qualità, generando le tabelle bronze e mettendo in quarantena i record che non rispettano tali regole.
- L'elaborazione Silver può essere eseguita in una pipeline generica separata, che è il predefinito per i Declarative Automation Bundles, oppure nella stessa pipeline quando si utilizza la modalità combinata. La pipeline utilizza il DataflowSpec per applicare le trasformazioni appropriate e altre elaborazioni, generando tabelle silver pulite, arricchite e pronte per l'analisi.
Esegui le pipeline generate da sdp-meta per mantenere l'output aggiornato man mano che i dati sorgente vengono aggiornati.
Get started
Per usare sdp-meta, devi:
- Distribuire e configurare la soluzione sdp-meta.
- Preparare i metadati per le tabelle dei livelli bronze e silver.
- Creare un processo per eseguire l'onboarding dei metadati.
- Usare i metadati per creare pipeline per le tabelle.
Il progetto sdp-meta supporta diverse interfacce di distribuzione: bundle (consigliato), una CLI interattiva, un'app Databricks con interfaccia grafica basata su browser, un server MCP per la configurazione assistita dall'IA e un Agent Skill portatile per agenti AI consapevoli delle competenze.
La documentazione sdp-meta su GitHub contiene un tutorial per aiutarti a iniziare questo processo. Per maggiori informazioni, vedi come iniziare con sdp-meta su GitHub.