Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Nella progettazione dei dati il backfilling si riferisce al processo di elaborazione retroattiva dei dati cronologici tramite una pipeline di dati progettata per l'elaborazione di dati correnti o di streaming.
In genere, si tratta di un flusso separato che invia dati alle tabelle esistenti. La figura seguente mostra un flusso di backfill che invia dati storici alle tabelle "bronze" nella pipeline.
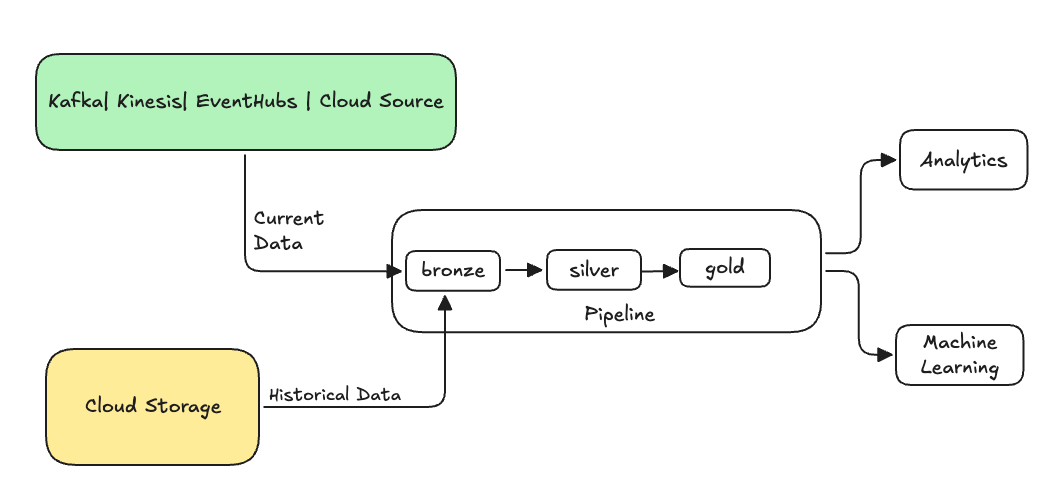
Alcuni scenari che potrebbero richiedere un backfill:
- Elaborare dati cronologici da un sistema legacy per eseguire il training di un modello di Machine Learning (ML) o creare un dashboard di analisi cronologica delle tendenze.
- Rielaborare un sottoinsieme di dati a causa di un problema di qualità dei dati con fonti di dati a monte.
- I requisiti aziendali sono stati modificati ed è necessario eseguire il backfill dei dati per un periodo di tempo diverso non coperto dalla pipeline iniziale.
- La logica di business è stata modificata ed è necessario rielaborare sia i dati cronologici che i dati correnti.
Il flusso di riempimento che usi dipende dalla tabella target e dai dati sorgente. Per un AUTO CDC target di dimensione a cambiamento lento (SCD) di Tipo 1 con una snapshot autorevole, si utilizza un flusso a una tantum AUTO CDC FROM SNAPSHOT . Per una migrazione SCD che riproduce cambiamenti storici, usa un flusso a una tantum AUTO CDC .
Per i backfill solo append: Usa un flusso di append specializzato con l'opzione ONCE per eseguire il backfill di una tabella di streaming solo append. Per altre informazioni sull'opzione, vedere append_flow o ONCE
Considerazioni sul riempimento dei dati storici in una tabella di streaming
- In genere, i dati vengono aggiunti alla tabella di streaming bronze. Gli strati d'argento e d'oro a valle captano i nuovi dati dallo strato di bronzo.
- Assicurarsi che la pipeline possa gestire correttamente i dati duplicati nel caso in cui gli stessi dati vengano accodati più volte.
- Verificare che lo schema dei dati cronologici sia compatibile con lo schema dei dati corrente.
- Considera la dimensione del volume di dati e l'accordo sul livello di servizio (SLA) richiesto e, di conseguenza, configura le dimensioni del cluster e dei batch.
Esempio: aggiungere un backfill a una pipeline esistente
In questo esempio, supponiamo di avere una pipeline che acquisisce dati di registrazione eventi non elaborati da un datore di archiviazione cloud, a partire dal 1 gennaio 2025. Poi ti rendi conto che vuoi popolare retroattivamente i dati storici dei tre anni precedenti per casi d'uso di reporting e analisi downstream. Tutti i dati si trovano in una posizione, partizionata per anno, mese e giorno, in formato JSON.
Pipeline iniziale
Ecco il codice iniziale della pipeline che inserisce in modo incrementale i dati grezzi di registrazione degli eventi dalla memoria cloud.
Pitone
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
incremental_load_path = f"{source_root_path}/*/*/*"

# create a streaming table and the default flow to ingest streaming events
@dp.table(name="registration_events_raw", comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2025-01-01T00:00:00.000+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}") # safeguard to not process data before begin_year
    )
SQL
-- create a streaming table and the default flow to ingest streaming events
CREATE OR REFRESH STREAMING LIVE TABLE registration_events_raw AS
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025'; -- safeguard to not process data before begin_year
In questo caso si usa l'opzione modifiedAfter Caricamento automatico per assicurarsi che non vengano elaborati tutti i dati dal percorso di archiviazione cloud. L'elaborazione incrementale viene interrotta in corrispondenza di tale limite.
Suggerimento
Altre origini dati, ad esempio Kafka, Kinesis e Hub eventi di Azure, hanno opzioni di lettura equivalenti per ottenere lo stesso comportamento.
Recuperare i dati dei 3 anni precedenti
Ora si vuole aggiungere uno o più flussi per il riempimento dei dati precedenti. In questo esempio seguire questa procedura:
- Usare il flusso
append once. In questo modo viene eseguito un backfill a singolo eseguimento senza continuare l'esecuzione dopo il primo backfill. Il codice rimane nella pipeline e, se la pipeline viene aggiornata completamente, il backfill viene eseguito nuovamente. - Creare tre flussi di backfill, uno per ogni anno (in questo caso i dati vengono suddivisi per anno nel percorso). Per Python viene parametrizzata la creazione dei flussi, ma in SQL viene ripetuto tre volte il codice, una volta per ogni flusso.
Se lavori su un tuo progetto e non utilizzi calcolo serverless, potresti voler aggiornare il numero massimo di lavoratori per la pipeline. L'aumento del numero massimo di lavoratori garantisce di disporre delle risorse per elaborare i dati cronologici continuando a elaborare i dati di streaming correnti all'interno dell'SLA previsto.
Suggerimento
Se si usa il calcolo serverless con scalabilità automatica avanzata (impostazione predefinita), le dimensioni del cluster aumentano automaticamente quando il carico aumenta.
Pitone
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
backfill_years = spark.conf.get("backfill_years") # e.g. "2024,2023,2022"
incremental_load_path = f"{source_root_path}/*/*/*"

# meta programming to create append once flow for a given year (called later)
def setup_backfill_flow(year):
    backfill_path = f"{source_root_path}/year={year}/*/*"
    @dp.append_flow(
        target="registration_events_raw",
        once=True,
        name=f"flow_registration_events_raw_backfill_{year}",
        comment=f"Backfill {year} Raw registration events")
    def backfill():
        return (
            spark
            .read
            .format("json")
            .option("inferSchema", "true")
            .load(backfill_path)
        )

# create the streaming table
dp.create_streaming_table(name="registration_events_raw", comment="Raw registration events")

# append the original incremental, streaming flow
@dp.append_flow(
        target="registration_events_raw",
        name="flow_registration_events_raw_incremental",
        comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2024-12-31T23:59:59.999+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}")
    )

# parallelize one time multi years backfill for faster processing
# split backfill_years into array
for year in backfill_years.split(","):
    setup_backfill_flow(year) # call the previously defined append_flow for each year
SQL
-- create the streaming table
CREATE OR REFRESH STREAMING TABLE registration_events_raw;

-- append the original incremental, streaming flow
CREATE FLOW
  registration_events_raw_incremental
AS INSERT INTO
  registration_events_raw BY NAME
SELECT * FROM STREAM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025';


-- one time backfill 2024
CREATE FLOW
  registration_events_raw_backfill_2024
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2024/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2023
CREATE FLOW
  registration_events_raw_backfill_2023
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2023/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2022
CREATE FLOW
  registration_events_raw_backfill_2022
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2022/*/*",
  format => "json",
  inferColumnTypes => true
);
Questa implementazione evidenzia diversi modelli importanti.
Separazione delle responsabilità
- L'elaborazione incrementale è indipendente da operazioni di backfill.
- Ogni flusso ha impostazioni di configurazione e ottimizzazione personalizzate.
- Esiste una chiara distinzione tra le operazioni incrementali e backfill.
Esecuzione controllata
- L'uso dell'opzione
ONCEgarantisce che ogni backfill venga eseguito esattamente una volta. - Il flusso di riempimento rimane nel diagramma della pipeline, ma diventa inattivo al termine. È pronto per l'uso immediato al termine del refresh completo, automaticamente.
- Esiste un chiaro audit trail delle operazioni di backfill nella definizione della pipeline.
Ottimizzazione dell'elaborazione
- È possibile suddividere il backfill grande in più backfill più piccoli per un'elaborazione più rapida o per controllarne l'elaborazione.
- L'uso della scalabilità automatica avanzata ridimensiona dinamicamente le dimensioni del cluster in base al carico del cluster corrente.
Evoluzione dello schema
- L'uso di
schemaEvolutionMode="addNewColumns"gestisce le modifiche dello schema in modo efficace. - L'inferenza dello schema è coerente tra i dati cronologici e correnti.
- Esiste una gestione sicura delle nuove colonne nei dati più recenti.
Aggiungi un backfill a una tabella AUTO CDC SCD Tipo 1
Utilizzare un flusso monouso AUTO CDC FROM SNAPSHOT per aggiungere uno snapshot autorevole a un target SCD Tipo 1 che riceve anche un feed continuo di Change Data Capture (CDC). La versione snapshot e la colonna di sequenziamento CDC formano un unico dominio di ordinazione. Un evento CDC più recente ha la precedenza su uno snapshot più vecchio, mentre uno snapshot più recente ha la precedenza su un evento CDC più vecchio.
Requirements
Prima di aggiungere il riempimento, assicurati che i flussi soddisfino i seguenti requisiti:
- La destinazione utilizza SCD Tipo 1.
- Il bersaglio ha esattamente un
AUTO CDC FROM SNAPSHOTflusso e uno o più flussiAUTO CDCcon nomi univoci. - Tutti i flussi usano lo stesso numero di chiavi nello stesso ordine. I nomi delle chiavi Snapshot-flow vengono confrontati senza distinzione tra maiuscole e minuscole con i nomi delle chiavi
AUTO CDCFlussi multipliAUTO CDCdevono utilizzare nomi chiave e casing identici. - La versione snapshot e ogni colonna di sequenziamento CDC hanno esattamente lo stesso tipo di dato.
- Il
AUTO CDC FROM SNAPSHOTflusso non definisce le aspettative. - I
AUTO CDCflussi non utilizzanoIGNORE NULL UPDATES. In Python, non impostareignore_null_updates,ignore_null_updates_column_list, oignore_null_updates_except_column_list. - Il pipeline utilizza la modalità attivata da trigger. Questo schema non supporta pipeline continue.
Entrambi i tipi di flusso possono utilizzare l'interfaccia di pipeline SQL o Python. Puoi mescolare flussi SQL e Python nello stesso target.
L'snapshot deve rappresentare lo stato completo della sorgente nella sua versione. Se una chiave target manca dallo snapshot, AUTO CDC FROM SNAPSHOT considera l'assenza come una cancellazione nella versione snapshot. Un evento CDC con una versione più recente preserva o ripristina la chiave.
Aggiungi il backfill
Per aggiungere un backfill snapshot una tantum e continuare a elaborare gli eventi CDC, utilizza i seguenti passaggi:
- Mantenere la tabella di destinazione esistente e i suoi
AUTO CDCflussi in corso nella definizione della pipeline. - Definisci lo snapshot autorevole e la sua versione. Per un callback in Python, la prima invocazione deve restituire uno snapshot e una versione. Restituire
Nonesolo dopo che almeno uno snapshot è stato elaborato. - Aggiungi un
AUTO CDC FROM SNAPSHOTflusso cononce=Truein Python oONCEin SQL. Per un backfill SQL in un target esistente, includere unaWITH VERSIONquery. Un flusso snapshot SQL senzaWITH VERSIONsupporta solo un caricamento iniziale in un target vuoto. - Esegui un aggiornamento della pipeline attivato per elaborare il backfill e gli eventi CDC in corso.
Il seguente esempio inizia con una pipeline Python esistente che elabora incrementalmente le modifiche da customers_cdc. Supponiamo di aver già eseguito questa pipeline e popolato il customers target:
from pyspark import pipelines as dp
from pyspark.sql.functions import col, expr

@dp.view
def customers_cdc():
    return (
        spark.readStream.table("main.bronze.customers_cdc")
        .withColumn("change_timestamp", col("change_timestamp").cast("timestamp"))
    )


dp.create_streaming_table("customers")

dp.create_auto_cdc_flow(
    name="customers_incremental_cdc",
    target="customers",
    source="customers_cdc",
    keys=["customer_id"],
    sequence_by=col("change_timestamp"),
    apply_as_deletes=expr("operation = 'DELETE'"),
    except_column_list=["operation", "change_timestamp"],
    stored_as_scd_type=1,
)
Per riempire quel target esistente con lo stato di customers_snapshot al 1° gennaio 2025, aggiungi il seguente codice alla stessa definizione di pipeline. Mantieni la tabella di destinazione e il flusso esistenti:
from datetime import datetime, timezone
from typing import Optional, Tuple

from pyspark.sql import DataFrame

backfill_version = datetime(2025, 1, 1, tzinfo=timezone.utc)


def backfill_snapshot_and_version(
    latest_snapshot_version: Optional[datetime],
) -> Optional[Tuple[DataFrame, datetime]]:
    if latest_snapshot_version is None:
        return (spark.read.table("main.legacy.customers_snapshot"), backfill_version)
    return None


dp.create_auto_cdc_from_snapshot_flow(
    target="customers",
    source=backfill_snapshot_and_version,
    keys=["customer_id"],
    stored_as_scd_type=1,
    once=True,
)
Il callback deve restituire uno snapshot e una versione alla sua prima invocazione. Se ritorna None prima che venga elaborato qualsiasi snapshot, l'aggiornamento della pipeline fallisce. Dopo l'elaborazione dello snapshot, la restituzione di None segnala che non sono disponibili ulteriori snapshot.
La versione snapshot è un oggetto Python datetime, che corrisponde al tipo Spark SQL TIMESTAMP. Il flusso esistente AUTO CDC esegue il cast di change_timestamp in TIMESTAMP in modo che i due tipi di sequenziamento corrispondano esattamente. L'esempio usa Python per entrambi i flow, ma puoi definire uno dei due flow in SQL e mescolare flussi SQL e Python nello stesso target. Per la sintassi SQL, inclusa la query richiesta WITH VERSION per un target non vuoto, vedi CREATE FLOW (pipelines).
Dopo che il flusso snapshot viene confermato con successo, gli aggiornamenti incrementali successivi lo saltano mentre il flusso AUTO CDC continua a elaborare nuovi eventi.
Important
Un aggiornamento completo del target riesegue il flusso di snapshot una tantum. Mantieni lo snapshot disponibile e assicurati che rappresenti ancora lo stato previsto prima di effettuare un aggiornamento completo.
Questo pattern unificato di backfill non supporta destinazioni SCD Tipo 2 o bitemporali.
Esempio: riempire un target SCD durante una migrazione
Uno scenario di migrazione comune è una tabella a dimensione che cambia lentamente (SCD) che già esiste in un sistema legacy con anni di storia accumulata, ma il cui feed di cambiamento originale non è più disponibile. Poiché gli eventi di cambiamento originali sono spariti, invece riproduci la storia della tabella legacy nel nuovo AUTO CDC target una volta, poi colleghi un nuovo feed CDC in futuro. Per maggiori informazioni sui AUTO CDC tipi di SCD, vedi The AUTO CDC APIs: Simplify change data capture with pipeline.
Il modello è un flusso una tantum AUTO CDC nella stessa tabella di streaming a cui è destinato il flusso continuo AUTO CDC. Una destinazione AUTO CDC accetta solo flussi AUTO CDC, quindi anche il seme deve essere un flusso AUTO CDC. Un semplice flusso di aggiunta INSERT INTO ONCE nella stessa tabella non supera la convalida:
-
Crea la tabella di destinazione per lo streaming in cui il tuo
AUTO CDCflusso scrive. -
Inizializza la cronologia legacy una sola volta con un
AUTO CDC ONCEflow che legge la tabella SCD legacy come uno stream, sequenziato in base alla colonna legacy di inizio validità. Riproduci le righe legacy come eventi di modifica invece di generarle tu stesso.AUTO CDCgenera le colonne di cronologia__START_ATe__END_ATper una destinazione SCD di tipo 2, quindi non scrivere direttamente tali colonne. -
Collega il flusso in esecuzione
AUTO CDCche legge il feed delle modifiche più recente.AUTO CDCgestisce l'ordinamento per chiave, quindi il cutover deve applicarsi a ciascuna chiave di business singolarmente: la prima modifica live di ogni chiave deve essere successiva all'ultima modifica inizializzata per quella stessa chiave. Un valore di sequenza appena successivo al massimo globale legacy può comunque essere obsoleto per una singola chiave, e il primo cambiamento live di quella chiave viene poi ignorato o ordinato in modo errato.
Il seguente codice crea una tabella di streaming che segue i passaggi sopra:
CREATE OR REFRESH STREAMING TABLE customers_history;

-- One-time seed: replay the legacy history as change events
CREATE FLOW customers_history_seed
AS AUTO CDC ONCE INTO customers_history
FROM stream(legacy.customers_scd2)
KEYS (customer_id)
SEQUENCE BY valid_from
STORED AS SCD TYPE 2;

-- Ongoing live CDC into the same target
CREATE FLOW customers_history_cdc
AS AUTO CDC INTO customers_history
FROM stream(customers_cdc_bronze)
KEYS (customer_id)
SEQUENCE BY change_timestamp
STORED AS SCD TYPE 2;
Entrambi i flussi devono concordare sulle loro chiavi, sul tipo SCD e sul tipo di dato della colonna di sequenziamento. Nell'esempio precedente, entrambi i flussi si sequenziano tramite un timestamp, che utilizza un singolo tempo di cutover per separare la cronologia seeded dal feed live. Se la sequenza legacy della tabella ha un valore di tipo diverso dal feed live, trasmettine una in modo che i tipi corrispondano.
Lo stesso schema funziona per un target SCD di tipo 1: sostituisci STORED AS SCD TYPE 2 con STORED AS SCD TYPE 1 in entrambi i flussi e il target mantiene solo la riga corrente per ogni chiave. Prima di fare affidamento su una delle due configurazioni, verifica, su un campione di chiavi, che la prima modifica in produzione per una chiave inizializzata produca esattamente una nuova versione e chiuda correttamente la versione precedente. Un gap di sequenza per tasto di solito appare in quel passaggio.
Risorse aggiuntive
- Caricare ed elaborare i dati in modo incrementale con i flussi della pipeline Lakeflow
- Utilizzare i flussi nelle pipeline di Lakeflow
- Le API AUTO CDC: semplificare la cattura dei dati di modifica con le pipeline
- append_flow
- create_auto_cdc_from_snapshot_flow
- create_auto_cdc_flow
- CREATE FLOW (pipeline)