Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Controllo di accesso
Le funzionalità sono oggetti del catalogo Unity gestibili. L'accesso CREATE FEATUREa una funzionalità è controllato dai privilegi del catalogo unity , READ FEATUREe MANAGE . Per le descrizioni complete, vedere Informazioni di riferimento sui privilegi del catalogo Unity.
-
CREATE FEATURE: Richiesto per creare una caratteristica in uno schema.create_featureeregister_featurerichiedereCREATE FEATUREsullo schema genitore. Seguendo il principio dei privilegi minimi, concedereCREATE FEATUREa livello di schema; è anche possibile concederlo a un catalogo per consentire la creazione di funzionalità in qualsiasi schema in tale catalogo. -
READ FEATURE: Richiesto per leggere i metadati delle funzionalità.get_feature,create_training_set, elist_materialized_featuresrichiedonoREAD FEATUREsulla caratteristica. Questo privilegio non concede l'accesso ai dati delle funzionalità nelle tabelle di output sorgente o materializzate. Per leggere quei dati per l'addestramento o il servizio, devi averliSELECTanche nelle tabelle applicabili.READ FEATUREConcesso su uno schema o catalogo si applica a tutte le caratteristiche attuali e future che contiene. -
MANAGE: Richiesto per gestire il ciclo di vita di una funzionalità e le sovvenzioni. Eliminare una caratteristica condelete_feature, e materializzare una caratteristica conmaterialize_features, richiedeMANAGEsulla caratteristica. Eliminare una caratteristica materializzata condelete_materialized_featurenon è regolata daMANAGE: solo il creatore della caratteristica materializzata può eliminarla.
Tutte le operazioni sulle funzionalità richiedono USE CATALOG anche nel catalogo padre e USE SCHEMA nello schema padre. Per informazioni su come MANAGE e READ FEATURE si applica alla materializzazione, vedere Autorizzazioni.
API Visualizzazione funzionalità
Feature costruttore e register_feature()
L'approccio consigliato consiste nel costruire un Feature oggetto in locale e usarlo register_feature per renderlo persistente in Unity Catalog. Questo flusso di lavoro in due passaggi consente di sperimentare le funzionalità (incluso create_training_set) prima di registrarle.
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() registra un locale costruito Feature nel Catalogo Unity.
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() valida, costruisce e registra immediatamente una funzionalità nel Catalogo Unity in un solo passaggio. Usare questa opzione quando non è necessario provare prima di tutto con la funzionalità in locale.
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
Parametri:
-
source: La sorgente dati utilizzata nel calcolo delle caratteristiche (DeltaTableSource,StreamSource,RequestSource, oFeatureViewSource). -
function: EAggregationFunctionche raggruppa un operatore e una finestra temporale,ColumnSelection("column_name")per caratteristiche pass-through oCustomUDFper trasformazioni riga a riga. Vedi Funzioni supportate per tipi di sorgente compatibili. -
catalog_name: Il nome del catalogo Unity per la rubrica. -
schema_name: Il nome dello schema del Catalogo Unity per la funzione. -
entity: Elenco dei nomi delle colonne che definiscono le chiavi di aggregazione o di ricerca (chiavi primarie). Richiesto perDeltaTableSourceeStreamSource. Ad esempio,["user_id"]aggrega o cerca per utente. Omettere perRequestSourceeFeatureViewSource. -
timeseries_column: La colonna timestamp usata per l'aggregazione della finestra temporale o la selezione del valore più recente. Richiesto perDeltaTableSourceeStreamSource. Omettere perRequestSourceeFeatureViewSource. -
name: Nome della funzione opzionale. Se omesso, generato automaticamente dalla colonna di input, dalla funzione e dalla finestra (ad esempio,amount_avg_rolling_7d). -
description: Descrizione opzionale della caratteristica.
Ritorni: Un'istanza di Feature validata
Aumenta: ValueError se una validazione fallisce
delete_feature()
Elimina una funzionalità dal catalogo unity in base al nome completo.
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
Prima di eliminare una funzionalità, rimuovere o aggiornare i modelli o le specifiche di funzionalità che vi fanno riferimento. Una funzione non può essere eliminata finché ha ancora delle funzionalità materializzate. Elimina prima le funzionalità materializzate, poi elimina la caratteristica. Vedere Come eliminare una funzionalità materializzata.
Nomi generati automaticamente
Quando name viene omesso, viene generato automaticamente un nome. I nomi generati seguono il modello : {column}_{function}_{window}. Per esempio:
-
price_avg_rolling_1h(prezzo medio di 1 ora) -
transaction_count_rolling_30d_1d(Conteggio di 30 giorni di transazione con ritardo di 1d dal timestamp dell'evento)
Funzioni supportate
Funzione di aggregazione
Note
Le funzioni di aggregazione vengono disposte in un insieme AggregationFunction a un intervallo di tempo, come descritto nelle finestre temporali. Ogni funzione accetta un input parametro che specifica la colonna di origine da aggregare.
| Function | Description | Esempio di caso d'uso |
|---|---|---|
Sum(input="column") |
Totale dei valori | Utilizzo giornaliero delle app per utente in minuti |
Avg(input="column") |
Media dei valori | Importo medio delle transazioni |
Count(input="column") |
Numero di record | Numero di accessi per utente |
Min(input="column") |
Valore minimo | Frequenza cardiaca più bassa registrata da un dispositivo indossabile |
Max(input="column") |
Valore massimo | Quantità massima di transazioni per sessione |
StddevPop(input="column") |
Deviazione standard della popolazione | Variabilità giornaliera dell'importo delle transazioni in tutti i clienti |
StddevSamp(input="column") |
Deviazione standard di esempio | Variabilità dei tassi di click-through delle campagne pubblicitarie |
VarPop(input="column") |
Varianza della popolazione | Distribuzione delle letture dei sensori per i dispositivi IoT in una fabbrica |
VarSamp(input="column") |
Varianza campione | Distribuzione delle classificazioni dei film su un gruppo campionato |
ApproxCountDistinct(input="column", relativeSD=0.05) |
Conteggio univoco approssimativo | Conteggio distinto degli articoli acquistati |
ApproxPercentile(input="column", percentile=0.95, accuracy=100) |
Percentile approssimativo | Latenza di risposta p95 |
First(input="column") |
Primo valore | Timestamp del primo accesso |
Last(input="column") |
Ultimo valore | Importo dell'acquisto più recente |
FirstN(input="column", n=3) |
I primi n valori come array |
I primi tre prodotti visualizzati in una sessione |
LastN(input="column", n=3) |
Ultimi n valori come array |
Tre stati più recenti dei casi di supporto |
FirstDistinct(input="column", n=3) |
Innanzitutto n , valori distinti come array |
Prime tre categorie di prodotto distinte viste |
LastDistinct(input="column", n=3) |
Ultimi n valori distinti come array |
Le tre categorie di mercanti più recenti e distinte |
Note
First, Last, FirstN, LastN, , FirstDistinct, e LastDistinct accettano valori scalari supportati e ARRAY, MAP, e STRUCT valori, incluse le combinazioni annidate. Includono valori nulli di default. Per ignorare i valori Null, aggiungere un oggetto filter_condition che esclude in modo esplicito le colonne di input null.
FirstN, LastN, , e LastDistinct usare le timeseries_column feature per ordinare le righe di input e restituire un array contenente fino a n valori. FirstDistinct Il parametro n deve essere un intero positivo.
FirstN e FirstDistinct selezionare valori dal più antico all'ultimo livello.
LastN e LastDistinct selezionare i valori dall'ultimo al più antico, poi restituire i valori selezionati in ordine temporale.
FirstDistinct e LastDistinct rimuovere i valori duplicati mentre si selezionano i valori in quella direzione.
Ad esempio, se le righe sorgente di un'entità sono ordinate da event_time , ["A", "A", "B", "C", "B", "B"]le seguenti funzioni restituiscono:
| Function | Result |
|---|---|
FirstN(input="event_type", n=3) |
["A", "A", "B"] |
LastN(input="event_type", n=3) |
["C", "B", "B"] |
FirstDistinct(input="event_type", n=3) |
["A", "B", "C"] |
LastDistinct(input="event_type", n=3) |
["A", "C", "B"] |
FirstN, LastN, FirstDistinct, e LastDistinct richiedono databricks-feature-engineering la versione 0.17.0 o successiva.
CustomUDF
CustomUDFapplica una funzione Python (UDF) registrata nel Catalogo Unity a ogni riga. Usalo per trasformare gli input delle richieste o combinare i valori delle caratteristiche. Non aggrega righe né definisce una finestra temporale.
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings mappa il nome di ogni parametro UDF a un input. Per RequestSource, l'input è il nome di una colonna sorgente. Per FeatureViewSource, è un riferimento a funzione a monte. Assegna ogni parametro UDF, inclusi i parametri con i valori predefiniti. I tipi di input devono corrispondere esattamente ai tipi di parametri UDF, senza cast numerici impliciti. Puoi usare tipi di input e return scalari e complessi (ARRAY, MAP, e STRUCT), incluse combinazioni annidate.
| origine | Behavior |
|---|---|
RequestSource |
Trasforma le colonne dal DataFrame di addestramento o dalla richiesta di inferenza. |
FeatureViewSource |
Combina i valori delle funzionalità a monte. Vedi FeatureViewSource. |
Le funzionalità supportate CustomUDF da Delta non possono essere materializzate o servite online. Per trasformare i valori delle caratteristiche supportate da tabelle per l'addestramento e il servizio, definisci un'aggregazione basata su Delta o una caratteristica di selezione di colonne e confrontala tramite FeatureViewSource.
CustomUDF non è supportata da StreamSource. Per trasformare l'output di una funzione di streaming, fai riferimento a quella caratteristica tramite FeatureViewSource.
CustomUDF con RequestSource richiede databricks-feature-engineering la versione 0.17.0 o successiva.
Per usare un CustomUDF, è necessario il EXECUTE privilegio sull'UDF, il USE CATALOG privilegio sul suo catalogo genitore e il USE SCHEMA privilegio sul suo schema genitore.
Il seguente esempio utilizza NumPy per calcolare log(1 + amount), riducendo la scala degli importi di grandi transazioni. Eseguilo su computazione serverless con le dipendenze UDF personalizzate attivate. Lo main.ecommerce schema deve esistere.
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '6'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
Registra una caratteristica che leghi la colonna transaction_amount di richiesta al parametro amountUDF:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
L'UDF ENVIRONMENT configura le dipendenze per il calcolo offline. Per la notifica online, dichiara anche i pacchi in create_feature_spec(extra_pip_requirements=...) o log_model(extra_pip_requirements=...). Non vengono copiati automaticamente dall'UDF.
Vedi Dipendenze di Feature Serving e dipendenze di modello.
CustomUDF le caratteristiche non possono essere realizzate. Gli UDF supportati da richieste e con funzionalità funzionano su richiesta durante la formazione e il servizio. Ogni UDF in una catena di dipendenza aggiunge calcolo, quindi mantieni le funzioni e le catene piccole. Gli UDF devono gestire gli input mancanti, che possono essere None offline o NaN online.
Per indicazioni su come gestire i valori mancanti, vedi Come gestire i valori delle caratteristiche mancanti.
ColumnSelection (passaggio)
ColumnSelection seleziona una singola colonna da una sorgente senza applicare alcuna aggregazione. Viene eseguito il wrapping direttamente nel function parametro (non all'interno AggregationFunctiondi ). Il tipo di ritorno, inclusi annidati ARRAY, MAP, e STRUCT tipi, viene dedotto dallo schema sorgente quando la caratteristica viene creata. Modificare il tipo della colonna sorgente dopo aver creato la funzione non è supportato.
| Function | Description | Esempio di caso d'uso |
|---|---|---|
ColumnSelection("col") |
Valore più recente di una colonna (nessuna aggregazione) | Categoria fornitore più recente, pass-through di un campo richiesta |
ColumnSelection Supporta le seguenti fonti di dati:
-
DeltaTableSource: Restituisce l'ultimo valore per chiave di entità tramite un join in un momento (senza aggregazione di finestre di lookback). -
SdpSource: Restituisce l'ultimo valore per chiave di entità dalla tabella di output della pipeline, uguale aDeltaTableSource. -
StreamSource: Restituisce l'ultimo valore per chiave di entità dal Stream (senza aggregazione a finestra di lookback). -
RequestSource: Passa attraverso il valore fornito al momento dell'inferenza (o estratto dal DataFrame etichettato al momento dell'addestramento).
Per un DeltaTableSource, ColumnSelection le funzionalità supportano filter_condition e transformation_sql, applicato prima della selezione di valore più recente, lo stesso vale per le caratteristiche di aggregazione.
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
Esempio: funzionalità di aggregazione e selezione di colonne
L'esempio seguente mostra le funzionalità definite sulla stessa origine dati.
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
Funzionalità con condizioni di filtro
Il filter_condition parametro permette di filtrare le righe dalla tabella sorgente prima di calcolare le aggregazioni o selezionare il valore della colonna più recente. Questa funzione funge da clausola SQL WHERE applicata prima del raggruppamento e dell'aggregazione dei dati.
Note
Per le funzionalità di aggregazione, filter_condition filtra le righe prima dell'aggregazione, come una clausola SQL WHERE applicata prima GROUP BYdi . Non modifica la granularità, che viene sempre definita dalla entity definizione della funzionalità.
I filtri sono utili quando si lavora con tabelle di origine di grandi dimensioni che includono un superset di dati necessari per il calcolo delle funzionalità e ridurre al minimo la necessità di creare viste separate sopra queste tabelle.
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
Fonti dati
DeltaTableSource
DeltaTableSourceè un oggetto Python effimero usato per definire come le caratteristiche vengono calcolate da una tabella sorgente. Non crea una nuova tabella. Specifica la configurazione per la lettura dei dati e l'aggregazione delle funzionalità.
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
Parametri:
-
catalog_name,schema_name,table_name: Identifica la tabella Delta sorgente nel Catalogo Unity. -
filter_condition: Una clausola SQLWHEREapplicata prima dell'aggregazione o della selezione delle colonne. Esempio:"status = 'completed'". -
transformation_sql: Un'espressione SQLSELECTapplicata alla tabella sorgente. Usa questo per rinominare colonne, castare tipi o calcolare colonne derivate prima dell'aggregazione o della selezione delle colonne. Se omesso, vengono selezionate tutte le colonne (*). Esempio:"user_id, CAST(amount AS DOUBLE) AS amount, event_time". -
dataframe_schema: Lo schema del DataFrame risultante dopo le trasformazioni, in formato JSON Spark StructType (dadf.schema.json()). Obbligatorio setransformation_sqlspecificato. Questo indica al sistema i nomi e i tipi di colonna risultanti dalla trasformazione. -
lateness: UnSourceLatenessoggetto che descrive quanto tempo la sorgente normalmente impiega a diventare completa in tempo di evento. Se omesso, la fonte è considerata immediatamente completa.
filter_condition
transformation_sql Quando e sono impostati, la query risultante è : SELECT {transformation_sql} FROM {table} WHERE {filter_condition}.
SourceLateness.settling_delay è il modo raccomandato per simulare durante l'addestramento un ritardo ETL costante che influisce sulla materializzazione online. Azure Databricks sposta indietro il tempo di valutazione dell'addestramento idoneo di questa durata, così che un esempio di addestramento non utilizzi dati che sarebbero stati ancora in transito online. Durante la materializzazione, Azure Databricks attende la stessa durata prima di pubblicare una finestra completata e serve l'ultima finestra completata durante il periodo intermedio.
Ad esempio, supponiamo che un lavoro ETL giornaliero si completi 8 ore dopo mezzanotte in un fuso orario locale dove la mezzanotte corrisponde alle 07:00 UTC. Usa un ritardo di assestamento di 8 ore e uno spostamento della finestra di 7 ore:
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
Note
Il timeseries_column deve essere di tipo TimestampType o TimestampNTZType.
DateType non è supportata per le serie temporali; cast la colonna in TimestampType first (ad esempio, con transformation_sql).
Esempio: Uso transformation_sql per trasformazioni a colonna
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
Esempio: derivazione transformation_sql e dataframe_schema da un DataFrame PySpark
È possibile scrivere la trasformazione come query PySpark, quindi estrarre lo schema dal dataframe risultante:
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
Espressioni supportate transformation_sql
Le stesse regole si applicano a transformation_sql su DeltaTableSource e StreamSource.
transformation_sql supporta qualsiasi espressione riga a riga; le operazioni valutate indipendentemente per ogni riga. Non cambiano il numero di righe né la corrispondenza uno a uno con la fonte. Le espressioni riga per riga includono rinomi di colonne, cast, operazioni aritmetiche e altro ancora.
Le operazioni che modificano la forma o il conteggio delle righe non sono supportate, come aggregazioni come SUM() o COUNT(). Usare AggregationFunction invece nella definizione di funzionalità.
DeltaTableSource.from_sql()
Per praticità, è possibile creare un oggetto DeltaTableSource da una query SQL. Il metodo analizza la query per estrarre automaticamente il nome della tabella, transformation_sql, e filter_condition.
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
Sono supportate solo query semplici SELECT ... FROM ... [WHERE ...] . L'istruzione SQL complessa (JOINs, sottoquery, CTEs, UNIONs) viene rifiutata. Per le query complesse, costruire DeltaTableSource direttamente con transformation_sql e filter_condition.
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
Eseguire l'iterazione con to_dataframe()
Usare source.to_dataframe() per visualizzare in anteprima i dati che verranno usati per il calcolo delle funzionalità. Ciò è utile per eseguire filter_condition l'iterazione e transformation_sql fino a quando non producono i risultati previsti.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
Informazioni sulle entità
Le colonne di entità definiscono il livello di aggregazione per le funzionalità. Vengono specificati nella Feature definizione, non in DeltaTableSource. Le entità determinano:
-
Come vengono raggruppati i dati: le caratteristiche vengono aggregate per combinazione unica di valori di entità (simile a
GROUP BYSQL) - La struttura chiave primaria: ogni combinazione unica di entità risulta in una riga di caratteristiche calcolate
Esempio: funzionalità a livello cliente
Il codice seguente aggrega le funzionalità a livello di cliente (una riga per cliente):
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Esempio: Funzionalità a livello cliente-negozio
Per aggregare le funzionalità a un livello più dettagliato (una riga per ogni combinazione di customer-store), usare più colonne di entità:
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Quando sono necessarie funzionalità a diversi livelli di aggregazione (ad esempio, a livello di cliente e a livello di punto vendita del cliente), usare valori diversi entity nelle definizioni delle funzionalità. Lo stesso DeltaTableSource può essere condiviso tra le funzionalità con configurazioni di entità diverse.
StreamSource
StreamSource riferimento a un Stream. Stream contiene la configurazione di connessione, autenticazione, schema e inserimento per l'origine di streaming. Per Kafka, i riferimenti alle colonne nelle definizioni di funzionalità devono essere preceduti value. da o key. per indicare la parte del messaggio da leggere.
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
Parametri:
-
full_name: Il nome completo in tre parti di un Stream (ad esempio,"my_catalog.my_schema.my_stream"). -
filter_condition(opzionale): Una clausola SQLWHEREapplicata ai dati di flusso prima dell'aggregazione, usando riferimenti a colonne con prefisso di punti (ad esempio,"value.event_type = 'purchase'"). -
transformation_sql(opzionale): un'espressione SQLSELECTapplicata prima dell'aggregazione o della selezione delle colonne, utilizzando riferimenti con prefisso a punti allekeystruct e.valueSupporta le stesse espressioni riga per riga diDeltaTableSource. Se omesso, la sorgente utilizza tutte le colonne (*). -
dataframe_schema: Lo schema JSON SparkStructTypedell'output proiettato. Obbligatorio se impostitransformation_sql. -
lateness: UnSourceLatenessoggetto che descrive quanto tempo il flusso normalmente impiega per completarsi in tempo di evento. VedeteSourceLateness.settling_delay.
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
Si deriva dataframe_schema eseguendo la proiezione contro la tabella di ingestione del Stream, che espone le key strutture e value .
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
SdpSource
SdpSource definisce le caratteristiche su una tabella di uscita di una pipeline Lakeflow attivata. Feature Store esegue la pipeline prima di ogni materializzazione e backfill, e poi legge la tabella di output nello stesso modo in cui legge un DeltaTableSource. Per il flusso di lavoro end-to-end, vedi Usa una pipeline Lakeflow come fonte di funzionalità.
SdpSource(
    pipeline_id: str,                            # Required: ID of the pipeline that produces the output table
    output_table: str,                           # Required: Three-part name of the pipeline output table to read
    input_tables: Optional[List[str]] = None,    # Optional: Three-part names of the tables the pipeline reads from
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause to filter the output table
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
)
Parametri:
-
pipeline_id: L'ID di una pipeline attivata esistente. La pipeline non deve essere ancora stata eseguita. Devi PUÒ CORRERE, PUÒ GESTIRE, o È il permesso del PROPRIETARIO. Le pipeline continue vengono rifiutate. -
output_table: Il nome in tre parti (catalog.schema.table) della tabella di uscita della pipeline da leggere. La tabella non deve esistere finché la pipeline non viene eseguita per la prima volta. Quando esiste, deve essere un output della pipeline, e deviSELECTessere su di essa. -
input_tables: I nomi in tre parti delle tabelle da cui la pipeline legge. Deve materializzarsi con unTableTrigger, che avvia una run quando queste tabelle si aggiornano.ColumnSelectionle caratteristiche si materializzano su un trigger di tabella, quindi richiedonoinput_tables. Puoi elencare fino a 25 tabelle, senza duplicati, e ogni tabella deve esistere quando crei la funzione. ATableTriggercontrolla più di 10 tabelle solo quando gli eventi del file sono abilitati su ogni tabella visionata. -
filter_condition,transformation_sql,dataframe_schema: Applicato alla tabella di uscita nello stesso modo di su unDeltaTableSource.dataframe_schemaè richiesto se si impostatransformation_sql.
SdpSource
Funzioni di supporto ColumnSelection e aggregazione delle caratteristiche. Non supportano CustomUDF.
Dopo aver creato una funzionalità, la sua fonte riporta un dispositivo di sola pipeline_statelettura:
-
PENDING: La pipeline non è ancora stata eseguita, quindi la tabella di output non esiste. -
RESOLVED: La tabella di output esiste e le colonne della funzionalità sono validate rispetto ad essa. -
ERROR: La pipeline eseguita o la validazione della tabella di output non è successa.
Il seguente esempio definisce un SdpSource:
from databricks.feature_engineering.entities import SdpSource

source = SdpSource(
    pipeline_id="1234abcd-5678-90ef-1234-567890abcdef",
    output_table="main.features.tutor_review_stats",
    input_tables=["main.raw.reviews", "main.raw.tutors"],
)
refresh_sdp_source()
refresh_sdp_source gestisce le pipeline dietro le funzionalità fornite. Avvia un aggiornamento per ogni pipeline, oppure si collega a un aggiornamento già in esecuzione.
FeatureEngineeringClient.refresh_sdp_source(
    *,                                  # Arguments are keyword-only
    features: List[Feature],            # Features with an SdpSource
    wait: bool = True,                  # Wait for the updates to finish
) -> Dict[str, str]                     # Pipeline ID to update ID
Con wait=True, la chiamata attende che ogni aggiornamento venga completato, senza timeout, e poi risolve le funzionalità pipeline_state. Si alza ValueError se un aggiornamento fallisce o viene cancellato, oppure se una funzione rimane irrisolta. Con , la chiamata ritorna wait=Falsenon appena iniziano gli aggiornamenti.
Per eseguire la pipeline di una funzionalità prima dell'addestramento, esegui quanto segue:
fe.refresh_sdp_source(features=[fe.get_feature(full_name="main.features.tutor_avg_score_7d")], wait=True)
RequestSource
RequestSource definisce uno schema per i dati forniti al momento dell'inferenza nel payload della richiesta invece che consultati da una tabella pre-materializzata. Durante il training, queste colonne vengono estratte dal dataframe etichettato passato a create_training_set. Durante la gestione del modello, il chiamante deve includerli nel payload della richiesta HTTP.
RequestSource può essere utilizzato con le funzioni CustomUDF o ColumnSelection Feature View. Non supporta funzioni di aggregazione o finestre temporali.
Definizione dello schema
Definire lo schema come elenco di oggetti, ognuno dei quali specifica un nome di FieldDefinition colonna e un ScalarDataTypeoggetto :
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
Per gli schemi che includono array, mappe o struct, passa dataframe_schema (il JSON Spark StructType da df.schema.json()) invece di schema, oppure deduci lo schema da un DataFrame con RequestSource.from_dataframe:
from databricks.feature_engineering.entities import RequestSource

request_source = RequestSource.from_dataframe(dataframe=labeled_df.select("cart_items", "device_info"))
Tipi di dati supportati
RequestSourcesupporta i tipi scalari definiti in ScalarDataType: INTEGER, FLOAT, BOOLEAN, STRING, DOUBLE, LONG, TIMESTAMP, SHORTDATE, . BINARY Supporta ARRAYinoltre , MAP, e STRUCT colonne costruite da questi tipi quando si definisce lo schema con dataframe_schema o from_dataframe.
MAP Le chiavi devono essere STRING.
Come vengono idratati i dati della richiesta
| Contesto | Behavior |
|---|---|
Formazione (create_training_set) |
Le colonne vengono estratte dal dataframe etichettato. I tipi vengono convalidati rispetto allo schema dichiarato. Le mancate corrispondenze generano un errore (nessun cast implicito). |
| Serving (endpoint modello) | Le colonne vengono estratte da dataframe_records o dataframe_split nella richiesta HTTP. I valori JSON vengono cast ai tipi dichiarati (ad esempio, numero JSON → DOUBLE). |
Firma del modello
Quando un modello viene registrato usando log_model con un set di training che include RequestSource funzionalità, le RequestSource colonne vengono aggiunte alla firma del modello MLflow come input necessari. Ciò significa che lo schema API dell'endpoint di servizio riflette i campi che i chiamanti devono fornire in fase di inferenza.
FeatureViewSource
FeatureViewSource usa gli output di altre Feature View come input per un CustomUDF. Il concatenamento delle caratteristiche crea un grafo aciclico diretto (DAG). Ad esempio, una caratteristica di margine può combinare aggregati di ricavi e costi, e un'altra caratteristica può trasformare il margine.
Usa databricks-feature-engineering la versione 0.18.0 o successiva per FeatureViewSource.
Passa una lista di Feature oggetti a features, non stringhe di nomi di caratteristiche. Recupera le caratteristiche registrate con get_feature. In input_bindings, usa la full_namefunzione di ciascuna registrata . Per una funzione locale non registrata, usa invece di SUA name .
Il seguente esempio assume due caratteristiche registrate, revenue_sum_7d e cost_sum_7d, che restituiscono DOUBLE valori con customer_id e usano event_time per il calcolo in un momento nel tempo:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
Si applicano le seguenti restrizioni:
- Solo
CustomUDFè supportata come funzione. Le funzionalità a monte possono essere aggregazioni, selezioni di colonne o altreCustomUDFfunzionalità. - Ometti
entityetimeseries_columnsulla caratteristica derivata. Ogni caratteristica a monte mantiene la propria entità, timestamp e definizione di finestra. - Una funzione ha una sola fonte. Per combinare un valore di richiesta con una caratteristica supportata da tabelle, definisci una
RequestSourcecaratteristica e fai riferimento a entrambe tramiteFeatureViewSource. - Ogni caratteristica a monte dichiarata deve essere utilizzata in
input_bindings. I cicli non sono permessi. - Registra le funzionalità a monte prima di registrare la caratteristica derivata. Grafi locali non registrati possono essere usati con
create_training_setper sperimentazioni. - Per l'addestramento o il servizio, è necessario il privilegio
READ FEATUREoMANAGEsulla caratteristica derivata e le sue caratteristiche transitive a monte. Usa nomi di caratteristiche distinti lungo il grafico per la registrazione e il servizio, anche tra cataloghi o schemi. - Una caratteristica può fare riferimento a fino a 20 funzionalità dirette a monte. I grafi registrati supportano una profondità massima di cinque caratteristiche lungo un percorso di dipendenza, inclusa la caratteristica base.
- Le query di addestramento sono soggette al limite di cinque chiamate UDF del Catalogo Unity per ogni query, conteggiate su tutto il grafo di dipendenza. Per superarla, usa il calcolo classico che esegue Databricks Runtime 18.1 o superiore. Sul calcolo serverless e su SQL warehouse pro e serverless, impostato
environment_versiona6o superiore in ciascuna definizione UDF. -
FeatureViewSourceLe caratteristiche non possono essere materializzate o valutate concompute_features. Usalocreate_training_setper valutarli offline. Per il servizio online, materializza invece le funzionalità supportate a monte con supporto a tabella.
Per la valutazione delle dipendenze e la selezione dell'output, vedi Allenare con le funzionalità di FeatureViewSource. Per il deployment, vedi le funzionalità derivate da Serve.
API di training e inferenza
create_training_set e score_batch calcolare i valori di correzione puntuale del tempo su richiesta dai dati sorgente. Per le funzionalità che supportano la materializzazione offline, ad esempio le aggregazioni di finestre scorrevoli nelle origini di tabelle delta, la materializzazione delle funzionalità prima in un archivio offline migliora le prestazioni di entrambe le operazioni. Quando sono disponibili funzionalità offline materializzate, le operazioni leggono i dati offline precompilate anziché ricompilare i valori delle funzionalità dall'origine. Vedere Materialze Feature Views (Materialze Feature Views ) per materializzare le funzionalità in un negozio offline.
create_training_set()
Crea un set di dati di training con il calcolo delle funzionalità corretto temporizzato. Per informazioni dettagliate, vedere Eseguire il training di modelli con visualizzazioni delle funzionalità.
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
Registra un modello con metadati delle funzionalità per il rilevamento della derivazione e la ricerca automatica delle funzionalità durante l'inferenza. Per informazioni dettagliate, vedere Eseguire il training di modelli con visualizzazioni delle funzionalità.
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
Esegue l'inferenza batch offline con la ricerca automatica delle funzionalità. Usa i metadati delle funzionalità archiviati con il modello per calcolare le funzionalità corrette temporizzato, garantendo la coerenza con il training.
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
Il dataframe di input deve contenere le colonne di entità e timeeries usate durante il training. Le funzionalità vengono calcolate automaticamente dai dati di origine.
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
Intervalli di tempo
Le Feature Views supportano quattro tipi di finestre per controllare il comportamento di lookback per aggregazioni basate su finestre temporali. I tipi di finestre disponibili dipendono dalla fonte della caratteristica: le funzionalità di streaming possono utilizzare finestre a rotelle e a dente di sega, mentre le funzionalità a batch possono usare finestre a rotola, a rotazione e scorrevoli.
- Il rollback delle finestre dall'ora dell'evento. La durata e il ritardo vengono definiti in modo esplicito.
- Le finestre scorrevoli sono finestre temporali fisse e non sovrapposte. Ogni punto dati appartiene esattamente a una finestra.
- Le finestre scorrevoli sono finestre temporali sovrapposte, mobili, con un intervallo di spostamento configurabile.
- Le finestre Sawtooth mantengono fresca una lunga finestra di retrospettazione su una sorgente in streaming utilizzando un percorso ibrido batch e streaming. Vedi la finestra Sawtooth.
L'illustrazione seguente mostra i tipi di finestre a rotola, scivolamento, rotolante e a dente di sega.

Temporizzazione della finestra temporale
Usare delay per valutare una finestra in un momento analitico precedente. Ad esempio, una finestra di 30 giorni con un ritardo di 7 giorni calcola un valore di 30 giorni a partire da una settimana prima del periodo di valutazione.
delay è indipendente dal tempo di arrivo della fonte. Per modellare il tempo che impiega l'arrivo dei dati di origine, configura SourceLateness.settling_delay invece.
Quando entrambe le impostazioni sono presenti, compongono. Azure Databricks considera la finestra completa dopo il ritardo di assestato della sorgente e la valuta usando il ritardo analitico.
Usare offset per cambiare l'allineamento dei confini fissi delle finestre. Per impostazione predefinita, le finestre a rotazione e le finestre scorrevoli sono allineate a mezzanotte UTC. Ad esempio, uno spostamento di 22 ore allinea un limite giornaliero alle 22:00 UTC. Per approssimare i confini in un fuso orario locale, si configura uno spostamento statico rispetto all'UTC. Lo spostamento non si aggiusta per l'ora legale, non sposta il tempo di valutazione né modella i dati in ritardo.
La seguente tabella riassume il supporto per questi campi:
| Campo | Windows supportati | Constraint |
|---|---|---|
delay |
Rotola, rotolare e scivolare | Deve essere non negativo datetime.timedelta |
offset |
Rotoli e scivolamenti | Deve essere non negativo e più breve del periodo* |
SourceLateness.settling_delay |
Caratteristiche rotolanti, rotolanti e scivolanti | Deve essere non negativo datetime.timedelta |
start_time |
Rotola, rotola, scivolamento e dente di sega | Deve essere un oggetto datetime.datetime. Per i dente di sega, non deve essere successivo al momento della creazione della caratteristica. |
*Punto: Per una finestra a rotazione, lo spostamento deve essere più breve di window_duration. Per una finestra scorrevole, deve essere più corta di slide_duration.
Ora di avvio
Usare start_time per impostare il primo confine temporale di evento in UTC in cui una caratteristica può emettere un output. Il confine è inclusivo.
start_time Porta. Non limita le righe di sorgente storiche che una finestra può leggere, né cambia l'allineamento della finestra. Se start_time cade tra due confini allineati, il primo output a finestra fissa idoneo è il confine successivo.
Con start_time, le finestre a durata fissa possono emettere prima che una durata completa della finestra sia trascorsa nella sorgente. Questi primi output utilizzano la storia delle sorgenti disponibili. Ad esempio, consideriamo una finestra scorrevole con un window_duration anno e uno giorno slide_duration, su una fonte i cui dati iniziano il 1° gennaio 2024:
- Senza
start_time, la funzionalità viene pubblicata per la prima volta il 1° gennaio 2025, una volta che si può formare una finestra annuale completa. - Con
start_timeil 21 agosto 2024, il film uscirà per la prima volta il 21 agosto 2024. Quella pubblicazione copre solo la cronologia delle fonti disponibili finora, dal 1° gennaio 2024. La finestra raggiunge la sua piena durata annuale il 1° gennaio 2025 e da allora produce risultati completi.
Poiché start_time non cambia l'allineamento delle finestre, un valore tra due confini allineati non crea un nuovo confine. Per una finestra a rotazione con confini giornalieri a mezzanotte UTC, a start_time delle 06:00 UTC emette prima al confine successivo di mezzanotte. A start_time che atterra esattamente su un bordo emette in quel confine, perché il confine è inclusivo.
Se start_time non è impostato, le finestre a rotazione e le finestre scorrevoli a durata fissa emettono prima a un bordo allineato dopo che si può formare una finestra piena. Le finestre scorrevoli e le finestre mobili a vita vengono emesse non appena esistono dati di origine idonei.
Note
start_time è supportata per finestre a dente di sega e per finestre a rotola, rotolamento e scorrevoli su funzionalità batch che utilizzano DeltaTableSource. Non è supportata per RollingWindow con StreamSource. Vedi la finestra Sawtooth.
Per esempio:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
Finestra a scorrimento
Note
RollingWindow in precedenza si chiamava ContinuousWindow. Se si esegue la migrazione da una versione precedente dell'SDK, aggiornare le importazioni di conseguenza.
Le finestre in sequenza sono up-to-date e aggregazioni in tempo reale, in genere usate sui dati di streaming. Nelle pipeline di streaming, la finestra in sequenza genera una nuova riga solo quando il contenuto della finestra a lunghezza fissa cambia, ad esempio quando un evento entra o esce. Quando viene usata una funzionalità finestra in sequenza nelle pipeline di training, viene eseguito un calcolo accurato delle funzionalità temporizzato sui dati di origine usando la durata della finestra a lunghezza fissa immediatamente precedente al timestamp di un evento specifico. Ciò consente di evitare l'asimmetria online-offline o la perdita di dati. Caratteristiche al tempo T aggregare eventi da [T − durata, T).
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Nella tabella seguente sono elencati i parametri per una finestra in sequenza. L'ora di inizio e di fine della finestra si basa su questi parametri come indicato di seguito:
- Ora di inizio:
evaluation_time - window_duration - delay(inclusivo) - Ora di fine:
evaluation_time - delay(esclusivo)
| Parametro | Vincoli |
|---|---|
delay (opzionale) |
Deve essere ≥ 0. Sposta la finestra analitica all'indietro rispetto al timestamp della valutazione. Usalo SourceLateness.settling_delay per modellare una base coerente per il ritardo di arrivo della sorgente nel tuo flusso. |
window_duration |
Deve essere > 0 |
start_time (opzionale) |
Primo confine temporale di evento a cui la caratteristica può emettere un'uscita. |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
Definire una finestra in sequenza con ritardo usando il codice seguente.
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
Esempi di finestre in sequenza
window_duration=timedelta(days=7): Questo crea una finestra di revisione di 7 giorni che termina al momento attuale della valutazione. Per un evento alle 2:00 del giorno 7, sono inclusi tutti gli eventi dalle 2:00 del giorno 0 fino (ma non incluso) alle 2:00 del giorno 7.window_duration=timedelta(hours=1), delay=timedelta(minutes=30): Questo crea una finestra di revisione di un'ora che termina 30 minuti prima dell'orario della valutazione. Per un evento alle 15:00, sono inclusi tutti gli eventi dalle 13:30 fino alle 14:30, ma escluso le 14:30.
Usare Last per limitare la freschezza di un valore recente
Combina Last con RollingWindow quando un valore più recente è valido solo per un tempo limitato. In un momento di valutazione, la caratteristica restituisce il valore della riga con l'ultimo timestamp in questo intervallo:
[evaluation_time - delay - window_duration, evaluation_time - delay)
Se l'ultima riga nell'intervallo contiene un valore nullo, la caratteristica restituisce nullo. Se vuoi escludere i valori di ingresso nulli, imposta a filter_condition sulla sorgente.
Questa combinazione differisce da ColumnSelection.
ColumnSelection restituisce l'ultimo valore non nullo osservato senza scadderlo in base all'età.
Per le funzionalità batch, questa combinazione prevede una modalità speciale di materializzazione solo online. Supporta solo DeltaTableSource, Last, RollingWindow, e TableTrigger. Vedi Materialize valori più recenti con limiti di freschezza.
Finestra a cascata
Per le funzionalità definite tramite finestre a scorrimento, le aggregazioni vengono calcolate su una finestra a lunghezza fissa pre-determinata che avanza in base a un intervallo di scorrimento, producendo finestre non sovrapposte che partizionano completamente il tempo. Di conseguenza, ogni evento nell'origine contribuisce esattamente a una finestra. Le funzionalità al momento t aggregano dati dalle finestre che terminano a o prima di t in modo esclusivo. Windows inizia dall'epoca Unix.
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Nella tabella seguente sono elencati i parametri per una finestra a cascata.
| Parametro | Vincoli |
|---|---|
window_duration |
Deve essere > 0 |
delay (opzionale) |
Deve essere ≥ 0. Sposta la finestra analitica all'indietro rispetto al timestamp della valutazione. |
offset (opzionale) |
Deve essere ≥ 0 e più breve di window_duration. Sposta i confini della finestra da mezzanotte UTC. |
start_time (opzionale) |
Primo confine temporale di evento a cui la caratteristica può emettere un'uscita. |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Esempio di finestra a cascata
-
window_duration=timedelta(days=5): Questo crea finestre di lunghezza fissa predefinite di 5 giorni ciascuna. Esempio: la finestra n. 1 si estende da Giorno 0 a Giorno 4, Window #2 si estende da Giorno 5 a Giorno 9, Finestra #3 si estende da Giorno 10 a Giorno 14 e così via. In particolare, Window #1 include tutti gli eventi con timestamp a partire dal00:00:00.00giorno 0 fino a (ma non incluso) qualsiasi evento con timestamp00:00:00.00il giorno 5. Ogni evento appartiene esattamente a una finestra.
Finestra scorrevole
Per le caratteristiche definite tramite finestre scorrevoli, le aggregazioni vengono calcolate su una finestra che avanza di un intervallo di scorrimento. Una finestra scorrevole può avere una durata fissa o una durata di tutta la vita. Le finestre a durata fissa si sovrappongono, quindi ogni evento sorgente può contribuire all'aggregazione di funzionalità per più finestre. Una finestra di vita include tutti gli eventi di sorgente prima della fine della finestra. Le funzionalità al momento t aggregano dati dalle finestre che terminano a o prima di t in modo esclusivo. Windows sono allineati all'epoca Unix.
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
Nella tabella seguente sono elencati i parametri per una finestra scorrevole.
| Parametro | Vincoli |
|---|---|
window_duration |
Deve essere positivo per una finestra di durata fissa. Impostato per None una finestra a vita. |
slide_duration |
Deve essere positivo. Per una finestra di durata fissa, deve anche essere più breve di window_duration. |
delay (opzionale) |
Deve essere ≥ 0. Sposta la finestra analitica all'indietro rispetto al timestamp della valutazione. |
offset (opzionale) |
Deve essere ≥ 0 e più breve di slide_duration. Sposta i confini della finestra da mezzanotte UTC. |
start_time (opzionale) |
Primo confine temporale di evento a cui la caratteristica può emettere un'uscita. |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Esempio di finestra scorrevole
-
window_duration=timedelta(days=5), slide_duration=timedelta(days=1): Questo crea finestre sovrapposte di 5 giorni che avanzano di 1 giorno ogni volta. Esempio: la finestra n. 1 si estende da Giorno 0 a Giorno 4, Window #2 si estende da Giorno 1 a Giorno 5, Finestra #3 si estende da Giorno 2 a Giorno 6 e così via. Ogni finestra include gli eventi dal00:00:00.00giorno di inizio fino al (ma non incluso)00:00:00.00giorno di fine. Poiché le finestre si sovrappongono, un singolo evento può appartenere a più finestre (in questo esempio ogni evento appartiene a un massimo di 5 finestre diverse).
Finestra di vita
Imposta window_duration=None per creare una finestra di vita intera. A ogni confine di slide, la caratteristica aggrega tutti gli eventi sorgente per l'entità con timestamp precedenti a quel confine. Ad esempio, una diapositiva di un giorno produce un valore cumulativo una volta al giorno.
Le finestre di vita sono supportate solo da SlidingWindow.
RollingWindow e TumblingWindow richiedono un finito window_duration.
Note
Le finestre a vita richiedono una databricks-feature-engineering versione client che supporti window_duration=None l'abilitazione dello spazio di lavoro. Le versioni client precedenti non supportano questa sintassi.
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
Finestra a dente di sega
Una finestra a dente di sega è un'aggregazione che supporta aggiornamenti molto recenti per eventi recenti, insieme alla compattazione giornaliera dei dati storici. Il suo bordo posteriore (più vecchio) avanza in passi fissi giornalieri mentre il bordo anteriore (recente) rimane aggiornato con gli ultimi eventi, quindi la lunghezza effettiva della finestra "sega" nel corso di ogni giorno. La maggior parte della finestra viene servita dai dati nella tabella di ingestione dello Stream, e solo i due giorni più recenti provengono dalla diretta stream. Questo è un compromesso che calcola in modo efficiente finestre di lunga durata (scalabili fino ad anni) pur rimanendo reattivo agli aggiornamenti recenti.
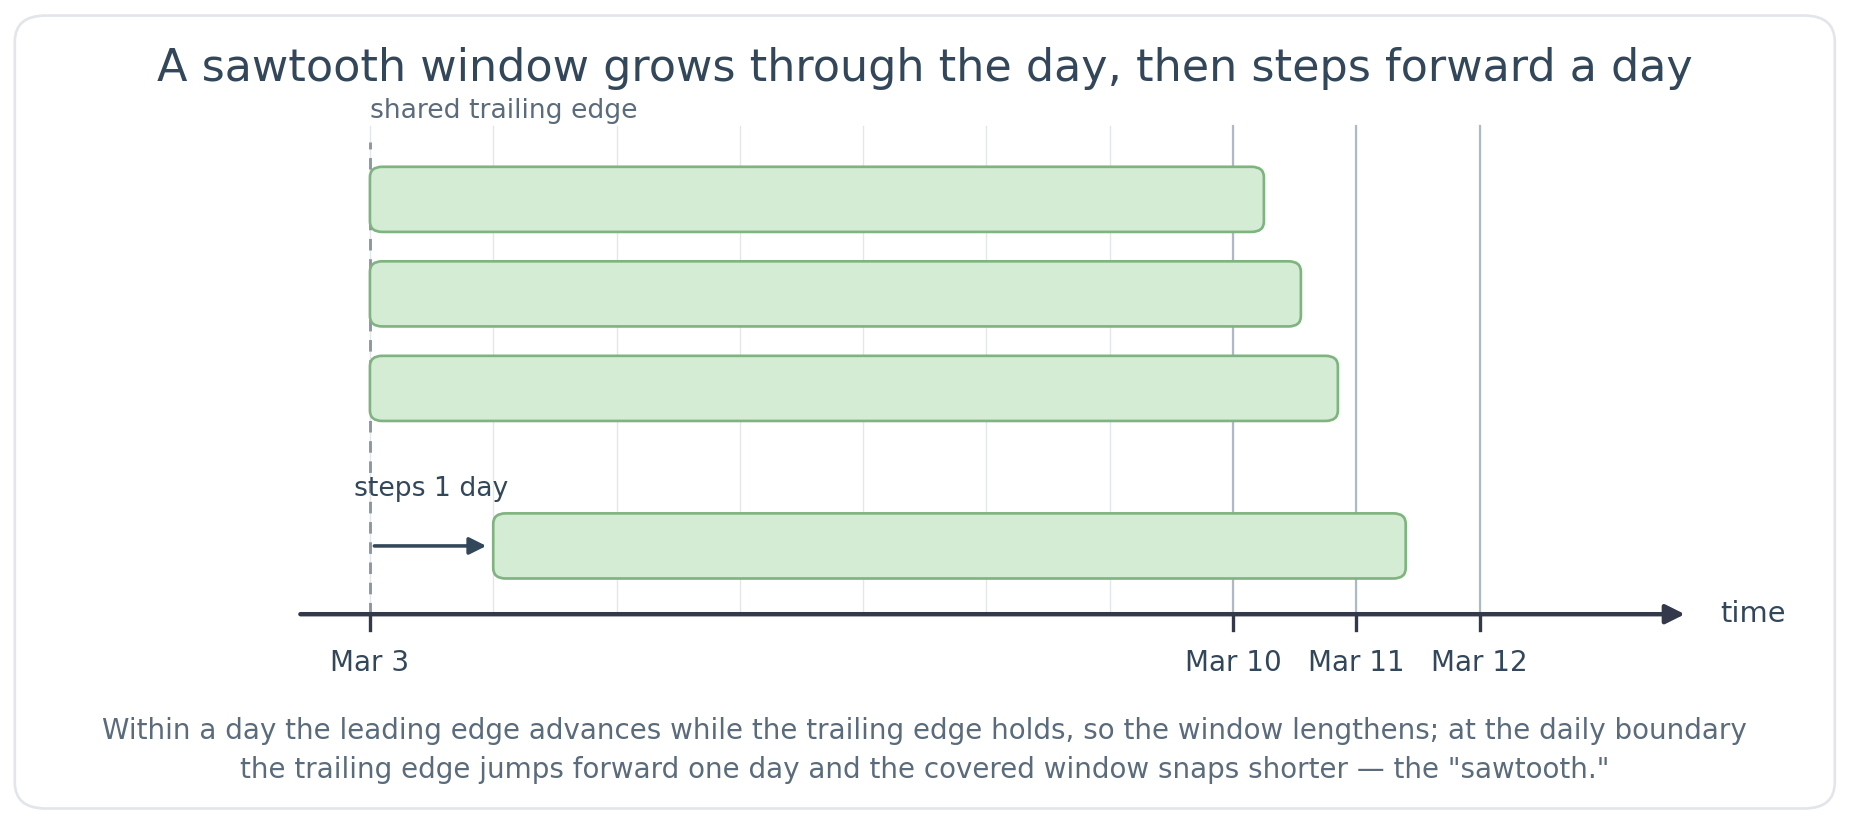
Le finestre a dente di sega si materializzano su un percorso ibrido batch e streaming. Una pipeline batch mantiene la maggior parte della finestra, mentre una pipeline streaming mantiene freschi i dati più recenti in tempo reale. I due vengono uniti in lettura, quindi per il modello o il consumatore che serve è una singola caratteristica.
Poiché la parte storica della finestra è calcolata dalla condotta batch, una caratteristica a dente di sega è pronta a servire poco dopo l'inizio della materializzazione, anche quando la finestra si estende su mesi o anni. Una finestra a rotelle è completa solo dopo che la durata completa della finestra è scaduta. Il minimo window_duration deve essere superiore a due giorni (il limite inferiore imposto). Databricks raccomanda una finestra a dente di sega per durate superiori a 7 giorni. Per finestre più lunghe di due giorni fino a sette giorni, scegli tra la precisione a lunghezza fissa di una finestra a rotelle e la prontezza di produzione più rapida di una finestra a dente di sega.
Note
Una caratteristica a dente di sega si basa su una storia già presente. La tabella di ingestione del Stream deve contenere dati che coprono almeno l'intera durata della finestra, altrimenti la finestra calcolata è incompleta. Se non lo fa, imposta start_time al momento più precoce in cui vuoi che la caratteristica serva i valori, non oltre quando crei la caratteristica. I valori da start_time allora coprono la storia disponibile a quel punto. Prima che trascorrono 2 giorni completi, la caratteristica riflette solo i dati materializzati finora. Non mettere in produzione il film fino a quando non sono passati 2 giorni interi. Un'aggregazione su una finestra vuota restituisce 0 per Sum e Count, e nullo per Avg, Min, Max, First, LastVarPop, , VarSamp, , StddevPop, , e StddevSamp.
Per sapere se una funzione a dente di sega è pronta, apri la Feature View in Catalog Explorer. Nella sezione Caratteristiche materializzate, il backfill batch è completato una volta che il tempo di materializzazione dell'ultimo feature avanza e il suo stato mostra successo. La parte di streaming è materializzata da un gasdotto dichiarativo Lakeflow. Dopo che la Feature View supera la validazione, la funzionalità materializzata si collega a quella pipeline, dove puoi monitorarne lo stato dell'esecuzione.
Le finestre a dente di sega richiedono un StreamSource e sono materializzate con StreamingMode.
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
    start_time: Optional[datetime.datetime] = None
I bordi di una finestra a dente di sega si muovono in modo diverso rispetto a quelli di una finestra a rotola: il bordo d'attacco segue l'ultimo evento, mentre quello posteriore avanza una volta al giorno invece che in modo continuo. Ogni giorno, a un limite fisso delle 18:00 UTC, il bordo d'uscita avanza fino al confine UTC-mezzanotte di quel giorno. Di conseguenza, la finestra effettiva è leggermente più lunga e window_duration cresce nel corso del giorno prima di tornare un giorno al termine successivo. Addestramento e servizio utilizzano lo stesso limite delle 18:00 UTC, quindi la formazione offline e il servizio online rimangono costanti.
| Parametro | Vincoli |
|---|---|
window_duration |
Devono essere più di due giorni. È consentita una durata che non sia un intero numero di giorni (ad esempio, timedelta(days=3, minutes=15)), ma la finestra viene comunque aggiornata con granularità giornaliera. |
start_time (opzionale) |
Non deve essere dopo il momento della creazione della feature. |
Impostato start_time quando la tabella di ingestione del Stream contiene meno storia di window_duration. Senza di esso, la pipeline batch aspetta che esista una finestra completa di storia. Impostalo al momento più precoce in cui vuoi che la funzione serva i valori. Il valore non dipende dai dati già presenti nella finestra. La caratteristica serve i valori parziali della finestra da poi start_time e raggiunge la durata completa della finestra dopo aver accumulato abbastanza storia.
Non puoi impostare una finestra start_time a dente di sega dopo il momento in cui crei la caratteristica.
start_time porta solo la parte batch della finestra, quindi un valore successivo permetterebbe alla parte streaming di servire valori precedenti start_timea .
Le finestre a dente di sega supportano le Sumfunzioni di aggregazione e LastNVarSampFirstDistinctLastDistinctFirstNVarPopStddevPopAvgMinStddevSampCountMaxFirstLastaggregazione.
Esempio di finestra a dente di sega
Il seguente esempio mostra un conteggio di 7 giorni delle transazioni di un utente. Il bordo d'attacco segue l'evento corrente mentre il bordo d'uscita avanza un giorno alla volta. Per gli eventi del 10 marzo, la finestra risale a circa il 3 marzo. Con il passare del 10 marzo, il bordo d'attacco continua ad avanzare mentre il bordo d'uscita regge, quindi la campata coperta aumenta. Poi, all'inizio dell'11 marzo, il bordo d'uscita passa a circa il 4 marzo. La finestra effettiva è sempre un po' più lunga di sette giorni. I due giorni più recenti sono serviti dalla diretta streaming, mentre i giorni precedenti dalla tabella di ingestione della Stream.
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
Il seguente esempio è una somma di 365 giorni su una tabella di ingestione i cui dati iniziano il 1° gennaio 2026. Con start_time una data fissata al 1° gennaio 2026, la funzione serve valori parziali della finestra da quel giorno e copre un anno intero dal 1° gennaio 2027:
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SawtoothWindow

window = SawtoothWindow(
    window_duration=timedelta(days=365),
    start_time=datetime(2026, 1, 1),
)
Limitazioni delle finestre a dente di sega
- Il
delayparametro non è supportato. -
SourceLateness.settling_delaynon è supportato. - Non puoi impostare una
start_timefunzione più tardi del momento in cui crei la funzione. - Le funzioni di aggregazione diverse da
Sum,Avg,Count,Min,Max,FirstLast, ,FirstN,LastNVarPopStddevSampVarSampLastDistinctStddevPopFirstDistincte non sono supportate (ad esempio,ApproxCountDistincte ).ApproxPercentile - Le finestre a dente di sega richiedono un
StreamSource. ADeltaTableSourcenon è supportato.
Trigger di materializzazione
Attiva il controllo quando viene eseguita una pipeline di materializzazione. Il tipo di trigger dipende dal tipo di funzionalità.
CronSchedule
Da usare CronSchedule per le funzionalità di aggregazione batch. Di default, Azure Databricks deriva un programma dalla finestra di aggregazione. Un programma derivato tiene conto del periodo della finestra, della finestra delay e offset, e della sorgente settling_delay , in modo che una run non pubblichi una finestra prima che i dati sorgente siano completi. I programmi derivati supportano finestre di tumbling e scorrevoli.
Per richiedere un programma derivato, si omette l'espressione cron.
CronSchedule() e la forma esplicita CronSchedule(mode=CronScheduleMode.DERIVED) sono equivalenti:
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
Non impostare quartz_cron_expression con CronScheduleMode.DERIVED. Quando recuperi la funzionalità materializzata, l'orario restituito può contenere l'espressione cron calcolata da Azure Databricks.
Per controllare direttamente il programma, fornire un'espressione cron di Quarzo.
CronScheduleMode.MANUAL si deduce quando si fornisce un'espressione:
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
Uso TableTrigger per caratteristiche o caratteristiche aggregate (AggregationFunction) supportate da un DeltaTableSource o da un SdpSourceColumnSelection . Per un DeltaTableSource, la pipeline viene eseguita ogni volta che la tabella Delta a monte riceve un nuovo commit.
Per le funzionalità di aggregazione, la pipeline è limitata in modo da non funzionare su ogni commit. Di default, il tempo tra una run e l'altra è almeno la metà della lunghezza della finestra della funzione (quella slide_duration di una finestra scorrevole o window_duration di una finestra a rotazione), mantenuta tra 5 minuti e 1 ora. Ad esempio, una funzione con una finestra di rotazione di 1 ora viene eseguita al massimo ogni 30 minuti, mentre una funzione con una finestra di 8 ore va al massimo ogni ora. Per modificare questa impostazione, impostare min_time_between_triggers. Il pavimento dei 5 minuti si applica quando metà della finestra è più piccola, quindi finestre di 10 minuti o meno funzionano al massimo ogni 5 minuti. Le funzionalità di aggregazione la cui finestra è inferiore a 5 minuti non possono usare TableTrigger, usano invece un trigger di streaming.
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
Per le funzionalità supportate da un SdpSource, TableTrigger osserva la tabella della input_tables sorgente invece che quella di output. Le funzionalità sulla stessa tabella di uscita e trigger che materializzi in una chiamata condividono un lavoro, che monitora input_tables tutte, fino a 25 tabelle in totale. Per monitorare più di 10 tabelle, abilita gli eventi del file su ogni tabella visionata. Vedi come le tabelle contano per il limite di trigger. Ogni esecuzione aggiorna la pipeline prima che materializzi le funzionalità.
Per controllare quando iniziano le partite, imposta i seguenti parametri opzionali:
TableTrigger(
    min_time_between_triggers: Optional[timedelta] = None,     # Optional: Shortest gap between two runs
    wait_after_last_change: Optional[timedelta] = None,        # Optional: Quiet period after the last update before a run starts
    condition: Optional[TableTriggerCondition] = None,         # Optional: Which table updates start a run
)
-
min_time_between_triggers: Il tempo più breve consentito tra due punti. Devono essere almeno 5 minuti. Se non fissate, le funzionalità a finestra scorrevole consumano metà dislide_duration, mentre quelle a finestra a rotazione consumano metà diwindow_duration, mantenute tra 5 minuti e 1 ora. Altre funzionalità non hanno un minimo. -
wait_after_last_change: Quanto tempo le tabelle sorgente devono rimanere senza aggiornamenti prima che inizi una run, così che una serie di aggiornamenti arrivi per prima. Devono essere zero o almeno 60 secondi. Se non è impostato o zero, una run inizia non appena una tabella sorgente si aggiorna. -
condition:TableTriggerCondition.TABLE_TRIGGER_CONDITION_ANY_UPDATED(il predefinito) avvia una run quando una tabella sorgente si aggiorna.TableTriggerCondition.TABLE_TRIGGER_CONDITION_ALL_UPDATEDinizia una run solo dopo che ogni tabella sorgente è stata aggiornata.
Il seguente esempio attende che tutte le tabelle di input si aggiornino, poi attende 10 minuti per ulteriori aggiornamenti, ed è eseguito al massimo ogni ora:
from datetime import timedelta
from databricks.feature_engineering.entities import TableTrigger, TableTriggerCondition

trigger = TableTrigger(
    condition=TableTriggerCondition.TABLE_TRIGGER_CONDITION_ALL_UPDATED,
    wait_after_last_change=timedelta(minutes=10),
    min_time_between_triggers=timedelta(hours=1),
)
StreamingMode
Da usare StreamingMode per calcolare le funzionalità con una pipeline di streaming strutturato continua che scrive i risultati direttamente sullo store online. È richiesto per le funzionalità supportate da un StreamSource, e puoi anche usarlo per le funzionalità supportate da un DeltaTableSource.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
Flusso da un DeltaTableSource
Quando passi StreamingMode() per una funzionalità supportata da un DeltaTableSource, la pipeline legge il feed dei dati di modifica della tabella come fonte di streaming invece di eseguirlo come un batch scheduled. Gira in modalità micro-batch, che elabora i nuovi commit in piccoli lotti. Per un esempio, vedi Definire una funzione di streaming usando una DeltaTableSource.
Si applicano i seguenti requisiti e comportamenti:
- La tabella sorgente deve avere abilitato il feed dei dati di modifica (
delta.enableChangeDataFeed = true). La pipeline verifica questa proprietà all'avvio e fallisce se non è impostata. -
ColumnSelectionSono supportate funzionalità e funzionalità di aggregazione che utilizzano ARollingWindowcon Awindow_duration. Le finestre a cascata, scorrevoli e a dente di sega non sono supportate per le funzioni di streamingDeltaTableSource. - La materializzazione parte dall'ultima versione della tabella e non elabora le righe già presenti nella tabella. Fino all'arrivo di una finestra completa di nuovi dati,
RollingWindowi valori riflettono solo i dati impegnati dopo l'inizio della pipeline. - Le righe inserite e aggiornate contribuiscono ai valori delle caratteristiche. Eliminare le righe dalla tabella sorgente non le elimina dai valori già aggregati.
- Devi fornire un
online_config. Le funzionalità di streaming si materializzano solo sullo store online.
Scelta di un trigger
Ogni caratteristica utilizza un solo trigger; Le opzioni per tipo di caratteristica sono:
| Tipo di funzionalità | Trigger | Quando viene eseguito |
|---|---|---|
Aggregazione (AggregationFunction) da DeltaTableSource |
CronSchedule |
Su un programma derivato o manuale |
Aggregazione (AggregationFunction) da DeltaTableSource |
TableTrigger |
In ogni commit della tabella di origine |
ColumnSelection (da DeltaTableSource) |
TableTrigger |
In ogni commit della tabella di origine |
Aggregazione (AggregationFunction) da SdpSource |
CronSchedule |
Su un programma derivato o manuale |
Aggregazione o ColumnSelection da SdpSource |
TableTrigger |
Sugli aggiornamenti a input_tables |
Funzionalità di StreamSource |
StreamingMode |
Streaming continuo |
RollingWindow Aggregazione o ColumnSelection da DeltaTableSource |
StreamingMode |
Streaming continuo (micro-batch) |
Una materialize_features chiamata può includere funzionalità batch con trigger diversi, SdpSourceDeltaTableSource funzionalità e SdpSource funzionalità provenienti da pipeline differenti. Ogni sorgente, pipeline e programma ha il proprio compito. Le funzionalità che usano StreamingMode necessitano di una chiamata separata.