Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Le funzioni definite dall'utente (UDF) nel catalogo Unity estendono le funzionalità SQL e Python in Azure Databricks. Consentono di definire, usare e condividere e gestire in modo sicuro le funzioni personalizzate in ambienti di elaborazione.
Le funzioni Python UDF registrate come funzioni nel Catalogo Unity differiscono nell'ambito e nel supporto dalle UDF di PySpark con ambito a un notebook o SparkSession. Vedi funzioni scalari Python definite dall'utente (UDF).
Per registrare funzioni definite dall'utente (UDF) scritte in Scala o Java in Unity Catalog, consulta Funzioni definite dall'utente (UDF) in Scala e Java in Unity Catalog.
Per vedere quali carichi di lavoro e tabelle fanno riferimento a un UDF nel Catalogo Unity prima di modificarlo, vedi Visualizza la linea UDF.
Per informazioni di riferimento complete sul linguaggio SQL, vedere CREATE FUNCTION (SQL, Python, Scala e Java).
Requisiti
Per usare funzioni definite dall'utente nel Catalogo Unity, è necessario soddisfare i seguenti requisiti:
- Per usare il codice Python nelle funzioni definite dall'utente registrate nel Catalogo Unity, è necessario usare un SQL Warehouse serverless o pro, o un cluster che esegue Databricks Runtime 13.3 LTS o versione successiva.
- Se una vista include una funzione definita dall'utente Python del catalogo Unity, l'operazione ha esito negativo nei warehouse SQL classici.
- Il supporto dell'istanza ARM per le funzioni definite dall'utente in Scala nei cluster abilitati per il "Catalogo Unity" è disponibile in Databricks Runtime 15.2 e versioni successive.
Gli UDF scalari e batch Unity Catalog Python sono generalmente disponibili su tutti i tipi di calcolo supportati.
Requisiti di funzionalità Python UDF
I requisiti variano a seconda delle caratteristiche. Databricks Runtime 19 e l'ambiente versione 6 non sono requisiti generali per gli UDF Python del Catalogo Unity.
Per le UDF di sessione di PySpark nei notebook o nei processi serverless, i requisiti dell'ambiente si riferiscono all'ambiente della sessione. Per le UDF Python definite in SQL, esse fanno riferimento a environment_version nella clausola ENVIRONMENT di ciascuna funzione. Cambiare l'ambiente di sessione non modifica l'ambiente di una funzione Unity Catalog esistente. Ad esempio, una sessione che utilizza l'ambiente versione 6 può chiamare una funzione del Catalogo Unity definita con l'ambiente versione 5.
| Feature | Requisiti |
|---|---|
ENVIRONMENT Clausole e dipendenze personalizzate |
notebook serverless e lavori; magazzini SQL pro o serverless; Databricks Runtime 16.2 o superiore su calcolo classico. Nel calcolo classico che esegue Databricks runtime 16.2 fino a 18.1, environment_version deve essere 'None'. |
| Funzioni definite dall'utente Python in Batch Unity Catalog | Elaborazione serverless; warehouse SQL pro e serverless; Databricks Runtime 16.3 o versioni successive con elaborazione classica |
| Gestore denominato per un UDF scalare Python | Databricks Runtime 18.1 o versioni successive nel compute classico. Nel calcolo serverless e nei warehouse SQL Pro e Serverless, imposta esplicitamente environment_version dell'UDF su 6 o versione successiva. |
| Credenziali di servizio in un UDF scalare Python | Databricks Runtime 18.1 o versioni successive nel compute classico. Nel calcolo serverless e nei warehouse SQL Pro e Serverless, imposta esplicitamente environment_version dell'UDF su 6 o versione successiva. Il calcolo classico non richiede la versione 6 dell'ambiente. Nei SQL warehouse serverless, attiva anche l'Anteprima pubblica della rete per carichi di lavoro isolati. |
| Credenziali di servizio in un UDF Python del Catalogo Batch Unity | Calcolo serverless; magazzini SQL pro e serverless; Databricks Runtime 16.3 o superiore sul calcolo classico. La versione 6 dell'ambiente non è obbligatoria. Nei SQL warehouse serverless, attiva anche l'Anteprima pubblica della rete per carichi di lavoro isolati. |
| Segreti in una UDF Python scalare o batch di Unity Catalog | Imposta esplicitamente environment_version su 6 o versione successiva; elaborazione serverless; SQL warehouse Pro e serverless; Databricks Runtime 19 o versione successiva con modalità di accesso standard nell'elaborazione classica. L'invocazione diretta non è supportata nel calcolo in modalità di accesso dedicata. |
Comportamento di input compatibile con TIMESTAMPPySpark |
Databricks Runtime 18.1 o versioni successive nel compute classico. Nel calcolo serverless e nei warehouse SQL Pro e Serverless, imposta esplicitamente environment_version dell'UDF su 6 o versione successiva. |
| Più di cinque chiamate UDF in una query | Databricks Runtime 18.1 o versioni successive nel compute classico. Nel calcolo serverless e nei warehouse SQL Pro e serverless, imposta esplicitamente environment_version di ogni UDF su 6 o superiore. |
Gli UDF esistenti e le funzionalità disponibili durante la Preview Pubblica continuano a funzionare sulle versioni di esecuzione precedenti applicabili.
La versione dell'ambiente determina anche se i chiamanti necessitano di accesso diretto alle dipendenze memorizzate in un volume del Catalogo Unity. Vedi Autorizzazioni per le dipendenze nei volumi di Unity Catalog.
Versioni dell'ambiente su Classic Compute
Nel calcolo classico, impostare environment_version un valore diverso da 'None' richiede Databricks Runtime 18.2 o superiore. Sui Databrick runtime 16.2 fino a 18.1, imposta environment_version = 'None' ogni volta che usi la ENVIRONMENT clausola. Il valore 'None' utilizza l'ambiente Python predefinito.
Su Databricks Runtime 18.2 o superiori, per un comportamento prevedibile, Azure Databricks raccomanda di impostare esplicitamente un fisso environment_version in ogni definizione Python UDF del Catalogo Unity. Scegli una versione che soddisfi i requisiti di funzionalità dell'UDF e che segua queste raccomandazioni di compatibilità:
| Versione di Databricks Runtime | Versione massima consigliata dell'ambiente |
|---|---|
| Da 18.2 a 18.x | 5 |
| 19.x | 6 |
Creazione di funzioni definite dall'utente (UDF) SQL e Python in Unity Catalog
Per creare una UDF SQL o Python in Unity Catalog, gli utenti devono disporre delle autorizzazioni USAGE e CREATE per lo schema e dell'autorizzazione USAGE per il catalogo. Per altri dettagli, vedere del catalogo Unity.
Per eseguire una funzione definita dall'utente (UDF), gli utenti devono disporre dell'autorizzazione EXECUTE sulla UDF. Gli utenti necessitano anche dell'autorizzazione USAGE per lo schema e il catalogo.
Per creare e registrare una UDF in uno schema di Unity Catalog, il nome della funzione deve seguire il formato catalog.schema.function_name. In alternativa, è possibile selezionare il catalogo e lo schema corretti nell'editor SQL.
In questo caso, il nome della funzione non deve essere preceduto da catalog.schema:
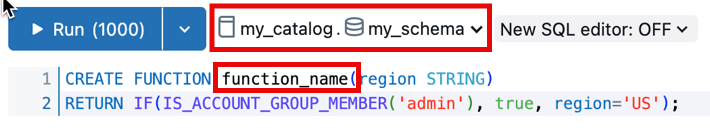
Nell'esempio seguente viene registrata una nuova funzione nello my_schema schema nel my_catalog catalogo:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight DOUBLE, height DOUBLE)
RETURNS DOUBLE
LANGUAGE SQL
RETURN
SELECT weight / (height * height);
Le UDF Python per Unity Catalog utilizzano istruzioni delimitate da doppi segni di dollaro ($$). È necessario specificare un mapping dei tipi di dati. L'esempio seguente registra una funzione definita dall'utente che calcola l'indice di massa corporea:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight_kg DOUBLE, height_m DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
return weight_kg / (height_m ** 2)
$$;
È ora possibile usare questa funzione del catalogo Unity nelle query SQL o nel codice PySpark:
SELECT person_id, my_catalog.my_schema.calculate_bmi(weight_kg, height_m) AS bmi
FROM person_data;
Per altri esempi di funzioni definite dall'utente (UDF), vedere Esempi di filtri di riga ed Esempi di maschera di colonna.
Usa un handler nominato in un UDF scalare Python
Nel calcolo classico, i gestori nominati richiedono Databricks Runtime 18.1 o superiore. Nel calcolo serverless e nei warehouse SQL Pro e Serverless, imposta esplicitamente environment_version dell'UDF su 6 o versione successiva. Il seguente esempio utilizza la versione 6 dell'ambiente. Sul calcolo classico che esegue Databricks Runtime 18.1, ometti la ENVIRONMENT clausola. Nelle versioni runtime successive, segui le raccomandazioni di compatibilità se includi la clausola.
Usa la HANDLER clausola per nominare una funzione Python nel corpo UDF come punto di ingresso. Il gestore nominato accetta gli argomenti UDF e restituisce un valore che corrisponde al tipo di ritorno dichiarato. Il codice esterno al handler viene eseguito quando ogni ambiente Python inizializza l'UDF, prima che il handler elabori gli input. Usa questo codice per un'inizializzazione una tantum da riutilizzare nelle chiamate successive dell'handler.
Il seguente esempio inizializza greeting_prefix prima di definire greet_handler, la funzione che gestisce gli input UDF:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.greet(name STRING)
RETURNS STRING
LANGUAGE PYTHON
HANDLER 'greet_handler'
ENVIRONMENT (
  environment_version = '6'
)
AS $$
# Runs once when each Python environment initializes the UDF.
greeting_prefix = "Hello"

def greet_handler(name):
    return f"{greeting_prefix}, {name}!"
$$;
Usa i segreti in un UDF Python
Le UDF Python scalari e batch di Unity Catalog possono accedere ai segreti dichiarati nella clausola SECRETS. La definizione UDF deve essere esplicitamente impostata environment_version a 6 o superiore. Un segreto del Catalogo Unity utilizza un nome in tre parti (catalog.schema.secret) ed è distinto da un segreto Azure Databricks a livello di workspace. Per il supporto per il calcolo, le autorizzazioni e l'eccezione della maschera di colonna per il calcolo dedicato, consulta Requisiti e autorizzazioni UDF.
Per accedere a un segreto da una UDF:
- Aggiungi il nome a tre parti del segreto nella clausola
SECRETSdella definizione della UDF. Una UDF può recuperare solo i segreti dichiarati in questa clausola. - Nel corpo UDF, chiama
databricks.secrets.get()con il catalogo, lo schema e il nome segreto.
Il seguente esempio scalare di UDF utilizza un segreto del Catalogo Unity come chiave di firma tramite codice di autenticazione dei messaggi (HMAC) basato su hash. Usa la stessa SECRETS clausola con PARAMETER STYLE PANDAS per accedere ai segreti dichiarati da un gestore UDF batch.
CREATE OR REPLACE FUNCTION main.default.sign_value(value STRING)
RETURNS STRING
LANGUAGE PYTHON
SECRETS (main.default.hmac_key)
ENVIRONMENT (
  environment_version = '6'
)
AS $$
import hashlib
import hmac
from databricks.secrets import get

key = get(catalog="main", schema="default", key="hmac_key")
return hmac.new(key.encode(), value.encode(), hashlib.sha256).hexdigest()
$$;
Avvertimento
Non restituire valori riservati da una UDF. La redazione segreta aiuta a ridurre l'esposizione accidentale in errori e log, ma non impedisce al codice UDF di esporre materiale segreto nei risultati delle query.
Ampliare le funzioni definite dall'utente utilizzando dipendenze personalizzate
Nota
Per installare dipendenze personalizzate da Internet su un SQL warehouse serverless, l'area di lavoro deve avere abilitata nella pagina Anteprime la funzionalità di anteprima pubblica Attiva la rete per i carichi di lavoro isolati nei SQL warehouse serverless.
È possibile estendere le funzionalità delle UDF Python di Unity Catalog oltre l'ambiente Databricks Runtime specificando dipendenze personalizzate per librerie esterne.
Requisiti
Le dipendenze personalizzate per le UDF del Unity Catalog sono supportate nei tipi di calcolo seguenti:
- Serverless notebook e attività
- Calcolo all-purpose classico con Databricks Runtime versione 16.2 e successive
- Pro o serverless SQL Warehouse
Origini di dipendenza
Installare le dipendenze dalle seguenti fonti.
- Pacchetti PyPI
- File memorizzati nei volumi del Catalogo Unity Vedi Permessi per le dipendenze nei volumi del Catalogo Unity.
- File disponibili negli URL pubblici Le regole di sicurezza della rete dell'area di lavoro devono consentire l'accesso agli URL pubblici. Vedere Requisiti.
Nota
Se l'area di lavoro limita l'accesso alla rete serverless, è necessario configurare le regole di sicurezza di rete per consentire gli URL pubblici. Vedi Impostare le regole in uscita.
Autorizzazioni per le dipendenze nei volumi di Unity Catalog
Il creatore di funzioni deve avere READ VOLUME su un volume sorgente per aggiungere una dipendenza da quel volume a un UDF.
Per un UDF la cui definizione imposta esplicitamente environment_version su 6 o versione successiva, i chiamanti devono disporre di EXECUTE sull'UDF, ma non necessitano di READ VOLUME sul volume di origine. Se la definizione UDF omette environment_version, la imposta su None o la imposta su una versione precedente, i chiamanti devono inoltre disporre di READ VOLUME nel volume di origine.
Definire le dipendenze
Utilizzare la sezione ENVIRONMENT della definizione della funzione definita dall'utente per specificare le dipendenze:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.mixed_process(data STRING)
RETURNS STRING
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["simplejson==3.19.3", "/Volumes/my_catalog/my_schema/my_volume/packages/custom_package-1.0.0.whl", "https://my-bucket.s3.amazonaws.com/packages/special_package-2.0.0.whl?Expires=2043167927&Signature=abcd"]',
  environment_version = '6'
)
AS $$
import simplejson as json
import custom_package
return json.dumps(custom_package.process(data))
$$;
La ENVIRONMENT sezione contiene i campi seguenti:
| Campo | Descrizione | TIPO | Esempio di utilizzo |
|---|---|---|---|
dependencies |
Elenco delle dipendenze separate da virgole da installare. Ogni voce è una stringa conforme al formato di file pip Requirements. | STRING |
dependencies = '["simplejson==3.19.3", "/Volumes/catalog/schema/volume/packages/my_package-1.0.0.whl"]'dependencies = '["https://my-bucket.s3.amazonaws.com/packages/my_package-2.0.0.whl?Expires=2043167927&Signature=abcd"]' |
environment_version |
Specifica la versione dell'ambiente in cui eseguire l'UDF. Questo campo è richiesto ogni volta che la ENVIRONMENT clausola è presente. Una versione di ambiente fisso esegue l'UDF con una versione di Python specifica e un insieme di pacchetti preinstallati, indipendentemente dalla versione di Python e dai pacchetti nel Databricks Runtime sottostante.I valori supportati sono una versione ambientale di 3 o superiore, come '6', oppure la stringa 'None'. Il valore 'None' seleziona l'ambiente Python predefinito. Nel calcolo classico, impostare environment_version un valore diverso da 'None' richiede Databricks Runtime 18.2 o superiore. Su Databricks è supportato solo 'None' il runtime 16.2 fino alla 18.1. Quando sono supportate versioni di ambiente fisso, selezionane esplicitamente una per comportamento prevedibile.Nel calcolo serverless e nei magazzini SQL pro e serverless, alcune funzionalità richiedono una versione esplicita dell'ambiente. Impostare environment_version sulla versione richiesta o su una versione successiva in ogni definizione UDF. Omettere l'intera ENVIRONMENT clausola o impostazione environment_version = 'None' non abilita queste funzionalità. Vedi i requisiti delle funzionalità Python UDF.Per la compatibilità delle versioni di calcolo classico, vedi Versioni dell'ambiente su computo classico. Per l'elenco delle versioni disponibili, vedi Versioni dell'Ambiente. |
STRING |
environment_version = '6' |
Usare le UDF del Catalogo Unity in PySpark
from pyspark.sql.functions import expr

result = df.withColumn("bmi", expr("my_catalog.my_schema.calculate_bmi(weight_kg, height_m)"))
display(result)
Aggiornare una funzione definita dall'utente con ambito sessione
Nota
La sintassi e la semantica per le funzioni definite dall'utente Python nel Unity Catalog differiscono dalle funzioni definite dall'utente Python registrate in SparkSession. Vedere Funzioni scalari definite dall'utente - Python.
Data la funzione definita dall'utente basata su sessione seguente in un notebook di Azure Databricks:
from pyspark.sql.functions import udf
from pyspark.sql.types import StringType

@udf(StringType())
def greet(name):
    return f"Hello, {name}!"

# Using the session-based UDF
result = df.withColumn("greeting", greet("name"))
result.show()
Per registrare questa operazione come funzione del catalogo Unity, usare un'istruzione SQL CREATE FUNCTION, come nell'esempio seguente:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.greet(name STRING)
RETURNS STRING
LANGUAGE PYTHON
AS $$
return f"Hello, {name}!"
$$
Condividere UDF nel catalogo Unity
I controlli di accesso applicati al catalogo, allo schema o al database in cui viene registrata la UDF ne gestiscono le autorizzazioni. Per altre informazioni, vedere Gestire i privilegi in Unity Catalog .
Usare Azure Databricks SQL o l'interfaccia utente dell'area di lavoro di Azure Databricks per concedere autorizzazioni a un utente o a un gruppo (scelta consigliata).
Autorizzazioni nell'interfaccia utente dell'area di lavoro
- Trova il catalogo e lo schema in cui è archiviata la UDF e seleziona l'UDF.
- Cercare un'opzione Autorizzazioni nelle impostazioni dell'UDF. Aggiungere utenti o gruppi e specificare il tipo di accesso necessario, ad esempio EXECUTE o MANAGE.

Autorizzazioni con Azure Databricks SQL
L'esempio seguente concede a un utente l'autorizzazione EXECUTE per una funzione:
GRANT EXECUTE ON FUNCTION my_catalog.my_schema.calculate_bmi TO `user@example.com`;
Per rimuovere le autorizzazioni, usare il comando REVOKE come nell'esempio seguente:
REVOKE EXECUTE ON FUNCTION my_catalog.my_schema.calculate_bmi FROM `user@example.com`;
Isolamento dell'ambiente
Nota
Gli ambienti di isolamento condiviso richiedono Databricks runtime 18.1 e superiori. Nelle versioni precedenti, tutte le funzioni definite dall'utente Python di Unity Catalog vengono eseguite in modalità di isolamento rigoroso.
Le funzioni definite dall'utente Python del catalogo Unity con lo stesso proprietario e la stessa sessione possono condividere un ambiente di isolamento come impostazione predefinita. Ciò migliora le prestazioni e riduce l'utilizzo della memoria riducendo il numero di ambienti separati che devono essere avviati.
Isolamento rigoroso
Per verificare che una UDF venga sempre eseguita in un ambiente completamente isolato, aggiungere la clausola CHARACTERISTIC STRICT ISOLATION.
La maggior parte delle UDF non richiede un isolamento rigoroso. Le funzioni definite dall'utente per l'elaborazione dati standard traggono vantaggio dall'ambiente predefinito di isolamento condiviso ed eseguono più velocemente con un consumo di memoria inferiore.
Aggiungere la clausola caratteristica alle UDF STRICT ISOLATION che:
- Eseguire l'input come codice usando
eval(),exec()o funzioni simili. - Scrivere file nel file system locale.
- Modificare le variabili globali o lo stato del sistema.
- Accedere o modificare le variabili di ambiente.
Il codice seguente mostra un esempio di UDF che deve essere eseguita utilizzando STRICT ISOLATION. Questa UDF esegue codice Python arbitrario, quindi potrebbe modificare lo stato del sistema, accedere alle variabili di ambiente o scrivere sul file system locale. L'utilizzo della clausola STRICT ISOLATION aiuta a prevenire interferenze o perdite di dati tra le funzioni definite dall'utente.
CREATE OR REPLACE TEMPORARY FUNCTION run_python_snippet(python_code STRING)
RETURNS STRING
LANGUAGE PYTHON
STRICT ISOLATION
AS $$
import sys
from io import StringIO

# Capture standard output and error streams
captured_output = StringIO()
captured_errors = StringIO()
sys.stdout = captured_output
sys.stderr = captured_errors

try:
    # Execute the user-provided Python code in an empty namespace
    exec(python_code, {})
except SyntaxError:
    # Retry with escaped characters decoded (for cases like "\n")
    def decode_code(raw_code):
        return raw_code.encode('utf-8').decode('unicode_escape')
    python_code = decode_code(python_code)
    exec(python_code, {})

# Return everything printed to stdout and stderr
return captured_output.getvalue() + captured_errors.getvalue()
$$
Impostare DETERMINISTIC se la funzione produce risultati coerenti
Aggiungere DETERMINISTIC alla definizione della funzione se produce gli stessi output per gli stessi input. Ciò consente alle ottimizzazioni delle query di migliorare le prestazioni.
Per impostazione predefinita, Azure Databricks considera le funzioni definite dall'utente Python (UDF) di Unity Catalog Batch come non deterministiche, a meno che non venga esplicitamente dichiarato il contrario. Esempi di funzioni non deterministiche includono la generazione di valori casuali, l'accesso a date o ore correnti o l'esecuzione di chiamate API esterne.
Vedere CREATE FUNCTION (SQL, Python, Scala e Java)
UDF per strumenti per agenti
Gli agenti di IA possono usare le UDF di Unity Catalog come strumenti per svolgere attività ed eseguire logiche personalizzate.
Vedi Creare strumenti per agenti con le funzioni di Unity Catalog.
Funzioni UDF (definite dall'utente) per l'accesso alle API esterne
È possibile usare le funzioni definite dall'utente per accedere da SQL alle API esterne. L'esempio seguente usa la libreria Python requests per effettuare una richiesta HTTP.
Nota
Le UDF Python consentono il traffico di rete TCP/UDP sulle porte 80, 443 e 53 quando si utilizza il calcolo serverless o il calcolo configurato con la modalità di accesso standard.
CREATE FUNCTION my_catalog.my_schema.get_food_calories(food_name STRING)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import requests

api_url = f"https://example-food-api.com/nutrition?food={food_name}"
response = requests.get(api_url)

if response.status_code == 200:
   data = response.json()
   # Assume the API returns a JSON object with a 'calories' field
   calories = data.get('calories', 0)
   return calories
else:
   return None  # API request failed

$$;
Funzioni definite dall'utente per la sicurezza e la conformità
Usare le funzioni definite dall'utente Python per implementare tokenizzazione personalizzata, mascheramento dei dati, redazione dei dati o meccanismi di crittografia.
L'esempio seguente maschera l'identità di un indirizzo di posta elettronica mantenendo la lunghezza e il dominio:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.mask_email(email STRING)
RETURNS STRING
LANGUAGE PYTHON
DETERMINISTIC
AS $$
parts = email.split('@', 1)
if len(parts) == 2:
  username, domain = parts
else:
  return None
masked_username = username[0] + '*' * (len(username) - 2) + username[-1]
return f"{masked_username}@{domain}"
$$
L'esempio seguente applica questa UDF in una definizione di visualizzazione dinamica.
-- First, create the view
CREATE OR REPLACE VIEW my_catalog.my_schema.masked_customer_view AS
SELECT
  id,
  name,
  my_catalog.my_schema.mask_email(email) AS masked_email
FROM my_catalog.my_schema.customer_data;

-- Now you can query the view
SELECT * FROM my_catalog.my_schema.masked_customer_view;
+---+------------+------------------------+------------------------+
| id|        name|                   email|           masked_email |
+---+------------+------------------------+------------------------+
|  1|    John Doe|   john.doe@example.com |  j*******e@example.com |
|  2| Alice Smith|alice.smith@company.com |a**********h@company.com|
|  3|   Bob Jones|    bob.jones@email.org |   b********s@email.org |
+---+------------+------------------------+------------------------+
Procedure consigliate
Affinché le funzioni definite dall'utente siano accessibili a tutti gli utenti, Databricks consiglia di creare un catalogo e uno schema dedicati con controlli di accesso appropriati.
Per le funzioni definite dall'utente specifiche del team, usare uno schema dedicato all'interno del catalogo del team per l'archiviazione e la gestione.
Databricks consiglia di includere le informazioni seguenti nella documentazione UDF:
- Numero di versione corrente
- Log delle modifiche per tenere traccia delle modifiche tra le versioni
- Scopo, parametri e valore restituito della funzione definita dall'utente (UDF)
- Un esempio di come usare la UDF (funzione definita dall'utente)
L'esempio seguente mostra una UDF che segue le buone pratiche:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight_kg DOUBLE, height_m DOUBLE)
RETURNS DOUBLE
COMMENT "Calculates Body Mass Index (BMI) from weight and height."
LANGUAGE PYTHON
DETERMINISTIC
AS $$
 """
Parameters:
calculate_bmi (version 1.2):
- weight_kg (float): Weight of the individual in kilograms.
- height_m (float): Height of the individual in meters.

Returns:
- float: The calculated BMI.

Example Usage:

SELECT calculate_bmi(weight, height) AS bmi FROM person_data;

Change Log:
- 1.0: Initial version.
- 1.1: Improved error handling for zero or negative height values.
- 1.2: Optimized calculation for performance.

 Note: BMI is calculated as weight in kilograms divided by the square of height in meters.
 """
if height_m <= 0:
 return None  # Avoid division by zero and ensure height is positive
return weight_kg / (height_m ** 2)
$$;
Comportamento del fuso orario del timestamp per input una riga alla volta
Un input TIMESTAMP raggiunge una UDF Python che elabora una riga alla volta come valore datetime senza fuso orario in UTC. Nel calcolo classico, questo comportamento richiede Databricks Runtime 18.1 o superiore. Nel calcolo serverless e nei warehouse SQL Pro e Serverless, imposta esplicitamente environment_version dell'UDF su 6 o versione successiva. L'oggetto datetime non include i metadati del fuso orario nel suo tzinfo attributo.
Catalogo Batch Unity I UDF Python ricevono input temporali negli pandas.Series oggetti e non utilizzano questa datetime mappatura.
Questa modifica allinea le UDF Python del catalogo Unity con le UDF Python ottimizzate con Arrow in Apache Spark.
Ad esempio, la seguente query imposta esplicitamente la versione 6 dell'ambiente e il fuso orario della sessione su UTC:
SET TIME ZONE 'UTC';

CREATE FUNCTION timezone_udf(date TIMESTAMP)
RETURNS STRING
LANGUAGE PYTHON
ENVIRONMENT (
  environment_version = '6'
)
AS $$
return f"{type(date)} {date} {date.tzinfo}"
$$;

SELECT timezone_udf(TIMESTAMP '2024-10-23 10:30:00');
Il percorso di esecuzione precedente restituisce un valore consapevole del fuso orario nel fuso orario della sessione. Questo vale sul calcolo classico prima di Databricks Runtime 18.1. Si applica anche all'elaborazione serverless e ai data warehouse SQL Pro e serverless quando ometti la clausola ENVIRONMENT, imposti environment_version = 'None' o selezioni una versione precedente alla 6. Con il fuso orario della sessione impostato su UTC, il percorso precedente produce:
<class 'datetime.datetime'> 2024-10-23 10:30:00+00:00 UTC
Con la definizione mostrata, serverless compute, Pro e i SQL warehouse serverless utilizzano il comportamento compatibile con PySpark. Il calcolo classico che esegue Databricks Runtime 18.1 o superiori usa lo stesso comportamento quando si aggiutica o si omette la ENVIRONMENT clausola:
<class 'datetime.datetime'> 2024-10-23 10:30:00 None
Questa modifica può influenzare i campi dell'orologio oltre a tzinfo. Per il momento 2024-10-23T10:30:00Z, il comportamento precedente in una sessione America/Los_Angeles produce 2024-10-23 03:30:00-07:00. Il nuovo comportamento produce il valore UTC 2024-10-23 10:30:00 senza fuso orario.
Se il tuo UDF si basa sulle informazioni sul fuso orario, ripristina esplicitamente UTC:
from datetime import timezone

date = date.replace(tzinfo=timezone.utc)
L'aggiunta delle informazioni sul fuso orario UTC non ripristina i precedenti campi locali dell'orologio della sessione. Se la tua logica ha bisogno di quei campi, converti anche il valore consapevole nel fuso orario previsto della sessione. Per esempio:
from zoneinfo import ZoneInfo

date = date.astimezone(ZoneInfo("America/Los_Angeles"))
Limiti
- È possibile definire un numero qualsiasi di funzioni Python all'interno di una funzione definita dall'utente (UDF) di Python, ma tutte queste devono restituire un valore scalare.
- Le funzioni Python devono gestire i valori NULL in modo indipendente e tutti i mapping dei tipi devono seguire i mapping del linguaggio SQL di Azure Databricks.
- Se non si specifica un catalogo o uno schema, Azure Databricks registra le funzioni Python definite dall'utente nello schema attualmente attivo.
- Le UDF Python vengono eseguite in un ambiente sicuro e isolato e non hanno accesso ai file system o ai servizi interni.
- Puoi chiamare più di cinque UDF in una query sul compute classico con Databricks Runtime 18.1 o versione successiva. Nell'elaborazione serverless e nei SQL warehouse Pro e serverless, ogni definizione di UDF deve essere impostata esplicitamente su
environment_versiona6o versione successiva.