Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Importante
Gli elementi contrassegnati come anteprima in questo articolo sono attualmente in anteprima. Questa anteprima viene fornita senza un contratto di servizio e Microsoft non lo consiglia per i carichi di lavoro di produzione. Alcune funzionalità potrebbero non essere supportate o potrebbero avere funzionalità limitate. Per ulteriori informazioni, vedere Condizioni supplementari per l'uso delle versioni di anteprima di Microsoft Azure.
Importante
Il training interattivo richiede l'approvazione esplicita dell'accesso. Richiedi l'accesso tramite il modulo di iscrizione dell'anteprima e attendi l'approvazione prima di creare una sessione di training.
Il training interattivo (anteprima) è un'API per la creazione di un ciclo post-training personalizzato su modelli open weight in Microsoft Foundry. Controlli l'esperimento in Python. Foundry esegue il campionamento dei modelli e gli aggiornamenti di adattamento a rango ridotto (LoRA) nelle GPU serverless.
Per l'apprendimento per rinforzo (RL), il codice controlla la raccolta dei rollout, i premi, i vantaggi e la pianificazione degli aggiornamenti. Le stesse primitive supportano l'apprendimento supervisionato, l'apprendimento delle preferenze, la distillazione e i flussi di lavoro con perdita personalizzata.
Quando usarlo
Usare il training interattivo quando il ciclo di training stesso fa parte della ricerca:
- È necessario un segnale di apprendimento personalizzato. Fornire dimostrazioni, calcolare ricompense e vantaggi o comporre una perdita locale per l'apprendimento delle preferenze o altri obiettivi.
- Il modello interagisce con un ambiente. Coordina le risposte del modello, le chiamate agli strumenti, le osservazioni e le ricompense nel driver.
- È necessario controllare i singoli aggiornamenti. Selezionare batch, maschere token, impostazioni di perdita e parametri dell'ottimizzatore. Decidi quando accumulare gradienti e applicare un aggiornamento.
- Si vuole esaminare e adattare un esperimento. Esempio dell'adattatore corrente, valutare i prompt esclusi dalla fase di addestramento e scegliere i prompt successivi in base ai risultati osservati.
- È necessario mantenere e proseguire i progressi. Salva lo stato dell'adattatore e dell'ottimizzatore, quindi riprendi in una sessione compatibile. Mantenere la posizione del set di dati e altri stati dell'esperimento nel driver.
L'ottimizzazione gestita supporta anche i valutatori per l'ottimizzazione per rinforzo. Scegliere il training interattivo quando è necessario controllare il ciclo, non solo le impostazioni del grader o del job. Vedi Scegliere l'approccio di training.
Chi fa quello che fa
Il tuo programma Python è il driver di addestramento. Prepara gli input e coordina l'esperimento. Foundry mantiene lo stato del modello e dell'adattatore ed esegue le operazioni richieste.
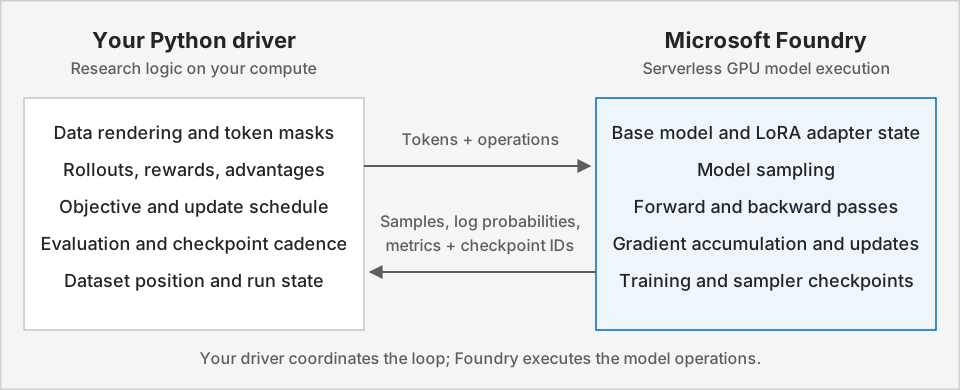
Il driver può essere eseguito su una CPU, incluso il tuo computer o un ambiente di calcolo. Un modello di ricompensa o un ambiente che aggiungi può avere requisiti di calcolo specifici. Mantenere il driver in esecuzione mentre gestisce il ciclo.
Concetti di base e primitive
Una sessione mantiene lo stato: il calcolo del gradiente, gli aggiornamenti dell'ottimizzatore e il campionamento sono operazioni separate su un modello e un adattatore selezionati. Questa separazione consente di scegliere quando raccogliere dati, accumulare gradienti, aggiornare e valutare.
| Blocco di base | Funzionamento |
|---|---|
| Sessione di addestramento e adattatore LoRA |
FineTuningSession.create inizializza un modello di base supportato con la configurazione dell'adattatore. La sessione contiene lo stato utilizzato dalle operazioni successive. |
| Batch e maschere tokenizzati |
Datum contiene input del modello e input della funzione di perdita. Le maschere selezionano i token che contribuiscono all'apprendimento, ad esempio token di assistente anziché richieste o osservazioni degli strumenti. |
| campionamento |
sample genera risposte da un checkpoint sampler selezionato. Gli input RL associano token campionati con le log-probabilità del rollout e i vantaggi derivati dalla ricompensa. |
| Passaggi in avanti e all’indietro |
forward restituisce gli output della funzione di perdita per ciascun esempio senza accumulare gradienti.
forward_backward calcola l'obiettivo selezionato e accumula gradienti. Non applica un aggiornamento dell'Optimizer. |
| Aggiornamento di Optimizer |
optim_step applica gradienti accumulati con i parametri Adam. Scegliere quando aggiornare e quale tasso di apprendimento usare. |
| Punto di controllo del campionatore |
save_weights_for_sampler prepara i pesi dell'adattatore per la generazione. Aggiorna questi pesi dopo un aggiornamento prima del campionamento dall'adattatore aggiornato. |
| Punto di controllo della formazione |
save_weights rende persistenti i pesi dell'adattatore e lo stato dell'ottimizzatore.
FineTuningSession.create_from_checkpoint riprende il training in una sessione compatibile. |
L'SDK include cross_entropy per gli aggiornamenti supervisionati e perdite RL come importance_sampling e ppo. Queste perdite sono primitive di perdita, non algoritmi end-to-end predefiniti. Per i contratti di ingresso e la composizione della funzione di perdita personalizzata, vedere Concetti chiave.
Funzionamento di un ciclo RL
Si consideri un esperimento di ragionamento matematico: il modello genera diverse risposte a ogni problema e il programma ne valuta la correttezza. Per un esempio pratico, seguire Guida introduttiva.
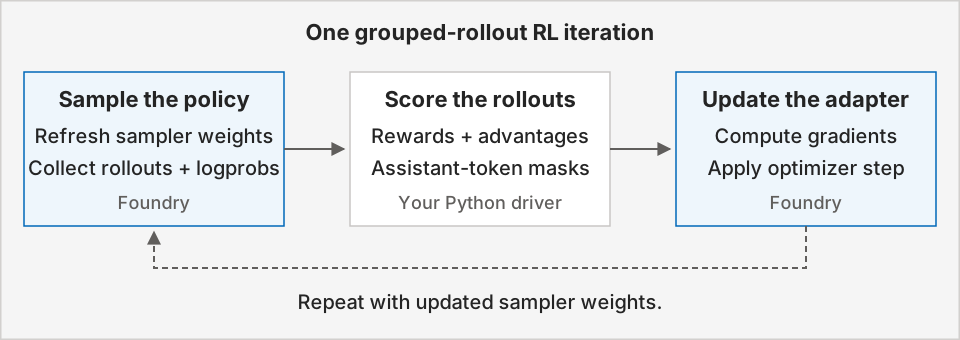
Stabilire una baseline di validazione separata e testare la funzione di ricompensa prima del primo aggiornamento. Quindi ripetere:
- Preparare la politica corrente per il campionamento. Salvare i pesi del campionatore dall'adattatore di training, quindi raccogliere diverse risposte o rollout per ogni richiesta.
- Assegnare un punteggio e confrontare le risposte. La funzione di ricompensa assegna un punteggio a ogni rollout. Sottrarre la ricompensa media del gruppo di prompt per produrre il vantaggio di ogni rollout.
- Prepara il segnale di training. Allineare i token di assistente campionati con le probabilità log del rollout e i vantaggi. Escludere i prompt e le osservazioni dell'ambiente dal segnale di apprendimento.
- Calcola i gradienti. Inviare il batch a
forward_backwardconimportance_sampling. Completare il calcolo del gradiente prima dell'aggiornamento che lo utilizza. - Aggiorna l'adattatore. Chiamare
optim_step, quindi aggiornare i pesi del campionatore prima di raccogliere risposte dalla policy aggiornata. - Valutare e preservare i progressi. Confrontare la correttezza sui dati held-out con la baseline e salvare i checkpoint di training con la cadenza scelta.
Get started
Scegliere il punto di partenza adatto all'attività:
- Guida introduttiva: Seguire l'esempio di avvio rapido per clonare il repository ed eseguire una breve ricetta di apprendimento per rinforzo.
- Prova altre ricette: Esplora il repository degli esempi di fine-tuning per altri esempi di training.
- Cerca un'operazione: Usa la guida rapida SDK (anteprima) per le funzioni e i parametri chiave.
- Comprendere il ciclo di training: Leggere Concetti chiave per premi, vantaggi, maschere token e checkpoint.
Modelli e aree supportati
Consulta la panoramica dell'ottimizzazione per i modelli supportati e le aree geografiche supportate.