Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
L'elaborazione flessibile (anteprima) offre inferenza a 50% sconto rispetto all'elaborazione Standard per i carichi di lavoro che possono tollerare tempi di risposta più lenti e occasionali indisponibilità delle risorse. Selezionare l'elaborazione Flex per una singola richiesta dell'API Responses o dell'API Chat Completions impostando service_tier su flex.
Usare l'elaborazione Flex per operazioni non interattive e con priorità inferiore, ad esempio valutazioni del modello, arricchimento dei dati, analisi dei documenti e flussi di lavoro asincroni delle applicazioni. Per i carichi di lavoro sensibili alla latenza o alla capacità, usare invece l'elaborazione standard, l'elaborazione prioritaria o la capacità effettiva con provisioning.
Importante
Con l'introduzione dell'elaborazione Flex, le richieste impostate su service_tierflex vengono elaborate solo quando il modello selezionato supporta l'elaborazione Flex. Un modello non supportato restituisce un errore HTTP 400 invalid_request_error e non passa all'elaborazione Standard. L'elaborazione Flex non prevede alcun SLA di latenza né SLA di servizio.
Prerequisiti
Una sottoscrizione di Azure. Creane uno gratis.
Una risorsa OpenAI di Azure con un modello supportato distribuito tramite il tipo di distribuzione Global Standard.
L'endpoint della risorsa e una chiave API o le credenziali Microsoft Entra ID. Gli esempi in questo articolo usano una chiave API archiviata nella
AZURE_OPENAI_API_KEYvariabile di ambiente.Un carico di lavoro in grado di tollerare una latenza variabile e risposte transitorie di risorsa non disponibile.
Python 3.10 o versione successiva e il pacchetto Python OpenAI per gli esempi di Python:
pip install --upgrade openai
Inviare una richiesta Flex
Impostare service_tier su flex in ogni richiesta che deve utilizzare l'elaborazione Flex. Il model valore è il nome della distribuzione del modello di Azure.
Python
L'esempio seguente invia una richiesta Flex usando l'API Risposte:
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
La risposta contiene l'analisi generata e il livello di servizio che elabora la richiesta.
Riferimento:Responses API
REST
L'esempio seguente invia la stessa richiesta direttamente all'API Risposte:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Per verificare quale livello elabora la richiesta, controllare il service_tier campo in una risposta con esito positivo.
Informazioni di riferimento:Informazioni di riferimento sulle API REST per le risposte
Scegliere un'opzione di elaborazione
L'elaborazione flex, Standard e Priority sono scelte di livello di servizio per le richieste API online. Batch e velocità effettiva con provisioning sono opzioni di distribuzione e acquisto separate.
| Opzione | Come selezionarlo | Latenza e disponibilità | Modello di costi | Migliore per |
|---|---|---|---|---|
| Elaborazione flessibile | Impostare il livello service_tier di richiesta su flex. |
Latenza variabile. Le richieste possono restituire HTTP 429 quando la capacità Flex non è disponibile. | 50% sconto rispetto alle tariffe dei token Standard. Si applicano anche gli sconti per i token memorizzati nella cache. | Valutazioni, arricchimenti, analisi offline e attività in background tolleranti ai ritardi. |
| Elaborazione standard | Impostare il livello service_tier di richiesta su defaulto usare il livello Standard configurato per la distribuzione. |
Elaborazione online ottimale per carichi di lavoro generali. | Tariffa standard con pagamento per token. | Carichi di lavoro di sviluppo, test e produzione con traffico variabile. |
| Elaborazione prioritaria | Configurare Priorità nella distribuzione o impostare il livello service_tier di richiesta su priority. |
Latenza più bassa e coerente, con una destinazione definita per i modelli supportati. | Tariffa con pay-per-token prioritario. | Applicazioni online sensibili alla latenza senza un impegno di capacità riservata. |
| Batch | Inviare un processo batch asincrono a una distribuzione Batch. | L'obiettivo è completare i risultati entro 24 ore. Nessun obiettivo di latenza in tempo reale. | Tariffa scontata per batch. | Processi offline di grandi dimensioni che non richiedono una risposta immediata. |
| Larghezza di banda allocata | Crea una distribuzione con provisioning e acquista o riserva unità di throughput con provisioning (PTU). | Capacità riservata con velocità effettiva e latenza prevedibili. | Fatturazione PTU oraria o prenotazione Azure. | Carichi di lavoro di produzione cruciali con volumi elevati. |
Scegliere Elaborazione flessibile quando si applicano tutte le condizioni seguenti:
- Il carico di lavoro può tollerare tempi di elaborazione più lunghi e variabili.
- Si preferisce un costo inferiore rispetto alla latenza prevedibile.
- L'applicazione può ripetere gli errori temporanei o indirizzare una richiesta non riuscita all'elaborazione Standard.
- Il modello selezionato e il contesto di richiesta sono supportati.
Non usare l'elaborazione Flex quando si applica una delle condizioni seguenti:
- Un utente è in attesa di una risposta interattiva.
- La richiesta deve essere completata entro un rigido obiettivo di latenza.
- L'applicazione non può tollerare o riprovare risposte HTTP 429 temporanee.
- È necessaria capacità di elaborazione riservata o velocità effettiva prevedibile.
L'elaborazione flessibile presenta le caratteristiche seguenti:
-
Selezione a livello di richiesta: Impostare
service_tiersuflexper ogni richiesta che deve usare l'elaborazione Flex. - Nessuna distribuzione separata: Inviare richieste Standard e Flex alla stessa distribuzione Standard globale e selezionare il livello per richiesta.
- API supportate: Utilizza la Responses API o la Chat Completions API.
- Risposta sincrona: La chiamata API rimane sincrona, anche se il carico di lavoro può richiedere più tempo per il completamento. L'elaborazione flessibile non è identica all'API Batch.
- Disponibilità dipendente dalla capacità: Una richiesta può restituire HTTP 429 quando la capacità Flex non è disponibile.
-
Nessun fallback standard automatico: L'applicazione deve riprovare in modo esplicito con
service_tierimpostato sudefaultse l'elaborazione Standard è accettabile. - Quota condivisa: Le richieste Flex e Standard usano la quota assegnata alla distribuzione Standard globale.
- Stessa qualità di output del modello: Flex usa lo stesso modello sottostante di Standard. Il livello di elaborazione modifica la latenza, la disponibilità e il prezzo, non la qualità del modello.
Note
I token di input e output flessibili ricevono uno sconto di 50% rispetto alle tariffe dei token Standard corrispondenti. Anche i token di input memorizzati nella cache che sono idonei ricevono lo sconto applicabile ai token memorizzati nella cache. Per le tariffe correnti, vedere prezzi Azure OpenAI.
Esaminare i modelli supportati
Al lancio, l'elaborazione Flex ha una disponibilità limitata di modelli.
gpt-5.6-sol è il primo modello supportato. Nella tabella seguente sono elencati i modelli supportati. Microsoft aggiunge altri modelli man mano che diventa disponibile il supporto.
| Model | Versione | Tipo di distribuzione | Disponibilità della regione |
|---|---|---|---|
gpt-5.6-sol |
2026-07-09 |
Standard globale | Tutte le aree Azure in cui è disponibile Global Standard |
Controllare questa tabella prima di inviare una richiesta Flex. Non presupporre che un modello o una nuova versione del modello supporti l'elaborazione Flex perché supporta l'elaborazione Standard o Priority. Un modello non supportato restituisce HTTP 400. Per evitare di causare interruzioni dell'applicazione, implementare un fallback a livello di applicazione al livello di elaborazione Standard quando i prezzi e le prestazioni del livello Standard sono accettabili.
Passa all'elaborazione standard
L'elaborazione flex non instrada automaticamente una richiesta a Standard quando la capacità Flex non è disponibile. Se il completamento della richiesta è più importante rispetto alla conservazione dei prezzi flex, ripetere la richiesta con service_tier impostato su default.
L'esempio seguente utilizza un criterio con priorità al completamento. Tenta prima di tutto l'elaborazione Flex e riprova una volta con l'elaborazione Standard dopo qualsiasi risposta HTTP 429:
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
Il fallback a Standard modifica le caratteristiche dei prezzi e delle prestazioni della richiesta. Usare questo modello solo quando il carico di lavoro può accettare prezzi Standard.
Una risposta HTTP 429 può indicare capacità flex non disponibile o un limite di quota. Poiché l'elaborazione Flex e Standard condividono la stessa quota, anche la richiesta Standard potrebbe non andare a buon fine se la risposta originale era dovuta ai limiti di quota. Applica limiti per i tentativi e gestisci un secondo RateLimitError nella tua applicazione. Quando il servizio restituisce l'identificatore di errore specifico per Flex, usalo per limitare il fallback alle risposte relative alla capacità.
Per i carichi di lavoro che assegnano priorità al costo più basso, ripetere l'elaborazione Flex con backoff esponenziale prima di eseguire il fallback. Per i carichi di lavoro che assegnano priorità al tempo di completamento, eseguire il fallback a Standard dopo il primo errore di capacità Flex.
Informazioni di riferimento:RateLimitError
Gestire gli errori di Flex
Distinguere gli errori di richiesta permanente dagli errori di capacità temporanei.
| Stato HTTP | Error | Cause | Gestione consigliata |
|---|---|---|---|
| 400 | invalid_request_error |
Il modello selezionato, la versione del modello, la lunghezza del contesto, l'API o la configurazione della richiesta non supporta l'elaborazione Flex. | Non riprovare la stessa richiesta senza modificarla. Selezionare un modello o una lunghezza del contesto supportata oppure riprovare in modo esplicito con service_tier impostato su default. |
| 408 | Timeout richiesta | La richiesta non viene completata entro il timeout del client o del servizio configurato. Le richieste flex possono richiedere più tempo rispetto alle richieste Standard. | Usare un timeout del client più lungo. Riprovare con backoff esponenziale delimitato. Se il tempo di completamento è più importante rispetto ai prezzi flex, riprovare con Standard. |
| 429 | Risorsa non disponibile o limitata a frequenza | La capacità Flex è temporaneamente indisponibile, oppure la richiesta ha superato un limite di frequenza applicabile. La capacità flessibile è soggetta a prelazione, quindi l'indisponibilità temporanea è più probabile durante le ore di punta. | Se la richiesta ha superato un limite di frequenza, aumentare il limite di frequenza della distribuzione Standard globale assegnando una quota maggiore. Flex e Standard condividono questa quota. Se la sottoscrizione non dispone di una quota sufficiente per un carico di lavoro a throughput elevato, richiedi un aumento della quota. Se la capacità Flex è temporaneamente indisponibile, riprovare con un backoff esponenziale e jitter, distribuire i carichi di lavoro che tollerano ritardi in fasce orarie non di punta, ad esempio le notti dei giorni feriali o i fine settimana, oppure riprovare con service_tier impostato su default. Onora Retry-After quando presente. |
| 500, 502, 503 o 504 | Errore temporaneo del servizio | Un problema temporaneo del servizio o del gateway ha impedito il completamento. | Riprovare con backoff esponenziale delimitato. Non inviare un numero illimitato di tentativi. |
| 401 o 403 | Errore di autenticazione o autorizzazione | Le credenziali sono mancanti, non valide, scadute o non hanno accesso alla risorsa. | Correggere le credenziali o l'assegnazione di ruolo. Non riprovare finché la configurazione non viene modificata. |
| 404 | La distribuzione non è stata trovata | Il nome o l'endpoint della distribuzione non è corretto. | Verificare che model corrisponda al nome della distribuzione e che l'URL di base punti alla risorsa OpenAI corretta Azure. |
Note
Una richiesta Flex rifiutata perché la capacità di elaborazione non è disponibile non viene fatturata. Tuttavia, è possibile notare una capacità inferiore al limite di velocità disponibile poiché le richieste Flex e Standard condividono la quota assegnata alla distribuzione Global Standard.
Usa il backoff esponenziale con jitter casuale per le risposte HTTP 408, 429 e 5xx transitorie. Impostare un numero massimo di tentativi e un ritardo massimo in modo che una richiesta non riuscita non rimanga in un ciclo di tentativi non associato.
- Mantenere
Retry-Afterquando è incluso nella risposta. - In caso contrario, attendere per un intervallo esponenzialmente crescente con jitter casuale.
- Ritentare Flex solo finché il ritardo rimane accettabile per il carico di lavoro.
- Ripiegare su Standard se il budget dei tentativi è esaurito e l'applicazione ammette il costo più elevato del livello Standard.
- Restituisce un errore esplicito se né l'elaborazione Flex ritardata né il fallback Standard soddisfano i requisiti dell'applicazione.
Non ripetere ripetutamente la stessa richiesta Flex non supportata. Un nuovo tentativo ha esito positivo solo dopo aver modificato il modello, la lunghezza del contesto, la configurazione dell'API o il livello di servizio.
Monitorare l'utilizzo e i costi
Usare Monitoraggio di Azure metriche per confrontare il traffico Flex e Standard nella stessa distribuzione. Monitorare il volume delle richieste, il consumo di token, la latenza, gli errori e la frequenza con cui le richieste Flex rientrano in Standard nell'applicazione.
Accedi al portale di Azure.
Passare alla risorsa Azure OpenAI e selezionare Metriche.
Aggiungi la metrica Azure OpenAI Requests. È anche possibile aggiungere Latenza di Azure OpenAI, Utilizzo di Azure OpenAI e metriche di errore.
Aggiungere un filtro in cui ServiceTierRequest è uguale a
flex.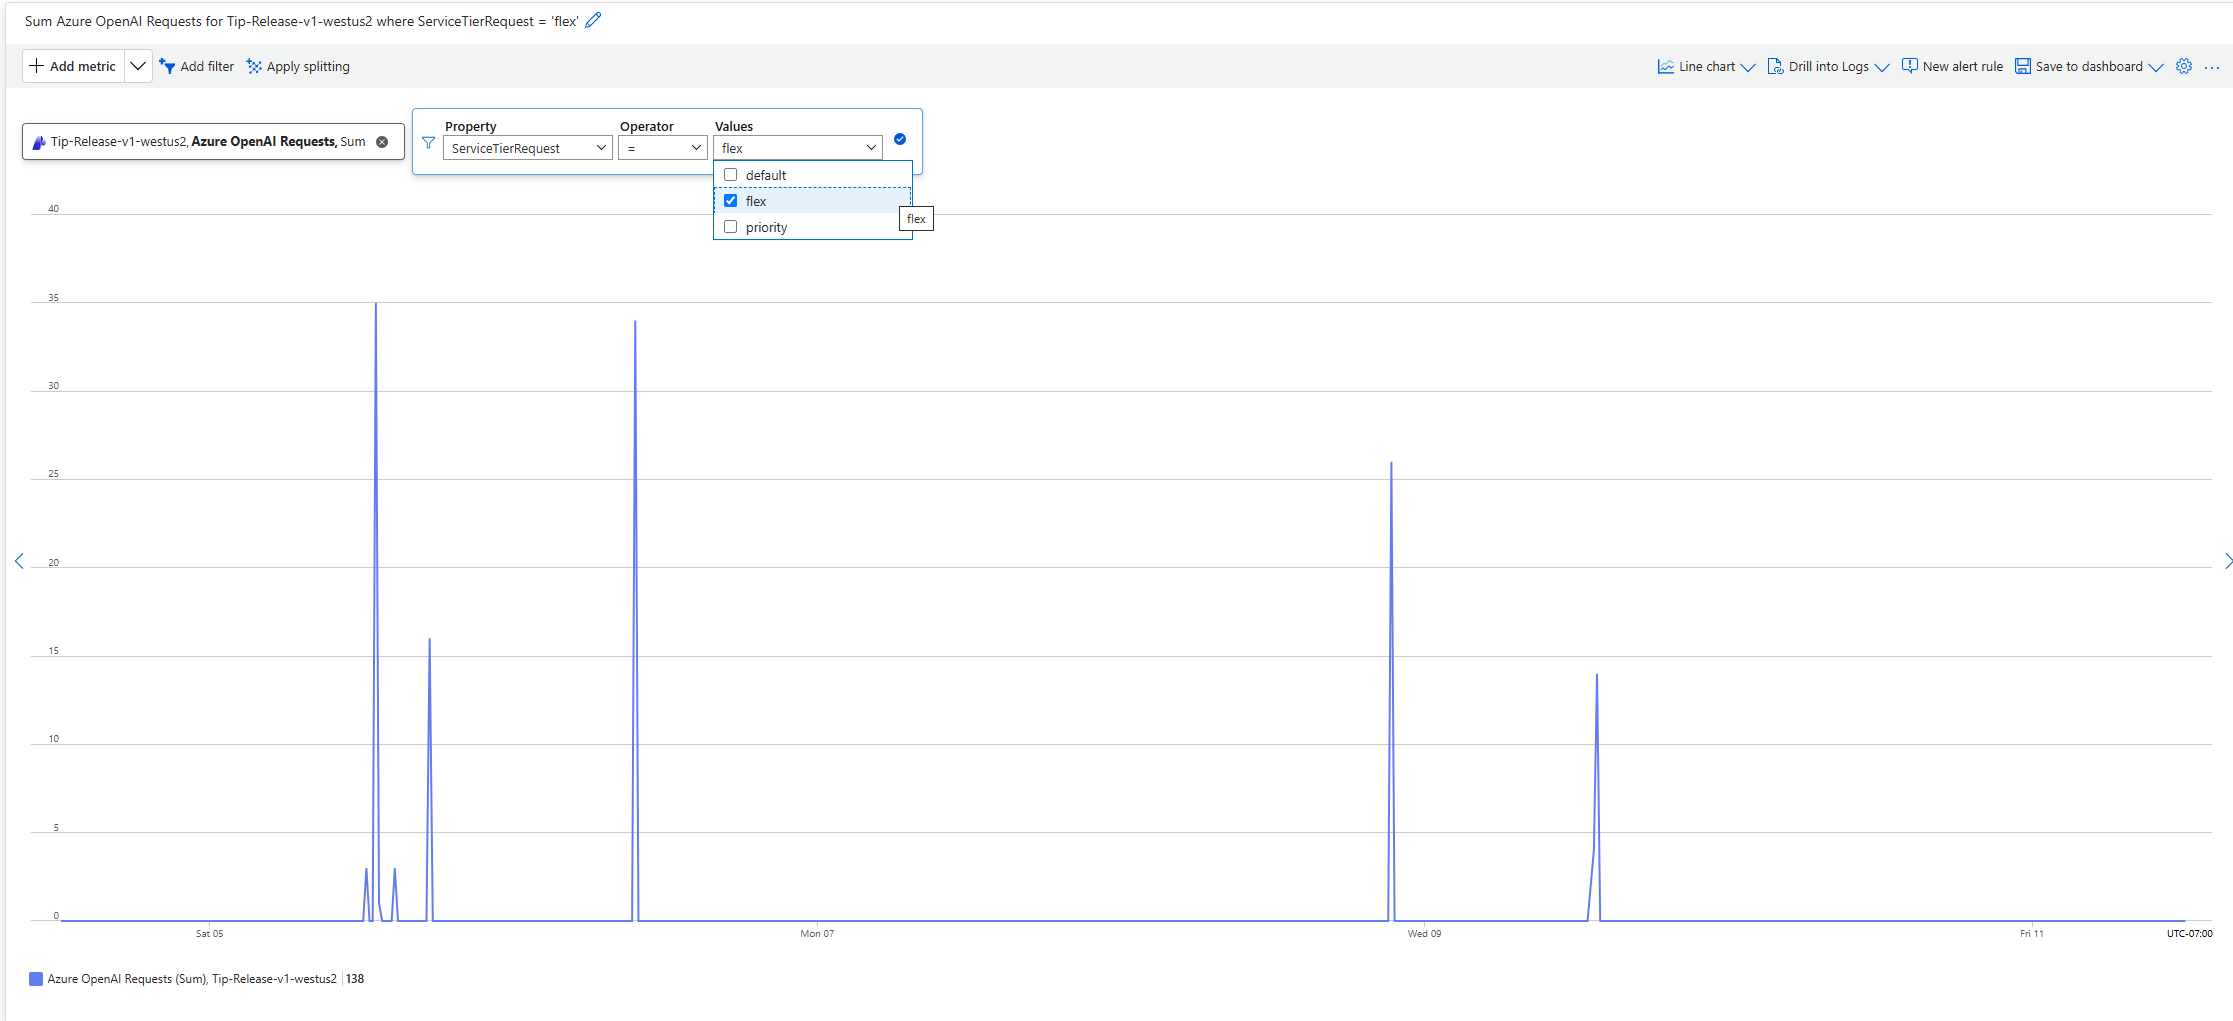
Creare avvisi per risposte HTTP 429 persistenti, aumenti dei tassi di errore e latenza che supera il budget dei nuovi tentativi del carico di lavoro.
Tenere traccia dei segnali seguenti per ogni carico di lavoro:
| Segnale | Perché è importante |
|---|---|
| Numero di richieste Flex | Mostra l'adozione e il traffico instradato verso l'elaborazione a costo inferiore. |
| Tasso di richieste Flex completate con successo | Mostra la frequenza con cui la capacità Flex accetta e completa le richieste. |
| Frequenza HTTP 429 | Mostra i periodi in cui la capacità flex o la quota di distribuzione è vincolata. |
| Conteggio e tasso di fallback standard | Mostra il vantaggio di affidabilità e il costo aggiunto dal fallback controllato dall'applicazione. |
| Input, input memorizzato nella cache e token di output | Supporta l'attribuzione dei costi e verifica l'effetto della memorizzazione nella cache dei prompt. |
| Latenza da un'estremità all'altra | Consente di determinare se un carico di lavoro rimane adatto per Flex. |
Conteggio invalid_request_error HTTP 400 |
Identifica modelli non supportati, versioni del modello, lunghezze del contesto o configurazioni delle richieste. |
Per altre informazioni sul monitoraggio delle distribuzioni dei modelli, vedere Monitorare Azure OpenAI.
L'utilizzo Flex viene fatturato tramite contatori Flex dedicati, in modo da poterlo distinguere dall'utilizzo Standard. Usare Analisi dei costi per esaminare i costi dei token Flex in base alla risorsa e alla distribuzione.
- Nel portale di Azure aprire Gestione costi e analisi dei costi di fatturazione>.
- Filtra per la sottoscrizione, il gruppo di risorse o la risorsa Azure OpenAI che contiene la distribuzione.
- Raggruppa o filtra per Meter per separare l'utilizzo Flex da quello Standard.
- Aggiungere un filtro tag di fatturazione, selezionare distribuzione e scegliere il nome della distribuzione.
- Confronta i risparmi sui costi di Flex con i costi di ripiego di Standard e i requisiti per il completamento del carico di lavoro.
I token di input e output flessibili hanno un prezzo pari al 50% delle corrispondenti tariffe Standard. La cache dei prompt può ridurre ulteriormente il costo dei token di input idonei presenti nella cache. Una richiesta Flex rifiutata perché la capacità di elaborazione non è disponibile non viene fatturata.
Applicare le procedure consigliate per la produzione
- Impostare un timeout più lungo. Le richieste flex possono richiedere più tempo rispetto alle richieste Standard. Inizia con un timeout del client appropriato al tuo carico di lavoro, ad esempio 15 minuti, e prova con prompt rappresentativi.
- Usare tentativi limitati. Limitare i tentativi di ripetizione e il tempo totale trascorso.
- Aggiungi instabilità. Variare in modo casuale i ritardi di backoff per evitare picchi sincronizzati nei tentativi di ritentativo.
- Rendere esplicito il fallback. Impostare
service_tiersudefaultanziché basarsi sul comportamento implicito. - Tenere traccia del livello elaborato. Registrare il valore della risposta
service_tiercon latenza, stato, utilizzo dei token e dati sui costi. - Separare il traffico interattivo e quello in background. Mantenere le richieste rivolte all'utente alla capacità effettiva standard, prioritaria o con provisioning, a meno che la latenza flex variabile non sia accettabile.
- Controllare il lavoro duplicato. Assicurarsi che l'applicazione non invii più volte lo stesso processo logico dopo i timeout lato client.
- Testa i percorsi di errore. Convalidare la gestione per le risposte HTTP 400, 408, 429 e temporanee 5xx prima di usare l'elaborazione Flex nei flussi di lavoro di produzione.
- Esaminare il supporto del modello prima degli aggiornamenti. Una versione di modello o modello sostitutivo non eredita automaticamente il supporto Flex.
Sostituire il livello di servizio tramite un'intestazione della richiesta
Usare l'intestazione di richiesta x-ms-service-tier quando un gateway, un proxy o un livello di instradamento centralizzato deve selezionare il tier di servizio senza ispezionare o modificare il corpo della richiesta. L'intestazione può anche ridurre le modifiche alla migrazione per le applicazioni che selezionano già un livello di servizio OpenAI tramite un'intestazione di richiesta.
L'intestazione accetta i valori seguenti:
| Valore intestazione | Livello di elaborazione richiesto |
|---|---|
flex |
Flex |
priority |
Priorità |
default |
Standard |
auto |
Priorità |
Quando l'intestazione è presente e valida, ha la precedenza rispetto al valore service_tier nel corpo della richiesta.
| Campo intestazione | Input del corpo della richiesta | Comportamento e risultato |
|---|---|---|
| Intestazione omessa | Valore valido service_tier |
Il corpo della richiesta seleziona il livello. Una risposta con esito positivo identifica il livello elaborato in service_tier. |
| Valore di intestazione valido | Qualsiasi valore oppure nessun valore | L'intestazione seleziona il livello richiesto. Una risposta con esito positivo identifica il livello elaborato in service_tier. |
| Valore dell'intestazione non supportato | Qualsiasi valore oppure lasciato vuoto | La richiesta restituisce HTTP 400. Il servizio non usa come alternativa il valore nel corpo della richiesta. |
In questo esempio viene richiesta l'elaborazione Flex tramite l'intestazione . L'intestazione sovrascrive il valore default nel corpo della richiesta:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
L'intestazione di override non fornisce il fallback automatico. Un valore di intestazione non valido o un livello che la distribuzione selezionata non supporta restituisce HTTP 400.