Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
✔️ Si applica a: condivisioni file SMB e NFS classiche create con il provider di risorse Microsoft.Storage
✔️ Si applica a: Condivisioni di file create con il provider di risorse Microsoft.FileShares
File di Azure può soddisfare i requisiti di prestazioni per la maggior parte delle applicazioni e dei casi d'uso. Questo articolo illustra i diversi fattori che influiscono sulle prestazioni della condivisione file e su come ottimizzare le prestazioni di File di Azure per il carico di lavoro.
Glossario sulle prestazioni di archiviazione
Prima di leggere questo articolo, è utile comprendere alcuni termini chiave relativi alle prestazioni di archiviazione:
Operazioni di I/O al secondo (IOPS)
Le operazioni di I/O o input/output al secondo misurano il numero di operazioni del file system al secondo. Nella documentazione File di Azure il termine "I/O" è intercambiabile con i termini "operation" e "transaction".
Dimensioni di I/O
Le dimensioni di I/O, talvolta definite dimensioni del blocco, sono le dimensioni della richiesta usata da un'applicazione per eseguire una singola operazione di input/output (I/O) nella risorsa di archiviazione. A seconda dell'applicazione, le dimensioni di I/O possono variare da dimensioni ridotte, ad esempio 4 KiB a dimensioni maggiori. Le dimensioni di I/O svolgono un ruolo importante nella velocità effettiva raggiungibile.
Velocità effettiva
La velocità effettiva misura il numero di bit letti o scritti nella risorsa di archiviazione al secondo ed è espressa in mebibyte al secondo (MiB/s). Per calcolare la velocità effettiva, moltiplicare le operazioni di I/O per le dimensioni di I/O. Ad esempio, 10.000 operazioni di I/O al secondo × 1 dimensione di I/O MiB = 10 GiB/s, mentre 10.000 operazioni di I/O × 4 dimensioni di I/O KiB = 38 MiB/s.
Latency
La latenza è un sinonimo di ritardo e viene misurata in millisecondi (ms). Esistono due tipi di latenza: latenza end-to-end e latenza del servizio. Per altre informazioni, vedere Latenza.
Profondità della coda
La profondità della coda è il numero di richieste di I/O in sospeso che possono essere gestite contemporaneamente da una risorsa di archiviazione. Per altre informazioni, vedere Profondità della coda.
Scelta di un livello multimediale in base ai modelli di utilizzo
File di Azure offre due livelli di supporto di archiviazione che è possibile usare per bilanciare le prestazioni e il prezzo: SSD e HDD. Selezionare il livello multimediale per la condivisione file a livello di account di archiviazione. Dopo aver creato un account di archiviazione in un determinato livello multimediale, non è possibile passare all'altro livello multimediale senza eseguire manualmente la migrazione a una nuova condivisione file.
Quando scegli tra condivisioni di file SSD e HDD, considera i requisiti del carico di lavoro previsto che intendi eseguire in File di Azure. Se sono necessarie grandi quantità di operazioni di I/O al secondo, velocità di trasferimento dei dati veloci o bassa latenza, scegliere condivisioni file SSD.
La tabella seguente riepiloga gli obiettivi di prestazioni previsti tra le condivisioni file SSD e HDD. Per informazioni dettagliate, vedere Obiettivi di scalabilità e prestazioni di File di Azure.
| Requisiti del modello di utilizzo | SSD | HDD |
|---|---|---|
| Latenza di scrittura (millisecondi a cifra singola) | Sì | Sì |
| Latenza di lettura (millisecondi a cifra singola) | Sì | NO |
Le condivisioni file SSD usano un modello di provisioning che garantisce il profilo di prestazioni seguente in base alle dimensioni della condivisione. Per altre informazioni, vedere il modello v1 con provisioning.
Migliori pratiche prestazionali
Se si valutano i requisiti di prestazioni per un carico di lavoro nuovo o esistente, la comprensione dei modelli di utilizzo consente di ottenere prestazioni prevedibili.
Sensibilità alla latenza: I carichi di lavoro sensibili alla latenza in lettura e molto visibili agli utenti finali sono più adatti alle condivisioni file su SSD, che possono offrire una latenza di un solo millisecondo sia per le operazioni di lettura sia per quelle di scrittura (meno di 2 ms per operazioni di I/O di piccole dimensioni).
Requisiti di I/O al secondo e velocità effettiva: Le condivisioni file SSD supportano limiti di operazioni di I/O al secondo e velocità effettiva maggiori rispetto alle condivisioni file HDD. Per altre informazioni, vedi obiettivi di scalabilità delle condivisioni file.
Durata e frequenza del carico di lavoro: È meno probabile che i carichi di lavoro brevi (minuti) e non frequenti (orari) raggiungano i limiti di prestazioni superiori delle condivisioni file HDD rispetto ai carichi di lavoro a esecuzione prolungata. Nelle condivisioni file su SSD, la durata del carico di lavoro aiuta a determinare il profilo prestazionale corretto da utilizzare in base allo storage, agli IOPS e al throughput di cui è stato effettuato il provisioning. Un errore comune è l'esecuzione di test delle prestazioni solo per pochi minuti, che spesso è fuorviante. Per avere una visione realistica delle prestazioni, assicurati di testare a una frequenza e durata sufficientemente elevate. Nelle condivisioni file con provisioning, un test breve può misurare gli IOPS di burst basati sui crediti anziché gli IOPS con provisioning. Per maggiori informazioni, vedi Bursting.
Parallelizzazione del carico di lavoro: Per i carichi di lavoro che eseguono operazioni in parallelo, ad esempio tramite più thread, processi o istanze dell'applicazione nello stesso client, le condivisioni file SSD offrono un vantaggio chiaro rispetto alle condivisioni file HDD: SMB multicanale. Per altre informazioni, vedere Migliorare le prestazioni di condivisione file SMB Azure.
Distribuzione delle operazioni API: i carichi di lavoro con un numero elevato di metadati, ad esempio i carichi di lavoro che eseguono operazioni di lettura su un numero elevato di file, sono più adatti alle condivisioni file SSD. Per altre informazioni, vedi Carico di lavoro elevato di metadati o namespace.
Posizionamento di zona: usare il posizionamento di zona per selezionare la zona di disponibilità specifica in cui risiede l'account di archiviazione. Questa funzionalità consente di inserire le macchine virtuali nella stessa zona di disponibilità dell'archiviazione, riducendo la latenza fino al 30%. Questa funzionalità è attualmente disponibile solo per gli account di archiviazione SSD che usano l'archiviazione con ridondanza locale nelle aree supportate.
Bursting
Le condivisioni file che utilizzano il modello di fatturazione provisioned v2 o provisioned v1 supportano il bursting IOPS basato su crediti. Il credit-based bursting permette a una condivisione file di utilizzare più IOPS di quanti ne abbia provisionati per un periodo limitato. Il credit-based bursting è una funzione della condivisione file. Il traffico a raffica è un pattern di carico di lavoro con brevi picchi di IOPS o throughput. Il bursting basato sui crediti può assorbire brevi picchi di IOPS causati da traffico a raffiche.
Il credit-based bursting è incluso nel costo della condivisione file provisioned e non aggiunge costi alla fattura. Il bursting basato su crediti si applica solo agli IOPS. Non aumenta la capacità di throughput oltre quella provisionata.
Il bursting non si applica alle condivisioni di file pay-as-you-go. Le condivisioni file classiche che fanno burst sono comunque soggette ai limiti IOPS dell'account di archiviazione. Per altre informazioni, vedere Limiti del piano dati delle condivisioni file classiche. Per informazioni su come l'bursting influisce sui costi, consulta Comprendi la fatturazione di File di Azure.
Bursting per il modello con provisioning v2
Il bursting di operazioni di I/O al secondo basato sul credito offre una maggiore flessibilità rispetto all'utilizzo delle operazioni di I/O al secondo. Usare questa flessibilità come buffer rispetto ai picchi imprevisti di I/O. Per i modelli di I/O stabiliti, effettuare il provisioning dei picchi di I/O.
I crediti di IOPS burst si accumulano ogni volta che il traffico per la condivisione file è inferiore agli IOPS provisionati (baseline). Ogni volta che l'utilizzo di operazioni di I/O al secondo di una condivisione file supera la quantità di cui è stato effettuato il provisioning e sono disponibili crediti burst per operazioni di I/O al secondo, la condivisione file può aumentare fino al limite massimo di operazioni di I/O al secondo consentito. Le condivisioni file possono continuare a scoppiare finché sono presenti crediti rimanenti, in base al numero di crediti burst accumulati. Ogni operazione I/O oltre gli IOPS forniti utilizza un credito. Dopo aver consumato tutti i crediti, la quota ritorna all'IOPS provisionato. Le operazioni di I/O al secondo sulla condivisione file non devono fare niente di speciale per usare il bursting. Il bursting funziona in base al principio del massimo impegno.
I crediti di condivisione hanno tre stati:
- Accumulo, quando la condivisione file usa meno operazioni di I/O al secondo di quelle di cui è stato effettuato il provisioning.
- Diminuzione, quando la condivisione file usa più operazioni di I/O al secondo di quelle di cui è stato effettuato il provisioning ed è in modalità burst.
- Costante, quando la condivisione di file usa esattamente gli IOPS di cui è stato effettuato il provisioning e non sono stati accumulati né usati crediti.
Una nuova condivisione file parte dal numero massimo di crediti nel bucket di burst. I crediti burst non si accumulano se le operazioni di I/O al secondo della condivisione sono inferiori al limite di provisioning a causa della limitazione delle richieste da parte del server. Le formule seguenti vengono utilizzate per determinare il limite di burst di IOPS e il numero di crediti possibili per una condivisione di file.
| Item | Formula SSD | Formula HDD |
|---|---|---|
| Limite burst per operazioni di I/O al secondo | MIN(MAX(3 * ProvisionedIOPS, 10000), 102400) |
MIN(MAX(3 * ProvisionedIOPS, 5000), 50000) |
| Crediti burst per operazioni di I/O al secondo | (BurstLimit - ProvisionedIOPS) * 3600 |
(BurstLimit - ProvisionedIOPS) * 3600 |
La tabella seguente illustra alcuni esempi di queste formule per vari importi di IOPS predisposti.
| Operazioni di I/O al secondo con provisioning | Limite di operazioni di I/O al secondo del burst SSD | Crediti burst SSD | Limite burst per operazioni di I/O al secondo HDD | Crediti burst HDD |
|---|---|---|---|---|
| 500 | -- | -- | Fino a 5.000 | 16,200,000 |
| 1,000 | -- | -- | Fino a 5.000 | 14,400,000 |
| 3,000 | Fino a 10.000 | 25,200,000 | Fino a 9.000 | 21,600,000 |
| 5,000 | Fino a 15.000 | 36.000.000 | Fino a 15.000 | 36.000.000 |
| 10,000 | Fino a 30.000 | 72,000,000 | Fino a 30.000 | 72,000,000 |
| 25,000 | Fino a 75.000 | 180,000,000 | Fino a 50.000 | 90.000.000 |
| 50,000 | Fino a 102.400 | 188,640,000 | Fino a 50.000 | 0 |
| 75,000 | Fino a 102.400 | 98,640,000 | -- | -- |
| 102,400 | Fino a 102.400 | 0 | -- | -- |
Bursting per il modello con provisioning v1
Il modello provisioned v1 supporta due tipi di bursting: il bursting basato sul credito, incluso senza costi aggiuntivi, e il bursting a pagamento, che puoi opzionalmente abilitare per consentire IOPS e throughput superiori al livello provisioned con addebiti basati sull'uso.
Bursting basato sul credito per il modello con provisioning v1
Il bursting di operazioni di I/O al secondo basato sul credito offre una maggiore flessibilità rispetto all'utilizzo delle operazioni di I/O al secondo. Usare questa flessibilità come buffer rispetto ai picchi imprevisti di I/O. Per i modelli di I/O stabiliti, effettuare il provisioning dei picchi di I/O.
I crediti di IOPS in modalità burst si accumulano ogni volta che il traffico per la condivisione file classica è inferiore agli IOPS di base (baseline). Ogni volta che l'utilizzo di operazioni di I/O al secondo di una condivisione file classica supera la quantità di cui è stato effettuato il provisioning e sono disponibili crediti burst per le operazioni di I/O al secondo, la condivisione file classica può aumentare temporaneamente fino al limite massimo di operazioni di I/O al secondo consentito. Le condivisioni file classiche possono continuare ad aumentare temporaneamente finché sono disponibili crediti rimanenti, in base al numero di crediti burst accumulati. Ogni operazione I/O oltre gli IOPS forniti utilizza un credito. Dopo aver consumato tutti i crediti, la condivisione file classica ritorna all'IOPS provisionato. Gli IOPS sulla condivisione file classica non devono eseguire operazioni particolari per usare il bursting. Il bursting funziona in base al principio del massimo impegno.
I crediti di condivisione hanno tre stati:
- Accumulo: quando la condivisione file usa meno operazioni di I/O al secondo di quelle di cui è stato effettuato il provisioning.
- Diminuzione, quando la condivisione file classica utilizza più operazioni di I/O al secondo rispetto a quello previsto e si trova in modalità burst.
- Costante, quando la condivisione file classica utilizza esattamente gli IOPS previsti e non ci sono crediti né accumulati né utilizzati.
Una nuova condivisione file classica parte dal numero massimo di crediti nel bucket di burst. I crediti burst non si accumulano se le operazioni di I/O al secondo della condivisione sono inferiori al limite di provisioning a causa della limitazione delle richieste da parte del server. Le seguenti formule vengono utilizzate per determinare il limite di IOPS in burst e il numero di crediti possibili per una condivisione file tradizionale.
| Item | Formula |
|---|---|
| Limite di burst | MIN(MAX(3 * ProvisionedStorageGiB, 10000), 102400) |
| Crediti burst | (BurstLimit - BaselineIOPS) * 3600 |
La tabella seguente illustra alcuni esempi di queste formule per le dimensioni preconfigurate.
| Capacità (GiB) | IOPS di base | Operazioni di I/O al secondo in modalità burst | Crediti burst | Velocità effettiva (MiB/sec) |
|---|---|---|---|---|
| 100 | 3.100 | Fino a 10.000 | 24,840,000 | 110 |
| 500 | 3,500 | Fino a 10.000 | 23,400,000 | 150 |
| 1,024 | 4.024 | Fino a 10.000 | 21,513,600 | 203 |
| 5120 | 8.120 | Fino a 15.360 | 26,064,000 | 613 |
| 10,240 | 13.240 | Fino a 30.720 | 62,928,000 | 1,125 |
| 33.792 | 36.792 | Fino a 102.400 | 227,548,800 | 3.480 |
| 51.200 | 54.200 | Fino a 102.400 | 164,880,000 | 5.220 |
| 102,400 | 102,400 | Fino a 102.400 | 0 | 10.340 |
Bursting a pagamento per il modello con provisioning v1
Il bursting a pagamento è una funzionalità avanzata del modello con provisioning v1, progettata per supportare i clienti che non vogliono mai subire limitazioni. Il bursting a pagamento aggiunge una fatturazione aggiuntiva basata sull'utilizzo per qualsiasi quantità di operazioni di I/O al secondo o velocità effettiva al di sopra dell'archiviazione di cui è stato effettuato il provisioning. Questa funzionalità è distinta dal bursting basato su crediti, incluso gratuitamente come parte dello storage provisionato. Sebbene il bursting a pagamento possa offrire una notevole flessibilità per il provisioning della condivisione file classica, può anche comportare addebiti imprevisti se usato in modo non corretto.
Analogamente al bursting basato sul credito, il bursting a pagamento non sostituisce l'allocazione della quantità corretta di IOPS e larghezza di banda. Invece, offre ulteriore protezione contro la limitazione se si verifica una domanda imprevista. Se si dispone di un livello costante di utilizzo di IOPS o throughput, è più conveniente allocare, tramite il provisioning dello storage, un numero sufficiente di IOPS e throughput per coprire il fabbisogno, anziché fare affidamento sul bursting a pagamento.
La funzionalità di bursting a pagamento è disabilitata per impostazione predefinita, ma è possibile abilitarla seguendo le istruzioni per modificare le impostazioni di costo e prestazioni di una condivisione file classica v1 di cui è stato effettuato il provisioning (solo PowerShell e CLI). Se si attiva il bursting a pagamento, monitorate l'utilizzo di IOPS e della velocità effettiva usando le metriche seguenti disponibili in Monitoraggio di Azure:
- Provisioning di operazioni di I/O al secondo della condivisione file
- Larghezza di banda provisionata per condivisione file MiB/s (velocità effettiva)
- Transazioni per numero massimo di operazioni di I/O al secondo
- Larghezza di banda per MiB/sec massimi (velocità effettiva)
- Crediti burst per operazioni di I/O al secondo (bursting basato sul credito)
- I/O burst a pagamento (I/O)
- Larghezza di banda bursting a pagamento
Latenza
Quando si parla di latenza, è importante innanzitutto capire come File di Azure la determina. Le misurazioni più comuni sono la latenza associata alle metriche di latenza end-to-end e latenza del servizio. L'uso di queste metriche delle transazioni consente di identificare i problemi di rete e la latenza lato client mostrando il tempo trascorso dal traffico dell'applicazione in transito da e verso il client.
La latenza end-to-end (SuccessE2ELatency) è il tempo totale necessario per eseguire un round trip completo dal client, attraverso la rete, al servizio File di Azure e di nuovo al client.
La latenza del servizio (SuccessServerLatency) è il tempo necessario per il round trip di una transazione solo all'interno di File di Azure. Questa misura non include alcuna latenza di rete o client.
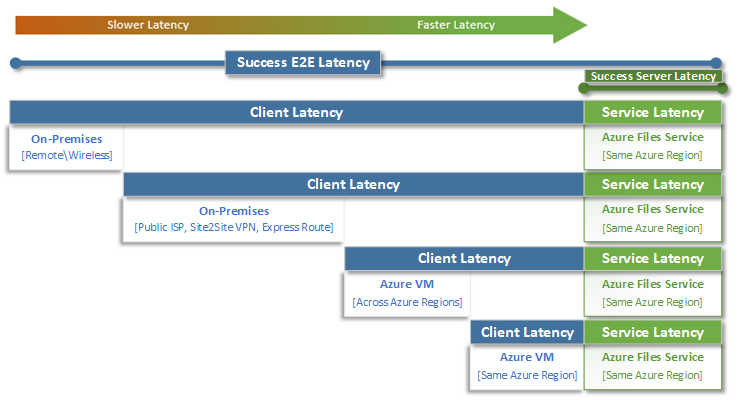
La differenza tra i valori SuccessE2ELatency e SuccessServerLatency è la latenza probabilmente causata dalla rete e/o dal client.
Spesso la latenza del client viene confusa con la latenza del servizio (in questo caso, con le prestazioni di File di Azure). Ad esempio, se la latenza del servizio segnala bassa latenza e la latenza end-to-end segnala una latenza molto elevata per le richieste, tutto il tempo viene impiegato in transito da e verso il client e non nel servizio File di Azure.
Inoltre, come illustrato nel diagramma, più si è lontani dal servizio, maggiore è la latenza e più difficile diventa raggiungere i limiti di scalabilità delle prestazioni con qualunque servizio cloud. Questa condizione è particolarmente vera quando si accede a File di Azure dall'ambiente locale. Anche se le opzioni come Azure ExpressRoute sono ideali per l'ambiente locale, non corrispondono ancora alle prestazioni di un'applicazione (calcolo e archiviazione) in esecuzione esclusivamente nella stessa area Azure.
Suggerimento
L'uso di una macchina virtuale in Azure per testare le prestazioni tra l'ambiente locale e Azure è un modo efficace e pratico per applicare le funzionalità di rete della connessione ad Azure. I circuiti ExpressRoute sottodimensionati o instradati in modo non corretto o i gateway VPN possono rallentare significativamente i carichi di lavoro in esecuzione in File di Azure.
Profondità coda
La profondità della coda è il numero di richieste di I/O in sospeso che possono essere eseguite da una risorsa di archiviazione. Man mano che i dischi usati dai sistemi di archiviazione si sono evoluti da spindle HDD (IDE, SATA, SAS) a dispositivi ssd (SSD, NVMe), si sono anche evoluti per supportare una maggiore profondità della coda. Un carico di lavoro costituito da un singolo client che interagisce serialmente con un singolo file all'interno di un set di dati di grandi dimensioni è un esempio di profondità ridotta della coda. Al contrario, un carico di lavoro che supporta il parallelismo con più thread e più file può raggiungere facilmente una profondità elevata della coda. Poiché File di Azure è un servizio file distribuito che si estende su migliaia di nodi del cluster Azure ed è progettato per eseguire carichi di lavoro su larga scala, compilare e testare carichi di lavoro con profondità elevata della coda.
È possibile ottenere una profondità elevata della coda in diversi modi. Per determinare la profondità della coda per il carico di lavoro, moltiplicare il numero di client per il numero di file (client × file × thread = profondità coda).
La tabella seguente illustra le varie combinazioni che è possibile usare per ottenere una maggiore profondità della coda. Anche se è possibile superare la profondità ottimale della coda di 64, non è consigliabile. In tal caso, non si noterà un miglioramento delle prestazioni e si rischia di aumentare la latenza a causa della saturazione TCP.
| Client | File | Thread | Profondità della coda |
|---|---|---|---|
| 1 | 1 | 1 | 1 |
| 1 | 1 | 2 | 2 |
| 1 | 2 | 2 | 4 |
| 2 | 2 | 2 | 8 |
| 2 | 2 | 4 | 16 |
| 2 | 4 | 4 | 32 |
| 1 | 8 | 8 | 64 |
| 4 | 4 | 2 | 32 |
Suggerimento
Per ottenere prestazioni massime, assicurarsi che il carico di lavoro o il test di benchmarking sia multithread e utilizzi più file.
Applicazioni a thread singolo e multithread
File di Azure funziona meglio con le applicazioni multithreading. Il modo più semplice per comprendere l'impatto sulle prestazioni che il multithreading ha su un carico di lavoro consiste nell'esaminare lo scenario in base all'I/O. Nell'esempio seguente è disponibile un carico di lavoro che deve copiare 10.000 file di piccole dimensioni il più rapidamente possibile in o da una condivisione file Azure.
Questa tabella suddivide il tempo necessario (in millisecondi) per creare un singolo file di 16 KiB in una condivisione file di Azure, in base a un'applicazione a thread singolo che scrive in dimensioni del blocco di 4 KiB.
| Operazione di I/O | Creare | Scrittura di 4 KiB | Scrittura di 4 KiB | Scrittura di 4 KiB | Scrittura di 4 KiB | Close | Totale |
|---|---|---|---|---|---|---|---|
| Thread 1 | 3 ms | 2 ms | 2 ms | 2 ms | 2 ms | 3 ms | 14 ms |
In questo esempio, sono necessari circa 14 ms per creare un singolo file da 16 KiB tramite sei operazioni. Se un'applicazione a thread singolo vuole spostare 10.000 file in una condivisione file Azure, tale operazione si traduce in 140.000 ms (14 ms × 10.000) o 140 secondi perché ogni file viene spostato in sequenza uno alla volta. Il tempo necessario per il servizio di ogni richiesta è determinato principalmente dalla vicinanza tra le risorse di calcolo e archiviazione, come illustrato nella sezione precedente.
Usando otto thread anziché uno, è possibile ridurre il carico di lavoro precedente da 140.000 ms (140 secondi) fino a 17.500 ms (17,5 secondi). Come illustrato nella tabella seguente, quando si spostano otto file in parallelo anziché un file alla volta, è possibile spostare la stessa quantità di dati in 87,5% meno tempo.
| Operazione di I/O | Creare | Scrittura di 4 KiB | Scrittura di 4 KiB | Scrittura di 4 KiB | Scrittura di 4 KiB | Close | Totale |
|---|---|---|---|---|---|---|---|
| Thread 1 | 3 ms | 2 ms | 2 ms | 2 ms | 2 ms | 3 ms | 14 ms |
| Thread 2 | 3 ms | 2 ms | 2 ms | 2 ms | 2 ms | 3 ms | 14 ms |
| Thread 3 | 3 ms | 2 ms | 2 ms | 2 ms | 2 ms | 3 ms | 14 ms |
| Thread 4 | 3 ms | 2 ms | 2 ms | 2 ms | 2 ms | 3 ms | 14 ms |
| Thread 5 | 3 ms | 2 ms | 2 ms | 2 ms | 2 ms | 3 ms | 14 ms |
| Thread 6 | 3 ms | 2 ms | 2 ms | 2 ms | 2 ms | 3 ms | 14 ms |
| Thread 7 | 3 ms | 2 ms | 2 ms | 2 ms | 2 ms | 3 ms | 14 ms |
| Thread 8 | 3 ms | 2 ms | 2 ms | 2 ms | 2 ms | 3 ms | 14 ms |