Trasformare i dati con join e operatori di insieme
I flussi di lavoro di progettazione dei dati richiedono spesso la combinazione di informazioni da più set di dati. I join combinano le tabelle orizzontalmente associando le righe alle colonne correlate, mentre gli operatori di impostazione combinano le tabelle in senso verticale aggiungendo, intersecando o escludendo righe. Comprendere quando usare ogni approccio consente di creare pipeline di trasformazione efficienti.
In questa unità si apprenderà come unire tabelle basate sulle relazioni e applicare operatori set per combinare set di dati con schemi corrispondenti.
Combinare tabelle con giunzioni
Unisce righe di due tabelle in base a una colonna correlata. Il tipo di join determina le righe visualizzate nel risultato e la modalità di gestione delle righe non corrispondenti.
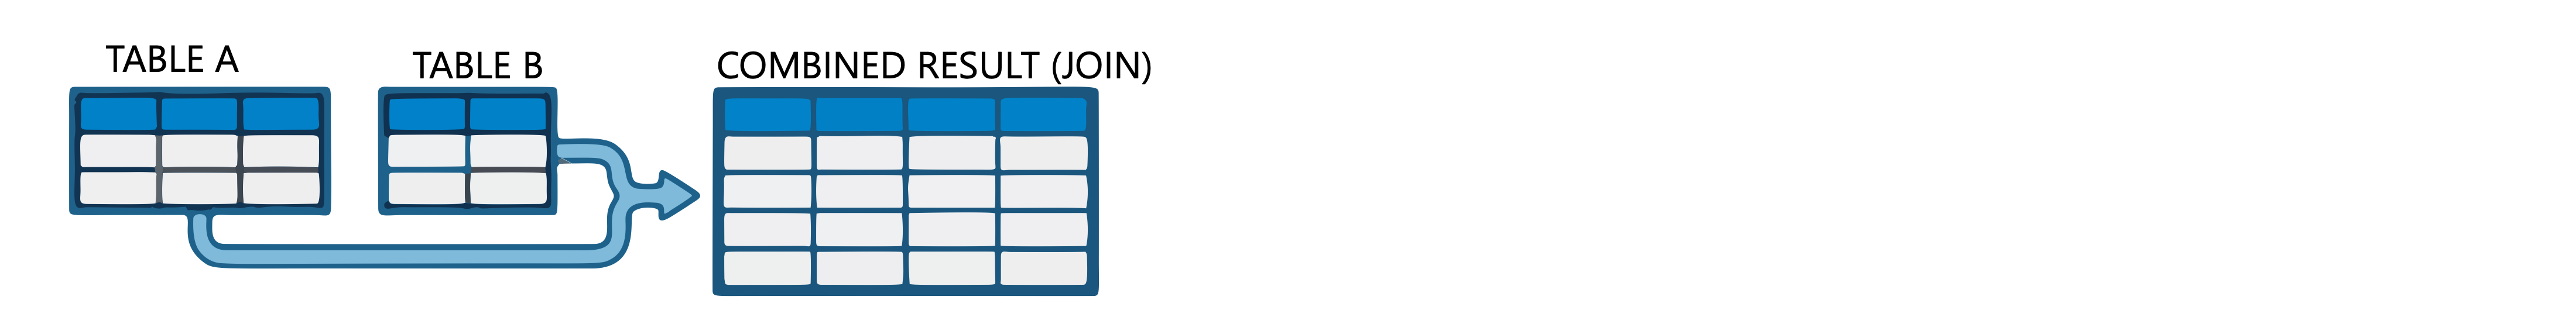
Informazioni sui tipi di join
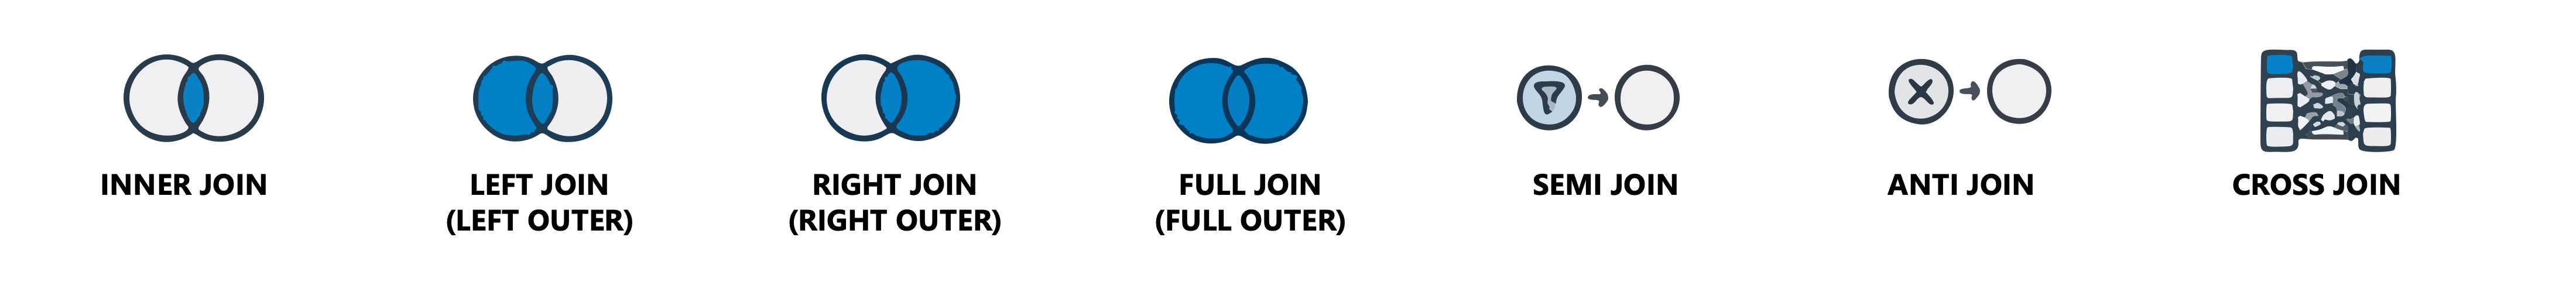
Ogni tipo di join ha uno scopo specifico nella trasformazione dei dati:
| Tipo di join | Description | Caso d'uso |
|---|---|---|
INNER |
Restituisce solo righe corrispondenti da entrambe le tabelle | Collegare gli ordini con clienti validi |
LEFT |
Restituisce tutte le righe della tabella sinistra; aggiunge valori NULL per la tabella destra quando non viene trovata alcuna corrispondenza | Includere tutti i clienti, anche senza ordini |
RIGHT |
Restituisce tutte le righe di tabella corrette; aggiunge valori NULL per la tabella sinistra quando non esiste alcuna corrispondenza | Includere tutti i reparti, anche senza dipendenti |
FULL |
Restituisce tutte le righe di entrambe le tabelle; aggiunge valori NULL per le corrispondenze non corrispondenti | Combinare set di dati per trovare spazi vuoti su entrambi i lati |
SEMI |
Restituisce le righe della tabella sinistra che hanno corrispondenze nella tabella a destra | Filtrare i clienti che hanno effettuato ordini |
ANTI |
Restituisce le righe della tabella sinistra che non hanno corrispondenze nella tabella a destra | Trovare i clienti che non hanno mai effettuato ordini |
CROSS |
Restituisce il prodotto cartesiano di tutte le righe | Generare tutte le possibili combinazioni |
Unire tabelle con SQL
La JOIN clausola combina le tabelle in base a una condizione specificata con ON o USING. Gli esempi seguenti usano tabelle dipendente e reparto:
CREATE TEMP VIEW employee(id, name, deptno) AS
    VALUES (105, 'Chloe', 5),
           (103, 'Paul',  3),
           (101, 'John',  1),
           (102, 'Lisa',  2),
           (104, 'Evan',  4),
           (106, 'Amy',   6);

CREATE TEMP VIEW department(deptno, deptname) AS
    VALUES (3, 'Engineering'),
           (2, 'Sales'),
           (1, 'Marketing');
Per associare i dipendenti ai reparti, usare un inner join:
-- Inner join: only employees with matching departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
INNER JOIN department d ON e.deptno = d.deptno;
Un inner join restituisce solo tre righe, ovvero i dipendenti i cui numeri di reparto sono presenti nella tabella del reparto. I dipendenti nei reparti 4, 5 e 6 non vengono visualizzati perché tali reparti non sono nella tabella del reparto.
Quando è necessario includere tutti i dipendenti, indipendentemente dalle corrispondenze dei reparti, utilizza un left join.
-- Left join: all employees, NULL for missing departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
LEFT JOIN department d ON e.deptno = d.deptno;
Questo restituisce tutti e sei i dipendenti. Quelli senza reparti corrispondenti mostrano NULL nella deptname colonna.
Unire i DataFrame con PySpark
Il metodo di join() PySpark fornisce la stessa funzionalità. Il how parametro specifica il tipo di join:
df_employee = spark.table("employee")
df_department = spark.table("department")

# Inner join
df_inner = df_employee.join(
    df_department,
    on=df_employee.deptno == df_department.deptno,
    how="inner"
)
display(df_inner)
Per i join sinistra, destra o full outer, modificare il parametro how:
# Left join: keep all employees
df_left = df_employee.join(
    df_department,
    on="deptno",
    how="left"
)

# Full outer join: keep all rows from both tables
df_full = df_employee.join(
    df_department,
    on="deptno",
    how="full"
)
Quando la colonna join ha lo stesso nome in entrambi i dataframe, passare il nome della colonna come stringa. Questo approccio evita colonne duplicate nel risultato.
Filtrare i dati con semi-join e anti-join
Semi e anti join filtrano i dati in base all'esistenza in un'altra tabella. Un semi join restituisce righe dalla tabella a sinistra che hanno corrispondenze, senza includere colonne della tabella a destra:
-- Find employees who belong to listed departments
SELECT *
FROM employee
LEFT SEMI JOIN department ON employee.deptno = department.deptno;
Un anti join restituisce le righe opposte, ovvero le righe senza corrispondenze:
-- Find employees in departments not listed
SELECT *
FROM employee
LEFT ANTI JOIN department ON employee.deptno = department.deptno;
In PySpark usare how="semi" o how="anti":
# Employees with matching departments
df_semi = df_employee.join(df_department, on="deptno", how="semi")

# Employees without matching departments
df_anti = df_employee.join(df_department, on="deptno", how="anti")
Combinare righe con operatori set
Gli operatori set funzionano verticalmente, combinando le righe delle query con la stessa struttura di colonne. A differenza dei join, gli operatori di set non si abbinano a condizioni—impilano o confrontano interi set di risultati.
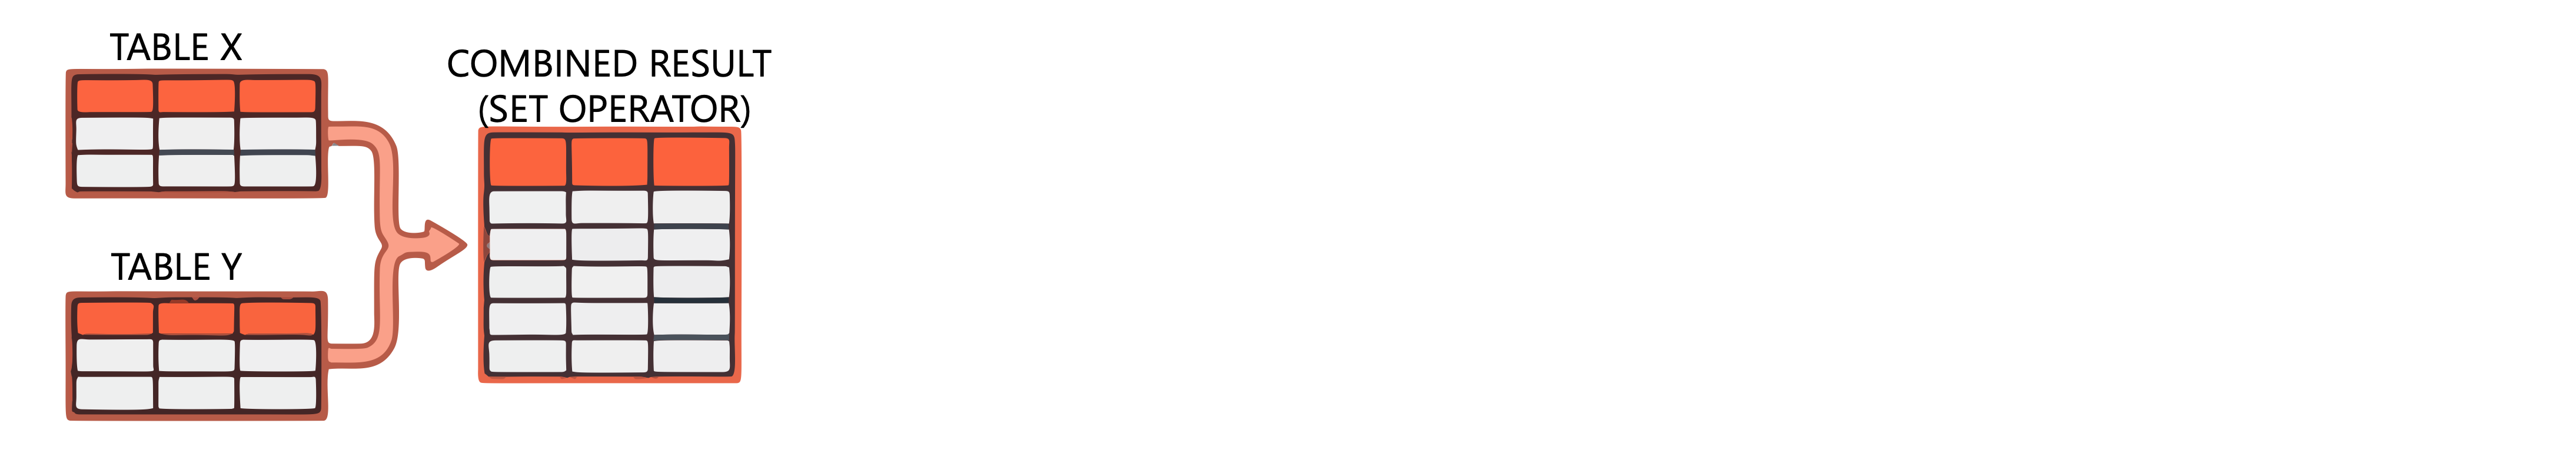
Informazioni sugli operatori set
Azure Databricks supporta tre operatori set:
| Operator | Description | Comportamento |
|---|---|---|
UNION |
Combina le righe di entrambe le query | Rimuove i duplicati per impostazione predefinita; usare ALL per mantenerli |
INTERSECT |
Restituisce righe presenti in entrambe le query | Vengono visualizzate solo le righe corrispondenti |
EXCEPT |
Restituisce righe dalla prima query non nella seconda | Rimuove i duplicati per impostazione predefinita |
Entrambe le query devono avere lo stesso numero di colonne con tipi di dati compatibili.
Unire set di dati con UNION
UNION aggiunge righe da una query a un'altra. Per impostazione predefinita, rimuove i duplicati:
-- Combine active and archived customers (no duplicates)
SELECT customer_id, name, email FROM active_customers
UNION
SELECT customer_id, name, email FROM archived_customers;
Per mantenere tutte le righe incluse i duplicati, usare UNION ALL:
-- Combine all rows, keeping duplicates
SELECT customer_id, name, email FROM active_customers
UNION ALL
SELECT customer_id, name, email FROM archived_customers;
Usare UNION ALL quando si sa che non sono presenti duplicati o quando i duplicati sono significativi. Offre prestazioni migliori perché ignora il passaggio di deduplicazione.
In PySpark usare union() per combinare i dataframe. Si noti che union() PySpark si comporta come UNION ALL—mantiene i duplicati.
df_active = spark.table("active_customers")
df_archived = spark.table("archived_customers")

# Combine both tables (keeps duplicates)
df_combined = df_active.union(df_archived)

# Remove duplicates if needed
df_distinct = df_active.union(df_archived).distinct()
Trovare righe comuni con INTERSECT
INTERSECT restituisce solo le righe visualizzate in entrambe le query. Ciò consente di identificare i dati sovrapposti:
-- Find customers in both active and archived tables
SELECT customer_id FROM active_customers
INTERSECT
SELECT customer_id FROM archived_customers;
Questa query identifica i clienti che in qualche modo vengono visualizzati in entrambe le tabelle, utili per i controlli di qualità dei dati o per identificare i record che richiedono la riconciliazione.
Escludere righe con EXCEPT
EXCEPT restituisce righe dalla prima query che non esistono nel secondo. Ciò consente di identificare le lacune o i record univoci:
-- Find active customers not in the archived table
SELECT customer_id FROM active_customers
EXCEPT
SELECT customer_id FROM archived_customers;
È anche possibile usare MINUS come sinonimo di EXCEPT:
-- Same result using MINUS syntax
SELECT customer_id FROM active_customers
MINUS
SELECT customer_id FROM archived_customers;
Come UNION, sia INTERSECT che EXCEPT rimuovono i duplicati per impostazione predefinita. Aggiungi ALL per mantenere i duplicati quando necessario.
Suggerimento
Quando si concatenano le operazioni del set, tenere presente che INTERSECT ha una precedenza maggiore rispetto a UNION e EXCEPT. Usare le parentesi per controllare l'ordine di valutazione.
Scegliere tra join e operatori di insieme
La scelta tra join e operatori impostati dipende dall'obiettivo della trasformazione. I join combinano le colonne delle tabelle correlate orizzontalmente, mentre gli operatori di impostazione combinano le righe verticalmente.
Utilizzare join quando necessario:
- Arricchire i record aggiungendo colonne da tabelle correlate
- Trovare la corrispondenza dei record in base alle relazioni chiave
- Filtrare i dati in base all'esistenza in un'altra tabella (semi/anti join)
Usare gli operatori set quando è necessario:
- Aggiungere record da più origini con schemi identici
- Trovare record comuni tra set di dati
- Identificare i record univoci per un set di dati
Entrambi gli approcci costituiscono la base di pipeline di trasformazione dei dati efficaci. Nell'unità successiva si esaminerà come caricare i dati trasformati in tabelle di destinazione all'interno di Unity Catalog.