Scegliere un formato di tabella dati
I data engineer devono prendere una decisione critica nelle prime fasi di ogni pipeline di dati: quale formato di tabella deve archiviare i dati? Questa scelta influisce sulle prestazioni delle query, sull'affidabilità delle transazioni, sull'interoperabilità con altre piattaforme e sulla manutenzione a lungo termine dell'architettura lakehouse.
Azure Databricks supporta più formati di archiviazione, ognuno progettato per scenari diversi. Comprendere le differenze consente di selezionare il formato corretto per i requisiti specifici.
Informazioni sui formati di file e sui formati di tabella
Prima di confrontare le opzioni, è importante distinguere tra formati di file e formati di tabella. Un formato di file come Parquet, CSV o JSON definisce il modo in cui i dati vengono archiviati fisicamente su disco. Un formato di tabella come Delta Lake o Apache Iceberg si basa sui formati di file aggiungendo un livello di metadati che tiene traccia delle transazioni, delle modifiche dello schema e dei percorsi dei file di dati.
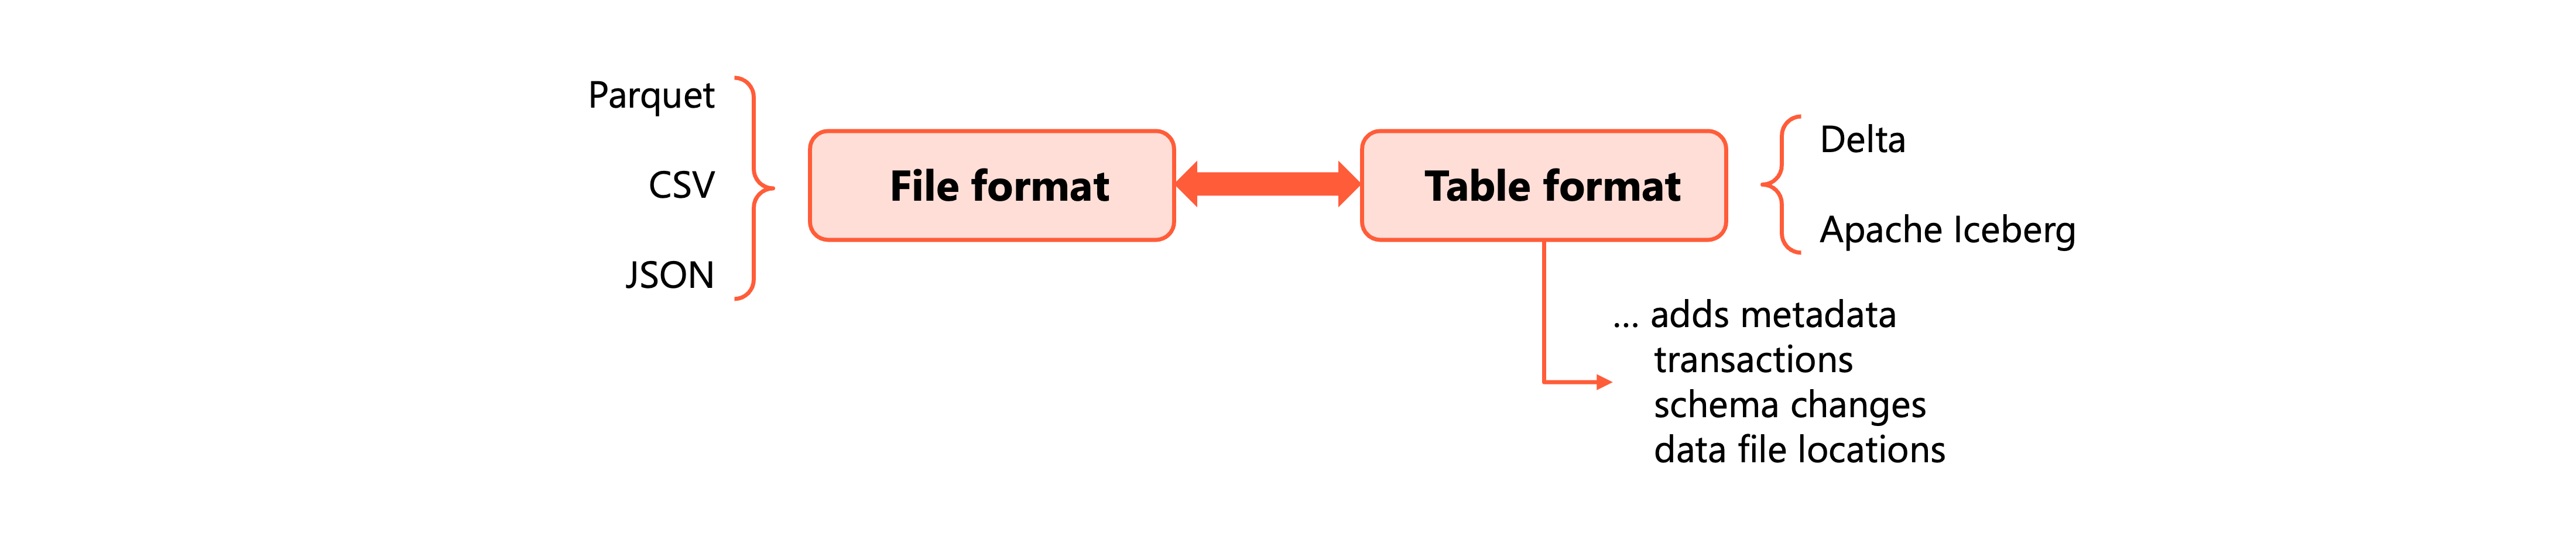
Sia Delta Lake che Apache Iceberg usano Parquet come formato di file sottostante. La differenza principale risiede nel livello dei metadati che consente funzionalità avanzate come transazioni ACID, viaggi in tempo e evoluzione dello schema.
Come Parquet archivia i dati in modo diverso.
Parquet usa l'archiviazione a colonne anziché l'archiviazione basata su righe. Questa differenza fondamentale influisce significativamente sulle prestazioni delle query analitiche.
Nei formati basati su righe, ad esempio CSV, i dati sono organizzati per record. La lettura di una singola colonna richiede l'analisi di ogni riga nel file. Nei formati a colonne come Parquet, i dati per ogni colonna vengono archiviati insieme. Quando una query richiede solo colonne specifiche, Parquet legge solo tali colonne e ignora completamente il resto.
Parquet organizza i dati in gruppi di righe, ognuno dei quali contiene blocchi di colonna. Ogni blocco di colonne archivia le statistiche, inclusi i valori minimi e massimi per tale segmento di dati. Quando si esegue una query con una condizione di filtro, il motore di query controlla prima queste statistiche. Se il valore del filtro non rientra nell'intervallo min/max di un gruppo di righe, il motore ignora la lettura dell'intera sezione.
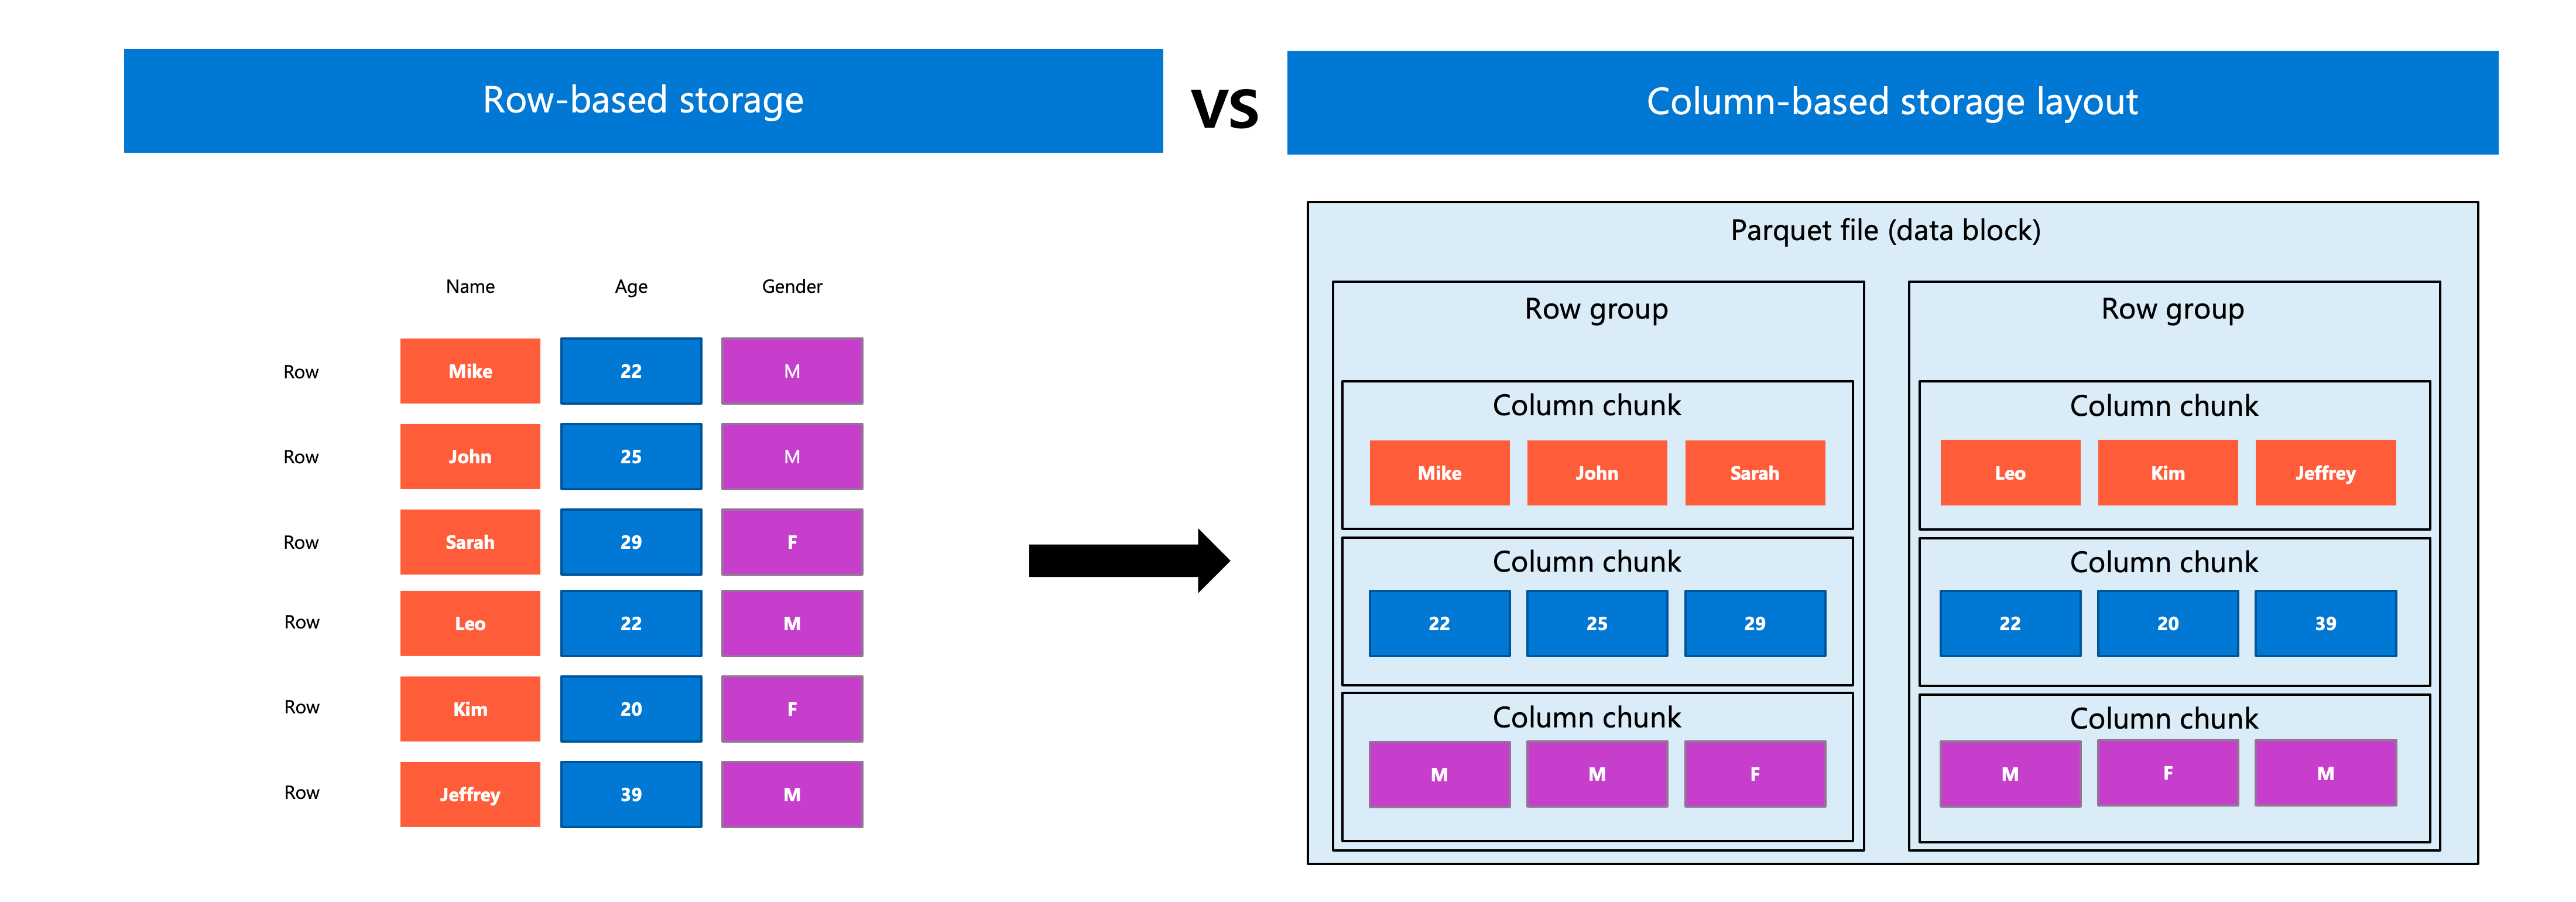
Questo approccio a colonne offre due tecniche di ottimizzazione che migliorano notevolmente le prestazioni di analisi:
- Potatura delle colonne: il motore legge solo le colonne a cui fa riferimento la query, riducendo sostanzialmente le operazioni di I/O.
- Predicate pushdown: Le condizioni di filtro vengono valutate rispetto alle statistiche delle colonne prima di leggere i dati, ignorando completamente i gruppi di righe irrilevanti.
Per i carichi di lavoro analitici che in genere accedono a un subset di colonne in molte righe, Parquet supera sostanzialmente i formati basati su righe.
Delta Lake come formato predefinito
Delta Lake è il formato di archiviazione predefinito per tutte le tabelle in Azure Databricks. Quando si crea una tabella senza specificare un formato, Azure Databricks usa automaticamente Delta Lake.
Delta Lake estende i file Parquet con un log delle transazioni che registra ogni modifica alla tabella. Questo log abilita diverse funzionalità che Parquet da solo non offre:
Transazioni ACID: più lettori e writer simultanei possono accedere alla stessa tabella senza danneggiamento dei dati. Ogni transazione viene completata completamente o non ha alcun effetto.
Tempo di percorrenza: eseguire query sulle versioni precedenti della tabella usando timestamp o numeri di versione. Se necessario, annullare le modifiche.
Applicazione ed evoluzione dello schema: la tabella convalida i dati in ingresso rispetto allo schema definito, impedendo l'immissione di dati danneggiati o incompatibili nel lakehouse. Quando i requisiti cambiano, è possibile aggiungere nuove colonne, modificare i tipi di dati o rinominare colonne senza riscrivere i dati esistenti.
Batch e streaming unificati: utilizzare la stessa tabella come origine o come sink per elaborazioni batch e di streaming.
Delta Lake si integra profondamente con la piattaforma Azure Databricks. Le funzionalità come il clustering liquido e l'ottimizzazione predittiva sono disponibili sia per le tabelle Delta Lake che per le tabelle Apache Iceberg gestite in Unity Catalog. Il feed di dati delle modifiche, tuttavia, è specifico di Delta Lake e si basa sul log delle transazioni.
Per la maggior parte degli scenari in Azure Databricks, Delta Lake è la scelta consigliata. Offre i vantaggi in termini di prestazioni di Parquet con garanzie transazionali che i sistemi di dati di produzione richiedono.
Apache Iceberg per scenari multipiattaforma
Apache Iceberg è un formato di tabella aperto alternativo supportato da Azure Databricks per le tabelle gestite ed esterne. Come Delta Lake, Iceberg offre transazioni ACID, evoluzione dello schema e funzionalità di spostamento del tempo basate su file Parquet.
La struttura logica gerarchica e ben definita di Iceberg lo rende altamente flessibile, supportando scalabilità e ottimizzazioni avanzate. Supporta l'eliminazione del manifesto, le statistiche a livello di file, il partizionamento nascosto e l'evoluzione della partizione.
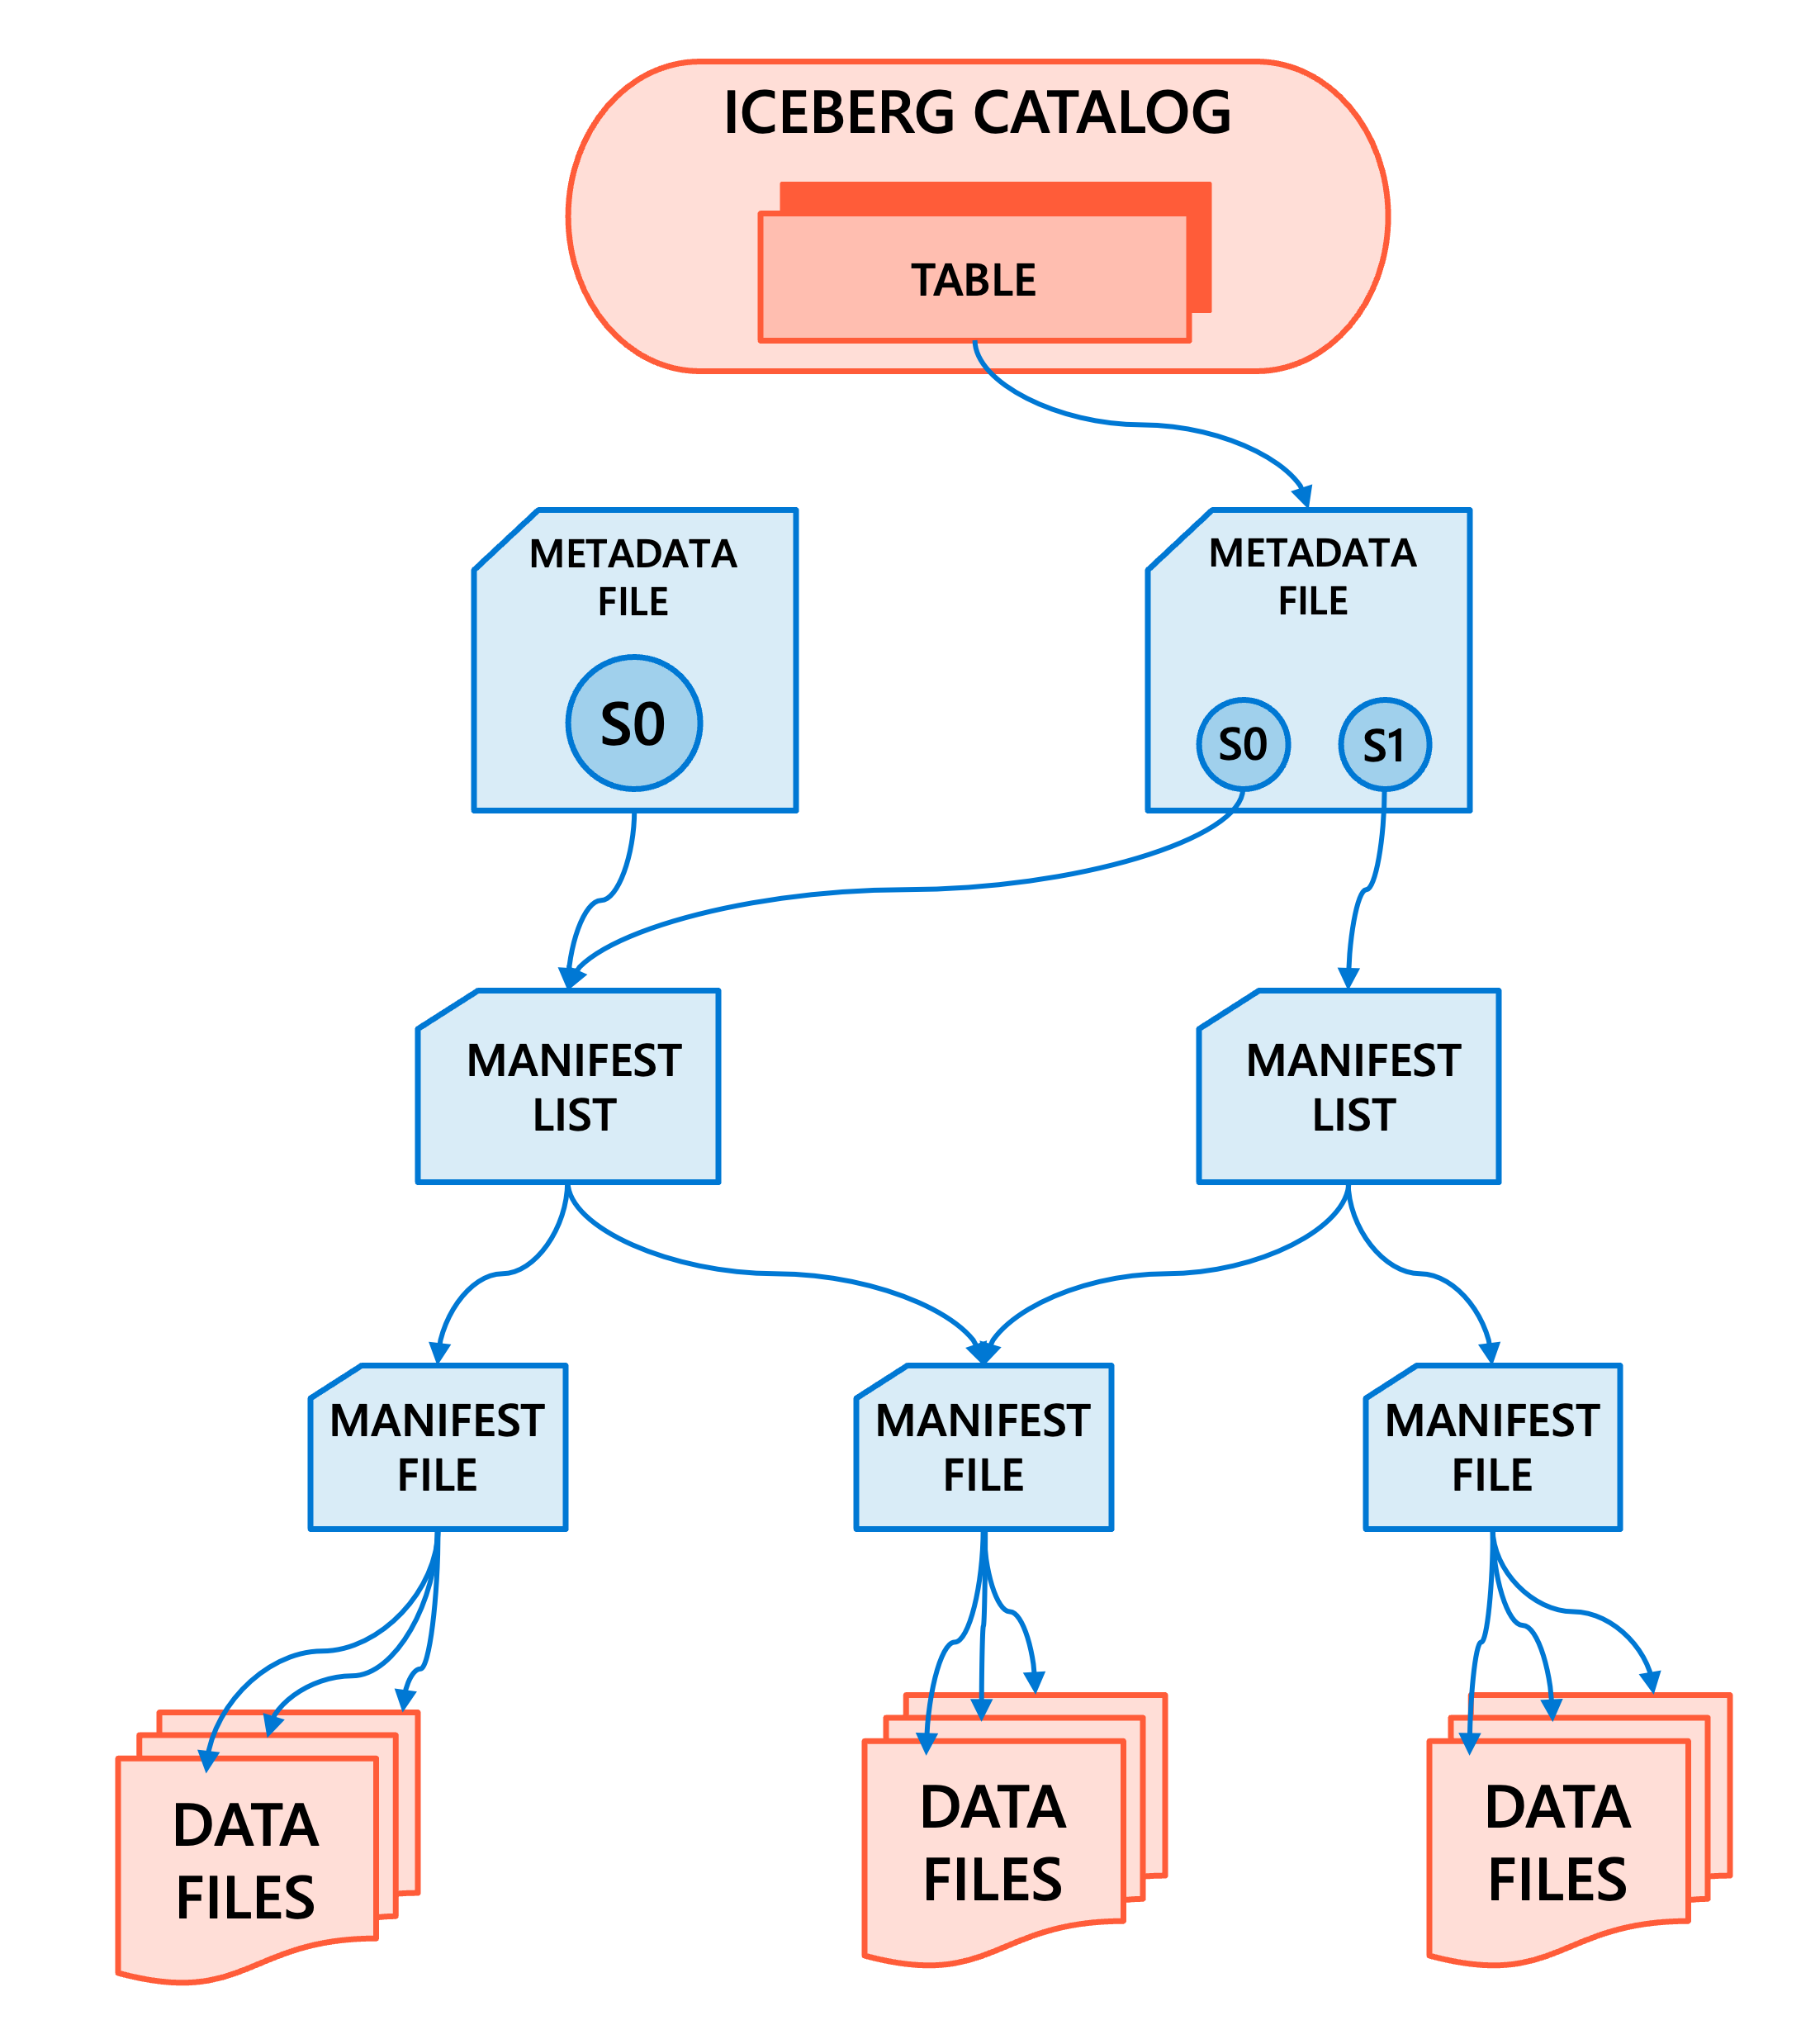
Il motivo principale per cui scegliere Iceberg è l'interoperabilità. Iceberg è ampiamente adottato nell'ecosistema dei dati, tra cui piattaforme come Snowflake, Amazon Athena, Trino, Apache Spark e Apache Flink. Se l'organizzazione esegue carichi di lavoro su più piattaforme che devono leggere e scrivere le stesse tabelle, Iceberg offre un formato comune per tutte le piattaforme.
Il catalogo unity può gestire direttamente le tabelle Iceberg, consentendo ad Azure Databricks di fungere da catalogo Iceberg per i motori esterni. È anche possibile leggere le tabelle Iceberg gestite da altri cataloghi come AWS Glue o Snowflake Horizon Catalog tramite connessioni di tabelle esterne.
Considera Iceberg quando:
- I dati devono essere accessibili da più motori di elaborazione all'esterno di Azure Databricks.
- La tua organizzazione ha adottato Iceberg come standard per la condivisione dei dati multipiattaforma.
- Stai integrando con sistemi che non supportano Delta Lake.
Per i carichi di lavoro eseguiti principalmente in Azure Databricks, Delta Lake rimane il formato consigliato grazie alle funzionalità di integrazione e ottimizzazione della piattaforma più approfondite.
Quando si applicano formati basati su righe
CSV e JSON rimangono scelte valide per scenari specifici, anche se sono meno efficienti per l'analisi su larga scala.
Usare CSV o JSON quando:
- Si ricevono dati da sistemi esterni in questi formati come zona di destinazione iniziale.
- Sono necessari dati leggibili per il debug o l'ispezione rapida.
- Stai integrando con sistemi che supportano solo formati basati su testo.
- I volumi di dati sono sufficientemente piccoli che le differenze di prestazioni sono trascurabili.
Per l'archiviazione permanente dei dati analitici, convertire i file CSV o JSON in tabelle Delta Lake durante l'inserimento. Questa conversione acquisisce i vantaggi di efficienza dell'archiviazione a colonne durante l'aggiunta di garanzie transazionali.
Applicare i criteri decisionali
La selezione di un formato di tabella dipende dai requisiti specifici. Iniziare con Delta Lake come scelta predefinita, quindi valutare le alternative solo quando sono necessari vincoli specifici.
| Considerazione | Delta Lake | Apache Iceberg | CSV/JSON |
|---|---|---|---|
| Prestazioni di analisi | Eccellente | Eccellente | Scarsa |
| Transazioni ACID | Yes | Yes | NO |
| Spostamento cronologico | Yes | Yes | NO |
| Integrazione di Azure Databricks | Profondo | Sostenuto | Basic |
| Compatibilità multipiattaforma | Crescente | Largo | Universale |
| Consigliato per la produzione | Yes | Sì (se necessario l'interoperabilità) | No (solo zona di destinazione) |
La scelta dipende anche da standard aziendali. Se il team dell'architettura ha stabilito convenzioni per i formati di tabella, allinearsi a tali decisioni per mantenere la coerenza nella piattaforma dati.