Scegliere la granularità in una colonna o una tabella in base ai requisiti
La granularità è una delle decisioni di progettazione più critiche prese durante la creazione di un modello di dati. Definisce il livello di dettaglio acquisito nelle tabelle e influisce direttamente sui costi di archiviazione, sulle prestazioni delle query e sulle domande analitiche a cui è possibile rispondere. In qualità di data engineer, la comprensione della granularità consente di progettare tabelle che soddisfino i requisiti aziendali mantenendo al contempo operazioni efficienti.
Questa unità illustra il significato della granularità nel contesto della modellazione dimensionale e come valutare diverse opzioni di granularità in base ai requisiti dell'organizzazione.
Comprendere cosa rappresenta la granularità
La granularità, talvolta denominata "granularità", descrive il livello di dettaglio rappresentato da ogni riga di una tabella. In una tabella dei fatti, la granularità determina l'evento aziendale o la misurazione acquisita da ogni riga. In una tabella dimensionale, il granulo determina come le entità sono rappresentate e versionate.
Si consideri uno scenario di dati dei sensori IoT. È possibile progettare la tabella dei fatti a livelli diversi di granularità:
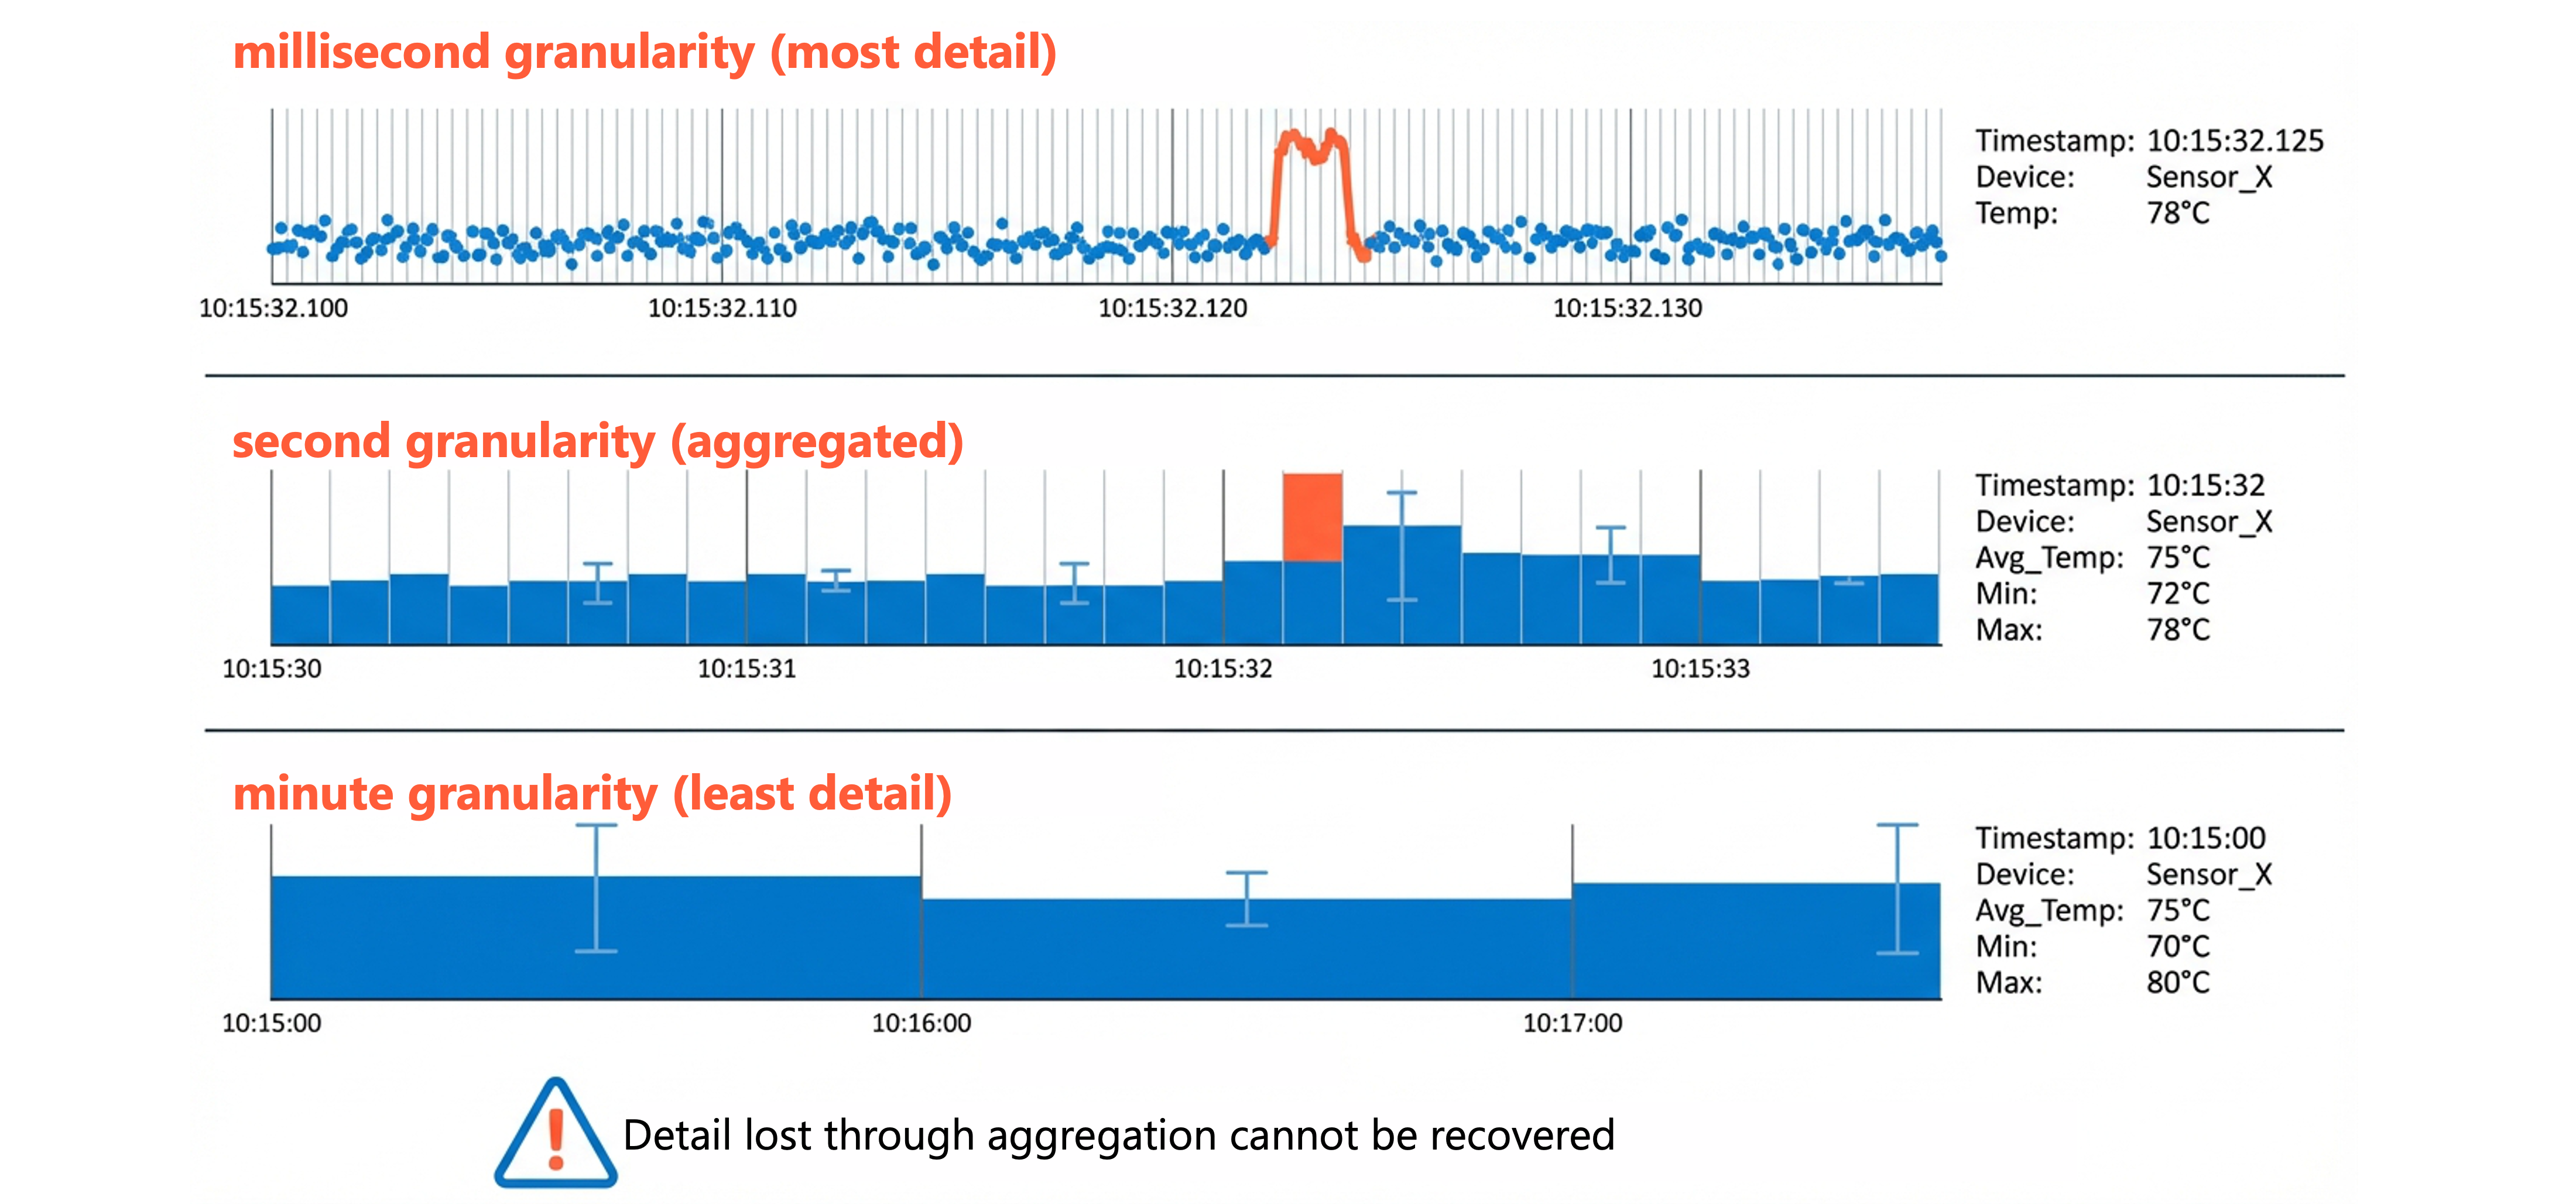
Granularità a livello di millisecondo: ogni riga rappresenta un singolo sensore acquisito a livello di millisecondo. In questo modo vengono acquisite le informazioni più dettagliate, inclusi timestamp precisi, valori del sensore e identificatori di dispositivo per ogni misura.
Seconda granularità aggregata: ogni riga rappresenta il valore medio, minimo o massimo del sensore per un dispositivo al secondo. Le singole letture vengono riepilogate in statistiche al secondo.
Granularità aggregata minuto: ogni riga rappresenta le statistiche aggregate dei sensori per un dispositivo durante un intero minuto. Questo fornisce il minimo dettaglio, ma richiede la quantità minima di spazio di archiviazione.
Il grano scelto influisce su tutti gli elementi downstream. Dopo aver perso i dettagli tramite l'aggregazione, non è possibile recuperarlo. Se la tabella con aggregazione dei minuti indica che il sensore X ha una temperatura media di 75°C durante un minuto specifico, non è possibile determinare quali millisecondi hanno picchi di temperatura o identificare il momento esatto in cui si è verificata un'anomalia.
Valutare i fattori che influenzano le decisioni di granularità
La scelta della granularità appropriata richiede il bilanciamento di più problemi concorrenti. La scelta giusta dipende dal contesto aziendale e dai vincoli tecnici specifici.
I requisiti aziendali determinano la granularità
Le domande analitiche che l'organizzazione deve rispondere devono essere il fattore principale per determinare la granularità. Chiediti: qual è il livello di analisi più dettagliato necessario?
Se i tecnici operativi devono rilevare anomalie delle apparecchiature a livello di millisecondo, le aggregazioni al minuto non sono sufficienti. Se la direzione richiede solo riepiloghi di utilizzo orario in base alla linea di produzione, l'archiviazione di ogni lettura del sensore comporta uno spreco di risorse.
Considerare questi scenari:
| Requisito aziendale | Granularità minima necessaria |
|---|---|
| Rilevare le anomalie delle vibrazioni delle apparecchiature in tempo reale | Livello evento millisecondo |
| Analizzare le tendenze della temperatura per la manutenzione predittiva | Secondo livello di aggregazione |
| Monitorare il consumo orario di energia per dispositivo | Livello di aggregazione minuto |
| Segnalare le metriche di produzione giornaliere in base alla struttura | Livello di aggregazione oraria |
I modelli di query influenzano le prestazioni
Il modo in cui gli utenti eseguono query sui dati influisce sulla granularità ottimale. Quando le query in genere filtrano e si aggregano a livelli più elevati, l'archiviazione di dati con granularità eccessiva crea un sovraccarico di elaborazione non necessario. Ogni query deve analizzare e aggregare più righe del necessario.
Allo stesso tempo, l'archiviazione dei dati con una granularità troppo grossolana impedisce agli utenti di eseguire il drill-down per rispondere a domande dettagliate. Per trovare il saldo è necessario comprendere i modelli di query correnti e previsti.
I costi di archiviazione e calcolo si accumulano
Una granularità più fine indica più righe, aumentando così i costi di archiviazione. Aumenta anche i costi di calcolo perché le query devono elaborare più dati. In Azure Databricks, questi costi si accumulano nel tempo poiché i dati storici si accumulano.
Un impianto di produzione con migliaia di sensori che acquisisce letture a intervalli di millisecondi può generare miliardi di righe al giorno con la massima granularità. L'aggregazione a statistiche al secondo o al minuto potrebbe ridurre i conteggi delle righe del 99% o più, che si traduce direttamente in costi di archiviazione e query inferiori.
I requisiti di conformità e controllo sono importanti
I requisiti normativi talvolta impongono livelli di granularità specifici. Le organizzazioni di servizi finanziari spesso devono mantenere i dettagli a livello di transazione a scopo di controllo, indipendentemente dai costi di archiviazione. Le organizzazioni sanitarie potrebbero dover tenere traccia delle interazioni dei singoli pazienti per motivi di conformità.
Quando la conformità determina la decisione di granularità, documentare chiaramente i requisiti. Questa giustificazione aiuta quando gli stakeholder domandano perché stai archiviando più dettagli di quanto necessario per le sole esigenze analitiche.
Applicare la granularità alle tabelle dei fatti
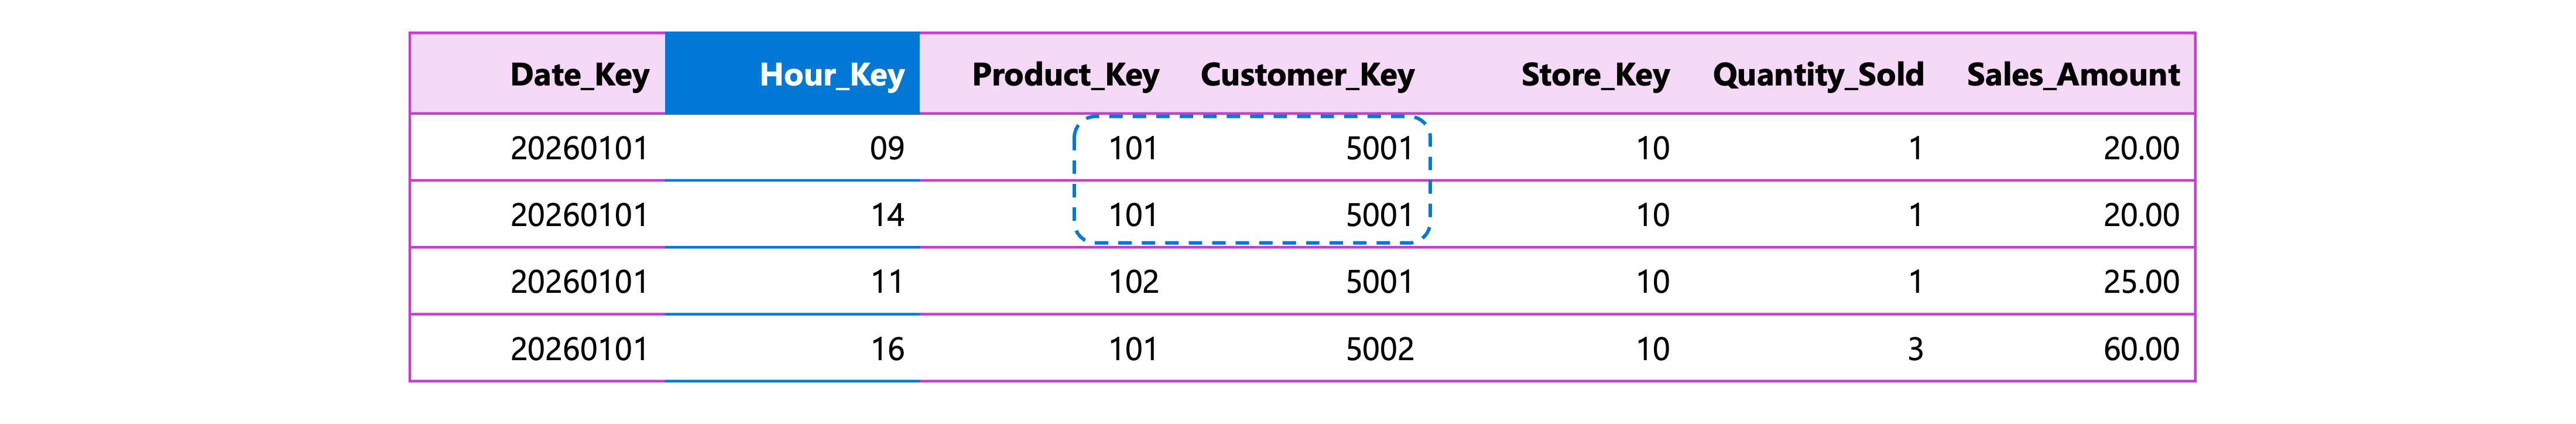
Le tabelle dei fatti traggono maggior vantaggio dalle decisioni di granularità accurate perché in genere contengono i volumi più grandi di dati. La granularità di una tabella dei fatti è determinata dalla combinazione delle relative chiavi di dimensione.
Una tabella dei fatti di vendita con chiavi di dimensione per data, prodotto, cliente e negozio ha una granularità di "una riga per prodotto per cliente per negozio al giorno". Ogni combinazione univoca di questi valori di dimensione crea una riga distinta. L'aggiunta di una chiave della dimensione temporale a livello di ora modifica il livello di granularità in "una riga per prodotto per cliente per punto vendita per ora", aumentando in modo significativo i conteggi delle righe.
Importante
Dichiarare in modo esplicito la granularità della tabella dei fatti prima di aggiungere le colonne. La dichiarazione grain funge da contratto che guida tutte le decisioni di progettazione successive. Ad esempio: "Questa tabella dei fatti contiene una riga per ogni voce dell'ordine di vendita".
Quando si progettano tabelle dei fatti, valutare se è necessario:
Granularità atomica: livello più dettagliato acquisito nel sistema di origine. La scelta della granularità atomica offre la massima flessibilità analitica perché è sempre possibile aggregare, ma non disaggregare mai.
Granularità aggregata: dati pre-riepilogati a un livello superiore rispetto all'origine. Le tabelle dei fatti aggregate migliorano le prestazioni delle query per i modelli analitici comuni, ma limitano le domande a cui gli utenti possono rispondere.
Molte organizzazioni mantengono tabelle dei fatti atomiche e aggregate, usando tabelle aggregate come ottimizzazione delle prestazioni mantenendo i dettagli atomici per l'analisi ad hoc. In Azure Databricks, le viste materializzate possono gestire automaticamente queste tabelle di aggregazione, aggiornandole man mano che cambiano i dati atomici sottostanti.
Applicare la granularità alle tabelle delle dimensioni
Anche le tabelle delle dimensioni hanno una granularità, sebbene funzioni in modo diverso rispetto alla granularità della tabella dei fatti. La granularità della dimensione determina la modalità di rappresentazione e versione delle entità aziendali.
Per una dimensione cliente, potresti scegliere:
- Una riga per cliente: lo stato corrente di ogni cliente, aggiornato sul posto quando gli attributi cambiano (SCD Type 1).
- Una riga per cliente per versione: una nuova riga per ogni modifica significativa, mantenendo gli stati cronologici (scD Type 2).
- Una riga per cliente per periodo di tempo: Istantanee periodiche che acquisiscono degli attributi dei clienti a intervalli regolari.
La granularità della dimensione scelta deve essere allineata alla granularità della tabella dei fatti. Se la tabella dei fatti traccia le singole transazioni con chiavi surrogate alla dimensione cliente, il grano della dimensione cliente deve supportare quella relazione. Una transazione che fa riferimento alla versione 5 del cliente deve essere in grado di trovare tale versione specifica nella tabella delle dimensioni.
Bilanciare i compromessi quando si seleziona la granularità
Nessuna scelta di granularità singola è universalmente corretta. Ogni decisione comporta compromessi che è necessario valutare in base ai requisiti specifici.
| Considerazione | Granularità fine | Granularità grossolana |
|---|---|---|
| Flessibilità analitica | Alto: può rispondere a domande dettagliate | Bassa - limitata all'analisi aggregata |
| Costi di archiviazione | Più alto - più righe da archiviare | Inferiore : meno righe |
| Prestazioni delle query | Più lento per le query di aggregazione | Più veloce per i modelli comuni |
| Analisi cronologica | Supporta l'analisi puntuale | Può perdere dettagli cronologici |
| Supporto per la conformità | Migliore per i requisiti di controllo | Potrebbe non rispettare le normative |
Quando non si è certi, a partire dalla granularità più fine è spesso più sicuro. È sempre possibile creare tabelle di aggregazione in un secondo momento per l'ottimizzazione delle prestazioni, ma non è possibile recuperare i dettagli mai acquisiti. Tuttavia, queste linee guida presuppongono che sia disponibile il budget e l'infrastruttura per supportare inizialmente l'archiviazione più granulare.
Comprendere come scegliere la granularità appropriata consente di progettare modelli di dati che supportano le esigenze analitiche dell'organizzazione gestendo i costi in modo efficace. I dettagli di implementazione per la compilazione e il caricamento di tabelle in base alla granularità scelta in Azure Databricks sono trattati in unità successive.