Implementare i controlli di convalida
Le pipeline di dati spesso riscontrano record con valori mancanti, identificatori duplicati o valori che non rientrano negli intervalli accettabili. Senza controlli di convalida, questi problemi di qualità dei dati si propagano a valle, causando analisi non corrette, report non riusciti e decisioni aziendali inaffidabili. I controlli di convalida intercettano questi problemi al momento dell'inserimento dei dati, assicurandosi che solo i dati qualitativi vengano trasmessi attraverso la pipeline.
In questa unità si apprenderà come implementare i controlli di convalida della nullabilità, della cardinalità dei dati e del controllo dell'intervallo usando le aspettative delle pipeline di Lakeflow e i vincoli di tabella Delta Lake.
Informazioni sugli approcci di convalida in Azure Databricks
Azure Databricks offre due meccanismi principali per l'implementazione dei controlli di convalida: aspettative della pipeline e vincoli di tabella. Ogni approccio offre scenari diversi e offre funzionalità distinte.
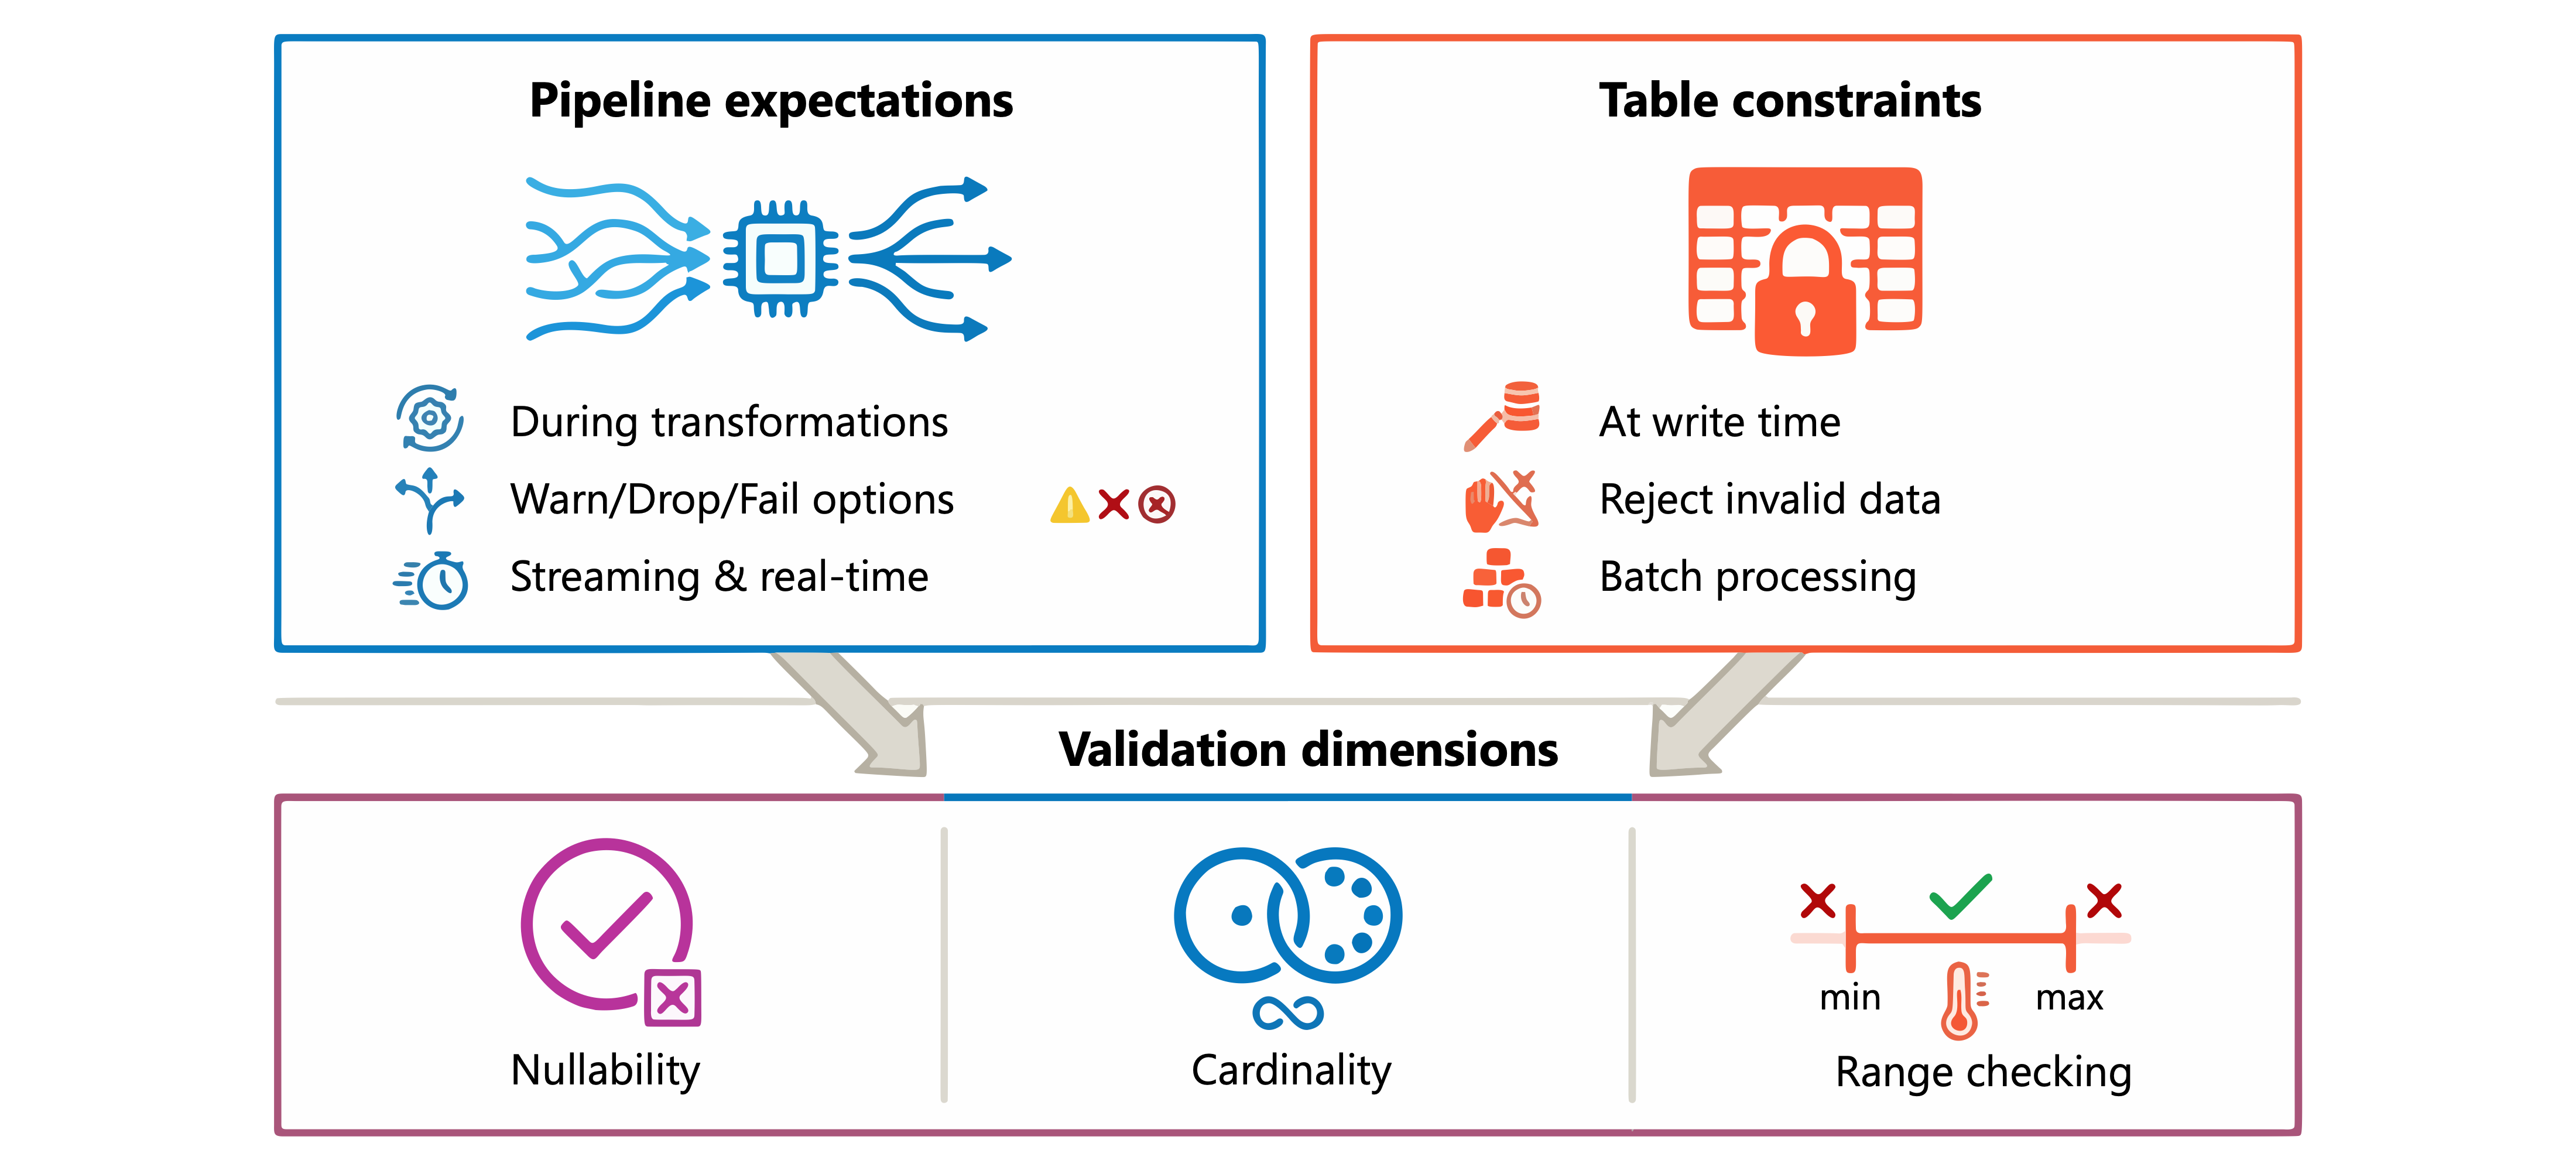
Le aspettative della pipeline consentono di applicare la convalida durante le trasformazioni dei dati nelle pipeline Lakeflow. Le aspettative consentono di avvisare, eliminare record non validi o interrompere la pipeline quando i dati violano le regole. Questo approccio funziona bene per le tabelle di streaming e le viste materializzate in cui è necessario un controllo qualitativo in tempo reale.
I vincoli di tabella applicano le regole direttamente nelle tabelle Delta Lake. I vincoli rifiutano i dati non validi in fase di scrittura, impedendo l'immissione di record non validi nelle tabelle. Questo approccio è adatto all'elaborazione batch e agli scenari che richiedono rigide garanzie di integrità dei dati.
Con questi approcci, è possibile convalidare tre dimensioni chiave della qualità dei dati: nullbility (verifica dell'esistenza di valori obbligatori), cardinalità dei dati (verifica dell'univocità dove previsto) e controllo dell'intervallo (confermando che i valori rientrano entro limiti accettabili).
Implementare controlli di nullabilità
La validazione della nullabilità garantisce che le colonne obbligatorie contengano valori. Si consideri una tabella cliente in cui email e customer_id deve avere sempre valori. È possibile implementare questi controlli usando le aspettative nella pipeline.
Usando Python, aggiungi decoratori delle aspettative alla definizione della tabella di streaming.
from pyspark import pipelines as dp

@dp.table
@dp.expect_or_drop("valid_email", "email IS NOT NULL")
@dp.expect_or_drop("valid_customer_id", "customer_id IS NOT NULL")
def customers():
    return spark.readStream.table("raw.customers")
La stessa convalida in SQL usa la CONSTRAINT clausola :
CREATE OR REFRESH STREAMING TABLE customers(
    CONSTRAINT valid_email EXPECT (email IS NOT NULL) ON VIOLATION DROP ROW,
    CONSTRAINT valid_customer_id EXPECT (customer_id IS NOT NULL) ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.customers);
Per le tabelle Delta Lake esterne alle pipeline, usare i vincoli NOT NULL nella definizione della tabella.
CREATE TABLE customers (
    customer_id INT NOT NULL,
    email STRING NOT NULL,
    first_name STRING,
    last_name STRING
);
È anche possibile aggiungere vincoli di nullità alle tabelle esistenti:
ALTER TABLE customers ALTER COLUMN email SET NOT NULL;
Annotazioni
Prima di aggiungere un NOT NULL vincolo a una tabella esistente, Azure Databricks verifica che tutte le righe esistenti soddisfino il vincolo. L'operazione ha esito negativo se nella colonna sono presenti valori Null.
Convalidare la cardinalità dei dati
La convalida della cardinalità garantisce che le colonne previste per contenere valori univoci lo facciano effettivamente. Questo controllo è essenziale per le chiavi primarie, gli identificatori delle transazioni e altri campi in cui i duplicati indicano problemi di qualità dei dati.
Le aspettative della pipeline possono convalidare la cardinalità verificando le condizioni che indicano problemi di unicità. Ad esempio, è possibile verificare che venga visualizzato un numero di previdenza sociale una sola volta per persona:
from pyspark.sql.window import Window
from pyspark.sql.functions import count

@dp.table
@dp.expect("unique_ssn_per_person", "ssn_count = 1")
def employees():
    df = spark.table("raw.employees")
    w = Window.partitionBy("ssn")
    return df.withColumn("ssn_count", count("*").over(w))
Per controlli di cardinalità più completi, combina le aspettative con la logica di aggregazione nelle tue trasformazioni.
CREATE OR REFRESH MATERIALIZED VIEW order_validation AS
SELECT
    order_id,
    COUNT(*) as occurrence_count
FROM orders
GROUP BY order_id
HAVING COUNT(*) > 1;
Questa vista materializzata identifica gli ID degli ordini duplicati, consentendo di analizzare e risolvere i problemi di cardinalità.
Delta Lake supporta vincoli di chiave primaria che documentano l'univocità prevista, anche se questi vincoli sono informativi e non applicati:
CREATE TABLE orders (
    order_id INT NOT NULL,
    customer_id INT,
    order_date DATE,
    CONSTRAINT orders_pk PRIMARY KEY (order_id)
);
Suggerimento
Anche se i vincoli di chiave primaria non vengono applicati, consentono di ottimizzare le query e documentare la struttura prevista del modello di dati. Usare le aspettative della pipeline per applicare attivamente l'univocità.
Applicare il controllo dell'intervallo
La convalida dell'intervallo conferma che i valori numerici, di data e di altro tipo rientrano nei limiti accettabili. Questo controllo rileva errori di immissione dei dati, glitch di sistema e problemi di integrazione che producono valori non compresi nell'intervallo.
Definire le aspettative di intervallo usando gli operatori di confronto o la BETWEEN clausola :
@dp.table
@dp.expect_or_fail("valid_age", "age BETWEEN 0 AND 150")
@dp.expect_or_fail("valid_salary", "salary >= 0")
@dp.expect_or_fail("valid_hire_date", "hire_date <= current_date()")
def employees():
    return spark.readStream.table("raw.employees")
In SQL applicare gli stessi controlli di intervallo:
CREATE OR REFRESH STREAMING TABLE transactions(
    CONSTRAINT valid_amount EXPECT (amount > 0) ON VIOLATION DROP ROW,
    CONSTRAINT valid_date EXPECT (transaction_date <= current_date()) ON VIOLATION DROP ROW,
    CONSTRAINT valid_quantity EXPECT (quantity BETWEEN 1 AND 10000) ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.transactions);
Per le tabelle Delta Lake, usare CHECK i vincoli per applicare intervalli in fase di scrittura:
ALTER TABLE employees ADD CONSTRAINT valid_age CHECK (age >= 18 AND age <= 120);
ALTER TABLE transactions ADD CONSTRAINT positive_amount CHECK (amount > 0);
I controlli di intervallo possono anche convalidare le regole business che combinano più condizioni:
@dp.expect("valid_discount", """
    discount_percent >= 0
    AND discount_percent <= 100
    AND (discount_percent <= 50 OR customer_tier = 'PREMIUM')
""")
Questa aspettativa garantisce che gli sconti rimangano entro limiti e impone che solo i clienti Premium ricevano sconti oltre 50%.
Scegliere le azioni per gli errori di convalida
Quando la convalida ha esito negativo, scegli come risponderà la tua pipeline. Ogni azione soddisfa i diversi requisiti aziendali e i livelli di criticità dei dati.
| Action | Caso d'uso | Comportamento |
|---|---|---|
| Avvisa (impostazione predefinita) | Monitoraggio e analisi | I record non validi vengono scritti nel target; metriche registrate |
| Drop | Pulizia dei dati | Record non validi rimossi prima della scrittura |
| Esito negativo | Integrità dei dati critici | La pipeline si arresta; rollback delle transazioni |
Usare l'azione di avviso quando è necessaria visibilità sui problemi di qualità dei dati senza bloccare il flusso di dati:
@dp.expect("has_phone", "phone_number IS NOT NULL")
Usare drop quando i record non validi devono essere filtrati automaticamente:
@dp.expect_or_drop("complete_address", "street IS NOT NULL AND city IS NOT NULL")
Usare fallimento quando l'integrità dei dati è critica e i record non validi non sono accettabili:
@dp.expect_or_fail("valid_account_balance", "balance >= 0")
È possibile visualizzare le metriche delle aspettative nell'interfaccia utente della pipeline selezionando un set di dati con aspettative e aprendo la scheda Qualità dei dati . Queste metriche consentono di monitorare i tassi di convalida e identificare problemi di qualità dei dati sistematici.
Ora che avete appreso come implementare i controlli di convalida, potete assicurarvi che le pipeline di dati mantengano gli standard di qualità per nullabilità, cardinalità e intervalli di valori.