検索強化生成 (RAG) ソリューションのこれまでの手順では、ドキュメントをチャンク化して、各チャンクに情報を付加しました。 この手順では、これらのチャンクと、ベクター検索を実行する予定のメタデータ フィールドの埋め込みを生成します。
この記事はシリーズの一部です。 概要を参照してください。
埋め込みは、テキストなどのオブジェクトの数学的表現です。 ニューラル ネットワークのトレーニング中に、プロセスによってオブジェクトの多くの表現が作成されます。 各表現には、ネットワーク内の他のオブジェクトへの接続があります。 埋め込みは、オブジェクトのセマンティックな意味をキャプチャするため重要です。
1 つのオブジェクトの表現は、他のオブジェクトの表現に接続されているため、オブジェクトを数学的に比較できます。 次の例は、埋め込みによって、オブジェクト間のセマンティックな意味とリレーションシップをキャプチャする方法を示しています。
embedding (king) - embedding (man) + embedding (woman) = embedding (queen)
類似度と距離の概念を使用して、埋め込みを相互に比較します。 次のグリッドは、埋め込みの比較を示しています。
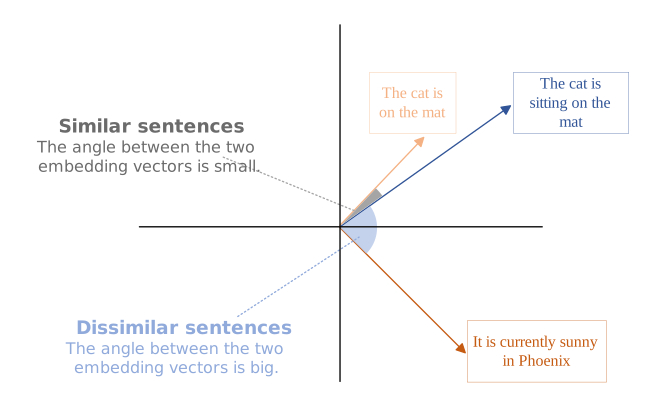
2 次元グリッドを示す図。 「猫はマットの上にいる」と「猫はマットの上に座っている」の文は、お互いに近い状態で、グリッドの右上のクアドラントのボックスに入っています。 各ボックスを指す 2 つのベクトルがあります。 ベクトル間の角度が小さい。 右下のクアドラントには、"現在フェニックスで晴れている" というテキストを含むボックスがあります。 ベクトルはそのボックスを指します。 そのベクトルと「猫がマットの上に座っている」のベクトルの間の角度が大きい。
RAG ソリューションでは、チャンクと同じ埋め込みモデルを使用してユーザー クエリを埋め込みます。 次に、データベースで関連するベクターを検索して、最も意味的に関連するチャンクを返します。 関連するチャンクの元のテキストは、接地データとして言語モデルに渡されます。
注
ベクトルは、数学的比較を可能にする方法でテキストのセマンティックな意味を表します。 ベクトル間の数学的近接性がセマンティック関連性を正確に反映するように、チャンクをクリーンアップする必要があります。
埋め込みモデルの重要性を理解する
選択した埋め込みモデルは、ベクター検索結果の関連性に大きく影響する可能性があります。 埋め込みモデルのボキャブラリを慎重に検討する必要があります。 すべての埋め込みモデルは、特定のボキャブラリでトレーニングされます。 たとえば、 トランスフォーマー (BERT) モデルからの双方向エンコーダー表現 のボキャブラリ サイズは約 30,000 語です。
埋め込みモデルのボキャブラリは、ボキャブラリにない単語を独自の方法で処理するため、重要です。 単語がモデルのボキャブラリにない場合でも、モデルはそのベクトルを計算します。 多くのモデルでは、単語がサブワードに分割されます。 サブワードを個別のトークンとして扱うか、サブワードのベクトルを集計して単一の埋め込みを作成します。
たとえば、ヒスタミンという単語は、埋め込みモデルのボキャブラリに含まれていない可能性があります。 ヒスタミンという言葉は意味的な意味を持っています: アレルギー症状を引き起こすあなたの体が放出する化学物質. 埋め込みモデルに ヒスタミンが含まれていない場合は、単語をボキャブラリ内のサブワード ( his、 ta、 mine など) に分割する可能性があります。
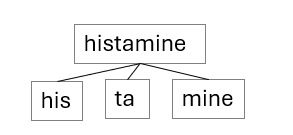
これらのサブワードの意味は、ヒスタミンの意味とはかけ離れています。 サブワードの個々のベクトル値または結合されたベクトル値は、 ヒスタミン という単語がモデルのボキャブラリに含まれている場合と比較して、ベクトルの一致が悪くなります。
埋め込みモデルを選択する
ユース ケースに適した埋め込みモデルを決定します。 埋め込みモデルを選択するときに、埋め込みモデルのボキャブラリとデータの単語の重複を考慮してください。
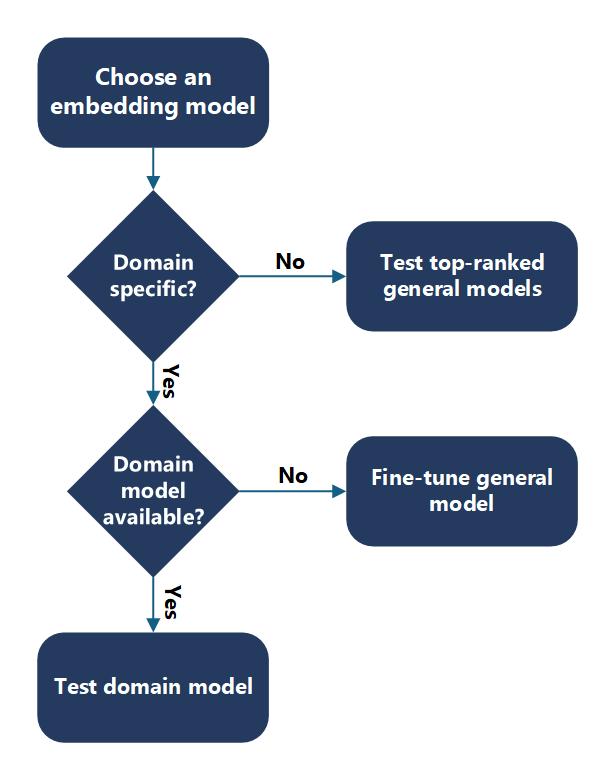
最初の決定は "ドメイン固有?" です。 いいえの場合、フローは "最上位の一般モデルをテストする" で終了します。 "はい" の場合、次の決定は "ドメイン モデルが使用可能か" です。 いいえの場合、フローは "一般的なモデルの微調整" で終了します。 "はい" の場合、フローは "テスト ドメイン モデル" で終了します。
まず、ドメイン固有のコンテンツがあるかどうかを判断します。 たとえば、ドキュメントはユース ケース、組織、業界に固有ですか? ドメインの特定性を判断する良い方法は、インターネット上のコンテンツでエンティティとキーワードを見つけることができるかどうかを確認することです。 可能であれば、一般的な埋め込みモデルも可能です。
一般的なコンテンツまたはドメイン固有でないコンテンツ
一般的な埋め込みモデルを選択する場合は、 Hugging Face ランキング モデルのランキングから始めます。 モデルがデータでどのように機能するかを評価し、上位のモデルから始めます。
ドメイン固有のコンテンツ
ドメイン固有のコンテンツの場合は、ドメイン固有のモデルを使用できるかどうかを判断します。 たとえば、データに生体文献が含まれている場合は、 PubMedBERT Embeddings モデルを使用できます。 このモデルは、Microsoft PubMedBERT に基づいており、医療論文に対するセマンティック検索用の埋め込みを生成するように設計されています。 ドメイン固有のモデルが使用可能な場合は、これらのモデルがデータとどのように連携するかを評価します。
ドメイン固有のモデルがない場合、またはドメイン固有のモデルがうまく動作しない場合は、ドメイン固有のボキャブラリを使用して一般的な埋め込みモデルを微調整できます。
重要
選択したモデルについて、ライセンスがニーズに合っていることを確認し、モデルが必要な言語サポートを提供していることを確認します。
マルチモーダル埋め込みの生成
埋め込みはテキストに限定されません。 テキストやその他のメディアの種類 (画像、オーディオ、ビデオなど) の埋め込みを生成できます。 埋め込みを生成するプロセスは、モダリティ間で似ています。 コンテンツを読み込み、埋め込みモデルを介して渡し、結果のベクターを格納します。 ただし、モデルと前処理の手順の選択は、メディアの種類によって異なります。
たとえば、 Contrastive Language-Image Pre-Training (CLIP) などのモデルを使用して、画像埋め込みを生成できます。 その後、ベクター検索で埋め込みを使用して、セマンティックに似た画像を取得できます。 ビデオの場合は、オブジェクトの存在やストーリーの概要など、特定の特徴を抽出するスキーマを定義し、特殊なモデルを使用してそれらの特徴の埋め込みを生成する必要があります。
ヒント
スキーマを使用して、マルチモーダル コンテンツから抽出する機能を定義します。 この方法では、取得目標に合わせて埋め込みを最適化します。
埋め込みのためのマルチモーダル コンテンツの前処理
マルチモーダル コンテンツの埋め込みを生成する前に、テキスト以外のメディアを埋め込みモデルで処理できるテキスト表現に変換します。 Azure Content Understanding は、埋め込む前のマルチモーダル コンテンツの前処理手順として機能します。 Content Understanding は、ドキュメント、画像、ビデオ、オーディオを構造化された Markdown および JSON 出力に変換し、標準のテキスト埋め込みモデルを使用して埋め込むことができます。
たとえば、Content Understanding ビデオ アナライザー は、シーンの説明、WebVTT 形式のインライン トランスクリプト、およびキー フレーム参照を含む Markdown 出力を生成します。 同様に、 オーディオ アナライザーは 、話者のダイアライズと概要を含むトランスクリプトを生成します。 埋め込みモデルを使用して生のメディア ファイルを直接処理するのではなく、この構造化されたテキスト出力を埋め込むことができます。
次の例は、Content Understanding 出力を前処理し、ベクター ストアに埋め込む方法を示しています。 プレースホルダーの値を独自のリソース設定に置き換え、Content Understanding アナライザーから返された実際の応答を使用します。
    from langchain.docstore.document import Document
    from langchain_openai import AzureOpenAIEmbeddings
    from langchain_community.vectorstores.azuresearch import AzureSearch

    # analyzer_content holds the structured output that your Content Understanding
    # analyzer returns. Convert each content item to a string and wrap it in a
    # LangChain Document so that you can embed it.
    document_splits = [ str(content) for content in analyzer_content[0]["content"] ]
]
docs = [Document(page_content=v) for v in document_splits]

# Embed and index in Azure AI Search
aoai_embeddings = AzureOpenAIEmbeddings(
    azure_deployment=EMBEDDING_DEPLOYMENT_NAME,
    openai_api_version="2023-05-15",
    azure_endpoint=OPENAI_ENDPOINT,
)

vector_store = AzureSearch(
    azure_search_endpoint=SEARCH_ENDPOINT,
    index_name="multimodal-index",
    embedding_function=aoai_embeddings.embed_query,
)
vector_store.add_documents(documents=docs)
完全な実装については、Content Understanding RAG Pythonコード サンプルを参照してください。
次元の削減を使用する
ベクターの埋め込みには高次元を使用できるため、ストレージとコンピューティングのコストが増加します。 次元の削減手法は、埋め込みをより管理しやすく、コスト効率が高く、解釈しやすくするのに役立ちます。
t 分散確率的近隣埋め込み (t-SNE) や主成分分析 (PCA) などのアルゴリズムを使用して、ベクトル内の次元数を減らすことができます。 これらのツールは、PyTorch や scikit-learn などのライブラリで使用できます。
次元の削減により、セマンティックの明確さと視覚化が向上します。 また、高密度埋め込みの未使用またはノイズの多い機能を排除するのにも役立ちます。
注
次元の減少は後処理ステップです。 埋め込みを生成した後に適用して、ストレージと取得のパフォーマンスを最適化します。
埋め込みを比較する
埋め込みを評価するときは、数式を使用してベクトルを比較できます。 これらの数式は、2 つの埋め込みがどの程度類似しているか、または類似していないかを判断するのに役立ちます。
一般的な比較方法は次のとおりです。
- コサインの類似性: 2 つのベクトル間の角度を測定します。 高次元データに便利です。
- ユークリッド距離: 2 つのベクトル間の直線距離を測定します。
- マンハッタンの距離: ベクトル 成分間の絶対差を測定します。
- ドット積: あるベクトルの別のベクトルへの投影を測定します。
ヒント
ユース ケースに基づいて比較方法を選択します。 たとえば、セマンティックの近接性を測定する場合はコサインの類似性を使用し、リテラルの近接性を測定する場合はユークリッド距離を使用します。
埋め込みモデルを評価する
埋め込みモデルを評価するには、埋め込みを視覚化し、質問ベクトルとチャンク ベクトル間の距離を評価します。
埋め込みを視覚化する
t-SNE などのライブラリを使用して、チャンクのベクトルと質問を X-Y グラフにプロットできます。 その後、どの程度チャンクが互いに離れているか、また質問から離れているかを判断できます。 次のグラフは、プロットされたチャンク ベクトルを示しています。 互いに近い 2 つの矢印は、2 つのチャンク ベクトルを表します。 もう 1 つの矢印は質問ベクトルを表します。 この視覚化を使用して、質問がチャンクからどのくらい離れているかを理解できます。
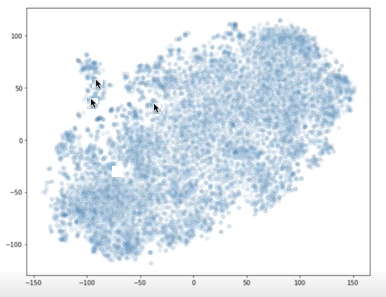
2 つの矢印は、互いに近接したプロット点を指しています。 別の矢印は、他の 2 つから遠く離れたプロット ポイントを示しています。
埋め込み距離を計算する
プログラムによる方法を使用して、埋め込みモデルが質問やチャンクとどの程度うまく機能するかを評価できます。 質問ベクトルとチャンク ベクトルの間の距離を計算します。 ユークリッド距離またはマンハッタン距離を使用できます。
取得パフォーマンスを使用して埋め込みモデルを評価する
最適な埋め込みモデルを選択するには、取得シナリオでのパフォーマンスを評価します。 コンテンツを埋め込み、ベクター検索を実行し、正しい項目が取得されたかどうかを評価します。
さまざまなモデル、比較式、および次元設定を試すことができます。 評価メトリックを使用して、ユース ケースに最適な結果を提供するモデルを決定します。
重要
取得パフォーマンスは、埋め込み品質を評価するための最も実用的な方法です。 実際のクエリとコンテンツを使用してモデルをテストします。
埋め込みモデルを微調整する
一般的なモデルまたはドメイン固有のモデルがニーズを満たしていない場合は、独自のデータを使用して微調整できます。 微調整では、ボキャブラリとセマンティクスをより適切に表すために、モデルの重みを調整します。
微調整により、特にコード検索や法的ドキュメントなどの特殊なドメインの取得精度を向上させることができます。 ただし、慎重な評価が必要であり、トレーニング データが不十分な場合はパフォーマンスが低下することがあります。
1 ビット強化学習 (RL) などの最新の手法により、微調整のコスト効率が高くなります。
ヒント
モデルを微調整する前に、プロンプト エンジニアリングまたは制約付きデコードで問題を解決できるかどうかを評価します。 評価メトリックと検索パフォーマンスを使用して、微調整を行います。
Hugging Face ランキングを使用する
Hugging Face リーダーボードは、埋め込みモデルの最新のランキングを提供します。 これを使用して、ユース ケースで最もパフォーマンスの高いモデルを特定します。
モデルを確認するときは、次の点を考慮してください。
- トークン: モデルのボキャブラリのサイズ。
- 記憶: モデルのサイズと推論コスト。
- 寸法: 出力ベクトルのサイズ。
注
大規模なモデルは、常に優れているとは限りません。 パフォーマンスを向上させることなく、コストが増加する可能性があります。 次元削減と情報検索評価を使用して、適切なバランスを図ります。
埋め込み経済学について
埋め込みモデルを選択する場合は、パフォーマンスとコストのトレードオフを行う必要があります。 通常、大規模な埋め込みモデルでは、データセットのベンチマークのパフォーマンスが向上します。 しかし、パフォーマンスが向上すると、コストが増加します。 大きなベクターでは、ベクター データベース内に必要な領域が増えます。 また、埋め込みを比較するために必要な計算リソースと時間も増えます。 通常、小さな埋め込みモデルでは、同じベンチマークでパフォーマンスが低下します。 ベクター データベースに必要な領域が少なくなり、埋め込みを比較するためのコンピューティングと時間が短縮されます。
システムを設計するときは、ストレージ、コンピューティング、パフォーマンスの要件に関して埋め込みのコストを考慮してください。 実験を通じてモデルのパフォーマンスを検証する必要があります。 一般公開されているベンチマークは、多くの場合、学術的なデータセットであり、ビジネス データやユース ケースには直接適用されない場合があります。 要件に応じて、コストよりもパフォーマンスを優先したり、十分なパフォーマンスのトレードオフを受け入れてコストを削減したりできます。