データベースで CodeQL を実行する
コードをデータベースに抽出したら、CodeQL クエリを使用して分析できるようになりました。 GitHub の専門家、セキュリティ研究者、コミュニティの共同作成者は、既定の CodeQL クエリを記述して維持します。 独自のクエリを記述することもできます。
コード スキャン分析で CodeQL クエリを使用して、ソース コードの問題を見つけ、潜在的なセキュリティの脆弱性を特定できます。 カスタム クエリを記述して、ソース コードで使用している各言語の問題を特定することもできます。
クエリには、次の 2 つの重要な種類があります。
- アラート クエリでは 、コードの特定の場所での問題が強調表示されます。
- パス クエリ は、コード内のソースとシンクの間の情報フローを記述します。
単純な CodeQL クエリ
基本的な CodeQL クエリ構造には、ファイル拡張子 .ql があり、 select 句が含まれています。 クエリ構造の例を次に示します。
/**
 *
 * Query metadata
 *
 */
import /* ... CodeQL libraries or modules ... */

/* ... Optional, define CodeQL classes and predicates ... */

from /* ... variable declarations ... */
where /* ... logical formula ... */
select /* ... expressions ... */
クエリのカスタマイズ
CodeQL 分析はクエリによって実行されます。 GitHubによって提供される標準クエリを使用できますが、独自のクエリを記述してクエリ パックに整理することで、分析をカスタマイズすることもできます。
クエリは通常、 クエリ パックにグループ化されます。クエリ、共有ライブラリ、構成ファイルを含むディレクトリです。 クエリ パックを使用すると、プロジェクトの再利用可能な分析ルールのセットを定義できます。 パック内には、個々の .ql ファイル、再利用可能なロジックを定義するヘルパー ライブラリ、複数のクエリをグループ化するクエリ スイートを含めることができます。
クエリ スイート (.qls ファイル) は、分析中に実行されるクエリを制御するために使用されます。 クエリを 1 つずつ実行する代わりに、実行するすべてのクエリを一覧表示するスイートを定義します。 例えば次が挙げられます。
- description: Custom security queries
- queries:
  - ./queries/hardcoded-credentials.ql
  - ./queries/insecure-config.ql
このスイートは複数のクエリをグループ化して、1 つの分析の一部としてまとめて実行できるようにします。
.ql ファイルを書き込むことで、独自のクエリを作成できます。 クエリは、検出するコード内のパターンを記述します。 通常、言語ライブラリをインポートし、条件を定義し、 select ステートメントを使用して結果を返します。
たとえば、次のクエリでは、ハードコーディングされた資格情報を含む文字列リテラルを検索します。
/**
 * @name Hardcoded credential detection
 * @description Finds string literals that may contain passwords
 * @kind problem
 * @id example/hardcoded-credentials
 * @severity warning
 */

import javascript

from Literal l
where l.getValue().toString().matches("%password%")
select l, "Possible hardcoded credential"
このクエリの場合:
-
importステートメントは、JavaScript の言語モデルを読み込みます。 -
from句は、分析対象のデータを定義します。 -
where句は、一致するパターンをフィルター処理します。 -
selectステートメントは、返される結果を定義します。
標準クエリから開始し、条件または出力を変更することで、カスタム クエリを作成できます。
GitHubコード スキャンでクエリを使用するには、クエリ メタデータを含める必要があります。 メタデータは、ファイルの上部にあるコメント ブロックで定義され、結果の解釈と表示方法を制御します。
少なくとも、メタデータには次のものが含まれている必要があります。
- 一意の識別子 (
@id) - 名前 (
@name) - 説明 (
@description) - 結果の種類 (
@kindやproblemなど、path-problem)
@severityや@precisionなどの追加のプロパティは、GitHubでのアラートの表示方法を決定するのに役立ちます。
メタデータは、コード スキャンとの統合に必要です。 メタデータが存在する場合、結果はリポジトリにアラートとして表示されます。 メタデータがない場合でも、CodeQL はクエリを実行しますが、結果は生出力としてのみ表示され、コード スキャン アラートとして表示されません。
クエリまたはクエリ スイートを定義したら、それらを分析構成に含めることができます。 GitHub Actionsでは、初期化手順中にクエリを指定します。
- name: Initialize CodeQL
  uses: github/codeql-action/init@v3
  with:
    queries: ./path/to/query-suite.qls
ワークフロー中:
- CodeQL によってデータベースが作成されます。
- 選択したクエリを実行します。
- SARIF 形式で結果を生成します。
- 結果をGitHubにアップロードします。
カスタム クエリの結果は、[セキュリティ] タブに標準の CodeQL 結果と共に表示されます。これにより、コードベースに固有のチェックを使用して既定の分析を拡張しながら、GitHubの維持されたクエリ セットの恩恵を受けることができます。
メタデータのクエリを実行する
前のセクションでは、コード スキャンで使用できるように、クエリにメタデータを追加しました。 このセクションでは、メタデータの使用方法と、メタデータがクエリ結果に与える影響について説明します。
クエリ メタデータは、 .ql ファイルの先頭にあるコメント ブロックで定義されます。 クエリに関する情報を提供し、結果の解釈と表示方法を制御します。
メタデータは、CodeQL と GitHub コード スキャンで使用されます。
- クエリとその目的を特定します。
- 結果の分類方法 (
problemやpathなど) を決定します。 - 重大度レベルと精度レベルを割り当てます。
- リポジトリに表示する結果を書式設定します。
たとえば、クエリには次のようなメタデータが含まれる場合があります。
/**
 * @name Hardcoded credential detection
 * @description Finds string literals that may contain passwords
 * @kind problem
 * @id example/hardcoded-credentials
 * @severity warning
 */
このメタデータが存在する場合:
- 結果は SARIF 形式に変換されます。
- アラートは GitHub のコード スキャンに表示されます。
- 結果には、重大度や説明などのコンテキストが含まれます。
メタデータが見つからない場合:
- クエリは引き続き実行されます。
- 結果はアラートとして表示されません。
- 出力は生テーブルとしてのみ表示されます。
メタデータは、スキャン全体で結果をグループ化および追跡する方法も決定します。 たとえば、クエリ @id は、実行間でアラートを照合するために使用されます。
GitHub には、クエリ メタデータに推奨されるスタイル ガイドがあります。 CodeQL ドキュメントで確認できます。
この例では、標準の Java クエリのメタデータを示します。
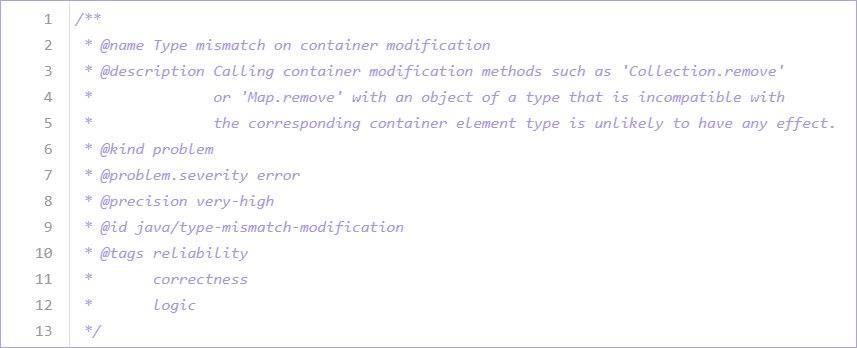
CodeQL では、メタデータを持たないクエリは解釈されません。 これらの結果はテーブルとして表示され、ソース コードには表示されません。
クエリの作成、テスト、実行
カスタム クエリを作成した後、次の手順は、それらをテストし、ワークフローで実行し、時間の経過と同時に保持することです。
クエリを記述するときは、CodeQL がコードベースで検出する必要があるパターンを定義します。 クエリを開発する最も効果的な方法は、リポジトリに追加する前にローカルで反復処理することです。
クエリをローカルでテストする
CodeQL CLI または Visual Studio Code 拡張機能を使用してクエリをテストできます。
CodeQL CLI では、既に作成したデータベースに対してクエリを実行します。
codeql database analyze <database> <query.ql>
このコマンドはクエリを実行し、SARIF または別の出力形式で確認できる結果を生成します。
次のコマンドを実行することもできます。
codeql query run <query.ql> --database=<database>
ローカルでテストすると、次のことができます。
- クエリから期待される結果が返されることを確認します。
- クエリ ロジックを調整します。
- 誤検知または不足しているケースを特定します。
Visual Studio Code拡張機能は、より対話型のエクスペリエンスを提供します。 次のようにすることができます。
- データベースを開きます。
- エディターから直接クエリを実行します。
- ソース コードと共に結果を表示します。
これにより、クエリの動作を理解し、迅速に調整することが容易になります。
GitHub コード スキャンでクエリを実行する
クエリで予想される結果が生成されたら、コード スキャン ワークフローに含めることができます。
GitHub Actionsでは、クエリは初期化手順で構成されます。
- name: Initialize CodeQL
  uses: github/codeql-action/init@v3
  with:
    queries: ./path/to/query-suite.qls
ワークフローの実行時:
- CodeQL は、リポジトリのデータベースを作成します。
- 選択したクエリを実行します。
- 結果を SARIF に変換します。
- 結果をGitHubにアップロードします。
結果は、標準の CodeQL の結果と共に、[ セキュリティ ] タブにアラートとして表示されます。
ワークフローでクエリを実行すると、次のことが保証されます。
- 分析は、プル要求とブランチで自動的に実行されます。
- コードが変更されると、新しい問題が検出されます。
- 結果はチームに表示されます。
クエリの保守と更新
ワークフローにカスタム クエリを追加すると、結果が期待どおりであるとは限らない場合があります。
例えば次が挙げられます。
- クエリが返す結果が多すぎることがあります(偽陽性)。
- 検出が必要なケースが見逃される可能性があります。
- リポジトリ内の新しいコード パターンはカバーされない場合があります。
このような場合は、クエリを更新して精度を向上させます。
まず、クエリをローカルで実行し、結果を確認します。 フラグが設定されたコードの場所を確認し、実際の問題を表しているかどうかを判断します。 そうでない場合は、 where 句の条件を絞り込み、結果を絞り込みます。
たとえば、次のような場合が考えられます。
- 安全なパターンを除外する条件を追加します。
- 文字列照合またはデータ フロー ロジックを調整します。
- 精度を向上させるために、既存のライブラリの述語を再利用します。
クエリを更新した後、データベースに対してもう一度実行して、結果が改善されたことを確認します。
更新されたクエリをコミットすると、コード スキャン ワークフローで自動的に実行されます。 これは、以下のようなことを意味します。
- 既存のアラートは更新または削除できます。
- 新しいアラートは、更新されたロジックに基づいて表示される場合があります。
時間の経過と同時に、コードベースの進化に合わせてこのプロセスを繰り返します。 クエリの維持は、分析が正確で関連性の高い状態を維持するのに役立つ継続的なタスクです。
QL 構文
QL は、宣言型のオブジェクト指向クエリ言語です。 階層データ構造、特にソフトウェア成果物を表すデータベースを効率的に分析できるように最適化されています。
QL の構文は SQL に似ていますが、QL のセマンティクスは Datalog に基づいています。 Datalog は宣言型ロジック プログラミング言語であり、クエリ言語としてよく使用されます。 QL は主にロジック言語であるため、QL のすべての操作は論理操作です。 QL では、データ ログから再帰述語も継承されます。 QL では集計のサポートが追加され、複雑なクエリも簡潔でシンプルになります。
QL 言語は論理式で構成されます。
and、or、notなどの一般的な論理結合を、forallやexistsなどの量指定子と共に使用します。 QL は再帰述語を継承するため、基本的な QL 構文と、 count、 sum、 averageなどの集計を使用して複雑な再帰クエリを記述することもできます。
QL 言語の詳細については、CodeQL のドキュメントを参照してください。
経路クエリ
プログラムを通じて情報が流れる方法は重要です。 無害と思われるデータは、予期しない方法で流れ、悪意を持って使用される可能性があります。
パス クエリを作成すると、コードベースを介して情報のフローを視覚化するのに役立ちます。 クエリでは、データが可能な開始点 (ソース) から使用可能なエンドポイント (シンク) までのパスを追跡できます。 パスをモデル化するには、クエリでソース、シンク、およびそれらをリンクするデータ フローステップに関する情報を提供する必要があります。
独自のパス クエリの記述を開始する最も簡単な方法は、既存のクエリのいずれかをテンプレートとして使用することです。 サポートされている言語のこれらのクエリを取得するには、CodeQL のドキュメントを参照してください。
パス クエリには、特定のメタデータ、クエリ述語、および select ステートメント構造が必要です。 CodeQL の組み込みパス クエリの多くは、基本的な構造に従います。 構造は、分析する言語を CodeQL でモデル化する方法によって異なります。
パス クエリのテンプレートの例を次に示します。
/**
 * ...
 * @kind path-problem
 * ...
 */

import <language>

// For some languages (Java/C++/Python/Swift), you need to explicitly
// import the data-flow library, such as:
// import semmle.code.java.dataflow.DataFlow
// import codeql.swift.dataflow.DataFlow

...

module Flow = DataFlow::Global<MyConfiguration>;
import Flow::PathGraph

from Flow::PathNode source, Flow::PathNode sink
where Flow::flowPath(source, sink)
select sink.getNode(), source, sink, "<message>"
そのテンプレートでは、次の手順を実行します。
-
MyConfigurationは、ソースとシンクの間のデータ フロー方法を定義する述語を含むモジュールです。 -
Flowは、MyConfigurationに基づくデータ フロー計算の結果です。 -
Flow::PathGraphは、クエリにパスの説明を含めるためにインポートする必要がある結果のデータ フロー グラフ モジュールです。 -
sourcesinkは、構成で定義されているグラフ内のノードであり、Flow::PathNodeはその種類です。 -
DataFlow::Global<..>はデータ フローの呼び出しです。 代わりにTaintTracking::Global<..>を使用して、テイント ステップの既定のセットを含めることができます。
パス クエリを記述する方法
パスの説明を生成するには、クエリでパス グラフを計算する必要があります。 そのためには、 edgesというクエリ述語を定義します。 クエリ述語は、クエリ注釈を持つ非メンバー述語です。 クエリ注釈は、述語が評価するすべてのタプルを返します。
edges述語は、計算するグラフのエッジ関係を定義します。 クエリによって生成される各結果に関連するパスを計算するために使用されます。 また、標準データ フロー ライブラリの 1 つで、パス グラフ モジュールから定義済みの edges 述語をインポートすることもできます。
データ フロー ライブラリには、パス グラフ モジュールに加えて、データ フロー分析でよく使用される他のクラス、述語、およびモジュールが含まれています。 CodeQL データ フロー ライブラリは、データ フロー グラフをモデル化するか、データ フロー分析を実装することによって機能します。 通常のデータ フロー ライブラリは、各ステップでデータ値が保持される情報フローを分析するために使用されます。
PathGraphが定義されているデータ フロー ライブラリ (DataFlow.qll) から edges モジュールをインポートするステートメントの例を次に示します。
import DataFlow::PathGraph
CodeQL に含まれる他の多くのライブラリをインポートできます。 また、さまざまな一般的なフレームワークや環境でデータ フロー分析を実装するように特別に設計されたライブラリをインポートすることもできます。
クラス PathNode は、データ フロー分析を実装するように設計されています。
Node呼び出しコンテキスト (シンクを除く)、アクセス パス、および構成で拡張されます。
PathNodeソースから到達可能な値のみが生成されます。
インポート パスの例を次に示します。
import semmle.code.cpp.ir.dataflow.internal.DataFlowImpl
必要に応じて、すべての言語のパス グラフのノードを指定する nodes クエリ述語を定義できます。
nodesを定義すると、選択したノードは端点を持つエッジのみを定義します。
nodesを定義しない場合は、エッジの使用可能なすべての端点を選択する必要があります。
データベース分析
クエリを使用して CodeQL データベースを分析すると、ソース コードのコンテキストで意味のある結果が得られます。 結果は、アラートまたはパスとして SARIF または別の解釈形式でスタイル設定されます。
選択したクエリを実行して結果を解釈することでデータベースを分析する CodeQL データベース コマンドの例を次に示します。
codeql database analyze \
  --format=<format> \
  --output=<output> \
  [--threads=<num>] \
  [--ram=<MB>] \
  <options>... \
  -- <database> <query|dir|suite>...
このコマンドは、 codeql database run-queries コマンドと codeql database interpret-results 配管コマンドの効果を結合します。
または、ソース コード アラートとして解釈される要件を満たしていないクエリを実行することもできます。 これを行うには、以下を使用します。
codeql database run-queriescodeql query run
次に、以下を使用します:
codeql bqrs decode
生の結果を読み取り可能な表記に変換します。
CodeQL CLI マニュアルでは、使用可能な CodeQL CLI コマンドの完全な一覧を取得できます。
SARIF ファイルをカテゴリと共に使用する
CodeQL では、静的分析結果を共有するための SARIF がサポートされています。 SARIF は、さまざまな静的分析ツールの出力を表すために設計されています。
CodeQL 分析に SARIF 出力を使用する場合は 、カテゴリ を指定する必要があります。 カテゴリは、同じコミット リポジトリと、異なる言語またはコードの異なる部分で実行される複数の分析を区別できます。 ただし、同じカテゴリの SARIF ファイルが互いに上書きされます。
カテゴリ値が分析の実行間で一貫している場合、CodeQL を使用して各 SARIF 出力ファイルをスキャンして、同じコード ベース内のさまざまな言語を分析できます。 スキャンされる言語をカテゴリの識別子として使用することをお勧めします。
たとえば、カテゴリ値は次のように表示されます (まだ存在しない場合は末尾にスラッシュが追加されます)。
-
<run>.automationIdSARIF v1 で - SARIF v2 での
<run>.automationLogicalId -
<run>.automationDetails.idSARIF v2.1.0 の場合
SARIF の結果を GitHub に投稿する
データベースの準備ができたら、対話形式でクエリを実行できます。 または、一連のクエリを実行して一連の結果を SARIF 形式で生成し、GitHub.com のターゲット リポジトリに結果をアップロードできます。
codeql github upload-results \
  --sarif=<file> \
  [--github-auth-stdin] \
  [--github-url=<url>] \
  [--repository=<repository-name>] \
  [--ref=<ref>] \
  [--commit=<commit>] \
  [--checkout-path=<path>] \
  <options>...
GitHub に結果をアップロードするには、各継続的インテグレーション (CI) サーバーに、CodeQL CLI で使用する GitHub アプリまたは個人用アクセス トークンがあることを確認します。
security_events書き込みアクセス許可を持つアクセス トークンまたは GitHub アプリを使用する必要があります。
CI サーバーがこのスコープを持つトークンを既に使用して GitHub からリポジトリをチェックアウトしている場合は、CodeQL CLI で同じトークンを使用することが許可される可能性があります。 それ以外の場合は、 security_events 書き込みアクセス許可を持つ新しいトークンを作成し、このトークンを CI システムのシークレット ストアに追加します。
セキュリティのベスト プラクティスとして、 --github-auth-stdin フラグを使用し、標準入力を使用してトークンをコマンドに渡します。
SARIF の結果をアップロードする
Microsoft 以外の静的分析ツールの結果を GitHub リポジトリに表示するコード スキャンでは、結果を、SARIF 2.1.0 JSON スキーマの特定のサブセットをサポートする SARIF ファイルに格納する必要があります。 コード スキャン API または CodeQL CLI を使用して、結果をアップロードできます。
新しいコード スキャンの結果をアップロードするたびに、CodeQL によって結果が処理され、リポジトリにアラートが追加されます。 同じ問題に対するアラートの重複を防ぐために、コード スキャンでは SARIF partialFingerprints プロパティを使用して、選択したブランチの最新の実行で 1 回だけ結果が表示されるように、複数の実行の結果を照合します。
重複を排除すると、ファイルの編集時にアラートを正しいコード行に一致させることができます。
結果のルール ID は、分析全体で同じである必要があります。 指紋データは、CodeQL 分析ワークフローまたは CodeQL ランナーを使用して作成された SARIF ファイルに自動的に含まれます。
SARIF 仕様では、名前付きフィンガープリント型から指紋へのディクショナリである JSON プロパティ名 partialFingerprintsが使用されます。 このプロパティには、少なくとも primaryLocationLineHash の値が含まれています。これにより、プライマリの場所のコンテキストに基づいて指紋が提供されます。
partialFingerprints アクションを使用して SARIF ファイルをアップロードし、このデータが見つからない場合、GitHub はソース ファイルから upload-sarif フィールドを設定しようとします。
さらに、 /code-scanning/sarifs API エンドポイントを使用して指紋データなしで SARIF ファイルをアップロードすると、コード スキャン アラートが処理されて表示されるときに、ユーザーに重複するアラートが表示されることがあります。
静的分析ツールの使用中にアラートが重複しないようにするには、SARIF ファイルをアップロードする前に指紋データを計算し、 partialFingerprints プロパティを設定します。 便利な開始点は、 upload-sarif アクションと同じスクリプトを使用することです。