음성 컨테이너에 워크로드를 보완하고 확장하기 위해 배치 처리 키트를 사용합니다. 컨테이너로 사용할 수 있는 이 오픈 소스 유틸리티는 수와 상관없이 온프레미스 및 클라우드 기반 음성 컨테이너 엔드포인트에 걸쳐 수많은 오디오 파일의 손쉬운 배치 대화기록을 지원합니다.
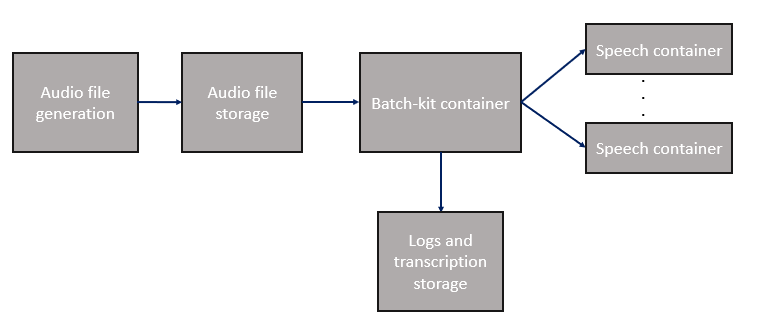
일괄 처리 키트 컨테이너는 GitHub 및 Docker Hub에서 무료로 제공됩니다. 사용하는 Speech 컨테이너에 대해서만 요금이 청구 됩니다.
| 기능 | 설명 |
|---|---|
| 오디오 파일 일괄 배포 | 온프레미스 또는 클라우드 기반 음성 컨테이너 엔드포인트에 자동으로 대량의 파일을 전송합니다. 파일은 모든 POSIX 규격 준수 볼륨에 있을 수 있으며, 네트워크 파일 시스템도 포함됩니다. |
| Speed SDK 통합 | Speech SDK에 n-best 가설, 음성 분할, 언어, 욕설 마스킹 등 공통 플래그를 전달합니다. |
| 실행 모드 | 배치 처리 클라이언트를 한 번만 실행하거나, 백그라운드에서 계속 실행하거나, 오디오 파일의 HTTP 엔드포인트를 생성합니다. |
| 내결함성 | 진행 상황에 영향을 미치지 않고 자동으로 대화기록을 재시도하고 계속 진행하여, 재시도 가능한 오류와 불가한 오류를 구분합니다. |
| 엔드포인트 가용성 탐지 | 엔드포인트가 사용 불가해지면 배치 클라이언트는 다른 컨테이너 엔드포인트를 사용하여 대화기록을 계속합니다. 클라이언트를 사용할 수 있게 되면, 자동으로 엔드포인트 사용이 시작됩니다. |
| 엔드포인트 핫 스왑 | 런타임 중에 베치 처리를 중단하지 않고 음성 컨테이너 엔드포인트를 추가, 제거 또는 수정합니다. 업데이트는 즉시 실행됩니다. |
| 실시간 로깅 | 각 오디오 파일에 대해 Speech SDK 로그 파일을 사용하여 시도한 요청, 타임스탬프 및 실패 이유를 실시간으로 로깅합니다. |
긴 오디오를 안전하게 처리
음성 컨테이너는 최대 24시간 동안 오디오를 지원합니다. 전사 요청 전에 24시간을 초과하는 오디오 파일을 분할하세요. 인코딩, 샘플 속도, 비트 깊이 및 채널 수에 따라 바이트 수가 결정되므로 파일 크기는 기간을 신뢰할 수 없습니다. 예를 들어 1GB는 범용 구분 임계값이 아닙니다.
일부 오디오 파이프라인은 32비트 카운터를 사용하여 기간을 계산합니다. 약 37.3시간이 지나면 카운터에 오버플로가 발생하여 더 짧고 겉보기에는 유효해 보이는 지속 시간을 생성할 수 있습니다. 이 경우 전사는 결과가 잘렸다는 경고 없이도 성공으로 보고될 수 있습니다. 이 오버플로의 정확한 코드 위치는 알 수 없습니다.
전사 후 원본 오디오 길이를 최종 전사문의 오프셋 또는 가장 최근에 인식된 타임스탬프와 비교합니다. 전사 결과가 성공으로 보고되더라도 원본 오디오가 끝나기 훨씬 전에 종료되는 결과는 불완전한 것으로 처리합니다.
원본 오디오를 RIFF/WAV로 변환하는 경우 다음 값을 사용하여 오버플로가 발생한 위치를 식별합니다.
- 변환된 WAV 데이터 청크 길이(
274,568,704바이트)는 변환 또는 파일을 쓰는 동안 오버플로를 나타냅니다. - 데이터 청크 길이
4,569,536,000바이트 또는 올바른 헤더가 있는 4GB보다 큰 파일은 파일이 올바르게 작성되었으며 나중에 처리 파이프라인에서 오버플로가 발생했음을 나타냅니다. 이 경우 엔지니어링에 참여하려면 Microsoft 지원에 문의하세요.
RF64 및 Wave64(W64)는 이 문제에 대한 드롭인 수정이 아닙니다. 파이프라인의 모든 판독기 및 기간 검사 경로는 선택한 형식을 지원해야 합니다. 예를 들어 Python 기본 제공 모듈은 wave RF64 파일을 거부합니다.
docker pull을 사용하여 컨테이너 이미지 가져오기
docker pull 명령을 사용하여 최신 일괄 처리 키트 컨테이너를 다운로드합니다.
참고
다음 예시는 Docker Hub에서 공용 컨테이너 이미지를 가져옵니다. 익명 풀 요청을 실행하는 대신 먼저 Docker Hub 계정(docker login)을 사용하여 인증할 것을 권장합니다. 공용 콘텐츠를 사용 시 안정성을 개선하기 위해서는 이미지를 프라이빗 Azure 컨테이너 레지스트리에서 불러와 관리합니다.
공용 이미지 작업에 대해 자세히 알아봅니다.
docker pull docker.io/batchkit/speech-batch-kit:latest
엔드포인트 구성
일괄 처리 클라이언트는 온-프레미스 컨테이너 엔드포인트를 지정하는 YAML 구성 파일을 사용합니다. 다음 예제에서 사용할 다음 예제를 /mnt/my_nfs/config.yaml에 작성합니다.
MyContainer1:
  concurrency: 5
  host: 192.168.0.100
  port: 5000
  rtf: 3
MyContainer2:
  concurrency: 5
  host: BatchVM0.corp.redmond.microsoft.com
  port: 5000
  rtf: 2
MyContainer3:
  concurrency: 10
  host: localhost
  port: 6001
  rtf: 4
이 YAML 예제에서는 3개의 호스트에 세 개의 음성 컨테이너를 지정합니다. 첫 번째 호스트는 IPv4 주소로 지정되고, 두 번째 호스트는 일괄 처리 클라이언트와 동일한 VM에서 실행되며, 세 번째 컨테이너는 다른 VM의 DNS 호스트 이름으로 지정됩니다.
concurrency 값은 동일한 컨테이너에서 실행할 수 있는 최대 동시 파일 전사를 지정합니다.
rtf (Real-Time Factor) 값은 선택 사항으로, 성능 조정에 사용 가능합니다.
배치 처리 클라이언트는 컨테이너 재시작 또는 네트워킹 문제 등을 이유로 엔드포인트를 사용할 수 없거나, 다시 사용할 수 있는 시점을 동적으로 탐지할 수 있습니다. 사용할 수 없는 컨테이너로는 대화기록 요청이 전송되지 않으며, 클라이언트는 사용 가능한 다른 컨테이너 사용을 계속합니다. 일괄 처리 진행을 중단하지 않고 언제든지 엔드포인트를 추가, 제거 또는 편집할 수 있습니다.
일괄 처리 컨테이너 실행
참고
- 이 예에서는 구성 파일과 입력, 출력 및 로그 디렉터리에 동일한 디렉터리(
/my_nfs)를 사용합니다. 이러한 폴더에 호스트되거나 NFS로 탑재된 디렉터리를 사용할 수 있습니다. -
–h플래그를 사용하여 클라이언트를 실행 시 사용 가능한 명령줄 매개변수와 해당 기본값을 열거합니다. - 배치 처리 컨테이너는 Linux에서만 지원합니다.
컨테이너를 시작하기 위해 Docker run 명령을 사용합니다. 이 명령은 컨테이너 내에서 대화형 셀을 시작합니다.
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs --entrypoint /bin/bash /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest
배치 처리 클라이언트를 실행하기 위해서는 다음을 수행합니다.
run-batch-client -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs -file_log_level DEBUG -nbest 1 -m ONESHOT -diarization None -language en-US -strict_config
단일 명령으로 배치 처리 클라이언트 및 컨테이너를 실행하기 위해서는 다음을 수행합니다.
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs
클라이언트 실행이 시작됩니다. 오디오 파일이 이전 실행에 대화기록된 경우, 클라이언트가 자동으로 파일을 건너뜁니다. 일시적인 오류가 발생할 경우 자동 재시도 기능으로 파일이 전송되며 클라이언트가 다시 시도할 오류를 구분할 수 있습니다. 클라이언트는 대화기록 오류 시 대화기록을 계속하고, 경과에 영향을 미치지 않고 재시도할 수 있습니다.
실행 모드
일괄 처리 키트는 --run-mode 매개 변수를 사용하여 세 가지 모드를 제공합니다.
ONESHOT 모드는 단일 음성 파일 패치(입력 디렉터리와 선택적 파일 목록)에서 출력 폴더로 대화기록을 합니다.
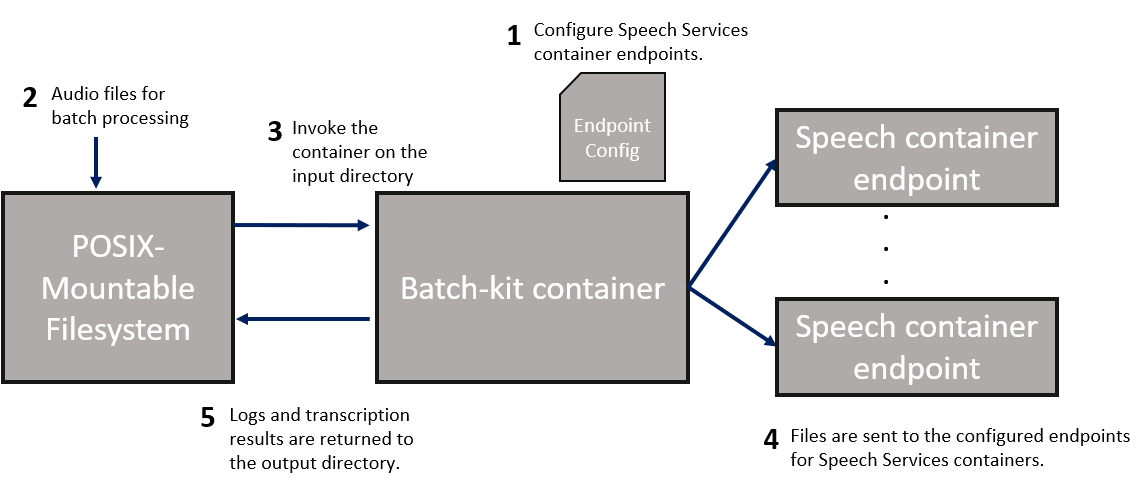
- 배치 클라이언트가 사용하는 Speech 컨테이너 엔드포인트를
config.yaml파일에 정의합니다. - 대화기록을 위한 음성 파일은 입력 디렉터리에 배치합니다.
- 파일 처리를 시작하기 위해 디렉터리에 컨테이너를 호출합니다. 이전 실행에서 음성 파일이 동일한 출력 디렉터리(동일한 파일 이름 및 체크섬)로 이미 대화기록되었다면 클라이언트는 그 파일을 건너뜁니다.
- 파일은 1단계의 컨테이너 엔드포인트로 디스패치됩니다.
- 지정된 출력 디렉터리로 로그 및 음성 컨테이너 출력이 반환됩니다.

로깅
참고
run.log 파일이 너무 커지면 일괄 처리 클라이언트가 주기적으로 덮어쓸 수 있습니다.
클라이언트는 명령에서 -log_folder 인수로 지정된 디렉터리에 run 파일을 생성합니다. 로그는 기본적으로 DEBUG 수준에서 기록됩니다.
stdout/stderr로 동일한 로그가 전송되어 -file_log_level 또는 console_log_level 인수에 따라 필터링됩니다. 이 로그는 디버깅, 또는 지원을 위해 추적을 보내야 하는 경우에만 필요합니다. 로깅 폴더에는 각 음성 파일에 대한 Speech SDK 로그도 포함되어 있습니다.
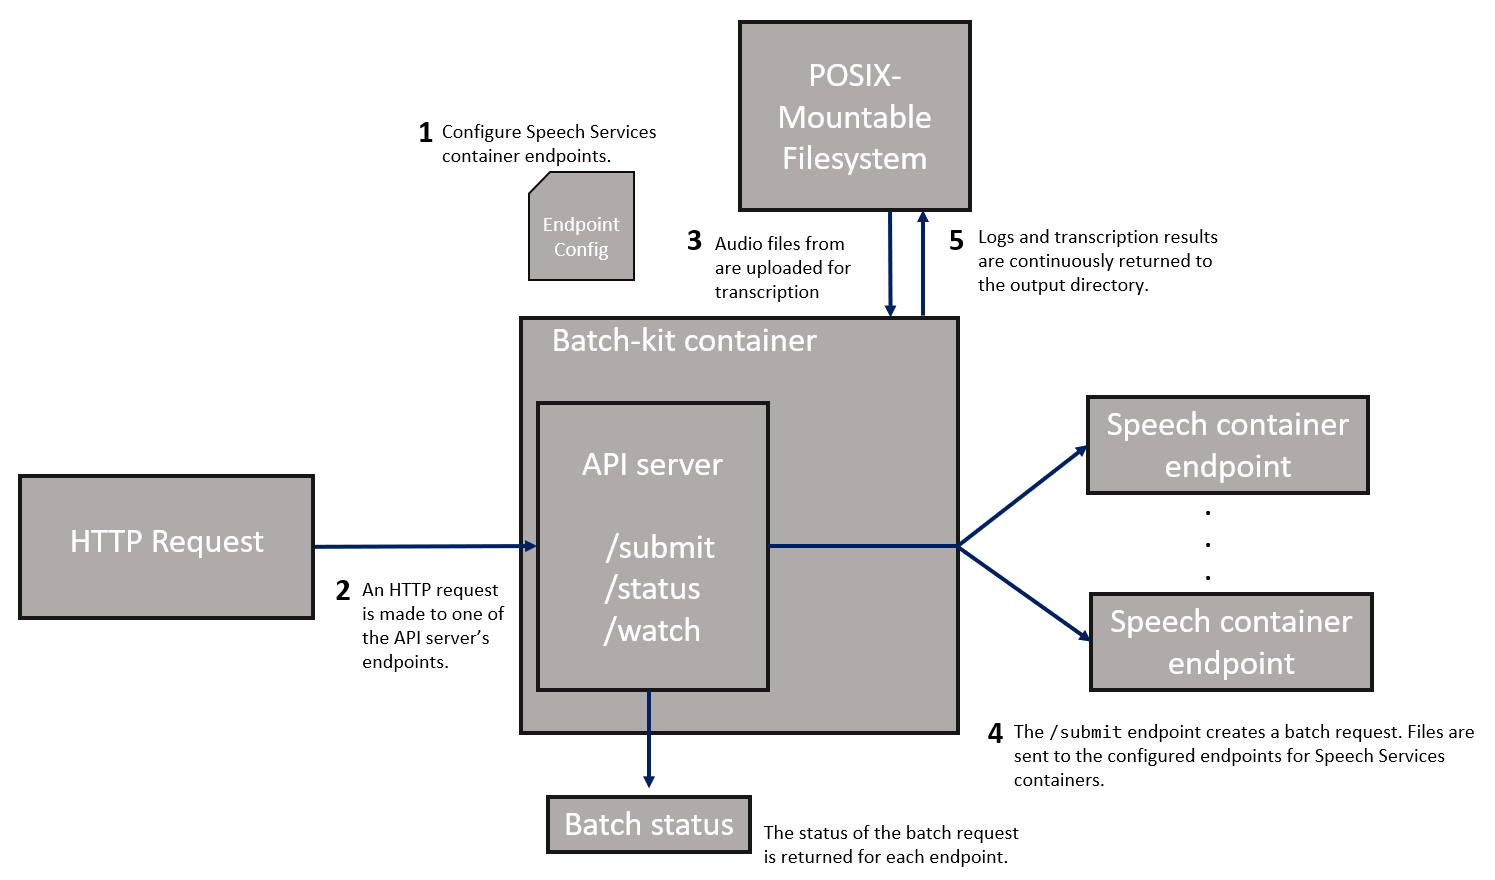
-output_folder로 지정된 출력 디렉터리에는 30초마다 또는 새 대화 내용 기록이 완료될 때마다 주기적으로 재작성되는 run_summary.json 파일이 포함되어 있습니다. 일괄 처리가 진행되는 동안 진행 상황을 확인하기 위해서는 이 파일을 사용합니다. 또한 배치가 완료되면 모든 파일의 최종 실행 통계와 최종 상태가 포함됩니다. 프로세스가 완전히 종료되면 일괄 처리가 완료됩니다.