ADX(Azure Data Explorer)는 대규모 원격 분석 및 로그 데이터를 실시간으로 분석하기 위한 완전 관리형 분석 플랫폼입니다. 이 문서에서는 Azure Data Explorer에서 수집된 GB당 비용을 계산하는 방법, 이를 구동하는 요인 및 비용 효율성을 위해 클러스터를 최적화하는 방법을 설명합니다. 빅 데이터 분석 플랫폼은 다양한 가격 책정 모델을 사용합니다. 많은 플랫폼은 쿼리 볼륨, 데이터 수집, 스토리지 기간 및 컴퓨팅 리소스와 같은 요인에 따라 가격을 책정합니다. 이러한 복잡성으로 인해 제품 간 가격 책정을 비교하기가 어렵습니다.
Azure Data Explorer 사용 비용을 이해하기 위해 이 문서에서는 수집된 GB당 메트릭 비용을 사용합니다. 이 메트릭은 총 클러스터 비용 (컴퓨팅, 스토리지, 네트워킹 및 서비스 태그)을 해당 기간 동안 수집된 총 원래 크기 데이터 로 나눈 값입니다.
2025년 6월 ADX 클러스터의 대표적인 스냅샷은 예제 분석을 접지하는 데 사용됩니다. 다음 섹션에서는 분석의 주요 결과를 보여 줍니다. 비용 변동을 유발하는 요소 와 사용자가 성능 저하 없이 수집된 GB당 비용을 최적화하는 방법을 설명합니다.
비고
- 이 문서의 모든 비용 수치는 정가를 표시하며 할인 또는 약정 기반 절감액을 포함하지 않습니다.
- 이 예제 분석을 위해 GB당 비용은 SCU(샘플 비용 단위)로 표현됩니다. 여기서 각 SCU는 일반 비용 단위(예: 1 US 센트)를 나타냅니다.
- 정가 및 계산 방법은 Azure Data Explorer 가격 계산기를 참조하세요.
GB 당 데이터 입력 비용 분석
차트는 원래 크기(Y축)로 중간값 일일 GB 투입량과 각 비용 그룹의 GB당 중간 비용 (X축)을 보여줍니다. 거품 크기는 서비스에 수집된 총 데이터의 그룹 공유를 나타냅니다.
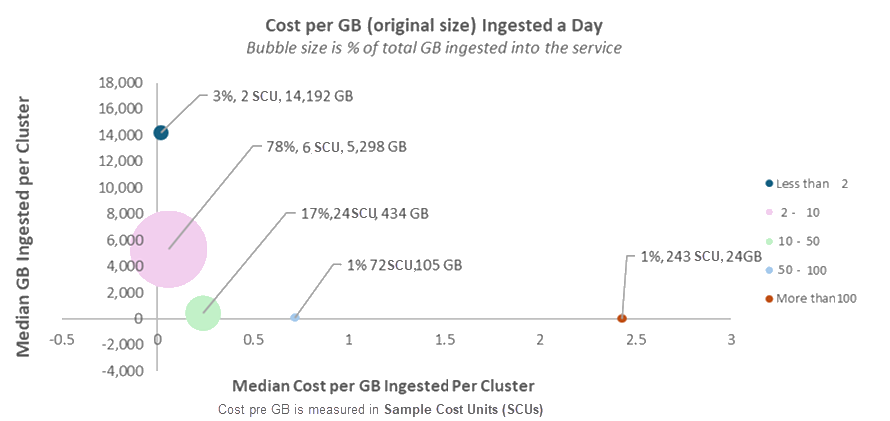
수집된 GB당 비용은 클러스터마다 다르지만 몇 가지 패턴이 눈에 띄습니다.
대부분의 데이터(>%75개) 는 GB 당 2~10개의 SCU (할인 전)의 비용으로 수집됩니다.
5개 미만의 데이터%GB당 2개 미만의 SCU에서 수집됩니다.
동일한 사용 범주(또는 "거품형") 내에서도 상당한 변형이 표시됩니다. 예를 들어 가장 큰 거품에서 한 클러스터는 GB당 2개의 SCU를 수집하는 반면 다른 클러스터는 GB당 10개의 SCU에 도달합니다. 이는 5배 차이입니다. 다음 섹션에서는 이러한 변형의 주요 이유를 설명합니다.
GB당 비용이 높은 클러스터는 일반적이지 않으며 일반적으로 수집 볼륨이 낮습니다. 일반적으로 데이터 볼륨이 작을수록 GB당 비용이 더 높습니다.
중요합니다
거품형 그래프는 수집된 GB당 비용이 클러스터마다 다르다는 것을 보여 줍니다. 이 변형은 좋은 사례나 나쁜 사례를 나타내지 않습니다. 서비스에 대한 다양한 시나리오, 구성 및 사용 패턴을 반영합니다.
예를 들어 한 클러스터는 규정 준수를 위해 데이터를 더 오래 보존하여 스토리지 비용을 증가시킬 수 있습니다. 또 다른 업데이트 정책은 수집 중에 데이터를 처리하여 컴퓨팅 사용량을 발생시키는 업데이트 정책을 사용할 수 있습니다. 이러한 시나리오는 특정 목표에 맞는 의도적인 디자인 선택이며 자연스럽게 GB당 비용에 영향을 줍니다.
GB당 비용을 결정하는 요인
이러한 주요 요소들이 클러스터당 수집되는 GB당 비용 변동의 원인입니다.
스토리지 기간: 데이터를 더 오래 저장할수록 비용이 높아집니다. 보존 정책을 참조하세요.
높은 CPU 사용량: 많은 쿼리, 데이터 처리 또는 변환과 같은 작업으로 인해 높은 CPU 사용량이 발생합니다.
캐시 설정: 더 많은 데이터를 캐싱하면 성능이 향상되지만 비용이 증가할 수 있습니다. 캐시 정책을 참조하세요.
콜드 데이터 사용: 콜드 데이터에 액세스하는 쿼리는 읽기 트랜잭션을 트리거하고 비용에 추가합니다. 핫 및 콜드 캐시를 참조하세요.
데이터 변환 및 최적화: 업데이트 정책, 구체화된 뷰 및 분할과 같은 기능은 CPU 리소스를 사용하고 비용을 증가시킬 수 있습니다. 업데이트 정책, 구체화된 뷰 및 파티션을 참조하세요.
수집 볼륨: 클러스터는 더 높은 수집 볼륨에서 비용 효율적으로 작동합니다.
스트리밍 대 큐 대기 수집: 각각 사용 사례에 따라 다른 비용 프로필이 있습니다. 스트리밍 및 큐 대기를 참조하세요.
스키마 디자인: 열이 많은 넓은 테이블에는 더 많은 컴퓨팅 및 스토리지 리소스가 필요하므로 비용이 발생합니다.
고급 기능: 팔로워, 프라이빗 엔드포인트 및 Python 샌드박스와 같은 옵션은 더 많은 리소스를 사용하고 비용을 추가할 수 있습니다.
데이터 파이프라인 선택: 일부 수집 경로의 비용은 더 낮습니다. 예를 들어 Event Grid 수집은 일반적으로 Event Hubs보다 저렴합니다.
자동 크기 조정: 자동 크기 조정이 없는 클러스터는 수요에 따라 크기를 조정하지 않으므로 비용이 더 많이 드는 경우가 많습니다.
이러한 요소 대부분을 구성하여 성능과 비용을 모두 최적화할 수 있습니다.
주요 비용 동인에 대해 자세히 살펴보기
이 섹션에서는 Azure Data Explorer에서 수집된 GB당 비용에 영향을 주는 주요 요소를 살펴보고 이러한 비용을 관리하고 최적화하는 방법에 대한 인사이트를 제공합니다.
비용에 대한 데이터 보존 영향
ADX에서 수집된 모든 데이터는 영구 스토리지에 저장됩니다. 각 테이블 및 구체화된 뷰에는 데이터가 유지되는 기간을 정의하는 보존 정책이 있습니다. 데이터가 오래 보존될수록 Azure Storage 가격 책정에 따라 비용이 높아집니다. 규정 준수와 같은 장기 스토리지가 필요한 경우 지속적인 스토리지 비용이 포함되므로 수집된 GB당 비용이 증가합니다.
클러스터에서 보고하는 익스텐트 크기 외에도 두 가지 추가 비용 드라이버가 있습니다.
- 보존 버퍼: 실수로 인한 데이터 손실로부터 보호하기 위해 기본적으로 7일의 추가 데이터가 저장됩니다.
- 복구 기능 오버헤드: 복구 가능성 설정 이 사용하도록 설정된 테이블(기본값)의 경우 데이터는 추가로 14일 동안 유지됩니다. 여기에는 병합 및 다시 빌드 작업 중에 생성된 중간 Blob이 포함됩니다.
클러스터 크기
클러스터 크기는 클러스터의 컴퓨터(노드) 수입니다. 각 컴퓨터는 SKU(유형)에 따라 비용을 추가합니다. 자동 크기 조정 은 CPU 사용량에 따라 클러스터 크기를 조정하므로 시스템에서 유휴 또는 중복 리소스를 방지하여 비용 및 성능을 최적화할 수 있습니다.
자동 크기 조정은 캐시된 데이터가 사용 가능한 SSD 공간 내에 맞도록 클러스터 크기를 조정합니다. 결과적으로, 큰 캐시는 클러스터 크기를 증가시킬 수 있으며 CPU 사용량이 낮으면 GB당 비용이 높아질 수 있습니다. 캐시 크기 최적화에 대한 자세한 내용은 캐시 탭Clusters Insight 도구를 참조하세요.
많은 쿼리를 실행하거나 구체화된 뷰, 업데이트 정책 또는 분할과 같은 CPU가 많은 작업을 수행하는 클러스터는 클러스터 크기를 조정하여 GB당 비용을 올릴 수 있습니다. 이러한 기능은 쿼리 성능을 크게 높이고 쿼리 CPU 사용량을 줄여 전반적인 효율성을 향상시킬 수 있습니다.
수집된 데이터 볼륨
클러스터가 증가함에 따라 더 많은 노드가 추가되어 총 비용이 증가합니다. 이 비용은 수집된 모든 데이터에 분산되므로 수집하는 데이터가 많을수록 GB당 비용이 낮아집니다.
콜드 데이터 사용량
쿼리가 디스크에 저장된 콜드 데이터에 자주 액세스하는 경우 더 많은 리소스를 사용하고 전체 클러스터 비용을 증가시킬 수 있는 읽기 트랜잭션이 발생합니다.
스트리밍 및 대기 중인 수집
각 수집 방법에는 비용, 대기 시간 및 기능 특성이 다르므로 각기 다른 시나리오에 더 적합합니다. 비용의 경우, 스트리밍 인제션은 작은 테이블에서 데이터가 흘러들어올 때 더 저렴하고, 대기열 인제션은 큰 테이블에 비용 효율적입니다.
팁 (조언)
데이터 수집 GB당 비용 최적화
주요 비용 동인의 구성을 확인하여 클러스터의 요구 사항 및 효율성에 대한 서비스 요구 사항에 맞는지 확인합니다. 특히 다음 사항에 주의하십시오.
- 콜드 데이터에 대한 쿼리를 최소화하여 읽기 트랜잭션을 줄입니다.
- 클러스터 크기를 수요에 맞게 동적으로 일치하도록 자동 크기 조정을 사용하도록 설정합니다.