특징 표는 두 가지 방식으로 제공할 수 있습니다:
- 모델 서빙: 특징 테이블에서 학습된 모델을 배포합니다. 특징 조회와 모델 추론 모두에 동일한 엔드포인트가 사용됩니다. 엔드포인트는 모델 기록 시 추적된 계보 정보를 사용하여 피처 값을 자동으로 조회하거나 계산합니다. 이를 사용하여 모델 예측을 제공합니다.
-
기능 서빙: 모델 없이 기능 테이블을 직접 참조하는
FeatureSpec를 배포합니다. 엔드포인트는 요청된 기능 출력을 반환합니다. 애플리케이션에 모델 예측이 아닌 기능 값이 필요한 경우 이를 사용합니다. 궁극적으로 모델 추론에 피처를 사용한다면, Databricks는 모델 서빙을 직접 사용하는 것을 권장합니다.
두 방식 모두 사전 계산된 기능과 주문형 기능을 지원합니다.
요구 사항
- Databricks Runtime 14.2 ML 이상
- Python API를 사용하려면 기능 제공에는 Databricks Runtime 14.2 ML에 기본 제공되는
databricks-feature-engineering버전 0.1.2 이상이 필요합니다. 이전 Databricks Runtime ML 버전의 경우%pip install databricks-feature-engineering>=0.1.2을 사용하여 수동으로 필수 버전을 설치해야 합니다. Databricks Notebook을 사용하는 경우 새 셀인dbutils.library.restartPython()명령을 실행하여 Python 커널을 다시 시작해야 합니다. - Databricks SDK를 사용하려면 기능 제공에
databricks-sdk버전 0.18.0 이상이 필요합니다. 필요한 버전을 수동으로 설치하려면%pip install databricks-sdk>=0.18.0를 사용합니다. Databricks Notebook을 사용하는 경우 새 셀인dbutils.library.restartPython()명령을 실행하여 Python 커널을 다시 시작해야 합니다.
Databricks 기능 제공은 엔드포인트 만들기, 업데이트, 쿼리 및 삭제를 위한 UI 및 여러 프로그래밍 옵션을 제공합니다. 이 문서에는 다음 각 옵션에 대한 지침이 포함되어 있습니다.
- Databricks 사용자 인터페이스
- REST API (REST 애플리케이션 프로그래밍 인터페이스)
- Python API
- Databricks SDK
REST API 또는 MLflow 배포 SDK를 사용하려면 Databricks API 토큰이 있어야 합니다.
중요합니다
프로덕션 시나리오에 대한 보안 모범 사례로 Databricks는 프로덕션 중에 인증 을 위해 머신-머신 OAuth 토큰을 사용하는 것이 좋습니다.
테스트 및 개발을 위해 Databricks는 작업 영역 사용자 대신 서비스 주체 에 속하는 개인용 액세스 토큰을 사용하는 것이 좋습니다. 서비스 주체에 대한 토큰을 만들려면 서비스 주체에 대한 토큰 관리를 참조하세요.
기능 제공에 대한 인증
인증에 대한 자세한 내용은 Azure Databricks 리소스에 대한 액세스 권한 부여 참조하세요.
생성 FeatureSpec
FeatureSpec는 사용자 정의 기능 및 함수 집합입니다.
FeatureSpec에서 기능과 함수를 결합할 수 있습니다.
FeatureSpecs는 Unity 카탈로그에 저장되고 관리되며 카탈로그 탐색기에 표시됩니다.
에 FeatureSpec 지정된 테이블은 온라인 기능 저장소 또는 타사 온라인 스토어에 게시해야 합니다.
Databricks Online 기능 저장소를 참조하세요.
databricks-feature-engineering 패키지를 사용하여 FeatureSpec를 만들어야 합니다.
먼저 함수를 정의합니다.
from unitycatalog.ai.core.databricks import DatabricksFunctionClient

client = DatabricksFunctionClient()

CATALOG = "main"
SCHEMA = "default"

def difference(num_1: float, num_2: float) -> float:
  """
  A function that accepts two floating point numbers, subtracts the second one
  from the first, and returns the result as a float.

  Args:
      num_1 (float): The first number.
      num_2 (float): The second number.

  Returns:
      float: The resulting difference of the two input numbers.
  """
  return num_1 - num_2

client.create_python_function(
  func=difference,
  catalog=CATALOG,
  schema=SCHEMA,
  replace=True
)
그런 다음 FeatureSpec에서 이 함수를 사용할 수 있습니다.
from databricks.feature_engineering import (
  FeatureFunction,
  FeatureLookup,
  FeatureEngineeringClient,
)

fe = FeatureEngineeringClient()

features = [
  # Lookup column `average_yearly_spend` and `country` from a table in UC by the input `user_id`.
  FeatureLookup(
    table_name="main.default.customer_profile",
    lookup_key="user_id",
    feature_names=["average_yearly_spend", "country"]
  ),
  # Calculate a new feature called `spending_gap` - the difference between `ytd_spend` and `average_yearly_spend`.
  FeatureFunction(
    udf_name="main.default.difference",
    output_name="spending_gap",
    # Bind the function parameter with input from other features or from request.
    # The function calculates num_1 - num_2.
    input_bindings={"num_1": "ytd_spend", "num_2": "average_yearly_spend"},
  ),
]

# Create a `FeatureSpec` with the features defined above.
# The `FeatureSpec` can be accessed in Unity Catalog as a function.
fe.create_feature_spec(
  name="main.default.customer_features",
  features=features,
)
기본값 지정
기능에 대한 기본값을 지정하려면 . default_values 에서 매개 변수를 FeatureLookup사용합니다. 다음 예제를 참조하세요.
feature_lookups = [
    FeatureLookup(
        table_name="ml.recommender_system.customer_features",
        feature_names=[
            "membership_tier",
            "age",
            "page_views_count_30days",
        ],
        lookup_key="customer_id",
        default_values={
          "age": 18,
          "membership_tier": "bronze"
        },
    ),
]
매개 변수 rename_outputs 를 사용하여 기능 열의 default_values 이름을 바꾸는 경우 이름이 바뀐 기능 이름을 사용해야 합니다.
FeatureLookup(
  table_name = 'main.default.table',
  feature_names = ['materialized_feature_value'],
  lookup_key = 'id',
  rename_outputs={"materialized_feature_value": "feature_value"},
  default_values={
    "feature_value": 0
  }
)
Python 의존성 추가
사용자 정의 함수(UDF)가 Python 패키지를 가져오는 경우 FeatureSpec를 만들 때 해당 패키지를 선언하세요. 이 매개변수 databricks-feature-engineering 는 extra_pip_requirements 0.17.0 이상이어야 합니다. Feature Serving은 MLflow와 databricks-feature-lookup 패키지를 자동으로 설치합니다.
예를 들어, 기능 사양의 UDF가 NumPy를 가져오면, 다음 요구사항을 추가하세요:
fe.create_feature_spec(
    name="main.default.customer_features_with_dependencies",
    features=features,
    extra_pip_requirements=["numpy==1.26.4"],
)
엔드포인트를 만들 때 명세명으로 사용 main.default.customer_features_with_dependencies 하세요.
각 extra_pip_requirements 항목은 PyPI 요구사항 문자열이어야 하며, 예: numpy==1.26.4, 또는 Unity 카탈로그 볼륨 내 파일로 가는 .whl 경로여야 합니다. 예를 들어, 업로드한 휠을 사용 /Volumes/main/libraries/wheels/custom_features-1.0.0-py3-none-any.whl 해 보세요. 엔드포인트 생성자는 볼륨에 대해 USE CATALOG, 그리고 상위 카탈로그 및 스키마에 대해 USE SCHEMA 및 READ VOLUME 권한이 있어야 합니다.
개인 저장소에서 패키지를 받으려면 작업 공간 기본 패키지 저장소를 설정하세요.
--index-url와 같은 pip 명령 옵션을 extra_pip_requirements에 넣지 마세요.
Unity Catalog UDF의 ENVIRONMENT 종속성 절은 오프라인 SQL 실행에 적용됩니다. Feature Serving은 그것들을 자동으로 복사하지 않습니다. 업스트림 기능의 UDF를 포함해, UDF에 필요한 모든 패키지를 기능 사양의 요구사항에 선언하세요.
엔드포인트 배포가 실패하면, 빌드 로그에서 패키지 설치 오류, 버전 충돌, 또는 휠 접근 실패를 확인하세요. 모델 품질 및 엔드포인트 상태 모니터링을 참조하세요.
CustomUDF 및 가 포함된 예시는 FeatureViewSource를 참조하세요. 모델 서빙 의존성에 대해서는 Custom UDF 의존성을 참조하세요.
엔드포인트 만들기
FeatureSpec은 엔드포인트를 정의합니다. 자세한 내용은 엔드포인트를 제공하는 사용자 지정 모델 만들기Python API 설명서 또는 Databricks SDK 설명서를 참조하세요.
참고 사항
대기 시간이 중요하거나 초당 높은 쿼리가 필요한 워크로드의 경우 Model Serving는 엔드포인트를 제공하는 사용자 지정 모델에 대한 경로 최적화를 제공합니다. 엔드포인트 제공에 대한 경로 최적화를 참조하세요.
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

workspace = WorkspaceClient()

# Create endpoint
workspace.serving_endpoints.create(
  name="my-serving-endpoint",
  config = EndpointCoreConfigInput(
    served_entities=[
    ServedEntityInput(
        entity_name="main.default.customer_features",
        scale_to_zero_enabled=True,
        workload_size="Small"
      )
    ]
  )
)
Python API
from databricks.feature_engineering.entities.feature_serving_endpoint import (
  ServedEntity,
  EndpointCoreConfig,
)

fe.create_feature_serving_endpoint(
  name="customer-features",
    config=EndpointCoreConfig(
    served_entities=ServedEntity(
      feature_spec_name="main.default.customer_features",
             workload_size="Small",
             scale_to_zero_enabled=True,
             instance_profile_arn=None,
    )
  )
)
REST API (REST 애플리케이션 프로그래밍 인터페이스)
curl -X POST -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints \
    -H 'Content-Type: application/json' \
    -d '"name": "customer-features",
   "config": {
       "served_entities": [
           {
               "entity_name": "main.default.customer_features",
               "workload_size": "Small",
               "scale_to_zero_enabled": true
           }
       ]
   }'
엔드포인트를 보려면 Databricks UI의 왼쪽 사이드바에서 서비스(Serving )를 클릭합니다. 상태가 준비 상태이면 엔드포인트가 쿼리에 응답할 준비가 된 것입니다. 모델 제공에 대한 자세한 내용은 모델 서비스를 참조하세요.
유추 테이블에 보강된 DataFrame 저장
2025년 2월부터 만든 엔드포인트의 경우 조회된 기능 값과 함수 반환 값이 포함된 보강된 DataFrame을 기록하도록 엔드포인트를 제공하는 모델을 구성할 수 있습니다. DataFrame은 제공된 모델의 유추 테이블에 저장됩니다.
이 구성 설정에 대한 지침은 테이블 유추에 대한 로그 기능 조회 데이터 프레임을 참조하세요.
추론 테이블에 대한 정보는 엔드포인트 서빙을 위한 로그 요청 및 응답(레거시)을 참조하세요.
엔드포인트 가져오기
Databricks SDK 또는 Python API를 사용하여 엔드포인트의 메타데이터 및 상태를 가져올 수 있습니다.
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

endpoint = workspace.serving_endpoints.get(name="customer-features")
# print(endpoint)
Python API
endpoint = fe.get_feature_serving_endpoint(name="customer-features")
# print(endpoint)
엔드포인트의 스키마 가져오기
Databricks SDK 또는 REST API를 사용하여 엔드포인트의 스키마를 가져올 수 있습니다. 엔드포인트 스키마에 대한 자세한 내용은 엔드포인트 스키마를 제공하는 모델 가져오기를 참조하세요.
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

# Create endpoint
endpoint = workspace.serving_endpoints.get_open_api(name="customer-features")
REST API (REST 애플리케이션 프로그래밍 인터페이스)
ACCESS_TOKEN=<token>
ENDPOINT_NAME=<endpoint name>

curl "https://example.databricks.com/api/2.0/serving-endpoints/$ENDPOINT_NAME/openapi" -H "Authorization: Bearer $ACCESS_TOKEN" -H "Content-Type: application/json"
엔드포인트 쿼리
REST API, MLflow 배포 SDK 또는 서비스 UI를 사용하여 엔드포인트를 쿼리할 수 있습니다.
다음 코드에서는 MLflow 배포 SDK를 사용할 때 자격 증명을 설정하고 클라이언트를 만드는 방법을 보여줍니다.
  # Set up credentials
  export DATABRICKS_HOST=...
  export DATABRICKS_TOKEN=...
  # Set up the client
  import mlflow.deployments

  client = mlflow.deployments.get_deploy_client("databricks")
참고 사항
보안 모범 사례로, 자동화된 도구, 시스템, 스크립트 및 앱을 사용하여 인증하는 경우 Databricks는 작업 영역 사용자 대신 서비스 주체 에 속한 개인용 액세스 토큰을 사용하는 것이 좋습니다. 서비스 주체에 대한 토큰을 만들려면 서비스 주체에 대한 토큰 관리를 참조하세요.
API를 사용하여 엔드포인트 쿼리
이 섹션에는 REST API 또는 MLflow 배포 SDK를 사용하여 엔드포인트를 쿼리하는 예제가 포함되어 있습니다.
MLflow 배포 기능 SDK
중요합니다
다음 예제에서는 predict()의 API를 사용합니다. 이 API는 실험적이며 API 정의가 변경될 수 있습니다.
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
response = client.predict(
    endpoint="test-feature-endpoint",
    inputs={
        "dataframe_records": [
            {"user_id": 1, "ytd_spend": 598},
            {"user_id": 2, "ytd_spend": 280},
        ]
    },
)
REST API (REST 애플리케이션 프로그래밍 인터페이스)
curl -X POST -u token:$DATABRICKS_API_TOKEN $ENDPOINT_INVOCATION_URL \
  -H 'Content-Type: application/json' \
  -d '{"dataframe_records": [
          {"user_id": 1, "ytd_spend": 598},
          {"user_id": 2, "ytd_spend": 280}
      ]}'
UI를 사용하여 엔드포인트 쿼리
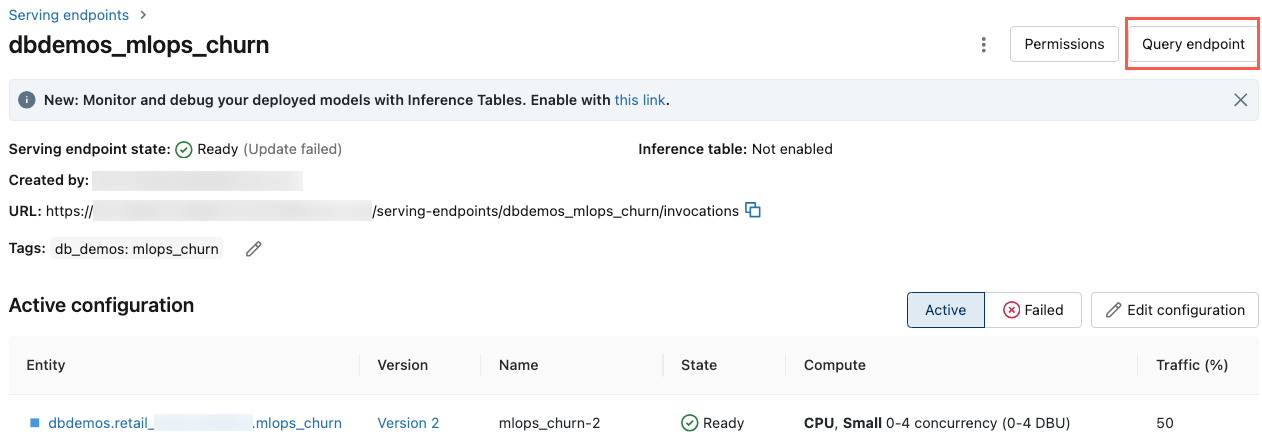
서비스 UI에서 직접 서비스 엔드포인트를 쿼리할 수 있습니다. UI에는 엔드포인트를 쿼리하는 데 사용할 수 있는 생성된 코드 예제가 포함되어 있습니다.
Azure Databricks 작업 영역의 왼쪽 사이드바에서 Serving 클릭합니다.
쿼리할 엔드포인트를 클릭합니다.
화면의 오른쪽 위에서 쿼리 엔드포인트를 클릭합니다.
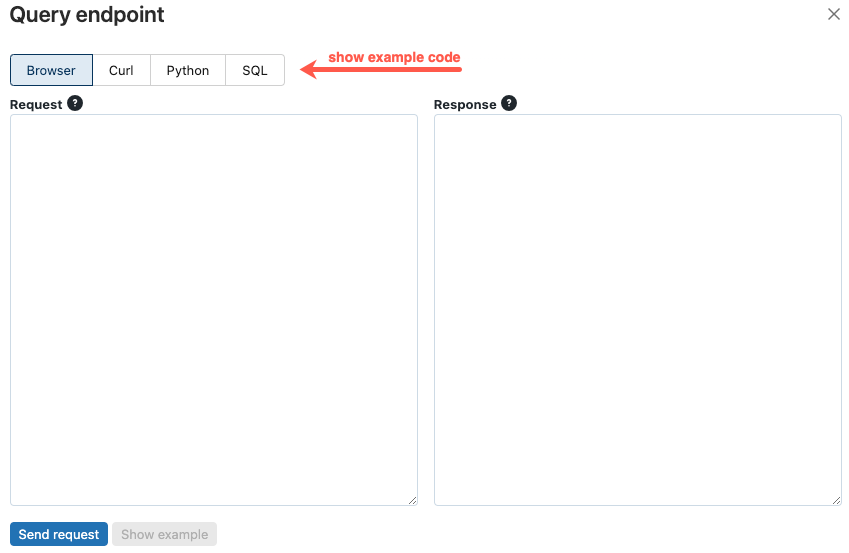
요청 상자에 요청 본문을 JSON 형식으로 입력합니다.
요청 보내기를 클릭합니다.
// Example of a request body.
{
  "dataframe_records": [
    { "user_id": 1, "ytd_spend": 598 },
    { "user_id": 2, "ytd_spend": 280 }
  ]
}
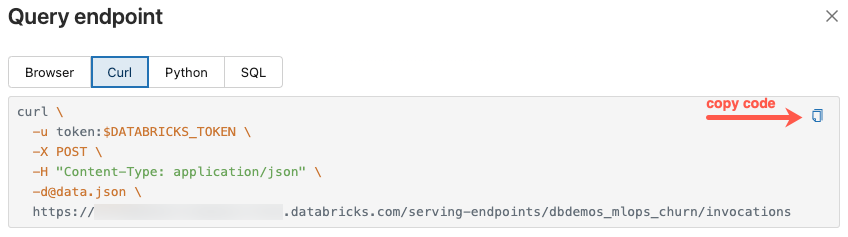
쿼리 엔드포인트 대화 상자에는 curl, Python 및 SQL에서 생성된 예제 코드가 포함됩니다. 탭을 클릭하여 예제 코드를 보고 복사합니다.
코드를 복사하려면 텍스트 상자의 오른쪽 상단에 있는 복사 아이콘을 클릭하세요.
엔드포인트 업데이트
중요합니다
기능 서비스 엔드포인트의 구성(예: 워크로드 크기 변경 FeatureSpec )을 수정하려면 항상 이 섹션에 설명된 업데이트 API를 사용합니다. 변경 내용을 적용하려면 엔드포인트를 삭제하고 다시 만들지 마세요. 라이브 엔드포인트를 삭제하면 즉시 가동 중지가 발생하고 쿼리하는 모든 애플리케이션이 중단됩니다.
REST API, Databricks SDK 또는 서비스 UI를 사용하여 엔드포인트를 업데이트할 수 있습니다.
API를 사용하여 엔드포인트 업데이트
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.update_config(
  name="my-serving-endpoint",
  served_entities=[
    ServedEntityInput(
      entity_name="main.default.customer_features",
      scale_to_zero_enabled=True,
      workload_size="Small"
    )
  ]
)
REST API (REST 애플리케이션 프로그래밍 인터페이스)
curl -X PUT -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>/config \
  -H 'Content-Type: application/json' \
  -d '"served_entities": [
        {
            "name": "customer-features",
            "entity_name": "main.default.customer_features_new",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ]'
UI를 사용하여 엔드포인트 업데이트
서비스 제공 UI를 사용하려면 다음 단계를 따르세요.
- Azure Databricks 작업 영역의 왼쪽 사이드바에서 Serving 클릭합니다.
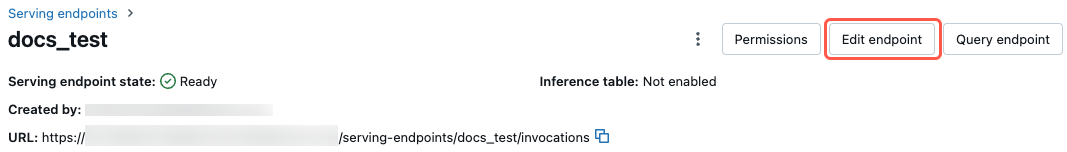
- 테이블에서 업데이트하려는 엔드포인트의 이름을 클릭합니다. 엔드포인트 화면이 나타납니다.
- 화면의 오른쪽 위에서 엔드포인트 편집을 클릭합니다.
- 서비스 엔드포인트 편집 대화 상자에서 필요에 따라 엔드포인트 설정을 편집합니다.
- 업데이트를 클릭하여 변경 내용을 저장합니다.
실시간 기능 서빙 엔드포인트의 의존성을 업데이트합니다
Feature Serving 엔드포인트는 처음 빌드되고 배포될 때 종속 항목을 확인합니다. 즉, 서비스 주체가 온라인 테이블(USE CATALOG, USE SCHEMA, and SELECT)을 읽는 데 필요한 권한과 FeatureSpec에 설명된 Unity Catalog UDF에 대한 EXECUTE 권한을 확인합니다. 엔드포인트는 빌드 시 이 권한을 고정하며, 단순한 재배포나 재시작으로 재해결하지 않습니다. 온라인 테이블이나 UDF를 다시 만들면 엔드포인트가 해당 온라인 테이블 또는 UDF에 대한 권한을 잃게 됩니다. UDF를 제자리에서 업데이트하면 엔드포인트는 원래 버전을 계속 실행합니다. 기능 조회가 실패하거나, 엔드포인트가 계속 Ready를 보고하는 동안에도 조용히 옛 UDF 로직을 사용할 수 있습니다.
온라인 테이블과 주문형 UDF 모두에 대해 Databricks는 버전별 마이그레이션을 권장합니다: 의존성의 새 버전을 만들고, 이에 대한 새 엔드포인트를 만든 다음, 트래픽을 새 엔드포인트로 마이그레이션하는 것입니다. 이렇게 하면 다운타임과 이 섹션에서 설명하는 고장 모드를 피할 수 있습니다.
온라인 표를 재현하세요
경고
라이브 기능 제공 엔드포인트 아래에 있는 온라인 테이블을 삭제하고 다시 만들지 마세요.
엔드포인트를 생성할 때 모델 서빙은 엔드포인트의 서비스 주체에 온라인 테이블의 카탈로그에서 USE SCHEMA, 해당 스키마에서 SELECT, 그리고 온라인 테이블에서 USE CATALOG를 부여합니다. 같은 이름이라도 테이블을 삭제하고 다시 만들면 Unity Catalog에 새로운 보안 개체가 생성되므로 SELECT 권한 부여가 그대로 유지되지 않습니다. 서비스 주체는 테이블 접근 권한을 잃고, OAuth 토큰 민팅이 실패하며, 온라인 스토어와의 연결이 비밀번호 인증으로 되돌아가 실패합니다. 특징 조회는 password authentication failed 또는 KeyError: 'OAUTH_TOKEN'와 같은 오류로 실패합니다.
이러한 실패는 쉽게 놓치기 쉽습니다: 엔드포인트는 여전히 Ready 를 보고하고, 동기화 파이프라인은 여전히 성공적인 실행을 보여주지만, 조회는 실패합니다. 온라인 테이블의 동기화 모드(예: CONTINUOUS와 SNAPSHOT 사이)를 변경하는 것은 제자리에서 할 수 없으며, 테이블을 다시 만들어야 하므로 이 문제를 일으킬 수도 있습니다.
엔드포인트는 특정 온라인 테이블을 읽지 않습니다.
FeatureSpec에 명명된 오프라인 피처 테이블을 통해 피처를 조회하며, 피처 테이블이 둘 이상의 온라인 테이블에 게시되면 엔드포인트는 가장 오래된 테이블을 사용합니다. 동일한 기능 테이블을 두 번째 온라인 테이블에 게시해도 엔드포인트가 새 온라인 테이블로 이동하지 않습니다.
온라인 기능 스토어 제한 사항을 참조하세요.
다운타임을 최소화하려면 오프라인 기능 테이블과 온라인 테이블을 모두 버전 관리하세요:
- 새로운 오프라인 피처 테이블을 만들고 이름에 버전을 포함하세요(예:
customer_features_v2). - 새로운 기능 테이블을 새 온라인 테이블로 게시하세요. 기능 표 게시를 참조하세요.
- 새로운 기능 테이블을 사용하는 새
FeatureSpec를 만들고, 이를 지원하는 새로운 기능 서비스 엔드포인트를 만드세요. - 트래픽을 새 엔드포인트로 이전하세요. 이전 엔드포인트가 더 이상 트래픽을 받지 못하면 해당 엔드포인트와 온라인 테이블을 삭제하세요.
주문형 UDF 업데이트
경고
FeatureSpec에서 사용하는 Unity Catalog UDF를 직접 수정하지 마세요.
AFeatureSpec의 온디맨드 UDF는 배포 시 서비스 엔드포인트에 내장되어 있습니다. 일반 새로고침이나 재배포는 해당 서빙 이미지에서 동일한 UDF를 재사용합니다. 동일한 이름으로 UDF에 대한 제자리 업데이트는 적용되지 않습니다. UDF를 삭제하고 다시 만들면 엔드포인트도 EXECUTE을 잃어버려서 UDF를 사용하는 조회가 실패합니다.
FeatureSpecs와 UDF는 버전 필드가 없으므로, 이름으로 버전을 관리합니다: 새 UDF와 새 FeatureSpec를 생성하고, 새 FeatureSpec를 사용하는 새로운 엔드포인트를 만들고, 트래픽을 그쪽으로 마이그레이션합니다.
FeatureSpec 만들기를 참조하세요.
주문형 특성 계산을 참조하세요.
인플레이스 변경 후 엔드포인트 복구하기
이미 의존성을 직접 변경했다면, 엔드포인트를 다시 구축해서 의존성을 다시 해결하세요. 새로운 FeatureSpec를 생성하고(또는 모델 서빙 엔드포인트의 경우 새 모델 버전을 등록하고), 이를 제공하도록 엔드포인트를 업데이트합니다. 엔드포인트가 제공하는 서비스를 변경하면 엔드포인트가 재구성되어 새로운 서비스 주체를 프로비저닝하고 권한 설정을 다시 실행합니다. 이 중 어느 것도 엔드포인트를 안정적으로 재구축하지 않습니다: 중지 및 재시작, 단순한 재배포, 환경 변수 변경이 그렇습니다.
엔드포인트 삭제
경고
이 작업은 되돌릴 수 없습니다. 기능 서비스 엔드포인트를 삭제하면 쿼리하는 모든 애플리케이션에 즉시 가동 중지 시간이 발생합니다. 엔드포인트의 구성을 변경하려면 엔드포인트를 삭제하고 다시 만드는 대신 엔드포인트 업데이트를 사용합니다.
REST API, Databricks SDK, Python API 또는 서비스 UI를 사용하여 엔드포인트를 삭제할 수 있습니다.
API를 사용하여 엔드포인트 삭제
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.delete(name="customer-features")
Python API
fe.delete_feature_serving_endpoint(name="customer-features")
REST API (REST 애플리케이션 프로그래밍 인터페이스)
curl -X DELETE -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>
UI를 사용하여 엔드포인트 삭제
다음 단계에 따라 서비스 UI를 사용하여 엔드포인트를 삭제합니다.
- Azure Databricks 작업 영역의 왼쪽 사이드바에서 Serving 클릭합니다.
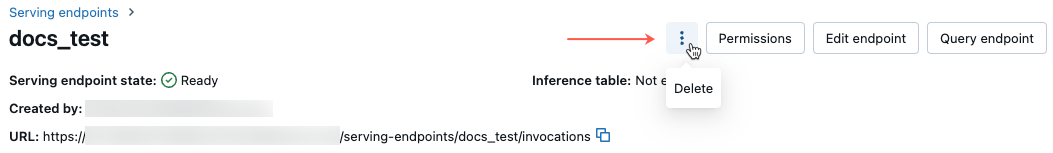
- 테이블에서 삭제할 엔드포인트의 이름을 클릭합니다. 엔드포인트 화면이 나타납니다.
- 화면 오른쪽 위에서 케밥 메뉴
 을 클릭하고 삭제를 선택합니다.
엔드포인트의 상태 모니터링
기능 제공 엔드포인트에 사용할 수 있는 로그 및 메트릭에 대한 자세한 내용은 모델 품질 및 엔드포인트 상태 모니터링을 참조하세요.
접근 제어
기능 서비스 엔드포인트에 대한 사용 권한에 대한 자세한 내용은 엔드포인트를 제공하는 모델에 대한 권한 관리를 참조하세요.
예제 노트북
이 Notebook에서는 Databricks SDK를 사용하여 Databricks Online 기능 저장소를 사용하여 기능 제공 엔드포인트를 만드는 방법을 보여 줍니다.