Important
이 기능은 베타 버전으로 제공됩니다. 이를 사용하려면 워크스페이스 관리자가 Previews 페이지에서 Efficient Column Updates를 켜야 합니다. Azure Databricks 미리 보기 관리를 참조하세요.
효율적인 열 업데이트(ECU)는 변경되지 않은 열을 다시 쓰지 않고도 Delta Lake 테이블의 열을 추가하거나 채울 수 있게 해줍니다. 기존 데이터셋에 새로운 특징, 임베딩 및 기타 파생 값을 채우는 데 사용하세요.
열을 추가하면 기존 데이터를 다시 쓰지 않고 테이블 스키마가 변경됩니다. 해당 열에 값을 채우려면 영향을 받는 행이 포함된 데이터 파일(변경되지 않은 열도 포함)을 다시 작성해야 할 수 있습니다. 효율적인 열 업데이트는 업데이트된 열 값을 별도의 Parquet 파일에 기록함으로써 변경되지 않은 열을 포함한 재작성을 방지합니다.
이는 큰 페이로드나 임베딩이 포함된 테이블에 소수의 열을 추가할 때 특히 유용합니다. 쿼리는 기존 데이터와 업데이트된 열 값을 결합한 하나의 논리 테이블을 계속 반환합니다.
다음 다이어그램은 열을 추가하고 다시 채우는 과정을 비교합니다. 회색 블록은 기존 열 데이터를 나타내며, 초록색 블록은 새 열 데이터를 나타내며, 빨간색 윤곽선은 다시 작성된 데이터를 나타냅니다.
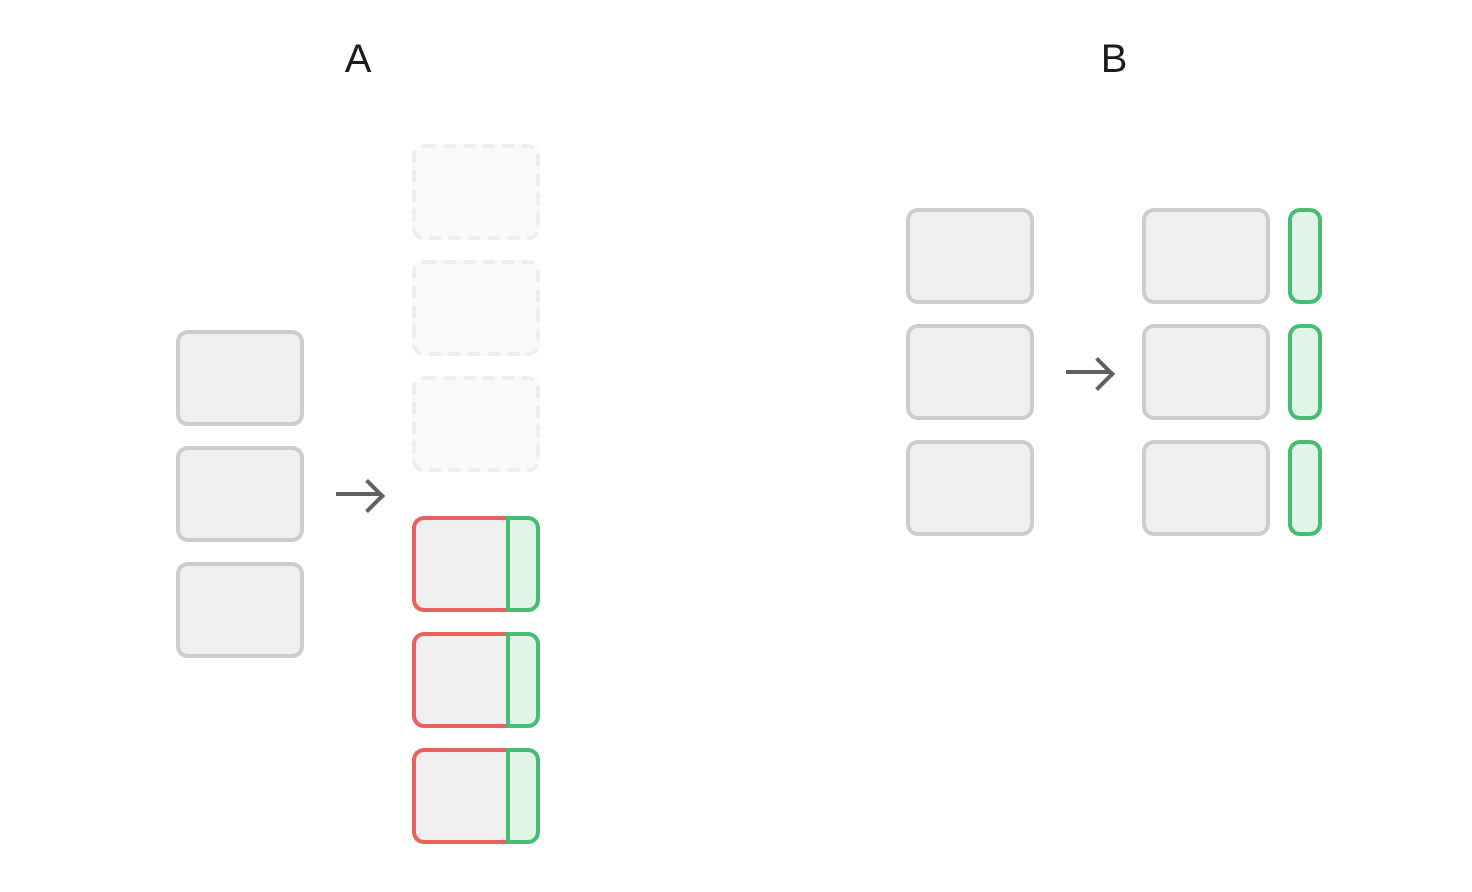
- A: ECU가 없으면, 백필은 원래 데이터 파일(점선 선)을 변경되지 않은 열과 새 열을 모두 포함하는 파일로 대체합니다.
- B: ECU에서는 원래 파일을 유지하고 새 열 값은 별도의 파일에 기록됩니다.
Requirements
- 효율적인 열 업데이트가 활성화된 테이블을 읽거나 쓰려면 Databricks Runtime 19 이상을 사용하십시오.
- 카탈로그 커밋이 활성화된 Unity Catalog 관리 Delta Lake 테이블을 사용하세요.
- 테이블에서 행 추적및 삭제 벡터 를 활성화합니다.
-
id을 모드('delta.columnMapping.mode' = 'id')에서 사용하십시오. 이 모드는 테이블을 생성할 때 설정해야 합니다. - 작업 공간 미리보기 페이지에서 베타를 활성화하세요.
효율적인 열 업데이트 활성화
테이블을 생성하거나 요구 사항을 충족하는 기존 테이블에서 효율적인 열 업데이트를 활성화할 수 있습니다. 활성화하기 전에 제한 사항을 검토하세요.
효율적인 열 업데이트가 활성화된 테이블을 만들려면 delta.enableColumnUpdates-preview 테이블 속성과 필요한 기능의 속성을 함께 설정하세요:
CREATE TABLE documents (
  document_id BIGINT,
  description STRING
)
TBLPROPERTIES (
  'delta.feature.catalogManaged' = 'supported',
  'delta.enableRowTracking' = 'true',
  'delta.enableDeletionVectors' = 'true',
  'delta.columnMapping.mode' = 'id',
  'delta.enableColumnUpdates-preview' = 'true'
);
이미 모드에서 id 열 매핑을 사용하는 기존 테이블의 경우, 카탈로그 커밋, 행 추적, 삭제 벡터가 아직 활성화되어 있지 않은 경우 활성화하세요:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.feature.catalogManaged' = 'supported',
  'delta.enableRowTracking' = 'true',
  'delta.enableDeletionVectors' = 'true'
);
그런 다음 효율적인 열 업데이트를 활성화하세요:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.enableColumnUpdates-preview' = 'true'
);
문제가 발생하면 표준 업데이트로 롤백할 수 있습니다.
열 추가 및 기존 데이터 채우기
다음 예제는 document_id 열과 documents 문자열 열이 있는 기존 description 테이블을 사용합니다. 각 설명의 길이를 담은 열을 추가합니다:
ALTER TABLE documents ADD COLUMN text_length INT;

UPDATE documents
SET text_length = LENGTH(description);
열을 추가한 후 기존 행에는 text_length에 UPDATE가 포함되며, NULL가 해당 값을 채울 때까지 유지됩니다. 효율적인 열 업데이트는 백필이 변경되지 않은 열을 다시 쓰지 않고 새 열 값을 기록할 수 있게 합니다.
채워진 값을 확인하기 위해 테이블을 쿼리합니다:
SELECT document_id, description, text_length
FROM documents
LIMIT 10;
효율적인 열 업데이트는 백필 시 재작성되는 데이터를 줄여줍니다. 업데이트는 여전히 입력 열을 읽고 새 값을 계산합니다.
효율적인 열 업데이트를 활성화한다고 해서 모든 UPDATE가 이를 사용한다는 보장은 없습니다. 경우에 따라 Azure Databricks는 영향을 받는 데이터 파일을 다시 작성하는 표준 업데이트를 대신 사용합니다. 업데이트는 여전히 성공하여 동일한 결과를 보여줍니다.
표준 업데이트로 롤백하기
효율적인 열 업데이트에 문제가 발생하면 새 열 업데이트를 비활성화하고 기존 열 파일을 통합하세요:
새 열 파일 작성 중지:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.enableColumnUpdates-preview' = 'false'
);
REORG TABLE을 사용해 열 파일이 있는 데이터 파일을 다시 씁니다:
REORG TABLE documents APPLY (PURGE);
REORG 최신 열 값을 다시 작성한 데이터 파일에 기록하여 열 파일 없이 새 테이블 버전을 생성합니다. 업데이트된 값은 보존됩니다. 이전 테이블 버전도 여전히 열 파일을 참조할 수 있습니다.
테이블 기능은 테이블 프로토콜에서 계속 활성화되어 있으므로, 읽기 및 쓰기 작업에는 여전히 Databricks Runtime 버전 19 이상이 필요합니다.
Limitations
- 효율적인 열 업데이트는 쓰기 시간 변경 데이터 피드(CDF)와 호환되지 않습니다. 레거시 변경 데이터 피드를 참조하세요.
- 효율적인 열 업데이트는 Universal Format(UniForm)과 호환되지 않습니다.
- Apache Iceberg 관리 테이블은 지원되지 않습니다.
-
MERGE작업에서는 효율적인 열 업데이트를 사용하지 않습니다. -
DROP FEATURE로 효율적인 열 업데이트를 제거하는 것은 지원되지 않습니다. Databricks는 중요 테이블에서는 이를 활성화하지 않는 것을 권장합니다. 열 업데이트 사용을 중지하려면 표준 업데이트로 롤백을 참조하세요. - 레이크플로우 파이프라인은 지원되지 않습니다.