Important
이 문서에서 미리 보기로 표시된 항목은 현재 미리 보기로 제공됩니다. 이 미리 보기는 서비스 수준 계약 없이 제공되며 Microsoft 프로덕션 워크로드에 권장하지 않습니다. 특정 기능이 지원되지 않거나 기능이 제한될 수 있습니다. 자세한 내용은 Microsoft Azure Preview에 대한 추가 사용 약관을 참조하세요.
Important
대화형 학습에는 명시적 액세스 승인이 필요합니다. 미리 보기 등록 양식을 통해 액세스를 요청하고 교육 세션을 만들기 전에 승인을 기다립니다.
대화형 학습(미리 보기)은 Microsoft Foundry에서 개방형 가중치 모델에 대한 자체 학습 후 루프를 구축하기 위한 API입니다. Python에서 실험을 제어합니다. Foundry는 서버리스 GPU에서 모델 샘플링 및 LoRA(하위 순위 적응) 업데이트를 실행합니다.
RL(강화 학습)의 경우 코드는 롤아웃 컬렉션, 보상, 이점 및 업데이트 예약을 제어합니다. 동일한 기본 요소들이 지도 학습, 선호도 학습, 증류 및 사용자 지정 손실 워크플로를 지원합니다.
사용 시기
훈련 루프 자체가 연구의 일부인 경우 대화형 훈련을 사용합니다.
- 사용자 지정 학습 신호가 필요합니다. 시연 예시를 제공하거나, 보상 및 어드밴티지를 계산하거나, 선호 학습 또는 기타 목표를 위한 로컬 loss를 구성합니다.
- 모델은 환경과 상호 작용합니다. 드라이버에서 모델 응답, 도구 호출, 관찰 및 보상을 조정합니다.
- 개별 업데이트를 제어해야 합니다. 일괄 처리, 토큰 마스크, 손실 설정 및 최적화 프로그램 매개 변수를 선택합니다. 그래디언트를 누적하고 업데이트를 적용할 시기를 결정합니다.
- 실험을 검사하고 조정하려고 합니다. 현재 어댑터의 샘플을 확인하고, 홀드아웃 프롬프트를 평가하고, 관찰된 결과에 따라 다음 프롬프트를 선택합니다.
- 진행 상황을 유지하고 계속 진행해야 합니다. 어댑터 및 최적화 프로그램 상태를 저장한 다음 호환되는 세션에서 다시 시작합니다. 드라이버에서 데이터 세트 위치 및 기타 실험 상태를 유지합니다.
관리되는 미세 조정은 강화 미세 조정을 위한 채점자도 지원합니다. 그레이더나 작업 설정뿐만 아니라 전체 루프를 제어해야 할 때는 대화형 학습을 선택하세요. 학습 방식을 선택하는 방법을 참조하세요.
누가 무엇을 합니까
사용자의 Python 프로그램이 학습용 드라이버입니다. 입력을 준비하고 실험을 조정합니다. Foundry는 모델 및 어댑터 상태를 유지하고 요청된 작업을 실행합니다.
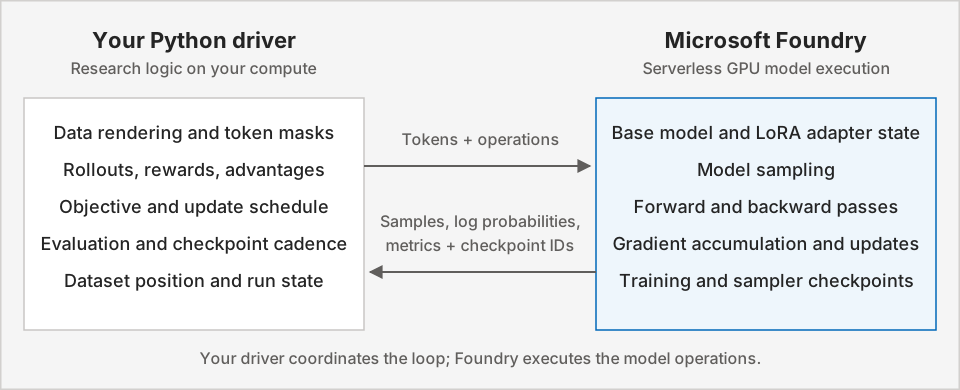
드라이버는 사용자의 컴퓨터 또는 컴퓨팅 환경을 포함한 모든 CPU에서 실행할 수 있습니다. 추가하는 보상 모델 또는 환경에는 자체 컴퓨팅 요구 사항이 있을 수 있습니다. 루프를 관리하는 동안 드라이버를 계속 실행합니다.
핵심 개념 및 프리미티브
세션은 상태를 유지합니다. 그래디언트 계산, 옵티마이저 업데이트 및 샘플링은 선택된 모델과 어댑터에 대해 별도로 수행되는 작업입니다. 이 분리를 통해 데이터를 수집하고, 그래디언트를 누적하고, 업데이트하고, 평가할 시기를 선택할 수 있습니다.
| 구성 요소 | 용도 |
|---|---|
| 학습 세션 및 LoRA 어댑터 |
FineTuningSession.create 어댑터 구성을 사용하여 지원되는 기본 모델을 초기화합니다. 세션은 후속 작업에서 사용하는 상태를 보유합니다. |
| 토큰화된 일괄 처리 및 마스크 |
Datum는 모델 입력 및 손실 입력을 포함합니다. 마스크는 프롬프트나 도구 관찰보다는 보조 토큰과 같이 학습에 기여하는 토큰을 선택합니다. |
| 샘플링 |
sample 는 선택한 샘플러 체크포인트를 사용해 응답을 생성합니다. RL 입력은 샘플링된 토큰과 해당 롤아웃 로그 확률 및 보상 기반 어드밴티지를 짝지습니다. |
| 순방향 및 역방향 패스 |
forward 는 그래디언트를 누적하지 않고 예제별 손실 함수 출력을 반환합니다.
forward_backward 선택한 목표를 계산하고 기울기를 누적합니다. 옵티마이저 업데이트가 적용되지 않습니다. |
| 최적화 프로그램 업데이트 |
optim_step 는 Adam 매개 변수를 사용하여 누적 그라데이션을 적용합니다. 업데이트 시기와 사용할 학습 속도를 선택합니다. |
| 샘플러 체크포인트 |
save_weights_for_sampler 는 생성을 위해 어댑터 가중치를 준비합니다. 업데이트된 어댑터에서 샘플링하기 전에 업데이트 후 이러한 가중치를 새로 고치세요. |
| 학습 체크포인트 |
save_weights 는 어댑터 가중치 및 최적화 프로그램 상태를 유지합니다.
FineTuningSession.create_from_checkpoint 호환되는 세션에서 학습을 다시 시작합니다. |
SDK에는 지도 학습 업데이트 및 강화 학습 손실 함수(예: importance_sampling 및 ppo)에 대한 cross_entropy이(가) 포함되어 있습니다. 이러한 손실은 미리 정의된 엔드 투 엔드 알고리즘이 아닌 손실 프리미티브입니다. 투입 계약 및 사용자 지정 손실 구성에 대해서는 주요 개념을 참조하세요.
RL 루프 작동 방식
수학 추론 실험을 고려합니다. 모델은 각 문제에 대한 몇 가지 답변을 생성하고 프로그램은 그 답변들의 정답 여부를 평가합니다. 예시를 보려면 시작하기를 클릭하세요.
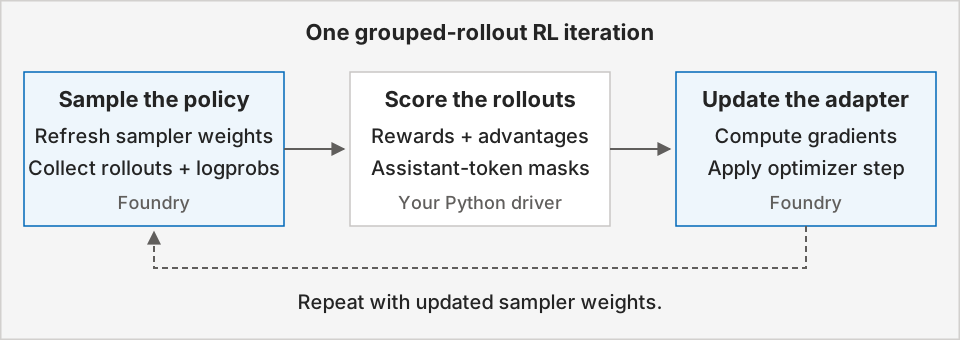
첫 번째 업데이트 전에 기준선을 설정하고 보상 함수를 테스트하세요. 그런 다음, 다음을 반복합니다.
- 샘플링을 위한 현재 정책을 준비합니다. 학습 어댑터에서 샘플러 가중치를 저장한 다음 각 프롬프트에 대해 여러 응답 또는 롤아웃을 수집합니다.
- 응답을 채점하고 비교합니다. 보상 함수는 각 롤아웃에 점수를 할당합니다. 각 실행 단계의 이점을 계산하려면 프롬프트 그룹의 평균 보상을 빼세요.
- 학습 신호를 준비합니다. 샘플링된 어시스턴트 토큰을 배포 로그 확률 및 이점과 일치시킵니다. 학습 신호에서 프롬프트 및 환경 관찰을 제외합니다.
- 그래디언트를 계산합니다.
importance_sampling와 함께 일괄 처리를forward_backward에 제출합니다. 해당 계산을 사용하는 업데이트 전에 그래디언트 계산을 완료하세요. - 어댑터를 업데이트합니다. 업데이트된 정책에서 응답을 수집하기 전에
optim_step를 호출한 다음 샘플러 가중치를 새로 고칩니다. - 진행 상황을 평가하고 유지합니다. 홀드아웃 정확도를 기준선과 비교하고 선택한 주기에 학습 체크포인트를 저장합니다.
Get started
작업에 맞는 시작점을 선택합니다.
- 빠른 시작:빠른 시작 샘플을 따라 저장소를 복제하고 간단한 강화 학습 레시피를 실행해 보세요.
- 다음과 같은 다른 레시피도 시도해 보세요. 더 많은 학습 예시를 보려면 파인 튜닝 샘플 저장소를 살펴보세요.
- 작업을 검색하세요. 함수 및 주요 매개변수에 대한 자세한 내용은 SDK 치트시트(미리 보기)를 참조하세요.
- 학습 루프 이해: 보상, 이점, 토큰 마스크 및 검사점에 대한 주요 개념을 읽습니다.
지원되는 모델 및 지역
지원되는 모델 및 지원되는 지역에 대한 미세 조정 개요를 참조하세요.