이 문서에서는 Azure Machine Learning의 그래프 검색 기능에 대해 알아봅니다.
그래프 검색을 사용하면 파이프라인을 디버깅하거나 빌드할 때 노드를 빠르게 탐색할 수 있습니다. 도구 모음의 입력 상자에 키워드 또는 쿼리를 입력하거나 왼쪽 패널의 검색 탭 아래에 입력하여 검색을 트리거할 수 있습니다. 일치하는 모든 결과는 캔버스에서 노란색으로 강조 표시되고, 왼쪽 패널에서 결과를 선택하면 캔버스의 노드가 빨간색으로 강조 표시됩니다.
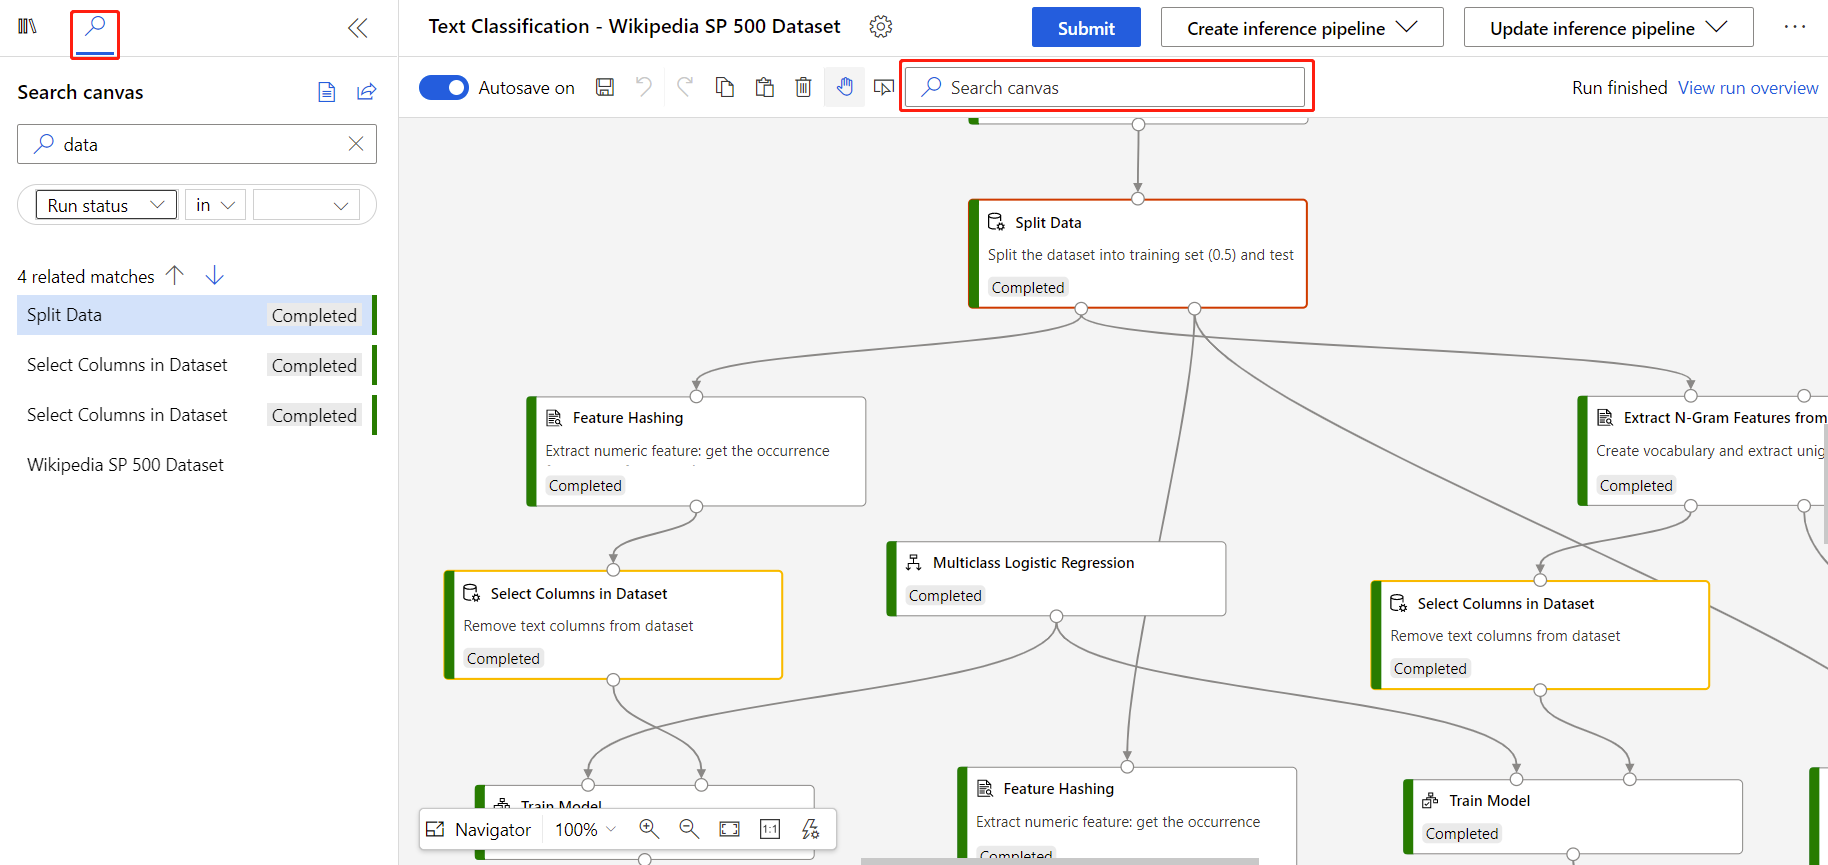
그래프 검색은 노드 이름 및 주석에 대한 전체 텍스트 키워드 검색을 지원합니다. runStatus, duration, computeTarget과 같은 노드 속성을 필터링할 수도 있습니다. 키워드 검색은 Lucene 쿼리를 기반으로 합니다. 전체 검색 쿼리는 다음과 같습니다.
[[lucene 쿼리] | [filter 쿼리]]
Lucene 쿼리 또는 필터 쿼리를 사용할 수 있습니다. 둘 다 사용하려면 구분 기호를 | 사용합니다. 필터 쿼리의 구문은 Lucene 쿼리보다 엄격합니다. 따라서 고객 입력을 둘 다로 구문 분석할 수 있는 경우 필터 쿼리가 적용됩니다.
예를 들어 data OR model | compute in {cpucluster}의 경우 이름이나 주석에 data 또는 model이 포함된 노드를 검색하기 위한 것이며, compute는 cpucluster입니다.
Lucene 쿼리
Graph 검색은 Lucene 단순 쿼리를 노드 "이름" 및 "주석"의 전체 텍스트 검색 구문으로 사용합니다. 지원되는 Lucene 연산자는 다음과 같습니다.
- AND/OR
- ? 및 * 연산자와 와일드카드 일치
예제
간단한 검색:
JSON DataAND/OR:
JSON AND Validation다중 AND/OR:
(JSON AND Validation) OR (TSV AND Training)와일드카드 일치:
machi?e learningmach*ing
참고 항목
"*" 문자로 Lucene 쿼리를 시작할 수 없습니다.
필터 쿼리
필터 쿼리는 다음 패턴을 사용합니다.
[key1] [operator1] [value1]; [key2] [operator1] [value2];
키로 다음 노드 속성을 사용할 수 있습니다.
- runStatus
- 계산하다
- 기간
- 재이용
- 출판하다
- 태그
그리고 다음 연산자를 사용할 수 있습니다.
- 크거나 같음:
>= - 작거나 같음:
<= - 큰:
> - 덜:
< - 같다:
== - 포함하다:
= - NotEqual:
!= - 안으로:
in
예시
- 기간 > 100;
- {Failed,NotStarted}의 상태
- {gpu-cluster}의 컴퓨팅 {Completed}의 runStatus
기술 정보
- 여러 필터 간의 관계는 "AND"입니다.
-
>=, >, <, or <=를 선택하면 값이 자동으로 숫자 형식으로 변환됩니다. 그렇지 않으면 문자열 형식이 비교에 사용됩니다. - 모든 문자열 형식 값의 경우 대/소문자를 비교할 때 구분되지 않습니다.
- 연산자 "In"에는 컬렉션이 값으로, 컬렉션 구문은 다음과 같습니다.
{name1, name2, name3} - 키워드 사이에 공백은 무시됩니다.