Microsoft Spark Utilities(MSSparkUtils)는 일반적인 작업을 쉽게 수행할 수 있도록 도와주는 내장 패키지입니다. MSSparkUtils를 사용하여 파일 시스템 작업을 수행하고, 환경 변수를 가져오고, 노트북을 연결하고, 비밀 정보를 다룰 수 있습니다. MSSparkUtils 패키지는 PySpark(Python), Scala, SparkR 노트북, Fabric 파이프라인에서 제공됩니다.
참고
- MsSparkUtils는 공식적으로 NotebookUtils로 이름이 변경되었습니다. 기존 코드는 이전 버전과의 호환성을 유지하며 어떠한 변경도 일으키지 않습니다. 지속적인 지원과 새로운 기능 접근을 위해 notebookutils로 업그레이드할 것을 강력히 권장 합니다. Mssparkutils 네임스페이스는 나중에 사용 중지됩니다.
- NotebookUtils는 Spark 3.4(런타임 v1.2) 이상에서 작동하도록 설계되었습니다. 모든 새로운 기능 및 업데이트는 앞으로 Notebookutils 네임스페이스에서만 지원됩니다.
파일 시스템 유틸리티
mssparkutils.fs는 Azure Data Lake Storage Gen2와 Azure Blob Storage를 포함한 다양한 파일 시스템을 다루는 유틸리티를 제공합니다. Azure Data Lake Storage Gen2 및 Azure Blob Storage에 대한 액세스를 적절하게 구성해야 합니다.
사용 가능한 메서드에 관한 개요를 가져오려면 다음 명령을 실행합니다.
from notebookutils import mssparkutils
mssparkutils.fs.help()
출력
mssparkutils.fs provides utilities for working with various FileSystems.

Below is overview about the available methods:

cp(from: String, to: String, recurse: Boolean = false): Boolean -> Copies a file or directory, possibly across FileSystems
mv(from: String, to: String, recurse: Boolean = false): Boolean -> Moves a file or directory, possibly across FileSystems
ls(dir: String): Array -> Lists the contents of a directory
mkdirs(dir: String): Boolean -> Creates the given directory if it does not exist, also creating any necessary parent directories
put(file: String, contents: String, overwrite: Boolean = false): Boolean -> Writes the given String out to a file, encoded in UTF-8
head(file: String, maxBytes: int = 1024 * 100): String -> Returns up to the first 'maxBytes' bytes of the given file as a String encoded in UTF-8
append(file: String, content: String, createFileIfNotExists: Boolean): Boolean -> Append the content to a file
rm(dir: String, recurse: Boolean = false): Boolean -> Removes a file or directory
exists(file: String): Boolean -> Check if a file or directory exists
mount(source: String, mountPoint: String, extraConfigs: Map[String, Any]): Boolean -> Mounts the given remote storage directory at the given mount point
unmount(mountPoint: String): Boolean -> Deletes a mount point
mounts(): Array[MountPointInfo] -> Show information about what is mounted
getMountPath(mountPoint: String, scope: String = ""): String -> Gets the local path of the mount point

Use mssparkutils.fs.help("methodName") for more info about a method.
MSSparkUtils는 Spark API와 동일한 방식으로 파일 시스템에서 작동합니다. 예를 들어 mssparkuitls.fs.mkdirs() 와 lakehouse 사용법을 보세요:
| 사용법 | HDFS 루트의 상대 경로 | ABFS 파일 시스템의 절대 경로 | 드라이버 노드의 로컬 파일 시스템에 대한 절대 경로 |
|---|---|---|---|
| 비표준 레이크하우스 | 지원되지 않음 | mssparkutils.fs.mkdirs("abfss://< container_name>@<storage_account_name.dfs.core.windows.net/>< new_dir>") | mssparkutils.fs.mkdirs("file:/<new_dir>") |
| 기본 레이크하우스 | "Files" 또는 "Tables"의 디렉터리: mssparkutils.fs.mkdirs("Files/<new_dir>") | mssparkutils.fs.mkdirs("abfss://< container_name>@<storage_account_name.dfs.core.windows.net/>< new_dir>") | mssparkutils.fs.mkdirs("file:/<new_dir>") |
파일 나열
디렉터리의 콘텐츠를 나열하려면 mssparkutils.fs.ls('디렉터리 경로')를 사용합니다. 예시:
mssparkutils.fs.ls("Files/tmp") # works with the default lakehouse files using relative path
mssparkutils.fs.ls("abfss://<container_name>@<storage_account_name>.dfs.core.windows.net/<path>")  # based on ABFS file system
mssparkutils.fs.ls("file:/tmp")  # based on local file system of driver node
파일 속성 보기
이 메서드는 파일 이름, 파일 경로, 파일 크기, 디렉터리인지 파일 인지 등 파일 속성을 반환합니다.
files = mssparkutils.fs.ls('Your directory path')
for file in files:
    print(file.name, file.isDir, file.isFile, file.path, file.size)
새 디렉터리 만들기
이 메서드는 지정된 디렉터리가 존재하지 않을 경우 생성하고, 필요한 부모 디렉터리를 생성합니다.
mssparkutils.fs.mkdirs('new directory name')
mssparkutils.fs. mkdirs("Files/<new_dir>")  # works with the default lakehouse files using relative path
mssparkutils.fs.ls("abfss://<container_name>@<storage_account_name>.dfs.core.windows.net/<new_dir>")  # based on ABFS file system
mssparkutils.fs.ls("file:/<new_dir>")  # based on local file system of driver node
파일 복사
이 메서드는 파일 또는 디렉터리를 복사하고 파일 시스템에서 복사 작업을 지원합니다.
mssparkutils.fs.cp('source file or directory', 'destination file or directory', True)# Set the third parameter as True to copy all files and directories recursively
성능이 우수한 파일 복사
이 메서드는 파일, 특히 대량의 데이터를 더 빠르게 복사하거나 이동하는 방법을 제공합니다.
mssparkutils.fs.fastcp('source file or directory', 'destination file or directory', True)# Set the third parameter as True to copy all files and directories recursively
파일 콘텐츠 미리 보기
이 메서드는 지정된 파일의 첫 maxBytes 바이트까지를 UTF-8로 인코딩한 문자열로 반환합니다.
# Set the second parameter as an integer for the maxBytes to read
mssparkutils.fs.head('file path', <maxBytes>)
파일 이동
이 메서드는 파일 또는 디렉터리를 이동하고 파일 시스템 간 이동을 지원합니다.
mssparkutils.fs.mv('source file or directory', 'destination directory', True) # Set the last parameter as True to firstly create the parent directory if it does not exist
mssparkutils.fs.mv('source file or directory', 'destination directory', True, True) # Set the third parameter to True to firstly create the parent directory if it does not exist. Set the last parameter to True to overwrite the updates.
파일 쓰기
지정된 문자열을 UTF-8으로 인코딩된 파일에 씁니다.
mssparkutils.fs.put("file path", "content to write", True) # Set the last parameter as True to overwrite the file if it existed already
파일에 콘텐츠 추가
이 메서드는 지정된 문자열을 UTF-8로 인코딩된 파일에 추가합니다.
mssparkutils.fs.append("file path", "content to append", True) # Set the last parameter as True to create the file if it does not exist
참고
mssparkutils.fs.append 루프에서 for API를 사용해 같은 파일에 쓸 때는, 반복 쓰기 사이에 약 0.5초에서 1초 정도의 sleep 문을 추가하는 것이 좋습니다.
mssparkutils.fs.append API의 내부 flush 동작은 비동기적이기 때문에, 짧은 지연이 데이터 무결성을 보장하는 데 도움이 됩니다.
파일 또는 디렉터리 삭제
이 메서드는 파일 또는 디렉토리를 제거합니다.
mssparkutils.fs.rm('file path', True) # Set the last parameter as True to remove all files and directories recursively
마운트/마운트 해제 디렉터리
자세한 사용에 대한 자세한 내용은 파일 마운트 및 언마운트를 참조하세요.
Notebook 유틸리티
MSSparkUtils Notebook 유틸리티를 사용하여 Notebook을 실행하거나 값이 있는 Notebook을 종료합니다. 사용 가능한 메서드에 관한 개요를 가져오려면 다음 명령을 실행합니다.
mssparkutils.notebook.help()
출력:
exit(value: String): Raises NotebookExit Exception -> This method lets you exit a notebook with a value.
run(path: String, timeoutSeconds: int, arguments: Map): String -> This method runs a notebook and returns its exit value.
참고
노트북 유틸리티는 Apache Spark 작업 정의(SJD)에는 적용되지 않습니다.
노트북을 참조하세요
이 메서드는 노트북을 참조하고 그 종료 값을 반환합니다. 중첩 함수 호출은 Notebook에서 인터랙티브하게 실행하거나 파이프라인에서 실행할 수 있습니다. 참조된 Notebook은 이 함수를 호출하는 Notebook의 Spark 풀에서 실행됩니다.
mssparkutils.notebook.run("notebook name", <timeoutSeconds>, <parameterMap>, <workspaceId>)
예시:
mssparkutils.notebook.run("Sample1", 90, {"input": 20 })
Fabric Notebook은 작업 영역 ID를 지정하여 여러 작업 영역에서 Notebook 참조를 지원합니다.
mssparkutils.notebook.run("Sample1", 90, {"input": 20 }, "fe0a6e2a-a909-4aa3-a698-0a651de790aa")
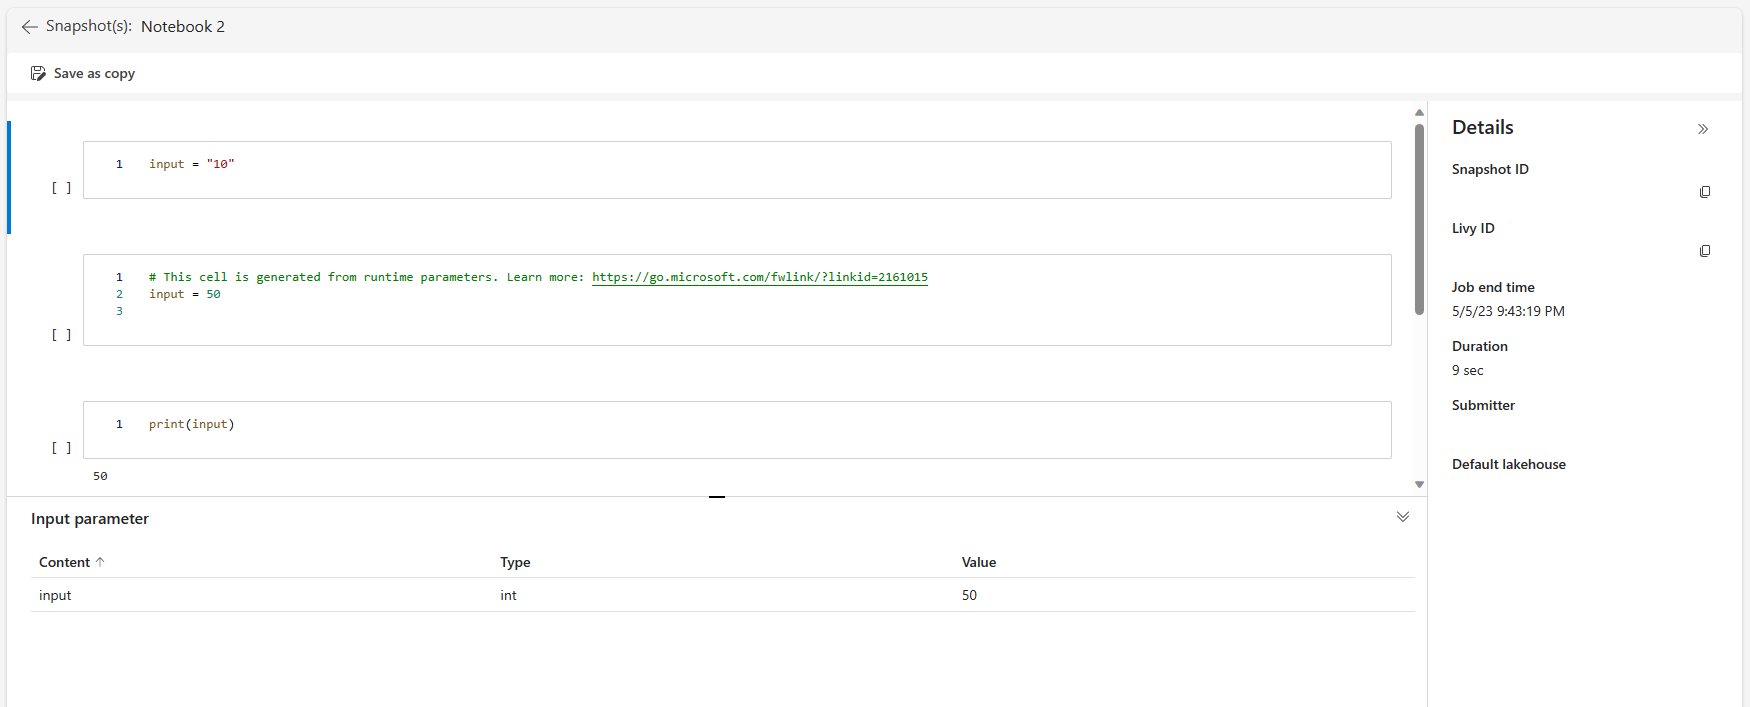
셀 출력에서 참조 실행의 스냅샷 링크를 열 수 있습니다. 스냅샷은 코드 실행 결과를 캡처하고 참조 실행을 쉽게 디버그할 수 있도록 합니다.

참고
- 작업 영역 간 참조 Notebook은 런타임 버전 1.2 이상에서 지원됩니다.
-
노트북 리소스 아래에 있는 파일을 사용한다면,
mssparkutils.nbResPath참조된 노트북에서 인터랙티브 실행과 같은 폴더를 가리키는지 확인하세요.
참조는 여러 Notebook을 병렬로 실행합니다.
중요한
이 기능은 프리뷰로 제공됩니다.
mssparkutils.notebook.runMultiple() 메서드를 사용하면 여러 Notebook을 병렬로 실행하거나 미리 정의된 토폴로지 구조로 실행할 수 있습니다. API는 멀티스레드 구현을 사용하여 기존 Spark 세션 내의 격리된 REPL 인스턴스(읽기-평가-출력-반복)에서 실행되는 자식 노트북을 제출하고, 대기열에 추가하며, 모니터링합니다. 참조된 자식 노트북은 세션의 컴퓨팅 리소스를 공유합니다.
mssparkutils.notebook.runMultiple()로 다음을 수행할 수 있습니다.
각 Notebook이 완료되는 것을 기다리지 않고 동시에 여러 Notebook을 실행합니다.
간단한 JSON 형식을 사용하여 Notebook에 대한 종속성 및 실행 순서를 지정합니다.
Spark 컴퓨팅 리소스 사용을 최적화하고 Fabric 프로젝트의 비용을 절감합니다.
각 노트북 실행 기록의 스냅샷을 출력에서 확인하고, 노트북 작업을 편리하게 디버깅하고 모니터링할 수 있습니다.
각 임원 활동의 종료 값을 가져와 다운스트림 작업에 사용합니다.
mssparkutils.notebook.help("runMultiple")를 실행하여 예제 및 자세한 사용량을 찾을 수도 있습니다.
다음은 이 방법을 사용하여 Notebook 목록을 병렬로 실행하는 간단한 예제입니다.
mssparkutils.notebook.runMultiple(["NotebookSimple", "NotebookSimple2"])
루트 Notebook의 실행 결과는 다음과 같습니다.

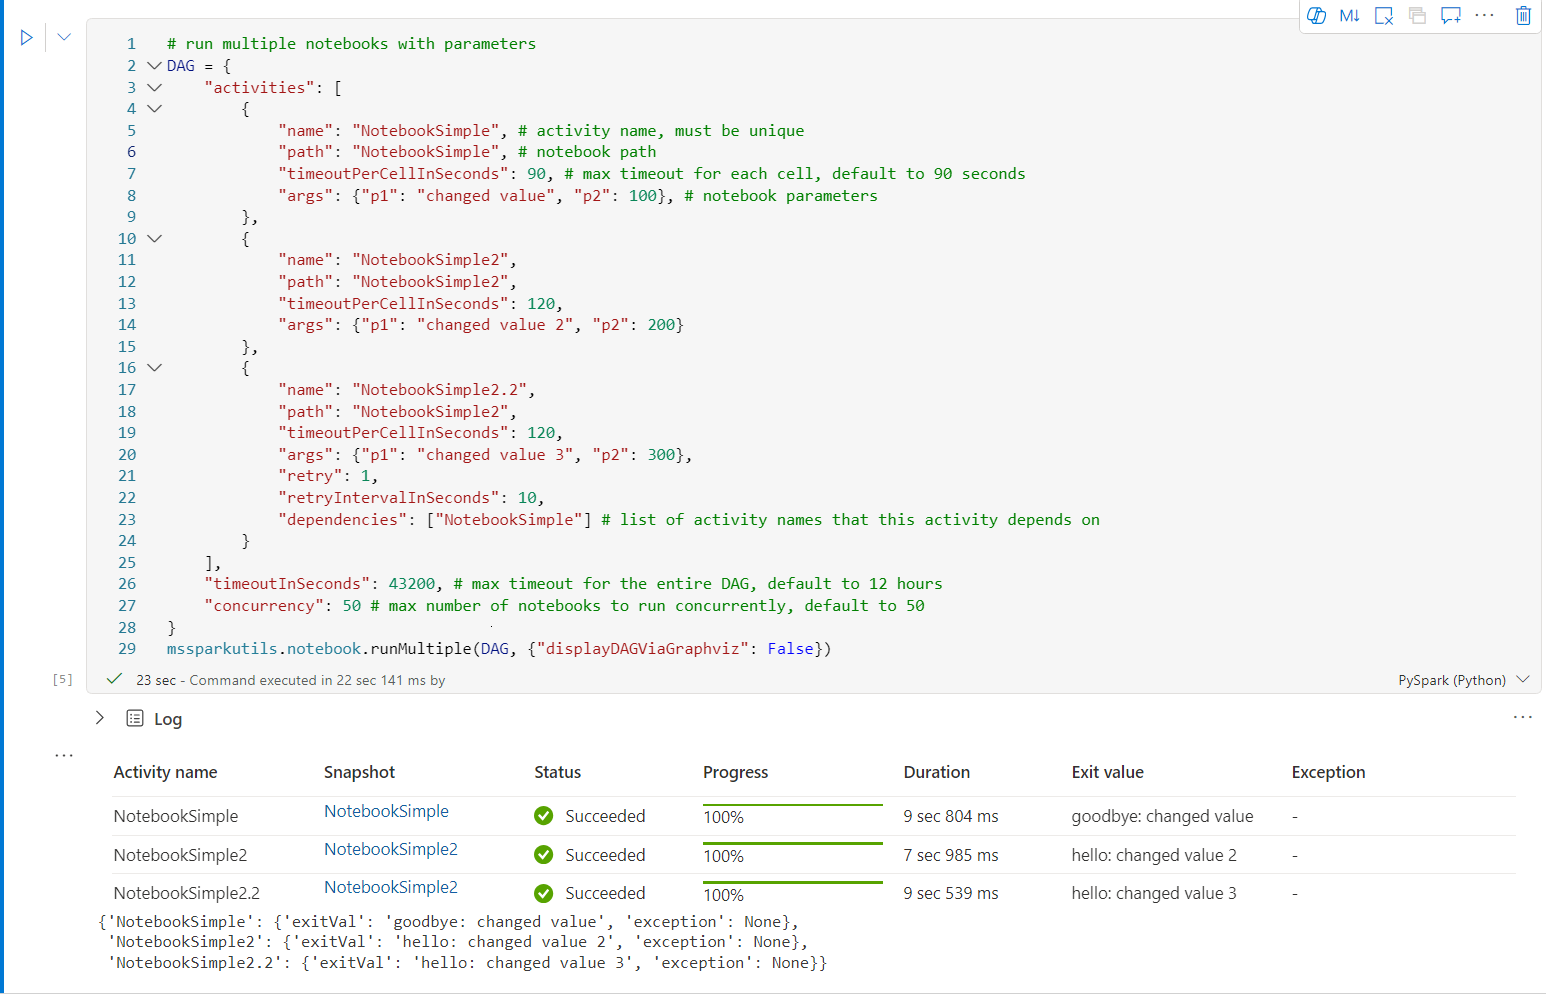
다음 예에서는 mssparkutils.notebook.runMultiple()를 사용하여 위상 구조의 노트북을 실행하는 방법을 보여 줍니다. 이 메서드를 사용하여 코드 경험을 통해 노트북을 쉽게 오케스트레이션할 수 있습니다.
# run multiple notebooks with parameters
DAG = {
    "activities": [
        {
            "name": "NotebookSimple", # activity name, must be unique
            "path": "NotebookSimple", # notebook path
            "timeoutPerCellInSeconds": 90, # max timeout for each cell, default to 90 seconds
            "args": {"p1": "changed value", "p2": 100}, # notebook parameters
        },
        {
            "name": "NotebookSimple2",
            "path": "NotebookSimple2",
            "timeoutPerCellInSeconds": 120,
            "args": {"p1": "changed value 2", "p2": 200}
        },
        {
            "name": "NotebookSimple2.2",
            "path": "NotebookSimple2",
            "timeoutPerCellInSeconds": 120,
            "args": {"p1": "changed value 3", "p2": 300},
            "retry": 1,
            "retryIntervalInSeconds": 10,
            "dependencies": ["NotebookSimple"] # list of activity names that this activity depends on
        }
    ],
    "timeoutInSeconds": 43200, # max timeout for the entire DAG, default to 12 hours
    "concurrency": 50 # max number of notebooks to run concurrently, defaults to 50 but ultimately constrained by the number of driver cores
}
mssparkutils.notebook.runMultiple(DAG, {"displayDAGViaGraphviz": False})
루트 Notebook의 실행 결과는 다음과 같습니다.
참고
- Notebook 활동 또는 동시 실행되는 Notebook의 상한은 드라이버 코어 수로 제한됩니다. 예를 들어, 8코어의 Medium 노드 드라이버는 최대 8대의 노트북을 동시에 실행할 수 있습니다. 이 한계는 제출된 각 노트북이 자체 REPL(읽기-평가-인쇄 루프) 인스턴스에서 실행되며, 각 인스턴스가 하나의 드라이버 코어를 소모하기 때문에 존재합니다.
- 기본 동시성 매개 변수는 사용자가 더 큰 노드 및 더 많은 드라이버 코어를 사용하여 Spark 풀을 구성할 때 최대 동시성 크기를 자동으로 조정하도록 지원하도록 50 으로 설정됩니다. 더 큰 드라이버 노드를 사용할 때 이 매개변수를 더 높게 설정할 수는 있지만, 단일 드라이버 노드에서 동시에 실행되는 프로세스 수를 늘리는 것은 일반적으로 선형적으로 확장되지 않습니다. 동시성을 높이면 드라이버 및 실행기 리소스 경합으로 인해 효율성이 저하될 수 있습니다. 각 실행 노트북은 전용 REPL 인스턴스에서 실행되며, 이 인스턴스는 드라이버의 CPU와 메모리를 소모합니다. 높은 동시성 상태에서는 이러한 소비가 드라이버 불안정성이나 메모리 초과 오류 위험을 증가시킬 수 있으며, 특히 장기 실행 작업 부하에서 더욱 그렇습니다.
- REPL 인스턴스 초기화와 여러 노트북 조정 오버헤드 때문에 각 작업별로 실행 시간이 길어질 수 있습니다. 문제가 발생하면 노트북을 여러
runMultiple호출로 분리하거나 DAG 매개변수의 동시 성 필드를 조정하여 동시성을 줄이는 것을 고려하세요. - 짧은 수명의 노트북(예: 코드 실행 5초)을 실행할 때는 초기화 오버헤드가 지배적으로 작용합니다. 준비 시간의 변동성은 노트북이 겹칠 가능성을 줄여 실현 동시성 감소로 이어질 수 있습니다. 이런 상황에서는 작은 작업을 하나 또는 여러 노트북에 합치는 것이 더 나을 수 있습니다.
- 멀티스레딩은 제출, 큐잉, 모니터링에 사용되지만, 각 노트북에서 실행되는 코드가 각 실행 기자마다 멀티스레드되어 있지 않다는 점에 유의하세요. 노트북 간에 자원 공유는 없습니다. 각 노트북 프로세스는 전체 집행자 자원의 일부를 할당받습니다. 이러한 할당은 짧은 작업은 비효율적으로 운영되고, 긴 작업은 자원을 두고 경쟁하게 만들 수 있습니다.
- 전체 DAG의 기본 타임아웃은 12시간이며, 자식 노트북의 각 셀에 대한 기본 타임아웃은 90초입니다. DAG 매개 변수에서 timeoutInSeconds 및 timeoutPerCellInSeconds 필드를 설정하여 시간 제한을 변경할 수 있습니다. 동시성을 높일수록 발생할 수 있는 리소스 경합으로 인해 불필요한 시간 초과가 발생하지 않도록 timeoutPerCellInSeconds 값을 늘려야 할 수 있습니다.
노트북 종료
이 메서드는 값이 있는 Notebook을 종료합니다. 중첩 함수 호출은 Notebook에서 인터랙티브하게 실행하거나 파이프라인에서 실행할 수 있습니다.
Notebook에서 exit() 함수를 대화형으로 호출하면 Fabric Notebook은 예외를 던지고 후속 셀 실행을 건너뛰며 Spark 세션을 활성 상태로 유지합니다.
exit() 함수를 호출하는 파이프라인에서 Notebook을 오케스트레이션하면 Notebook 작업이 종료 값으로 반환되고 파이프라인 실행이 완료되고 Spark 세션이 중지됩니다. exit() 함수는 try/catch로 감싸지 마세요. 파이프라인이 반환 값을 얻으려면 이 NotebookExit 예외가 전파되어야 합니다.
참조 중인 노트북에서 exit() 함수를 호출하면, Fabric Spark는 참조된 노트북의 추가 실행을 중단하고, run() 함수를 호출하는 메인 노트북의 다음 셀들을 계속 실행합니다. 예를 들어 Notebook1에는 세 개의 셀이 있으며 두 번째 셀에서 exit() 함수를 호출합니다. Notebook2에는 세 번째 셀에 5개의 셀과 호출 run(notebook1) 이 있습니다. Notebook2를 실행하면 exit() 함수를 누르면 Notebook1이 두 번째 셀에서 중지됩니다. Notebook2는 네 번째 셀과 다섯 번째 셀을 계속 실행합니다.
mssparkutils.notebook.exit("value string")
예시:
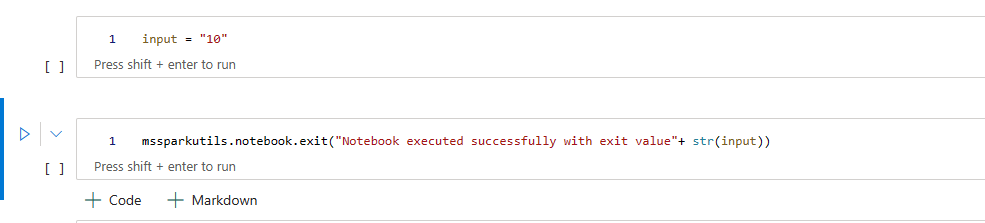
다음 두 개의 셀이 있는 Sample1 Notebook:
셀 1은 기본값이 10으로 설정된 입력 매개 변수를 정의합니다.
셀 2는 입력을 종료 값으로 사용하여 Notebook을 종료합니다.
기본값을 사용하여 다른 Notebook에서 Sample1을 실행할 수 있습니다.
exitVal = mssparkutils.notebook.run("Sample1")
print (exitVal)
출력:
Notebook executed successfully with exit value 10
다른 Notebook에서 Sample1을 실행하고 입력 값을 20으로 설정할 수 있습니다.
exitVal = mssparkutils.notebook.run("Sample1", 90, {"input": 20 })
print (exitVal)
출력:
Notebook executed successfully with exit value 20
자격 증명 유틸리티
MSSparkUtils 자격 증명 유틸리티를 사용해 액세스 토큰을 얻고 Azure Key Vault에서 비밀을 관리할 수 있습니다.
사용 가능한 메서드에 관한 개요를 가져오려면 다음 명령을 실행합니다.
mssparkutils.credentials.help()
출력:
getToken(audience, name): returns AAD token for a given audience, name (optional)
getSecret(keyvault_endpoint, secret_name): returns secret for a given Key Vault and secret name
토큰 가져오기
getToken특정 청중과 이름(선택 사항)에 대해 Microsoft Entra 토큰을 반환합니다. 다음 목록에는 현재 사용 가능한 대상 그룹 키가 나와 있습니다.
-
스토리지 오디언스 리소스:
storage -
Power BI 리소스:
pbi -
Azure Key Vault Resource:
keyvault -
Synapse RTA KQL DB Resource:
kusto
다음 명령을 실행하여 토큰을 가져옵니다.
mssparkutils.credentials.getToken('audience Key')
사용자 자격 증명을 사용해 비밀을 얻으세요
getSecret사용자 자격 증명을 사용하여 주어진 Azure Key Vault 엔드포인트와 비밀 이름에 대해 Azure Key Vault 비밀을 반환합니다.
mssparkutils.credentials.getSecret('https://<name>.vault.azure.net/', 'secret name')
파일 탑재 및 분리
Fabric은 Microsoft Spark 유틸리티 패키지에서 다음과 같은 탑재 시나리오를 지원합니다. 마운트, 언마운트, getMountPath(), mounts() API를 사용해 원격 저장소(Azure Data Lake Storage Gen2)를 모든 작동 중인 노드(드라이버 노드와 워커 노드)에 연결할 수 있습니다. 스토리지 탑재 지점을 설정한 후에는 로컬 파일 API를 사용하여 로컬 파일 시스템에 저장된 것처럼 데이터에 액세스합니다.
Azure Data Lake Storage Gen2 계정 마운트 방법
다음 예시는 Azure Data Lake Storage Gen2를 마운트하는 방법을 보여줍니다. Blob Storage 탑재 방법도 비슷합니다.
이 예제에서는 storegen2라는 Data Lake Storage Gen2 계정이 하나 있고 계정에 Notebook Spark 세션에 탑재/test하려는 mycontainer라는 컨테이너가 하나 있다고 가정합니다.
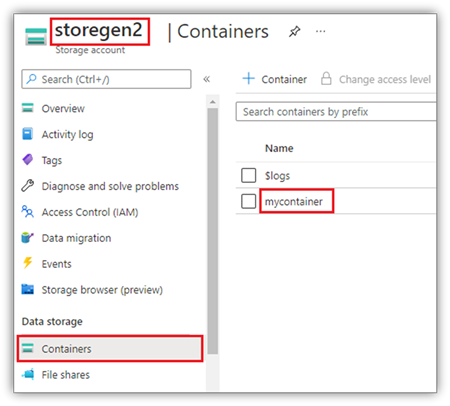
mycontainer라는 이름을 가진 컨테이너를 마운트할 때, mssparkutils는 먼저 해당 컨테이너에 접근할 권한이 있는지 확인합니다. Fabric은 트리거 마운트 연산을 위한 세 가지 인증 방식을 지원합니다: Microsoft Entra 토큰(기본 및 권장), accountKey, 그리고 sastoken. Microsoft Entra 토큰 인증과 현재 notebookutils API에 대한 자세한 내용은 Fabric용 NotebookUtils 파일 마운트 및 마운트 해제를 참조하세요.
공유 접근 서명 토큰이나 계정 키를 사용해 마운트합니다
MSSparkUtils는 대상 탑재를 위해 계정 키 또는 공유 액세스 서명(SAS) 토큰을 매개 변수로 명시적으로 전달하는 것을 지원합니다.
보안상의 이유로 계정 키 또는 SAS 토큰을 Azure Key Vault에 저장하는 것이 좋습니다(다음 스크린샷에 표시됨). 그런 다음 mssparkutils.credentials.getSecret API를 사용하여 검색할 수 있습니다. 자세한 내용은 Azure Key Vault 관리 스토리지 계정 키 정보를 참조하세요.

accountKey 메서드에 대한 샘플 코드:
from notebookutils import mssparkutils
# get access token for keyvault resource
# you can also use full audience here like https://vault.azure.net
accountKey = mssparkutils.credentials.getSecret("<vaultURI>", "<secretName>")
mssparkutils.fs.mount(
    "abfss://mycontainer@<accountname>.dfs.core.windows.net",
    "/test",
    {"accountKey":accountKey}
)
sastoken에 대한 샘플 코드:
from notebookutils import mssparkutils
# get access token for keyvault resource
# you can also use full audience here like https://vault.azure.net
sasToken = mssparkutils.credentials.getSecret("<vaultURI>", "<secretName>")
mssparkutils.fs.mount(
    "abfss://mycontainer@<accountname>.dfs.core.windows.net",
    "/test",
    {"sasToken":sasToken}
)
참고
사용할 수 없는 경우 mssparkutils를 가져와야 할 수 있습니다.
from notebookutils import mssparkutils
탑재 매개 변수:
-
fileCacheTimeout: 블롭은 기본적으로 로컬 임시 폴더에 120초 동안 캐시됩니다. 이 시간 동안 blobfuse는 파일이 최신 상태인지 여부를 확인하지 않습니다. 이 매개변수를 설정해 기본 타임아웃을 변경하세요. 여러 클라이언트가 동시에 파일을 수정할 때, 로컬 파일과 원격 파일 간의 불일치를 피하기 위해 캐시 시간을 단축하거나 0으로 변경하고, 항상 서버에서 최신 파일을 가져오는 것을 권장합니다. -
timeout: 마운트 작업 타임아웃은 기본값으로 120초입니다. 이 매개변수를 설정해 기본 타임아웃을 변경하세요. 집행자가 너무 많거나 마운트 타임아웃이 될 때는 가치를 높이는 것을 권장합니다.
다음과 같은 매개 변수를 사용할 수 있습니다.
mssparkutils.fs.mount(
   "abfss://mycontainer@<accountname>.dfs.core.windows.net",
   "/test",
   {"fileCacheTimeout": 120, "timeout": 120}
)
참고
보안상의 이유로 코드에 자격 증명을 저장하지 마세요. 자격 증명을 추가로 보호하기 위해 노트북 출력에서는 비밀 값이 가려집니다. 자세한 내용은 비밀 수정을 참조하세요.
Lakehouse를 설정하는 방법
/test에 레이크하우스를 마운트하기 위한 샘플 코드:
from notebookutils import mssparkutils
mssparkutils.fs.mount(
 "abfss://<workspace_id>@onelake.dfs.fabric.microsoft.com/<lakehouse_id>",
 "/test"
)
참고
지역 엔드포인트 설치는 지원되지 않습니다. Fabric은 전역 엔드포인트 onelake.dfs.fabric.microsoft.com 탑재만 지원합니다.
mssparkutils fs API를 사용하여 마운트 지점 아래 파일에 접근하세요
마운트 작업의 주요 목적은 로컬 파일 시스템 API를 사용하여 원격 저장소 계정에 저장된 데이터에 접근할 수 있게 하는 것입니다. 탑재된 경로가 있는 mssparkutils fs API를 매개 변수로 사용하여 데이터에 액세스할 수도 있습니다. 이 경로 형식은 약간 다릅니다.
마운트 API를 사용해 Data Lake Storage Gen2 컨테이너 mycontainer/test 를 마운트했다고 가정해 봅시다. 로컬 파일 시스템 API를 통해 데이터에 접근할 때, 경로 형식은 다음과 같습니다:
/synfs/notebook/{sessionId}/test/{filename}
mssparkutils fs API를 사용하여 데이터에 접근하고 싶을 때는 정확한 경로를 얻기 위해 getMountPath()를 사용하는 것을 권장합니다:
path = mssparkutils.fs.getMountPath("/test")
디렉터리 목록 표시:
mssparkutils.fs.ls(f"file://{mssparkutils.fs.getMountPath('/test')}")파일 콘텐츠 읽기:
mssparkutils.fs.head(f"file://{mssparkutils.fs.getMountPath('/test')}/myFile.txt")디렉터리 만들기:
mssparkutils.fs.mkdirs(f"file://{mssparkutils.fs.getMountPath('/test')}/newdir")
로컬 경로를 통해 탑재 지점 아래의 파일에 액세스
표준 파일 시스템을 사용하여 탑재 지점에서 파일을 쉽게 읽고 쓸 수 있습니다. 다음은 Python의 예입니다.
#File read
with open(mssparkutils.fs.getMountPath('/test2') + "/myFile.txt", "r") as f:
    print(f.read())
#File write
with open(mssparkutils.fs.getMountPath('/test2') + "/myFile.txt", "w") as f:
    print(f.write("dummy data"))
기존 탑재 지점을 확인하는 방법
mssparkutils.fs.mounts() API를 사용하여 모든 기존 탑재 지점 정보를 확인할 수 있습니다.
mssparkutils.fs.mounts()
탑재 지점을 분리하는 방법
다음 코드를 사용하여 탑재 지점을 분리합니다(이 예제에서는 /test).
mssparkutils.fs.unmount("/test")
알려진 제한 사항
현재 마운트는 작업 수준의 구성입니다. 마운트 지점이 존재하는지 또는 사용할 수 없는지 확인하는 데 mounts API를 사용하시기를 권장합니다.
분리 장치는 자동으로 작동하지 않습니다. 애플리케이션 실행이 완료되면 탑재 지점을 분리하여 디스크 공간을 해제하려면 코드에서 분리 API를 명시적으로 호출해야 합니다. 그렇지 않으면 애플리케이션 실행이 완료된 후에도 탑재 지점이 노드에 계속 존재합니다.
Azure Data Lake Storage Gen1 스토리지 계정을 마운트하는 것은 지원되지 않습니다.
Lakehouse 유틸리티
이 모듈은 mssparkutils.lakehouse 호숫가 아이템 관리를 위한 유틸리티를 제공합니다. 이 유틸리티들은 호숫가 아이템을 생성, 검색, 업데이트, 삭제하는 것을 쉽게 만듭니다.
참고
Lakehouse API는 런타임 버전 1.2 이상에서만 지원됩니다.
방법 개요
다음 메서드를 mssparkutils.lakehouse 모듈에서 사용할 수 있습니다:
# Create a new Lakehouse artifact
create(name: String, description: String = "", workspaceId: String = ""): Artifact

# Retrieve a Lakehouse artifact
get(name: String, workspaceId: String = ""): Artifact

# Update an existing Lakehouse artifact
update(name: String, newName: String, description: String = "", workspaceId: String = ""): Artifact

# Delete a Lakehouse artifact
delete(name: String, workspaceId: String = ""): Boolean

# List all Lakehouse artifacts
list(workspaceId: String = ""): Array[Artifact]
사용 예
이 방법들을 효과적으로 사용하려면 다음 사용 사례를 고려해 보세요:
호숫가 아이템 만들기
artifact = mssparkutils.lakehouse.create("artifact_name", "Description of the artifact", "optional_workspace_id")
호숫가 아이템 가져오기
artifact = mssparkutils.lakehouse.get("artifact_name", "optional_workspace_id")
호숫가 아이템 업데이트
updated_artifact = mssparkutils.lakehouse.update("old_name", "new_name", "Updated description", "optional_workspace_id")
호숫가 집 항목 삭제하기
is_deleted = mssparkutils.lakehouse.delete("artifact_name", "optional_workspace_id")
호숫가 주택 목록
artifacts_list = mssparkutils.lakehouse.list("optional_workspace_id")
추가 정보
각 방법과 그 매개변수에 대한 더 자세한 정보는 함수를 mssparkutils.lakehouse.help("methodName") 사용하세요.
MSSparkUtils의 Lakehouse 유틸리티를 사용하면 Lakehouse 항목을 보다 효율적으로 관리하고 이를 Fabric 파이프라인에 통합하여 전반적인 데이터 관리 경험을 향상시킬 수 있습니다.
이러한 유틸리티들을 탐색하고 Fabric 워크플로우에 통합하여 원활한 호숫가 아이템 관리를 하세요.
런타임 유틸리티
세션 컨텍스트 정보 표시
를 사용하면 mssparkutils.runtime.context현재 라이브 세션의 맥락 정보를 얻을 수 있는데, 노트북 이름, 기본 레이크하우스, 작업 공간 정보, 파이프라인 실행 여부 등 다양한 정보입니다.
mssparkutils.runtime.context
참고
mssparkutils.envFabric에서 공식적으로 지원되지 않습니다. 대안으로 notebookutils.runtime.context을(를) 사용하세요.
알려진 문제
1.2 이전 런타임 버전을 사용 중이라 mssparkutils.help()면, 나열된 fabricClient, warehouse, workspace API는 현재 지원되지 않습니다.