Microsoft Fabric의 Eventstream은 실시간 데이터 처리 및 분석을 가능하게 하는 완전 관리형 이벤트 수집 및 스트리밍 서비스입니다. Spark Structured Streaming을 사용해 이벤트스트림을 Fabric 노트북과 통합하여 실시간으로 스트리밍 데이터를 처리하고 분석할 수 있습니다.
이 통합을 통해 Real-Time 허브를 통해 Fabric 노트북 내에서 이벤트스트림과 기타 실시간 소스를 탐색할 수 있습니다. 또한 새로운 이벤트 스트림을 생성하고 CDC 지원 데이터베이스, 메시지 중개업체, 스트리밍 서비스, 공개 피드 등 거의 30개(그리고 계속 증가하는 스트리밍) 소스에서 데이터를 수집할 수 있습니다. 새로운 프로그래밍 모델은 이벤트 스트림에 쉽게 연결하고, 스트리밍 데이터를 읽으며, 연결 문자열이나 자격 증명 없이도 익숙한 Spark API를 사용해 실시간 분석을 수행할 수 있게 하여 실시간 애플리케이션 구축이 더욱 안전해집니다
필수 조건
시작하기 전에 다음 필수 구성 요소가 있는지 확인합니다.
- 이벤트스트림이 활성화된 Fabric 작업 공간입니다.
- Fabric으로 설정된 노트북 환경입니다.
- Spark 구조적 스트리밍 및 PySpark 또는 Scala에 대한 기본 지식입니다.
Notebook에서 Eventstream을 쿼리하는 단계
Notebook에 eventstream 검색 및 추가:
Microsoft Fabric Notebook을 엽니다.
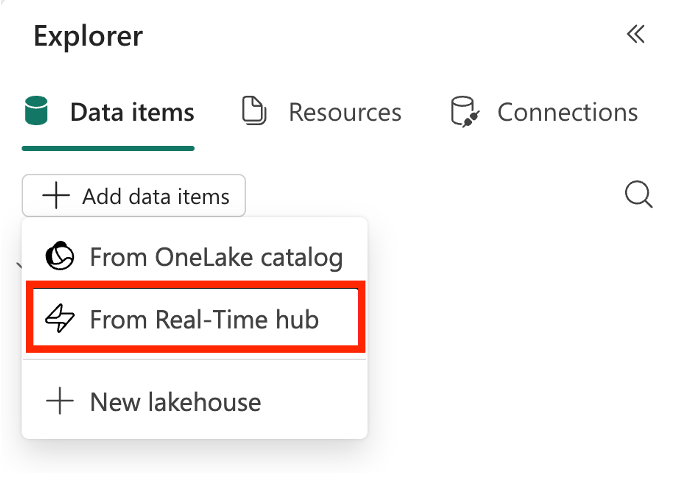
데이터 항목 탭에서 데이터 항목 추가를 선택한 다음 드롭다운 메뉴에서 Real-Time 허브에서 선택합니다.
Real-Time 허브 대화 상자에서 다른 검색 및 필터 옵션을 사용하여 쿼리할 대상 이벤트 스트림을 찾습니다.
Notebook 환경에 eventstream을 추가합니다.
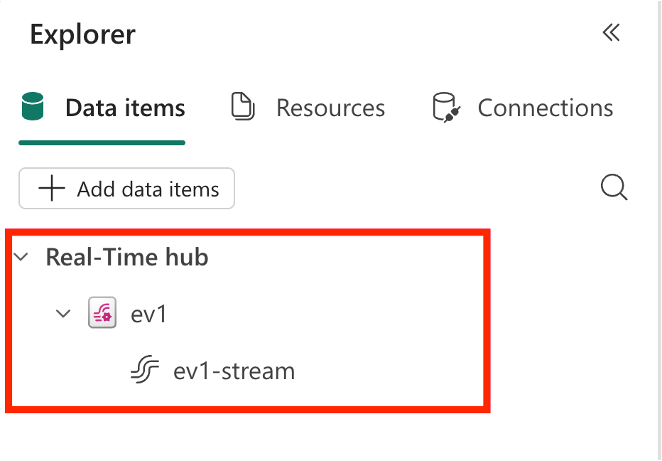
eventstream 항목이 추가되면 항목 이름이 있는 Notebook 개체 탐색기의 Real-Time 허브 노드 아래에 표시됩니다. 노드를 확장한 후에는 eventstream 항목 내에 기본 또는 파생 스트림이 표시됩니다.
eventstream에서 스트리밍 데이터를 읽습니다.
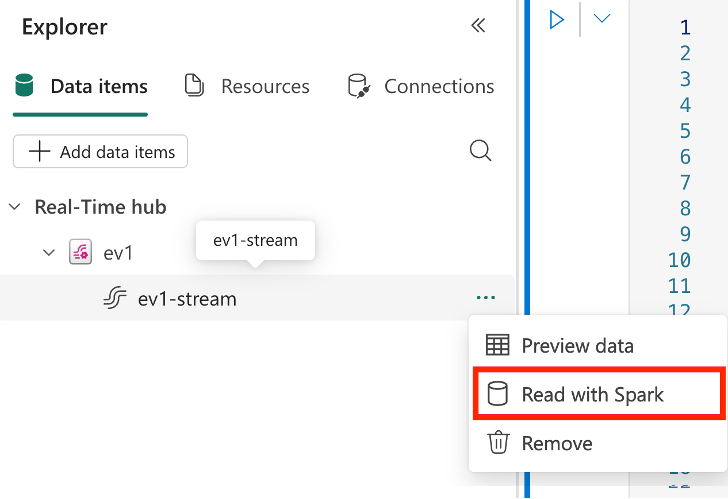
개체 탐색기에서 eventstream 항목의 상황에 맞는 메뉴에서 Spark로 읽기 를 선택하여 선택한 eventstream에서 읽을 미리 구성된 코드 셀을 만듭니다.
새로 만든 코드 셀에서 다음 PySpark 코드 조각을 사용하여 eventstream에서 스트리밍 데이터를 읽을 수 있습니다.
from pyspark.sql import SparkSession
from pyspark.sql.functions import col
from pyspark.sql.types import StringType
from pyspark.sql.dataframe import DataFrame

eventstream_options = {
    "eventstream.itemid": __in_eventstream_item_id,
    "eventstream.datasourceid": __in_eventstream_datasource_id
}

# Read from Kafka using the config map
df_raw = spark.readStream.format("kafka").options(**eventstream_options).load()

decoded_df = df_raw.select(
    col("key").cast(StringType()).alias("key"),
    col("value").cast(StringType()).alias("value"),
    col("partition"),
    col("offset")
)

def showDf(x:DataFrame, y:int):
    x.show()

# Print messages to the console
query = decoded_df.writeStream.foreachBatch(showDf).outputMode("append").start()
query.awaitTermination()
및
eventstream.itemid옵션의eventstream.datasourceid값은 이 코드 셀 위의 매개 변수 코드 셀에 자동으로 채워집니다.비고
Spark를 사용하여 읽기에서 선택할 때마다 필요한 매개 변수를 자동으로 입력하여 새 코드 셀이 생성되고, Eventstream 항목에 대해 새 Notebook 대상이 만들어집니다. 여기서
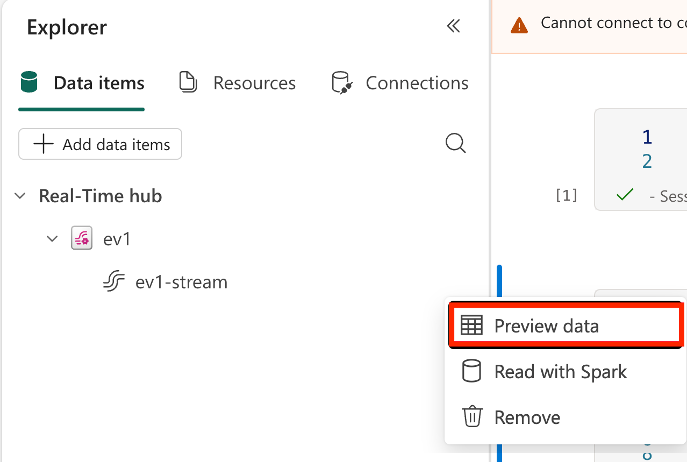
eventstream.datasourceid각 Notebook 대상에 대해 고유합니다. 노트북 항목 하나의 경우, 여러 대상을 만드는 경우에 대비하여, 하나의 Eventstream 항목에 대한 대상으로 한 번 설정하는 것이 좋습니다.작업을 실행하기 전에 Eventstream 항목의 상황에 맞는 메뉴에서 데이터 미리 보기 단추를 클릭하여 스트리밍 데이터를 미리 볼 수도 있습니다. 사이드 패널이 열리면 Notebook 옆에 스트리밍 데이터의 스냅샷이 표시됩니다.
Notebook을 대상으로 추가: Notebook을 Eventstream의 대상으로 추가하여 Notebook 내에서 Eventstream으로 데이터 수집을 시작할 수도 있습니다. 자세한 내용은 이벤트 스트림에 Spark Notebook 대상 추가를 참조하세요.
결론
Spark Structured Streaming을 이용해 Fabric에서 노트북과 이벤트스트림을 통합하면 실시간 데이터를 원활하게 처리하고 분석할 수 있습니다. 이 글에서 설명한 단계를 따르면 이벤트스트림에 쉽게 연결하고, 스트리밍 데이터를 읽으며, 익숙한 Spark API를 사용해 실시간 분석을 수행할 수 있습니다. 이 통합은 실시간 애플리케이션 구축과 Fabric 생태계 내 스트리밍 데이터로부터 인사이트를 얻는 새로운 가능성을 열어줍니다.
관련 콘텐츠
Fabric에서 이벤트스트림과 노트북을 다루는 방법에 대해 더 알고 싶다면 다음 자료들을 참고하세요