적용 대상: ✅ Microsoft Fabric의 웨어하우스
이 글에서는 Azure Synapse Analytics 전용 SQL 풀에서 Microsoft Fabric Data Warehouse 로켓으로 마이그레이션하는 방법을 설명합니다.
팁 (조언)
전략과 마이그레이션 계획에 대한 자세한 내용은 마이그레이션 계획: Fabric Data Warehouse 전용 SQL 풀 Azure Synapse Analytics 참조를 참조하세요.
데이터 웨어하우스용 Fabric Migration Assistant를 사용하면 Azure Synapse Analytics 전용 SQL 풀에서 마이그레이션하는 자동화된 환경을 사용할 수 있습니다. 이 문서의 나머지 부분에는 수동 마이그레이션 단계가 더 많이 포함되어 있습니다.
다음 표는 데이터 스키마(DDL), 데이터베이스 코드(DML), 데이터 마이그레이션 방법을 요약합니다. 옵션 열은 각 시나리오에 대한 세부 정보로 연결됩니다.
| 옵션 번호 | Option | 하는 일 | 실력 아니면 선호 | 시나리오 |
|---|---|---|---|---|
| 1 | 데이터 팩토리 | 스키마(DDL) 변환 데이터 추출 데이터 수집 |
ADF/파이프라인 | 하나의 DDL(스키마) 및 데이터 마이그레이션에서 모두 간소화되었습니다. 차원 테이블에 권장됩니다. |
| 2 | 파티션이 있는 Data Factory | 스키마(DDL) 변환 데이터 추출 데이터 수집 |
ADF/파이프라인 | 읽기/쓰기 병렬 처리를 늘리기 위해 분할 옵션을 사용하면 옵션 1에 비해 처리량이 10배 높아집니다. 팩트 테이블에 권장됩니다. |
| 3 | 가속 코드가 있는 Data Factory | 스키마(DDL) 변환 | ADF/파이프라인 | 먼저 DDL(스키마)을 변환하고 마이그레이션한 다음 CETAS를 사용하여 데이터를 추출하고 COPY/Data Factory를 사용하여 최적의 전체 수집 성능을 위해 데이터를 수집합니다. |
| 4 | 저장 프로시저 가속 코드 | 스키마(DDL) 변환 데이터 추출 코드 평가 |
T-SQL | 작업하려는 작업을 보다 세부적으로 제어하는 IDE를 사용하는 SQL 사용자. COPY/Data Factory를 사용하여 데이터를 수집합니다. |
| 5 | Visual Studio Code용 SQL Database 프로젝트 확장 | 스키마(DDL) 변환 데이터 추출 코드 평가 |
SQL 프로젝트 | 옵션 4의 통합을 사용하여 배포할 SQL Database 프로젝트. COPY 또는 Data Factory를 사용하여 데이터를 수집합니다. |
| 6 | CETAS(CREATE EXTERNAL TABLE AS SELECT) | 데이터 추출 | T-SQL | 비용 효율적인 고성능 데이터를 ADLS(Azure Data Lake Storage) Gen2로 추출합니다. COPY/Data Factory를 사용하여 데이터를 수집합니다. |
| 7 | dbt를 사용하여 마이그레이션 | 스키마(DDL) 변환 DML(데이터베이스 코드) 변환 |
dbt | 기존 dbt 사용자는 dbt Fabric 어댑터를 사용하여 DDL 및 DML을 변환할 수 있습니다. 그런 다음 이 테이블의 다른 옵션을 사용하여 데이터를 마이그레이션해야 합니다. |
초기 마이그레이션을 위한 워크로드 선택
Synapse 전용 SQL 풀에서 Fabric Data Warehouse로 마이그레이션하는 프로젝트를 어디서 시작할지 결정할 때, 다음을 수행할 수 있는 워크로드 영역을 선택하세요:
- 새로운 환경의 이점을 신속하게 제공함으로써 Fabric Data Warehouse로의 이주 가능성을 입증하세요. 작고 단순하게 시작해서 여러 번의 작은 이동을 준비하세요.
- 사내 기술 담당자가 다른 영역으로 이전할 때 사용하는 프로세스 및 도구에 대한 관련 경험을 쌓을 수 있도록 시간을 허용하십시오.
- 원본 Synapse 환경과 현재 도구 및 프로세스와 관련된 추가 마이그레이션을 위한 템플릿을 만듭니다.
팁 (조언)
마이그레이션할 객체 목록을 만들고 마이그레이션 과정을 처음부터 끝까지 문서화하여 다른 전용 SQL 풀이나 워크로드에 대해서도 반복할 수 있도록 하세요.
초기 마이그레이션에서 마이그레이션된 데이터의 양은 Fabric Data Warehouse 환경의 기능과 이점을 입증할 만큼 충분히 크지만, 빠르게 가치를 입증할 만큼 크지 않아야 합니다. 1-10TB 범위의 크기가 일반적입니다.
Fabric Data Factory를 사용하여 마이그레이션
이 섹션에서는 Azure Data Factory와 Synapse 파이프라인에 익숙한 사용자를 위한 Data Factory 옵션을 설명합니다. 드래그 앤 드롭 인터페이스는 DDL을 변환하고 데이터를 마이그레이션하는 간단한 방법을 제공합니다.
Fabric Data Factory는 다음 작업을 수행할 수 있습니다.
- 스키마(DDL)를 Fabric Data Warehouse 문법으로 변환하세요.
- Fabric Data Warehouse에서 스키마(DDL)를 생성하세요.
- 데이터를 Fabric Data Warehouse로 이전하세요.
옵션 1. 스키마 및 데이터 마이그레이션 - 복사 데이터 어시스턴트 및 ForEach 복사 활동
이 방법은 Data Factory Copy data assistant를 사용하여 소스 전용 SQL 풀에 연결하고, 전용 SQL 풀의 DDL 문법을 Fabric로 변환하며, 데이터를 Fabric Data Warehouse로 복사합니다. 하나 이상의 대상 테이블을 선택할 수 있습니다(TPC-DS 데이터 세트의 경우 22개의 테이블이 있습니다). ForEach를 생성하여 UI에서 선택한 테이블 목록을 반복하고 22개의 병렬 복사 작업 스레드를 생성합니다.
- 지정된 SQL 풀에서 22
SELECT개의 쿼리(각 테이블당 하나씩)가 생성되어 실행됩니다. - 생성된 쿼리가 실행될 수 있도록 적절한 DWU와 리소스 클래스를 갖추었는지 확인하세요. 이 경우, 22개의 제출된 쿼리를 처리하기 위해서는 최대 32개의 쿼리를 허용하는 DWU1000 이상의
staticrc10이 필요합니다. - 전용 SQL 풀에서 데이터를 직접 복사하여 Data Factory로 Fabric Data Warehouse하는 데는 스테이징이 필요합니다. 섭취 과정은 두 단계로 나뉩니다:
- 첫 번째 단계는 전용 SQL 풀에서 데이터를 ADLS로 추출합니다. 이 단계를 스테이징이라고 합니다.
- 두 번째 단계는 단계화된 데이터를 Fabric Data Warehouse에 흡수합니다. 대부분의 섭취 시간은 스테이징 단계에서 이루어지므로, 스테이징은 성능에 상당한 영향을 미칩니다.
권장 사용
복사 어시스턴트를 사용해 ForEach 활동을 생성하면 DDL을 변환하고 전용 SQL 풀에서 선택한 테이블을 한 단계로 Fabric Data Warehouse으로 변환할 수 있는 간단한 인터페이스가 제공됩니다.
하지만 이 옵션은 최적의 전체 처리량을 제공하지는 않습니다. 스테이징과 소스에서 스테이지 단계까지의 읽기 및 쓰기 병렬화 필요성이 지연의 주요 원인입니다. 이 옵션은 치수 표에만 사용하세요.
옵션 2. DDL/데이터 마이그레이션 - 파티션 옵션을 이용한 파이프라인
Fabric 파이프라인에서 더 큰 팩트 테이블을 로드할 때 처리량을 높이기 위해 각 팩트 테이블에 복사 작업를 사용하고 파티션을 활성화하세요. 이 구성은 최고의 복사 작업 성능을 제공합니다.
소스 테이블의 물리적 파티션이 있으면 사용하세요. 테이블이 물리적으로 분할되어 있지 않다면, 파티션 열과 동적 분할을 위한 최소 및 최대 값을 지정하세요. 다음 스크린샷에서 파이프라인 소스 옵션은 열을 ws_sold_date_sk 기반으로 동적 파티션 범위를 지정합니다.

파티셔닝은 스테이징 처리량을 증가시킬 수 있습니다. 구성 시 다음 지침을 참고하세요:
- 파티션 범위에 따라 이 연산은 128개 이상의 쿼리를 생성하고 전용 SQL 풀의 모든 동시성 슬롯을 사용할 수 있습니다.
- 모든 쿼리가 실행될 수 있도록 최소 DWU6000으로 확장해야 합니다.
- 예를 들어 TPC-DS
web_sales테이블의 경우 163개의 쿼리가 전용 SQL 풀에 제출되었습니다. DWU6000 시점에 128건의 쿼리가 실행되고 35건의 쿼리가 대기열에 있었습니다. - 동적 파티션은 범위 파티션을 자동으로 선택합니다. 이 경우 전용 SQL 풀에 제출된 각 SELECT 쿼리에 대한 11일 범위입니다. 예를 들어:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
권장 사용
팩트 테이블의 경우, 처리량을 높이기 위해 파티션 옵션이 있는 Data Factory를 사용하세요.
하지만 병렬 읽기를 위해서는 추출 쿼리를 실행할 수 있도록 전용 SQL 풀을 더 높은 DWU로 확장해야 합니다. 분할 지정은 분할을 사용하지 않을 때보다 비율을 10배 향상시킵니다. 더 높은 처리량을 위해 DWU를 늘릴 수 있지만, 전용 SQL 풀은 최대 128개의 활성 쿼리를 허용합니다.
Synapse DWU에서 Fabric 매핑에 대한 자세한 내용은 블로그: 매핑 Azure Synapse 전용 SQL 풀 to Fabric Data Warehouse 컴퓨트를 참조하세요.
옵션 3. DDL 마이그레이션 - 복사 데이터 어시스턴트 각 복사 활동
앞서 언급한 두 가지 옵션은 소규모 데이터베이스에 적합합니다. 더 높은 처리량이 필요하다면 다음 대안을 사용하세요:
- 전용 SQL 풀에서 데이터를 ADLS로 추출하여 스테이징 오버헤드를 줄이세요.
- Data Factory나 COPY 명령어를 사용해 데이터를 웨어하우스로 인징하세요.
권장 사용
Data Factory를 계속 사용하여 DDL(스키마)을 변환할 수 있습니다. 복사 데이터 어시스턴트를 사용하면 특정 테이블 또는 모든 테이블을 선택할 수 있습니다. 설계상 이 방법은 쿼리 문에서 false 조건 TOP 0 을 사용하여 행 없이 스키마를 추출하여 한 단계로 스키마를 마이그레이션합니다.
다음 코드 샘플에서는 Data Factory를 사용한 DDL(스키마) 마이그레이션에 대해 설명합니다.
코드 예제: Data Factory를 사용하여 DDL(스키마) 마이그레이션
Fabric Pipelines를 사용하면 Azure SQL Database나 전용 SQL 풀 등 어떤 소스에서든 테이블 객체의 DDL(스키마)을 쉽게 마이그레이션할 수 있습니다. 이 파이프라인은 소스 전용 SQL 풀 테이블의 스키마(DDL)를 Fabric Data Warehouse으로 마이그레이션합니다.

파이프라인 디자인: 매개 변수
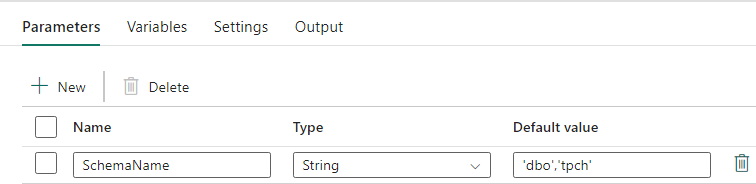
이 파이프라인은 어떤 스키마를 마이그레이션할지 지정하는 매개변수 SchemaName를 받습니다. 기본 스키마는 dbo입니다.
기본값 필드에 마이그레이션 할 스키마를 나타내는 쉼표로 구분된 테이블 스키마 목록을 입력합니다. 'dbo','tpch'에서는 dbo 및 tpch의 두 스키마를 제공합니다.
파이프라인 설계: 조회 활동
조회 작업을 만들고 원본 데이터베이스를 가리키도록 연결을 설정합니다.
설정 탭에서 다음을 수행합니다.
데이터 저장소 유형을 외부로 설정합니다.
연결은 해당 Azure Synapse 전용 SQL 풀입니다. 연결 유형은 Azure Synapse Analytics입니다.
쿼리 사용은 쿼리로 설정됩니다.
동적 표현식을 사용해 쿼리 필드를 구축하면, 쿼리에서 타겟 소스 테이블 목록을 반환하는 매개변수
SchemaName를 사용할 수 있습니다. 쿼리 를 선택한 후 동적 콘텐츠 추가를 선택하세요.조회 작업 내의 이 식은 시스템 보기를 쿼리하여 스키마 및 테이블 목록을 검색하는 SQL 문을 생성합니다. 이 모듈은 SQL 스키마에서 필터링을 가능하게 하기 위해 매개변수를
SchemaName참조합니다. 이 표현식의 출력은 ForEach Activity가 입력으로 사용하는 SQL 스키마와 테이블 배열입니다.다음 코드를 사용하여 스키마 이름이 있는 모든 사용자 테이블 목록을 반환합니다.
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')

파이프라인 설계: ForEach 루프
ForEach 루프의 경우 설정 탭에서 다음 옵션을 구성합니다.
- 여러 반복이 동시에 실행되도록 순 차(Sequential )를 비활성화하세요.
-
일괄 처리 수를
50으로 설정하여 최대 동시 반복 횟수를 제한합니다. -
Items(항목) 필드에서 동적 콘텐츠를 사용하여 LookUp Activity의 출력을 참조하세요. 다음 코드 조각을 사용하세요:
@activity('Get List of Source Objects').output.value

파이프라인 디자인: ForEach Loop 내의 복사 작업
ForEach 작업 내에 복사 작업을 추가합니다. 이 방법은 파이프라인 내 동적 표현 언어를 사용하여 데이터 없이 스키마만 웨어하우스로 마이그레이션하는 문장을 만듭니다 SELECT TOP 0 * FROM <TABLE> .
원본 탭에서:
- 데이터 저장소 유형을 외부로 설정합니다.
- 연결은 해당 Azure Synapse 전용 SQL 풀입니다. 연결 유형은 Azure Synapse Analytics입니다.
- 쿼리 사용을 쿼리로 설정합니다.
-
쿼리 필드에서 동적 콘텐츠 쿼리를 붙여넣고 이 표현식을 사용하세요. 이 표현식은 0행을 반환하지만 테이블 스키마를 포함합니다:
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)

대상 탭에서:
- 데이터 저장소 유형을 작업 영역으로 설정합니다.
- Workspace 데이터 저장소 타입을 Data Warehouse로 설정하고, Data Warehouse를 웨어하우스로 설정하세요.
- 대상 테이블의 스키마 및 테이블 이름은 동적 콘텐츠를 사용하여 정의됩니다.
- 스키마는 현재 반복의 필드를 가리키며,
SchemaName스니펫은 다음과 같습니다:@item().SchemaName - 스니펫이 포함된 표 참고
TableName문헌:@item().TableName
- 스키마는 현재 반복의 필드를 가리키며,

파이프라인 디자인: 싱크
싱크의 경우 웨어하우스를 가리키고 원본 스키마 및 테이블 이름을 참조합니다.
이 파이프라인을 실행하면, 소스의 각 테이블이 올바른 스키마를 사용해 웨어하우스에 채워진 것을 볼 수 있습니다.
Synapse 전용 SQL 풀에서 저장 프로시저를 이용한 마이그레이션
이 옵션은 저장 프로시저를 사용하여 Fabric Data Warehouse로의 마이그레이션을 수행합니다.
GitHub.com의 microsoft/fabric-migration에서 코드 샘플을 가져올 수 있습니다. 이 코드는 오픈 소스로 공유되므로 자유롭게 공동 작업하고 커뮤니티에 도움을 줄 수 있습니다.
Fabric 마이그레이션 저장 프로시저가 할 수 있는 일:
- 스키마(DDL)를 Fabric Data Warehouse 문법으로 변환하세요.
- Fabric Data Warehouse에서 스키마(DDL)를 생성하세요.
- Synapse 전용 SQL 풀에서 ADLS로 데이터를 추출합니다.
- T-SQL 코드(저장 프로시저, 함수, 뷰)에 대해 지원되지 않는 Fabric 문법을 플래그로 표시하세요.
권장 사용
이 옵션은 다음과 같은 경우에 매우 유용합니다:
- T-SQL에 익숙합니다.
- T-SQL 개발을 위한 통합 개발 환경을 사용하고 싶습니다.
- 어떤 작업을 하는지 더 세밀하게 통제하고 싶습니다.
DDL(스키마) 변환, 데이터 추출 또는 T-SQL 코드 평가에 대한 특정 저장 프로시저를 실행할 수 있습니다.
데이터 마이그레이션을 위해서는 COPY INTO나 Fabric Data Factory를 사용해 데이터를 웨어하우스로 인징하세요.
SQL 데이터베이스 프로젝트를 사용하여 마이그레이션
Fabric Data Warehouse Visual Studio Code 내에서 제공되는 SQL Database Projects 확장을 지원합니다.
이 확장은 Visual Studio Code 내에서 사용할 수 있습니다. 이 기능을 사용하면 소스 제어, 데이터베이스 테스트 및 스키마 유효성 검사 기능을 사용할 수 있습니다.
소스 제어에 대한 자세한 내용은 개발 및 배포 개요를 참조하세요.
권장 사용
SQL Database Project를 배포에 사용하고 싶다면 이 옵션을 사용하세요. 이 옵션은 Fabric 마이그레이션 저장 프로시저를 SQL 데이터베이스 프로젝트에 통합하여 원활한 마이그레이션 경험을 제공합니다.
SQL Database 프로젝트에서는 다음을 수행할 수 있습니다.
- 스키마(DDL)를 Fabric Data Warehouse 문법으로 변환하세요.
- Fabric Data Warehouse에서 스키마(DDL)를 생성하세요.
- Synapse 전용 SQL 풀에서 ADLS로 데이터를 추출합니다.
- T-SQL 코드(저장 프로시저, 함수, 보기)에 대해 지원되지 않는 구문에 플래그를 지정합니다.
데이터 마이그레이션은 COPY INTO 나 Data Factory를 사용해 웨어하우스에 데이터를 인징하세요.
Microsoft Fabric CAT 팀은 SQL 데이터베이스 프로젝트를 통해 스키마(DDL)와 데이터베이스 코드(DML)를 추출, 생성, 배포하는 PowerShell 스크립트를 제공합니다. 공략은 GitHub의 microsoft/fabric-migration을 참고하세요.
SQL Database 프로젝트에 대한 자세한 내용은 명령줄에서 SQL Database 프로젝트 확장 시작 및 데이터베이스 프로젝트 빌드를 참조하세요.
CETAS를 사용하여 데이터 마이그레이션
T-SQL CREATE EXTERNAL TABLE AS SELECT (CETAS) 명령어는 Azure Synapse 전용 SQL 풀에서 Azure Data Lake Storage (ADLS) Gen2로 데이터를 추출하는 가장 비용 효율적이고 최적의 방법을 제공합니다.
CETAS에서 수행할 수 있는 작업은 다음과 같습니다.
- 데이터를 ADLS로 추출합니다.
- 이 옵션은 데이터를 수집하기 전에 웨어하우스에서 스키마(DDL)를 생성해야 합니다. 이 문서의 옵션을 사용하여 DDL(스키마)을 마이그레이션합니다.
이 옵션의 장점은 다음과 같습니다.
- 마이그레이션은 소스 Synapse 전용 SQL 풀에 대해 각 테이블당 단 하나의 쿼리만 제출합니다. 이 쿼리는 모든 동시성 슬롯을 사용하지 않으며, 동시 고객 생산 ETL이나 쿼리를 차단하지도 않습니다.
- 각 테이블마다 단일 동시성 슬롯만 사용하므로 DWU6000 확장할 필요가 없으므로 더 낮은 DWU를 사용할 수 있습니다.
- 추출은 모든 컴퓨팅 노드에서 병렬로 실행되며, 이 기능은 성능을 향상시킵니다.
권장 사용
CETAS를 사용하여 데이터를 Parquet 파일 형식으로 ADLS에 저장합니다. 파켓 파일은 네트워크 전반에 걸리는 대역폭이 적은 열식 압축과 효율적인 데이터 저장 능력을 제공합니다. Fabric은 데이터를 델타 파켓 형식으로 저장하기 때문에, 데이터 인제스는 텍스트 파일 형식에 비해 2.5배 빠릅니다. 이는 인제스 시 델타 포맷으로 변환하는 오버헤드가 없기 때문입니다.
CETAS 처리량을 늘리려면 다음을 수행합니다.
- 병렬 CETAS 작업을 추가하여 동시성 슬롯의 사용을 늘리면서 더 많은 처리량을 허용합니다.
- Synapse 전용 SQL 풀에서 DWU 크기를 조정합니다.
dbt를 통한 마이그레이션
이 섹션에서는 이미 Synapse 전용 SQL 풀 환경에서 dbt를 사용하는 고객을 위한 dbt 옵션을 설명합니다.
dbt가 수행할 수 있는 작업:
- 스키마(DDL)를 Fabric Data Warehouse 문법으로 변환하세요.
- Fabric Data Warehouse에서 스키마(DDL)를 생성하세요.
- DML(데이터베이스 코드)을 Fabric 구문으로 변환합니다.
dbt 프레임워크는 실행될 때마다 DDL 및 DML(SQL 스크립트)을 즉시 생성합니다. DBT는 모델 파일을 문장으로 SELECT 표현하여 프로필(연결 문자열)과 어댑터 유형을 변경하여 DDL/DML을 즉시 어떤 대상 플랫폼에도 변환합니다.
권장 사용
DBT 프레임워크는 코드 우선 접근법을 사용합니다. CETAS 또는 COPY/Data Factory와 같은 이 문서에 나열된 옵션을 사용하여 데이터를 마이그레이션하세요.
Microsoft Fabric Data Warehouse용 dbt 어댑터를 사용하면 Azure Synapse 전용 SQL 풀, Snowflake, Databricks, Google BigQuery, Amazon Redshift 등 다양한 플랫폼을 대상으로 하는 기존 dbt 프로젝트를 간단한 설정 변경으로 웨어하우스로 이전할 수 있습니다.
Fabric Data Warehouse를 대상으로 하는 DBT 프로젝트를 시작하려면 튜토리얼: Fabric Data Warehouse DBT 설정 과정을 참고하세요. 이 문서에는 서로 다른 창고와 플랫폼 간 이동 옵션도 명시되어 있습니다.
Fabric Data Warehouse로의 데이터 수집
Fabric Data Warehouse로 데이터를 수집하려면 선호에 따라 COPY INTO 또는 Fabric Data Factory를 사용하세요. 두 방법 모두 파일이 이미 Azure Data Lake Storage(ADLS) Gen2로 추출되어야 한다는 전제 조건을 감안할 때, 동일한 성능 처리량을 가지므로 권장되고 성능이 가장 우수한 선택입니다.
다음 요소들을 고려하여 최대 성능을 위해 프로세스를 설계하세요:
- Fabric 사용하면 ADLS에서 Fabric Data Warehouse로 여러 테이블을 동시에 불러올 때 자원 충돌이 없습니다. 따라서 병렬 스레드를 로드할 때 성능이 저하되지 않습니다. 최대 인제스 처리량은 Fabric 용량의 컴퓨팅 파워에만 제한됩니다.
- Fabric 워크로드 관리는 부하 및 쿼리에 할당된 리소스의 분리를 제공합니다. 쿼리와 데이터 로딩이 동시에 실행되는 동안 자원 충돌이 없습니다.