적용 대상:✅ Microsoft Fabric의 SQL 분석 엔드포인트 및 웨어하우스
중요합니다
이 기능은 프리뷰 상태입니다.
Fabric Data Warehouse의 데이터 클러스터링에서는 더 빠른 쿼리 성능과 컴퓨팅 사용량을 줄이기 위해 데이터를 구성합니다. 이 자습서에서는 클러스터형 테이블 만들기에서 효과 확인에 이르기까지 데이터 클러스터링을 사용하여 테이블을 만드는 단계를 안내합니다.
필수 조건
- 구독이 활성 상태인 Microsoft Fabric 테넌트 계정.
- Microsoft Fabric 사용 작업 영역: 작업 영역 만들기가 있는지 확인합니다.
- 웨어하우스를 이미 만들었는지 확인합니다. 새 웨어하우스를 만들려면 Microsoft Fabric에서 웨어하우스 만들기를 참조하세요.
- T-SQL 및 데이터 쿼리에 대한 기본적인 이해
샘플 데이터 가져오기
이 자습서에서는 NY Taxi 샘플 데이터 집합을 사용합니다. NY Taxi 데이터를 웨어하우스로 가져오려면 샘플 데이터를 데이터 웨어하우스로 로드하는 자습서를 사용하십시오.
데이터 클러스터링이 포함된 테이블 생성
이 자습서에서는 NYTaxi 테이블의 두 복사본, 즉 자습서에서 가져온 테이블의 일반 복사본과 데이터 클러스터링을 사용하는 복사본이 필요합니다. 다음 명령을 사용하여 원래 NYTaxi 테이블을 기반으로 하여 CREATE TABLE AS SELECT (CTAS)를 사용해 새 테이블을 만드십시오.
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
비고
이 예제에서는 데이터 웨어하우스에 샘플 데이터 로드 자습서에서 NY Taxi 데이터 세트에 지정된 테이블 이름을 가정합니다. 다른 이름을 테이블에 사용한 경우, 명령에서 nyctlc을(를) 테이블 이름으로 바꾸십시오.
이 명령은 원래 NYTaxi 테이블의 정확한 복사본을 만듭니다. 그러나 데이터는 lpepPickupDatetime 열을 기준으로 클러스터링됩니다. 다음으로 쿼리에 이 열을 사용합니다.
쿼리 데이터
NYTaxi 테이블에서 쿼리를 실행하고 비교를 위해 NYTaxi_With_DataClustering 테이블에서 정확히 동일한 쿼리를 반복합니다.
비고
이 분석을 위해 패브릭 데이터 웨어하우스의 캐싱 기능을 사용하지 않고 두 실행의 콜드 캐시 성능을 살펴보는 것이 좋습니다. 따라서 Query Insights에서 결과를 보기 전에 각 쿼리를 정확히 한 번 실행합니다.
웨어하우스에서 자주 반복되는 쿼리를 사용합니다. 이 쿼리는 2008-12-31 및 2014-06-30 날짜 사이의 연도별 평균 운임 금액을 계산합니다.
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
비고
이 쿼리에 사용되는 레이블 옵션은 나중에 Regular를 사용하여 데이터 클러스터링을 사용하는 쿼리 세부 정보와 테이블의 쿼리 세부 정보를 비교할 때 유용합니다.
다음으로 정확히 동일한 쿼리를 반복하지만 데이터 클러스터링을 사용하는 테이블 버전에서는 다음을 수행합니다.
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
두 번째 쿼리는 레이블 Clustered 을 사용하여 나중에 Query Insights를 사용하여 이 쿼리를 식별할 수 있도록 합니다.
데이터 클러스터링의 효과 확인
클러스터링을 설정한 후 Query Insights를 사용하여 그 효과를 평가할 수 있습니다. Fabric Data Warehouse의 Query Insights는 기록 쿼리 실행 데이터를 캡처하고 장기 실행 또는 자주 실행되는 쿼리 식별과 같은 실행 가능한 인사이트로 집계합니다.
이 경우 Query Insights를 사용하여 일반 사례와 클러스터형 사례 간에 검색된 데이터의 차이를 비교합니다.
다음 쿼리를 사용합니다.
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
이 쿼리는 exec_requests_history 보기에서 정보를 가져옵니다. 자세한 내용은 queryinsights.exec_requests_history(Transact-SQL)를 참조하세요.
쿼리는 다음과 같은 방법으로 결과를 필터링합니다.
- 명령 이름에 텍스트가 포함된
NYTaxi행만 페치합니다(테스트 쿼리에서 사용된 대로). - 레이블 값이 일반 또는 클러스터형인 행만 가져옵니다.
비고
쿼리 세부 정보를 Query Insights에서 사용할 수 있게 되는 데 몇 분 정도 걸릴 수 있습니다. Query Insights 쿼리가 결과를 반환하지 않는 경우 몇 분 후에 다시 시도합니다.
이 쿼리를 실행하면 다음과 같은 결과가 표시됩니다.

두 쿼리 모두 6개의 행 수와 유사한 제출 시간을 갖습니다. 쿼리는 Clustered 1794, total_elapsed_time_ms 1676 및 allocated_cpu_time_ms 77.519를 보여줍니다data_scanned_remote_storage_mb. 쿼리는 2651개의 Regular, 2600개의 total_elapsed_time_ms, 177.700개의 allocated_cpu_time_ms를 보여줍니다. 이러한 숫자는 두 쿼리가 동일한 결과를 Clustered 반환하더라도 버전이 버전보다 Regular 약 36% CPU 시간을 적게 사용하고 디스크에서 약 56% 더 적은 데이터를 스캔했음을 보여 줍니다. 두 쿼리 실행에서 캐시가 사용되지 않았습니다. 이는 쿼리 실행 시간과 사용량을 줄이고 열을 데이터 클러스터링의 lpepPickupDatetime 강력한 후보로 만드는 데 도움이 되는 중요한 결과입니다.
비고
이 테이블은 약 7,600만 개의 행과 2GB의 데이터 볼륨을 가진 작은 테이블입니다. 이 쿼리는 집계에서 6개의 행만 반환하지만(범위에서 매년 하나씩) 결과를 집계하기 전에 제공된 날짜 범위에서 약 830만 개의 행을 검색합니다. 데이터 볼륨이 큰 실제 프로덕션 데이터는 더 중요한 결과를 제공할 수 있습니다. 결과는 쿼리 중에 용량 크기, 캐시된 결과 또는 동시성에 따라 달라질 수 있습니다.
작업 부하에서 클러스터링 열을 선택하세요
생산 테이블의 경우, 어떤 열을 클러스터링할지 추측하는 대신 관찰된 쿼리 패턴을 사용하세요. 이 기술의 sqldw-cli 연산 기능은 쿼리 인사이트 이력을 분석하고, 원격 스캔한 데이터를 기준으로 반복 쿼리 패턴을 순위 매기며, 술어에 사용되는 WHERE 열을 식별합니다.
시작하기 전에 Skills for Fabric을 설치하고, 창고에 최근 쿼리 활동이 있는지 확인하며, 기여자 작업 공간 역할 이상인지 확인하세요. 그 다음 GitHub Copilot CLI를 열고 다음과 같은 프롬프트를 사용하세요:
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
이 스킬은 스캔에 가장 큰 영향을 미치는 쿼리 패턴을 식별하고, 해당 쿼리에서 테이블과 필터 열을 추출하며, 클러스터링 후보를 순위 매깁니다. 권고사항을 다음 지침에 따라 검토하세요:
- 큰 표를 반복적으로 필터링하고 날짜나 식별자 같은 중간에서 높은 카디널리티 값을 사용하는 열을 선호합니다.
-
WHERE절의 선택도가 높은 범위 또는 동등 조건자에 사용되는 열을 우선적으로 선택하세요. - 열이 동등 조인 조건에 나타난다고 해서 열을 선택하지 마세요. 이러한 조건들은 데이터 클러스터링의 이점을 얻지 못합니다.
- 클러스터링 열은 최대 4개를 사용하지 않고, 작업량이 요구하는 열을 초과하지 마세요.
예를 들어, 전자상거래 창고에서 Sales.SalesOrder에는 15억 개의 행이 있고 Sales.OrderLine에는 60억 개의 행이 있는 경우를 생각해 봅시다. 반복되는 질문을 분석한 후, 해당 기술은 다음과 같은 추천을 반환할 수 있습니다:
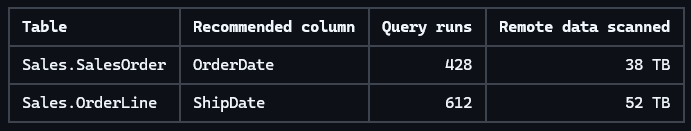
날짜 열은 가장 큰 테이블을 필터링하고 일반적인 범위 조건을 지원하며 OrderStatus 또는 SalesRegion와 같은 낮은 카디널리티의 열보다 파일을 건너뛸 수 있는 기회를 더 많이 제공하므로 유력한 후보입니다.
sqldw-cli 연산 기능은 읽기 전용입니다. 열을 추천하지만 테이블을 생성하거나 대체하지는 않습니다. 권고안을 검토한 후에는 CTAS를 사용해 테이블의 클러스터 복사본을 생성하세요:
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
클러스터 워크로드와 비클러스터 워크로드를 비교하여 효과를 검증하세요. 클러스터 테이블을 검증한 후에는 원래 테이블의 이름을 바꾸고, 클러스터 테이블의 이름을 원래 이름으로 바꾸세요:
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
원본 표는 롤백할 수 있도록 Sales.SalesOrder_old로 계속 사용할 수 있습니다. 원래 테이블을 제거하기 전에 의존 작업 부하와 새 테이블을 확인하세요. 롤백 사본이 더 이상 필요하지 않을 때는 다음과 같이 삭제하세요:
DROP TABLE Sales.SalesOrder_old;