GenAIOps를 구현하는 사용 가능한 도구 및 프레임워크 살펴보기
Tip
자세한 내용은 텍스트 및 이미지 탭을 참조하세요.
지금까지 Adventure Works 팀은 아웃도어 기어 웹사이트에서 쇼핑객의 질문에 답하는 어시스턴트인 에이전트를 계획하고 설계했습니다. 그들에게 아직 없는 것은 제대로 작동하고 신뢰할 수 있는 서비스이며, 거기에 이르기까지는 각 단계에 맞는 적절한 도구가 필요합니다.
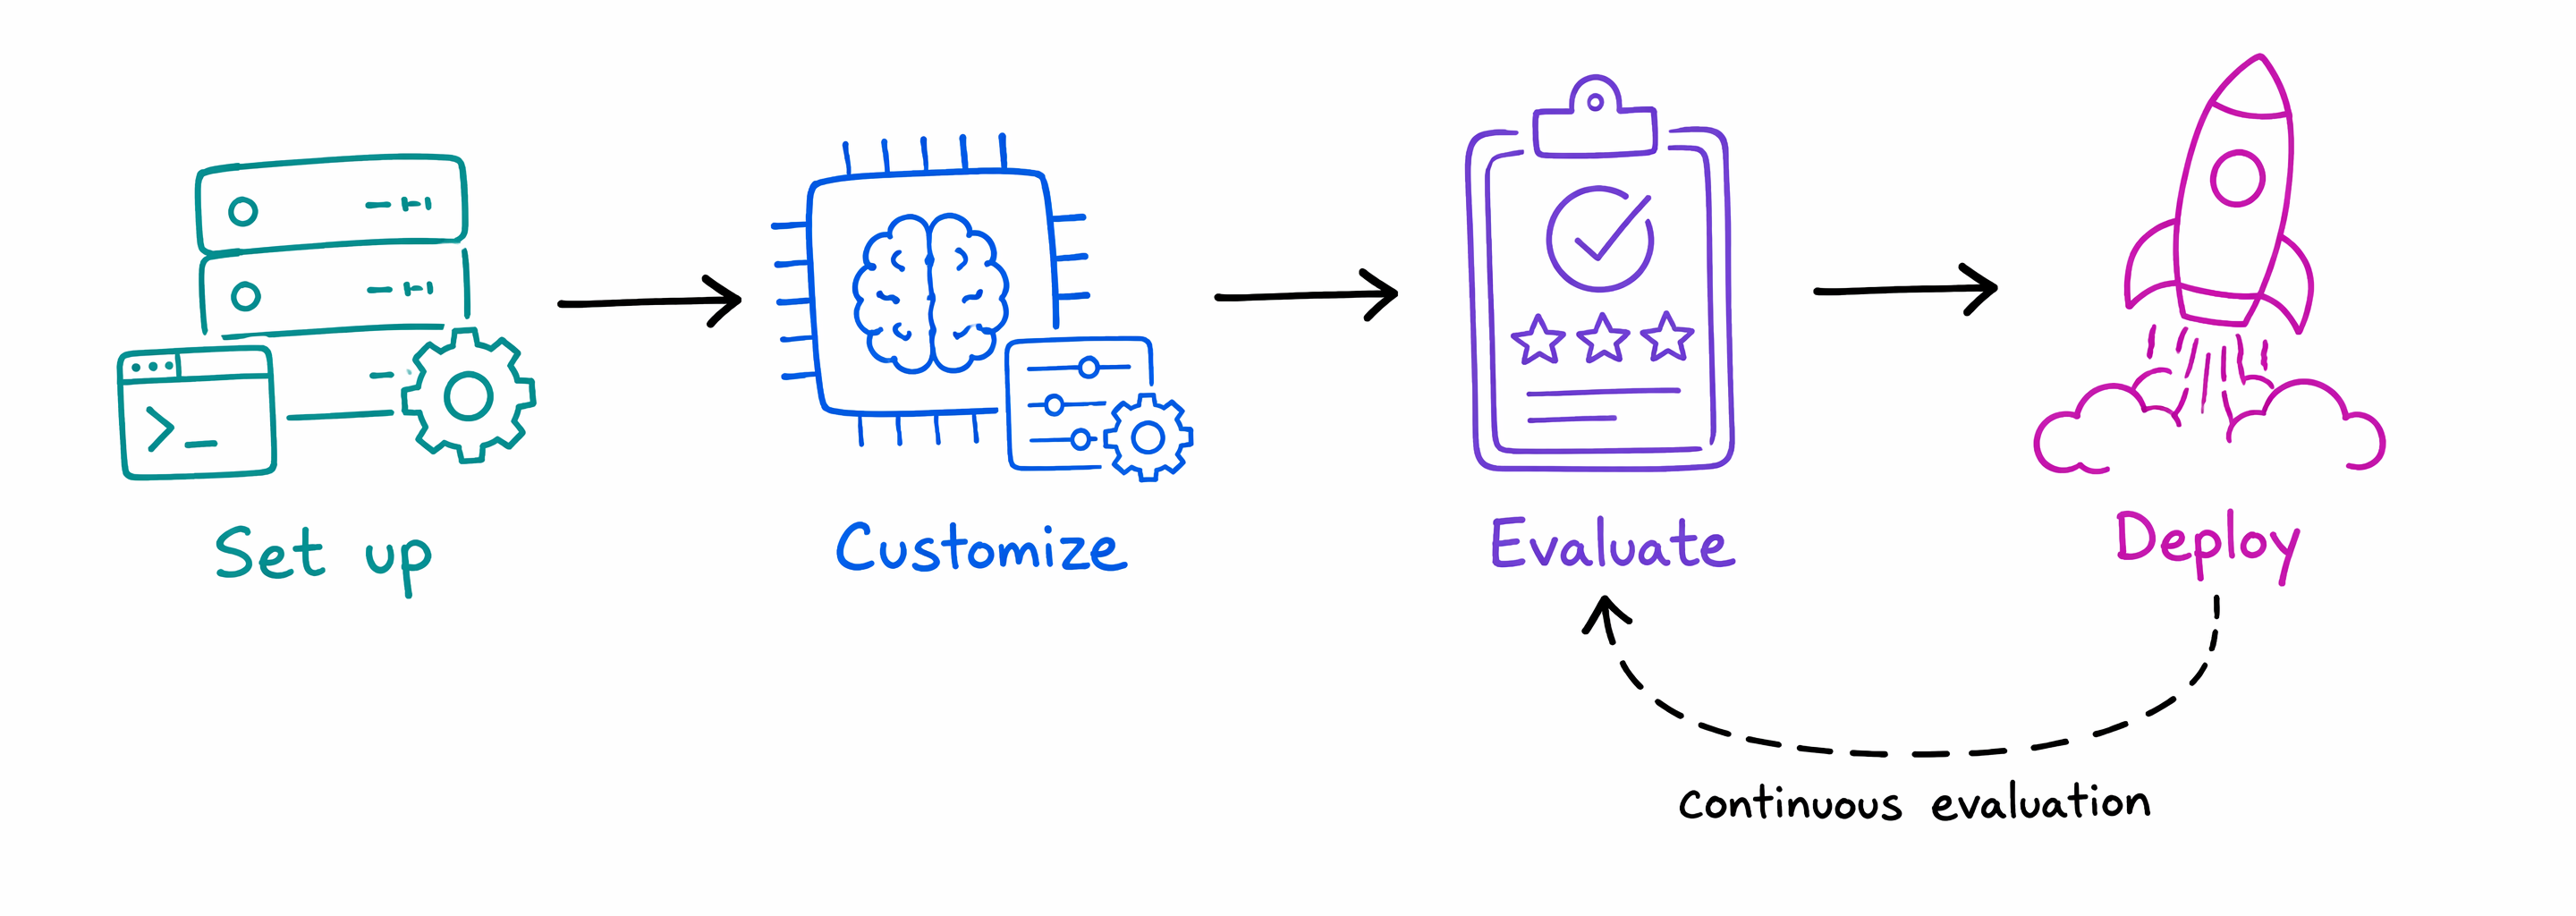
환경 설정, 모델 사용자 지정, 답변 평가, 프로덕션에 배포 등 네 단계로 진행됩니다. 에이전트가 각 단계를 수행하도록 돕는 도구는 다음과 같습니다.
환경 설정
팀이 무엇이든 빌드하기 전에 작업할 장소가 필요합니다. 서비스 및 구성은 느리고 오류가 발생하기 쉽기 때문에 Adventure Works는 미리 빌드된 AI 앱 템플릿과 함께 Azure 개발자 CLI(azd)를 사용하여 몇 가지 명령에 필요한 모든 것을 프로비전하고 배포합니다.
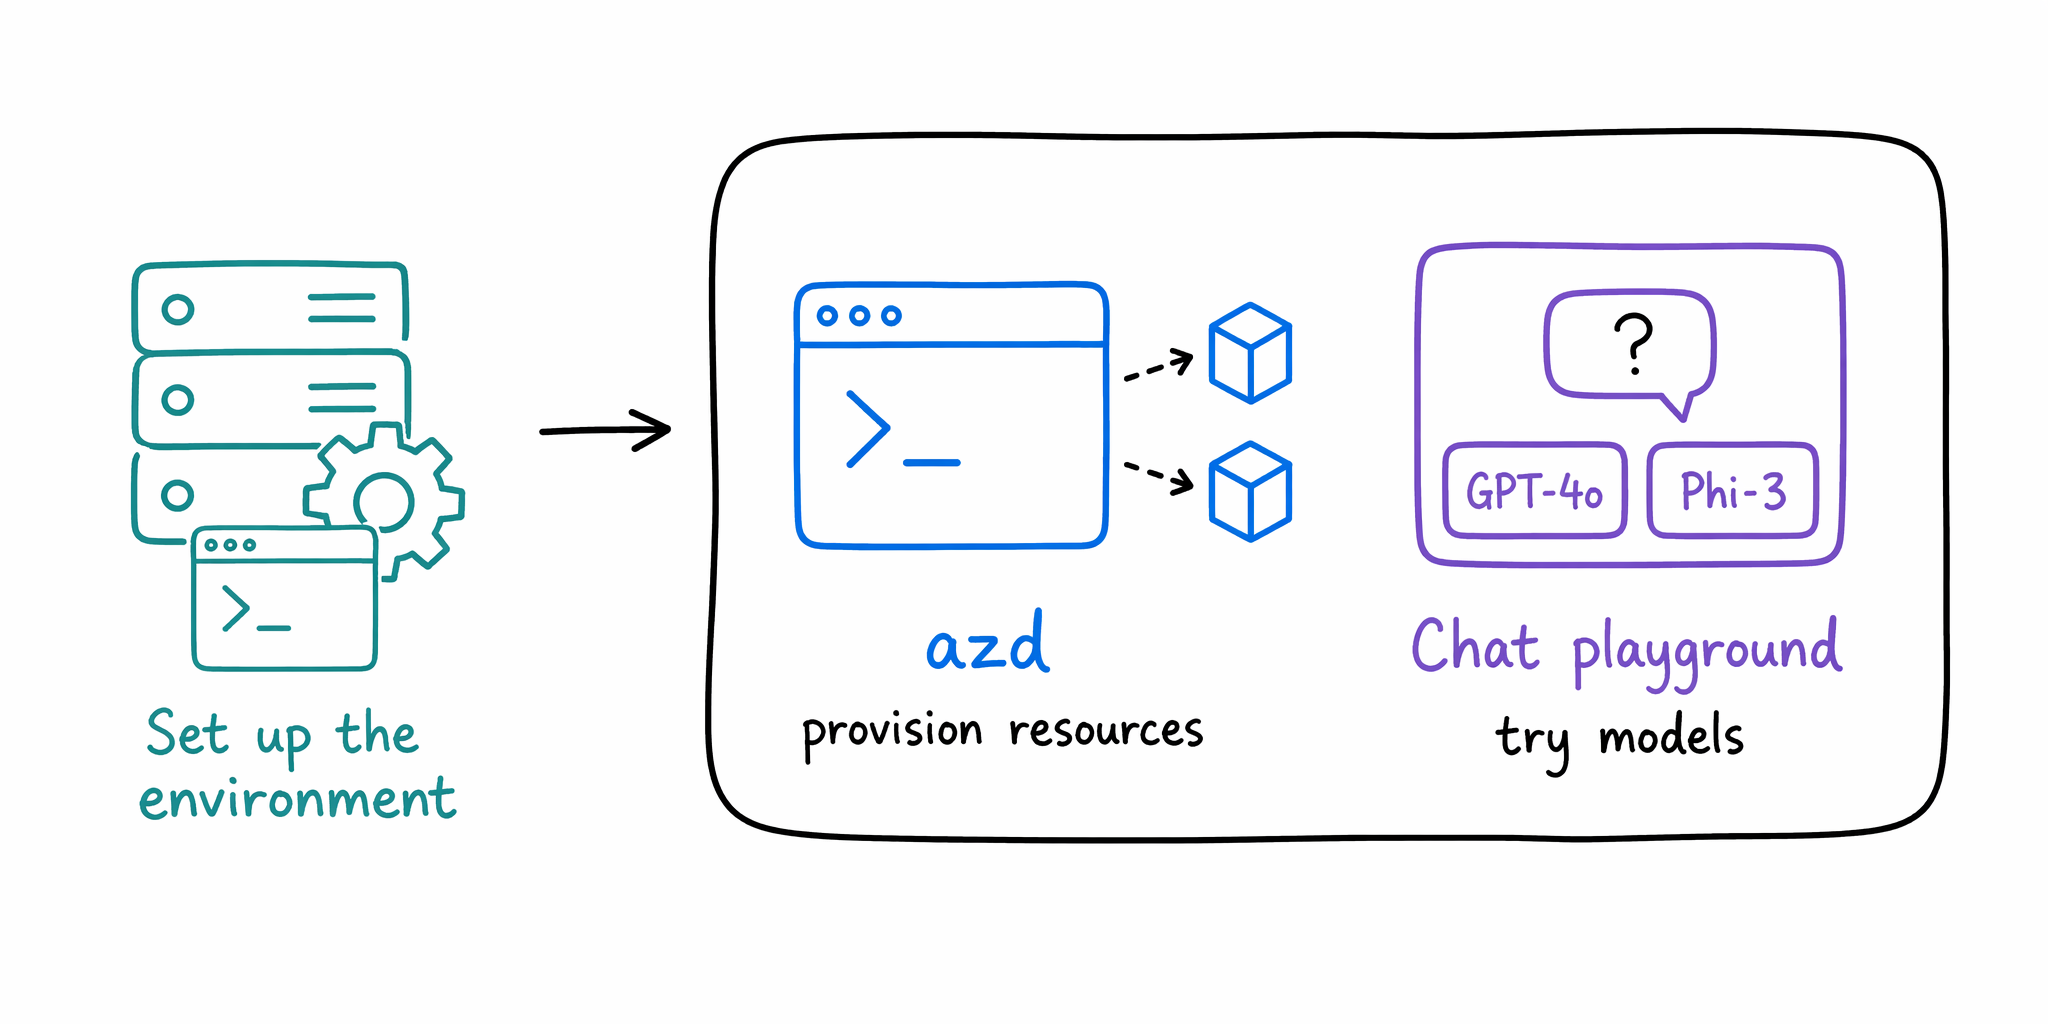
환경이 준비되면 Microsoft Foundry에서 모델을 탐색합니다. Foundry 포털에서 채팅 플레이그라운드를 열고 실제 쇼핑객의 질문인 "어떤 텐트가 겨울 캠핑에 적합한가요?"를 여러 모델에 던져, 최종 결정하기 전에 어떤 모델이 가장 자연스럽게 답하는지 확인합니다.
모델 사용자 지정
기본 모델은 세계에 대해 많이 알고 있지만 Adventure Works의 현재 인벤토리에 대해서는 아무것도 알지 못합니다. 팀은 그 격차를 두 가지 방법으로 닫습니다. 검색 증강 생성(RAG)을 사용하면 에이전트가 실시간 제품 카탈로그를 검색하고 찾은 정보를 바탕으로 응답할 수 있으므로, 추천은 항상 재고 현황을 반영합니다. Azure AI 검색 통해 관리되는 권한 인식 지식 계층인 Foundry IQ를 기반으로 하며, Microsoft Fabric Eventhouse에 포함을 저장하고 검색할 수 있습니다. 반면 미세 조정은 이전 지원 채팅과 같은 예시를 바탕으로 모델을 학습시켜 브랜드의 친근한 어조가 일관되게 반영되도록 하며, 서버리스 미세 조정은 이를 인프라를 관리할 필요 없이 수행합니다. Adventure Works는 RAG를 활용하여 신선함과 풍부한 음색을 섬세하게 다듬습니다.
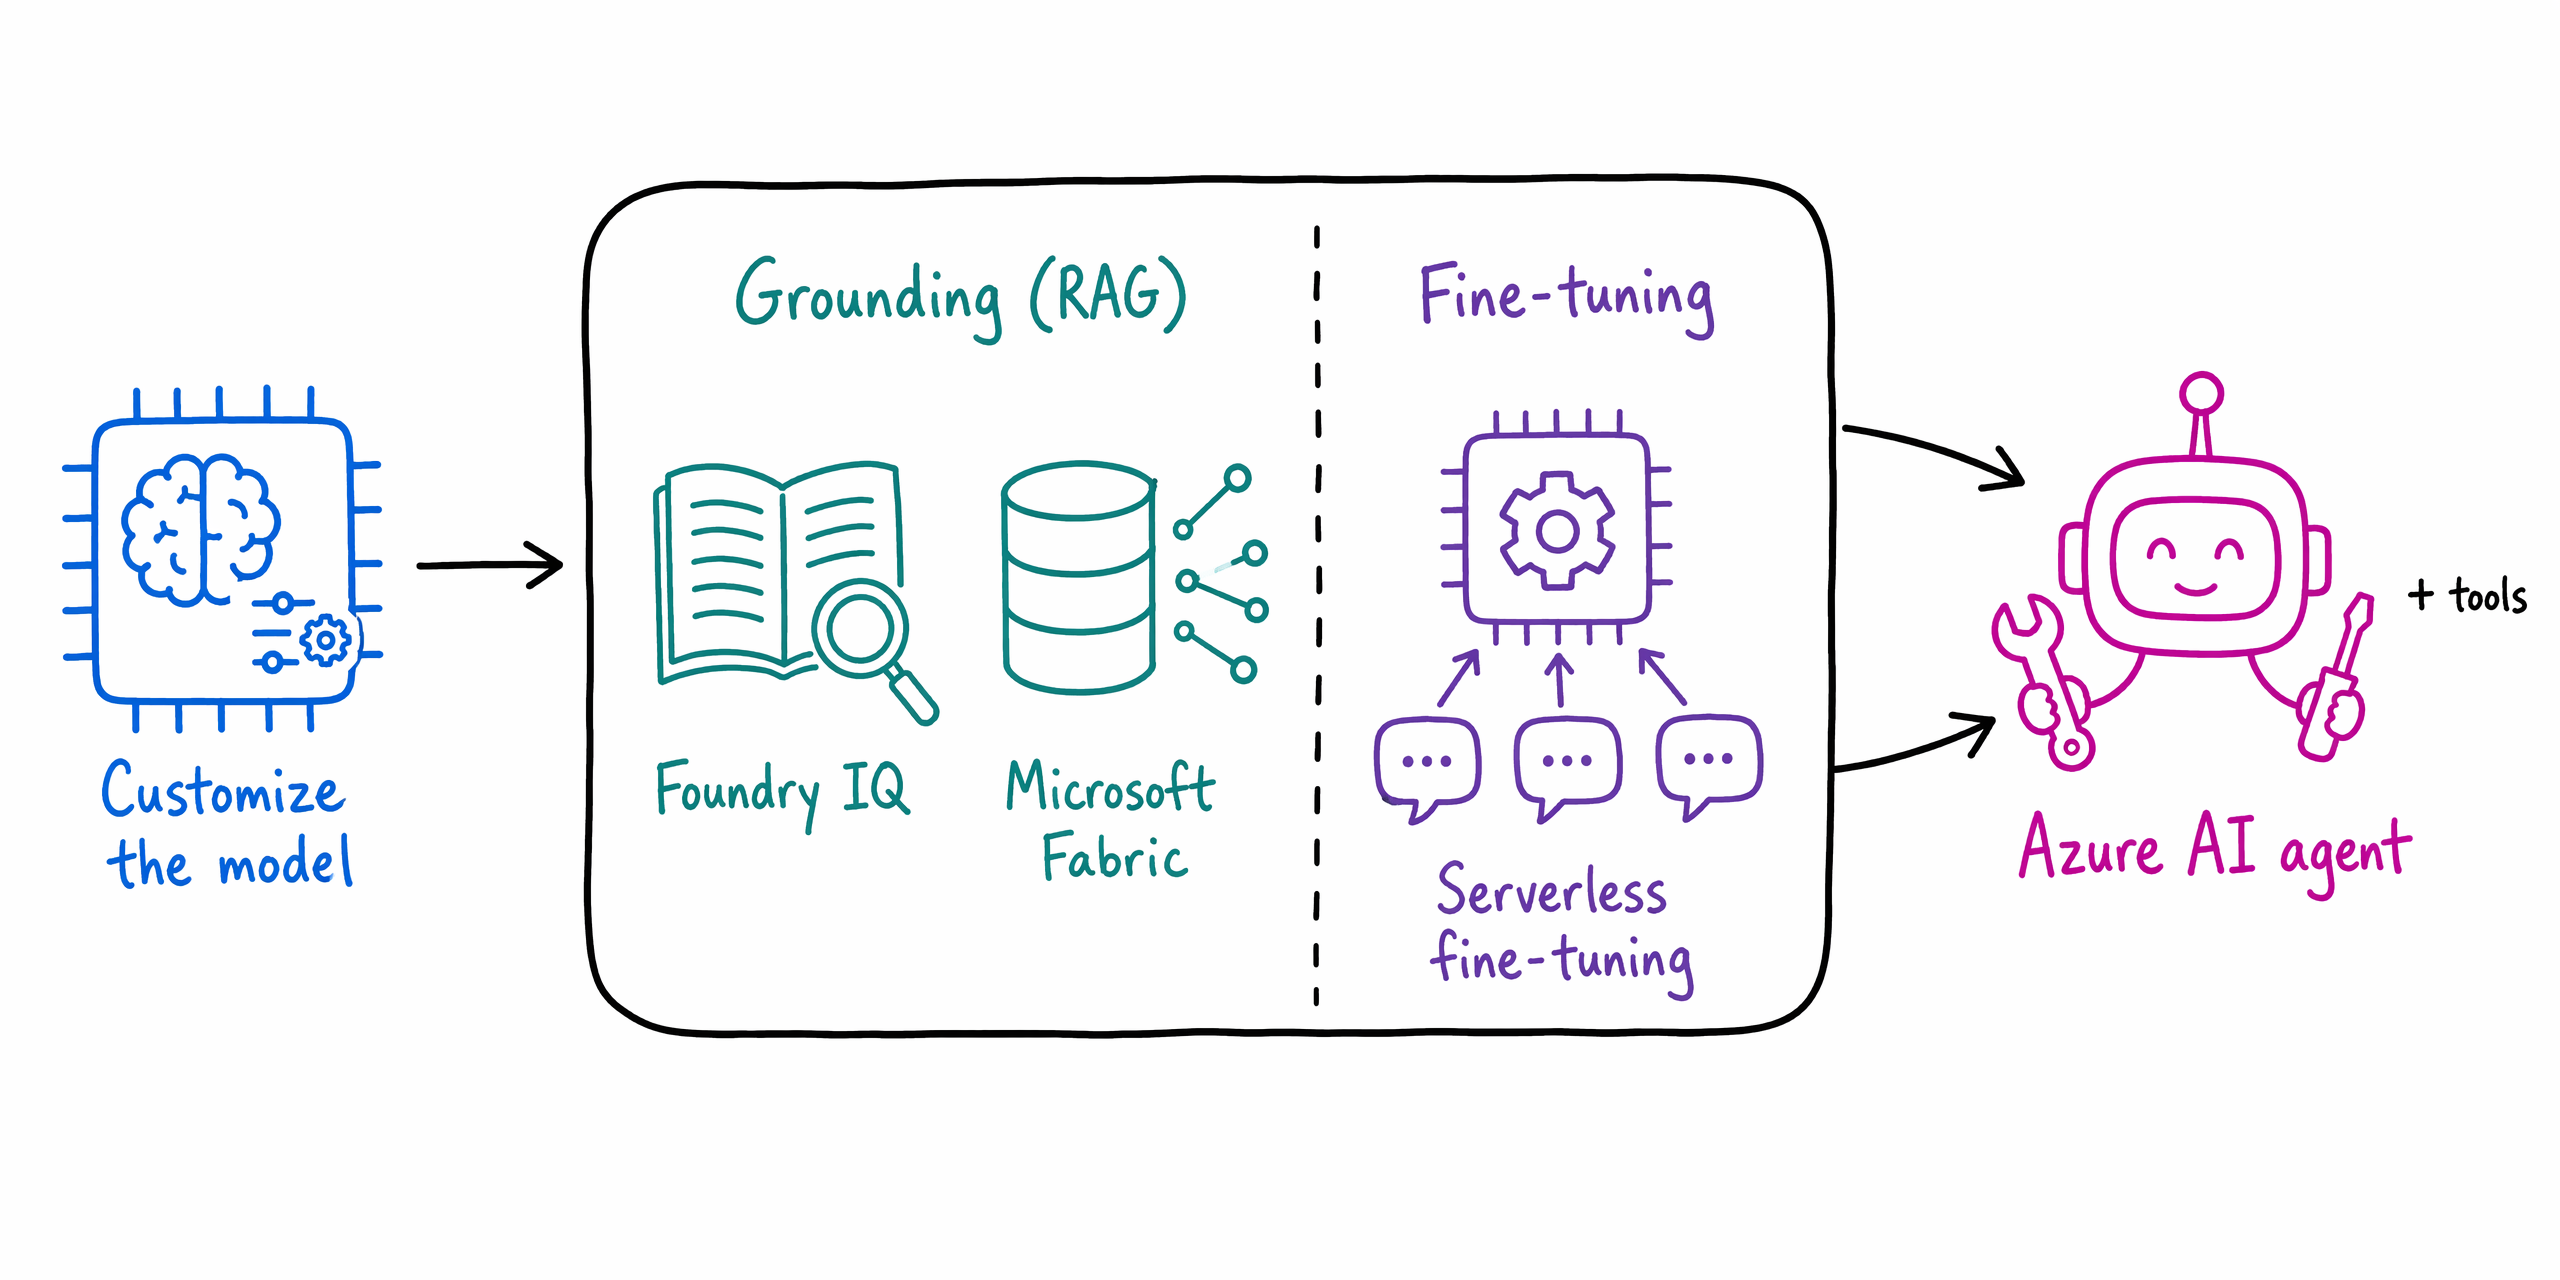
이들은 경쟁 관계가 아니라 상호 보완적입니다. 이러한 답변에 따라 작업하기 위해 팀은 모델을 Azure AI 에이전트로 래핑합니다. 에이전트는 RAG로 회신을 근거로 하고, 미세 조정된 모델에서 실행되며, 카탈로그 검색 및 구매 기록과 같은 도구를 호출하므로 쇼핑객을 대신하여 장비를 추천하고 비교할 수 있습니다. 사용자 지정된 에이전트는 여전히 잘 응답한다는 증거가 필요합니다. 이것이 바로 평가가 제공하는 것입니다.
답변 평가
에이전트가 라이브로 전환되기 전에 Adventure Works는 루브릭에 대한 답변을 채점합니다. 이 가이드는 관련성이 있고 실제 제품 데이터에 근거를 두고 톤이 친숙할 때와 같이 좋은 응답이 어떻게 표시되는지 설명하는 점수 매기기 가이드입니다.
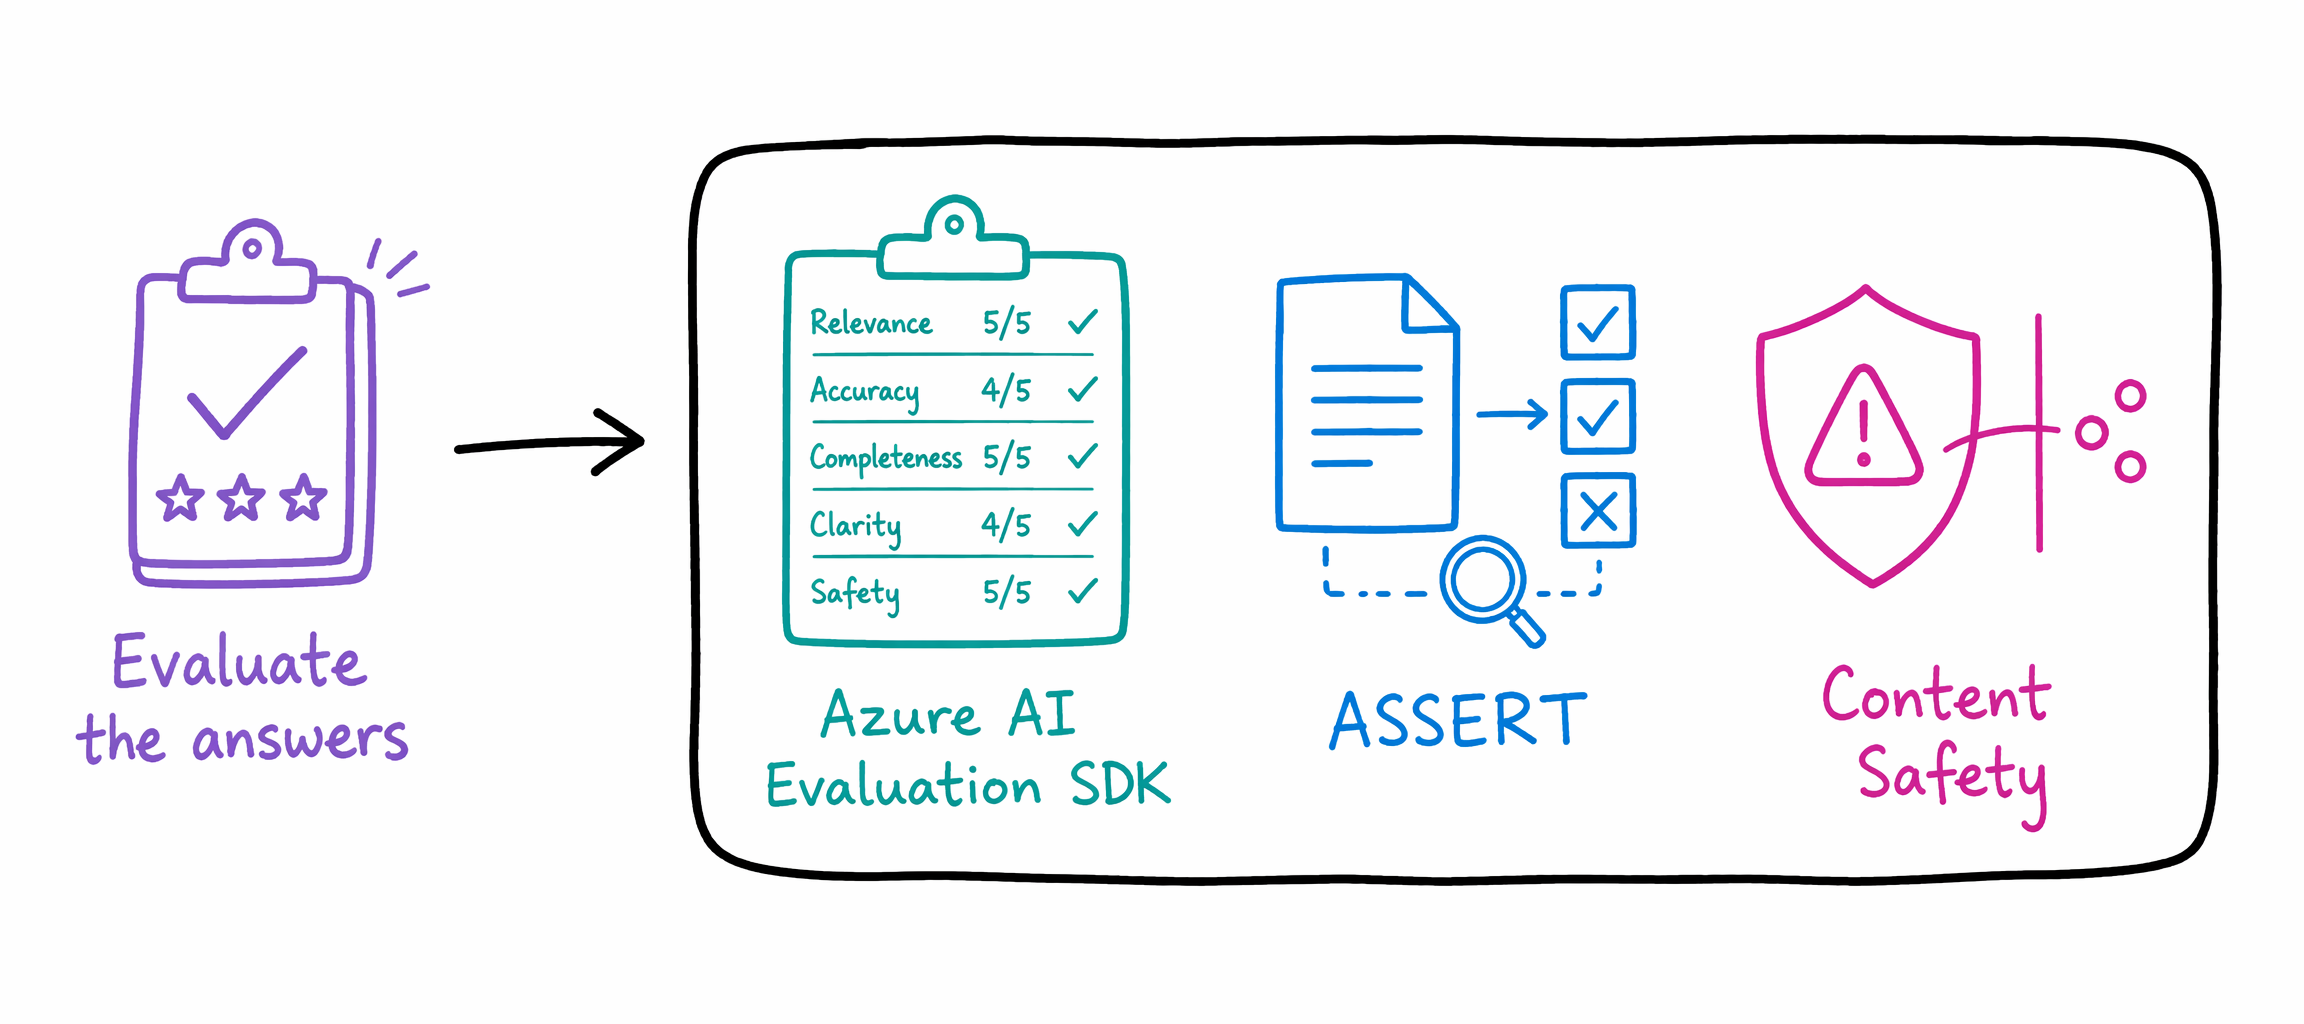
Azure AI 평가 SDK는 품질(접지성, 관련성, 일관성), 안전성(유해하거나 편향된 콘텐츠) 및 에이전트 동작(의도 확인, 도구 호출 정확도, 작업 준수)에 대한 기본 제공 평가자와 사용자 지정 평가자를 사용하여 이 점수 매기기를 자동으로 실행합니다.
회귀를 포착하기 위해 팀은 ASSERT(평가 및 회귀 테스트를 위한 적응형 사양 기반 평가)를 사용합니다. 이 도구는 할인을 지어내지 말 것과 같은 에이전트의 규칙을 자동화된 테스트로 바꾸고, 각 실패를 정확한 요청과 그 이유에 연결하므로 팀은 에이전트가 왜 기대에 못 미쳤는지 알 수 있습니다.
공용 에이전트는 공격적인 답변을 감당할 수 없기 때문에 Microsoft Foundry Content Safety는 쇼핑객에게 도달하기 전에 유해하거나 편향된 응답을 플래그로 지정합니다.
프로덕션에 배포
에이전트의 점수가 괜찮으니 이제 발송할 때입니다. Adventure Works는 웹 사이트에서 안정적으로 실행되고 가동 중지 시간 없이 업데이트되며 실제 쇼핑객이 도착하면 면밀히 관찰해야 합니다.
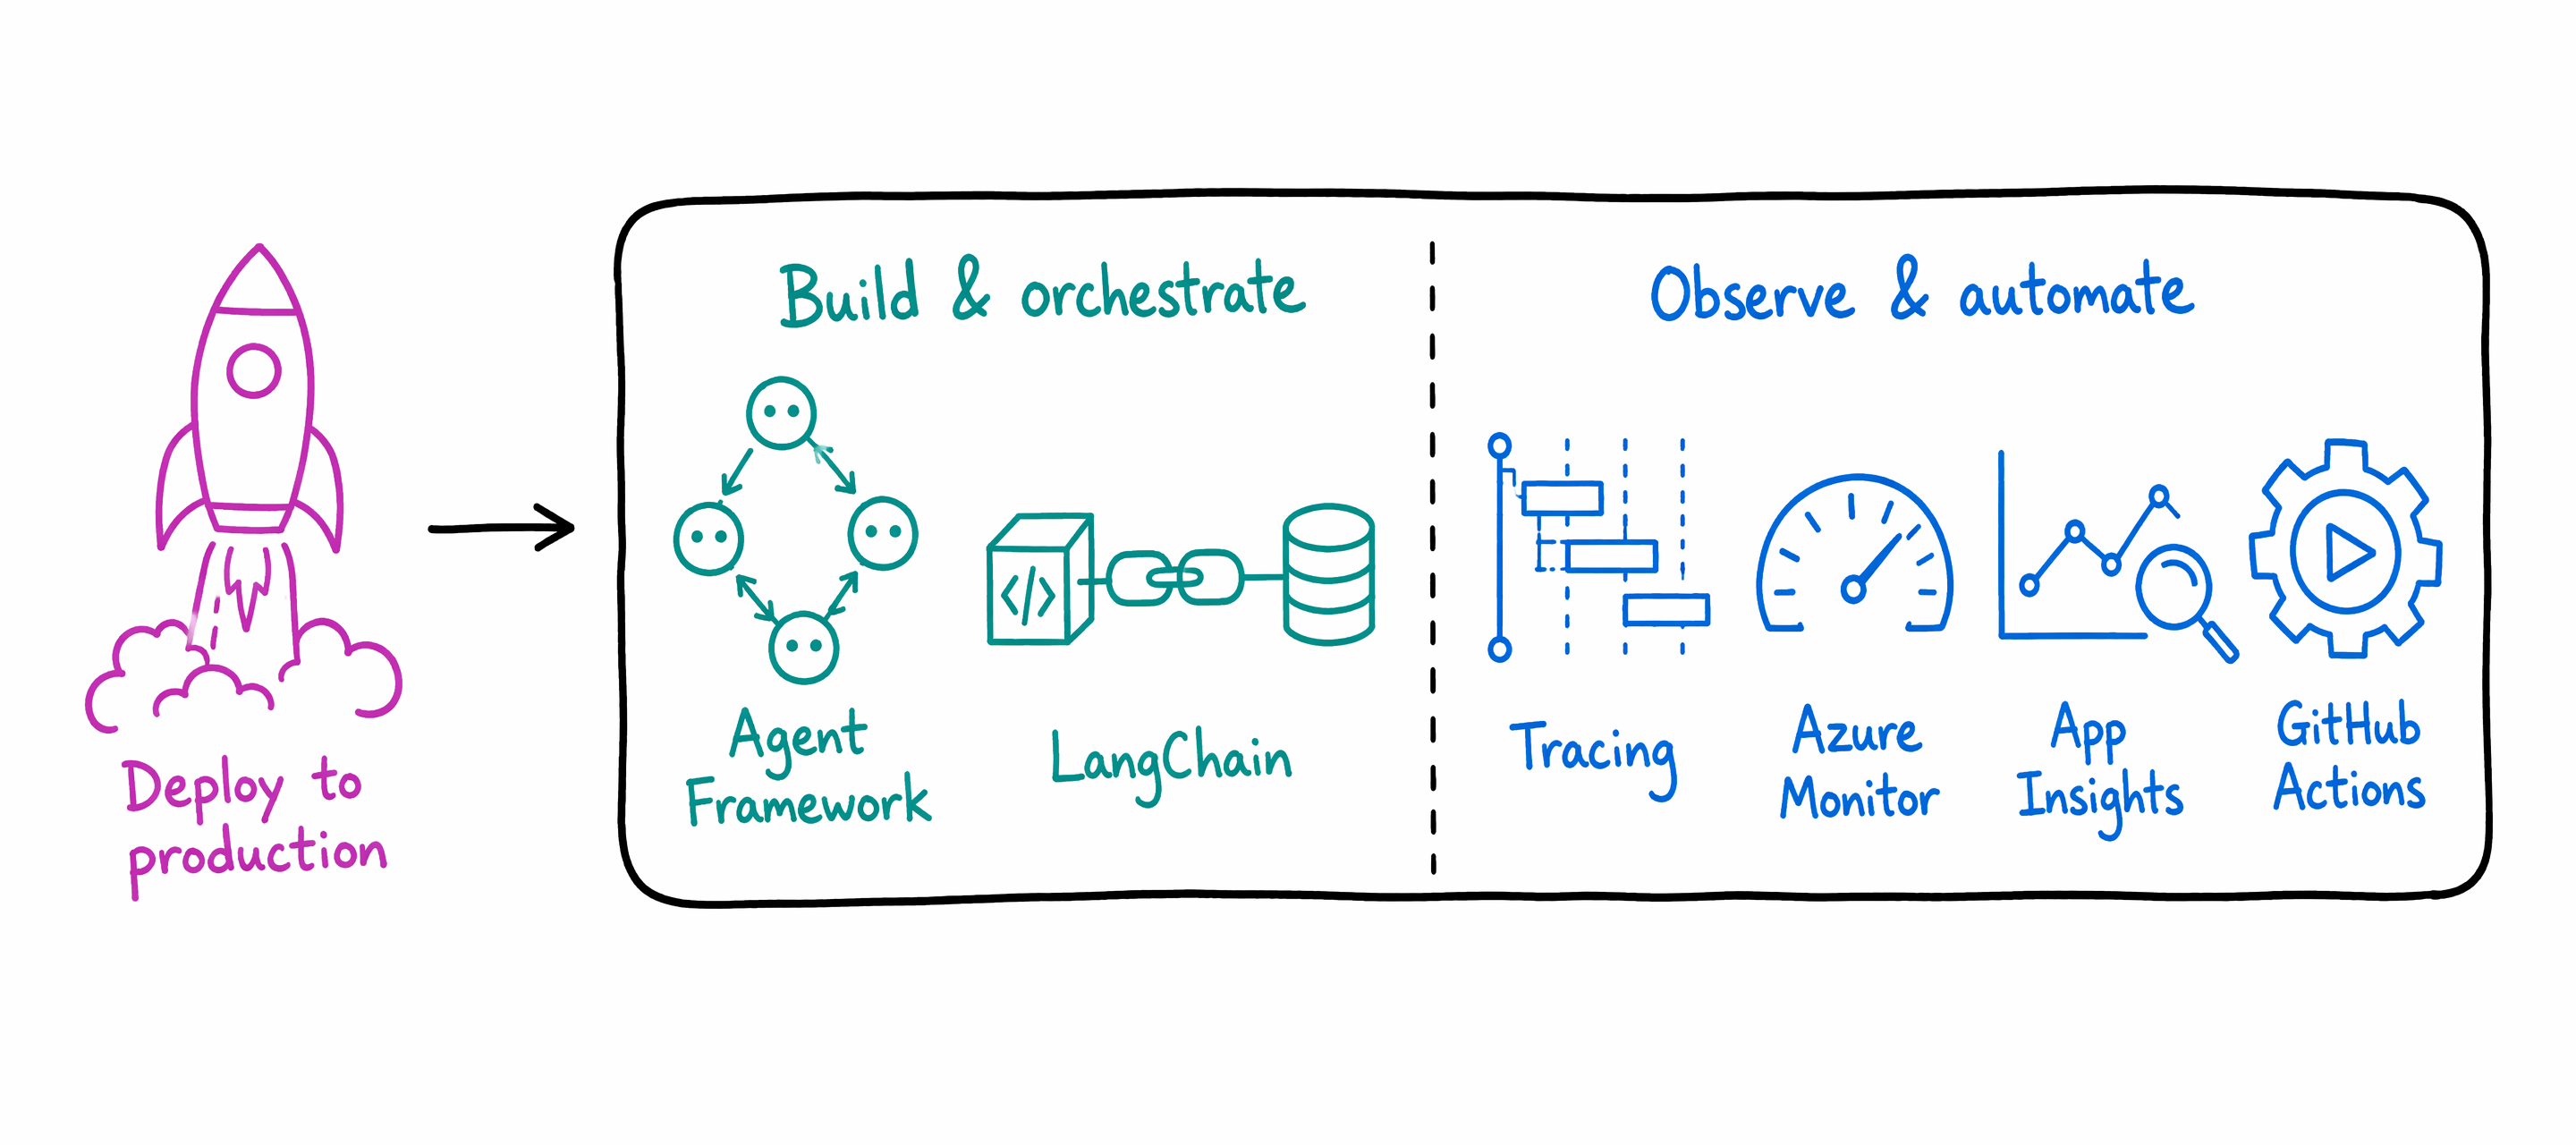
에이전트를 빌드하고 오케스트레이션하기 위해 Microsoft C#용 오픈 소스 SDK인 Microsoft 에이전트 프레임워크와 의미 체계 커널 및 AutoGen을 통합하는 Python 권장하므로, 이미 코드가 있는 경우 마이그레이션 가이드를 사용하여 단일 및 다중 에이전트 워크플로를 일관된 방식으로 빌드할 수 있습니다. LangChain 은 모델을 외부 데이터, API 및 메모리에 연결하는 데 널리 사용되는 대안입니다.
일단 서비스가 시작되면, 팀은 자체적으로 구축되는 스택을 사용하여 에이전트의 상태를 지속적으로 관리합니다. 추적은 각 요청을 기록합니다. 에이전트가 호출한 도구와 응답한 이유를 기록합니다. Azure Monitor 및 Application Insights는 대기 시간, 토큰 사용량 및 오류 비율과 같은 메트릭과 함께 이러한 추적을 수집하므로 팀은 실시간으로 문제를 발견합니다. GitHub Actions 새 버전을 자동으로 배송합니다.
이렇게 하면 루프가 닫힙니다. 프로덕션 트래픽은 동일한 루브릭에 대해 라이브 답변의 점수를 다시 지정하는 연속 평가를 피드합니다. 품질이 흔들리면 팀은 이를 포착해 에이전트를 개선하는 단계로 다시 돌아갑니다. 에이전트를 출시할 때 적용했던 바로 그 치밀한 계획 방식이 이제는 그 에이전트의 신뢰성을 계속 유지하게 합니다.