검색을 위한 데이터 준비
팁 (조언)
자세한 내용은 텍스트 및 이미지 탭을 참조하세요.
검색은 검색 가능한 정보만 찾을 수 있습니다. RAG 애플리케이션이 질문에 답변하려면 원본 데이터를 준비하는 인덱싱 파이프라인 이 필요합니다.
인덱싱 파이프라인은 일반적으로 다음 작업을 수행합니다.
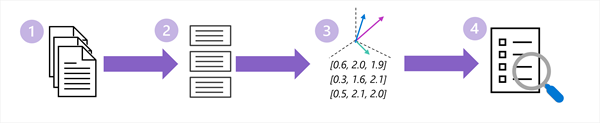
- 원본 텍스트를 추출합니다.
- 텍스트를 포커스가 있는 구절로 청크합니다.
- 의미 체계 특성을 캡슐화하는 포함 벡터로 텍스트 토큰을 인코딩합니다.
- 포함을 검색하는 데 사용할 수 있는 인덱스를 만듭니다.
이러한 각 작업을 좀 더 자세히 살펴보겠습니다.
원본 데이터 선택 및 처리
RAG 지식 원본에는 제품 설명서, 정책, 웹 페이지, 데이터베이스 레코드, 지원 티켓 또는 기타 승인된 콘텐츠가 포함될 수 있습니다. 준비 프로세스에는 일반적으로 다음 단계가 포함됩니다.
- 각 원본에서 콘텐츠를 로드합니다.
- PDF 파일, 프레젠테이션, 웹 페이지 또는 테이블과 같은 형식에서 유용한 텍스트 및 구조를 추출합니다.
- 반복되는 머리글, 탐색 텍스트 또는 질문에 대답하는 데 유용하지 않은 기타 요소를 제거하여 콘텐츠를 정리합니다.
- 제목, 원본 URL, 범주, 액세스 권한 및 마지막으로 업데이트된 날짜와 같은 메타데이터를 추가합니다.
원본 품질이 중요합니다. 중복되거나, 오래되거나, 모순된 문서는 잘못된 검색 및 신뢰할 수 없는 답변으로 이어질 수 있습니다. 액세스 제어도 필수적입니다. 사용자는 볼 수 있는 권한이 있는 콘텐츠만 검색해야 합니다.
콘텐츠를 청크로 나누기
문서가 너무 커서 전체 모델로 보낼 수 없는 경우가 많습니다. 그들은 청크라는 작은 구절로 나뉩 니다. 각 청크에는 특정 토픽에 중점을 두면서 의미 있는 컨텍스트를 충분히 포함해야 합니다.
예를 들어 여행 정책은 항공편, 호텔, 식사 및 지상 운송에 대한 별도의 청크로 섹션별로 분할될 수 있습니다. 호텔 제한에 대한 질문은 프롬프트에 전체 정책을 추가하지 않고 호텔 섹션을 검색할 수 있습니다.
청크 분할에는 다음과 같은 절충이 포함됩니다.
- 너무 큰 청크는 관련 없는 정보를 포함하고 모델의 컨텍스트 창을 더 많이 사용할 수 있습니다.
- 너무 작은 청크는 문을 이해하는 데 필요한 제목, 정의 또는 기타 정보와 구분할 수 있습니다.
청크는 경계에서 중요한 컨텍스트가 손실되지 않도록 약간 겹치는 경우가 많습니다.
임베딩 생성
RAG 솔루션은 일반적으로 포함 모델을 사용하여 각 청크를 콘텐츠의 의미 체계 특성을 나타내는 숫자 벡터인 포함으로 변환합니다. 비슷한 의미를 가진 청크에는 서로 다른 단어를 사용하는 경우에도 벡터 공간에서 서로 가까운 포함이 있습니다.
데이터 인덱싱
솔루션은 청크, 해당 포함 및 유용한 메타데이터를 검색 인덱스 또는 벡터 사용 데이터 저장소에 저장합니다. 인덱스가 다음을 지원할 수 있습니다.
- 키워드 검색은 정확한 단어, 식별자 또는 제품 코드가 중요한 경우에 효과적입니다.
- 의미상 유사한 콘텐츠를 찾는 벡터 검색입니다.
- 키워드와 벡터 검색을 결합하는 하이브리드 검색입니다.
데이터 준비는 일회성 작업이 아닙니다. 인덱싱 파이프라인은 새 콘텐츠를 추가하고, 변경된 콘텐츠를 업데이트하고, 더 이상 유효하지 않은 콘텐츠를 제거해야 하므로 검색은 현재 진리 소스를 반영합니다.