Merk
Tilgang til denne siden krever autorisasjon. Du kan prøve å logge på eller endre kataloger.
Tilgang til denne siden krever autorisasjon. Du kan prøve å endre kataloger.
Eventstream i Microsoft Fabric er en fullstendig administrert hendelsesinntak og strømmingstjeneste som muliggjør sanntids databehandling og analyse. Du kan integrere eventstream med Fabric-notatbøker ved å bruke Spark Structured Streaming for å behandle og analysere strømmedata i sanntid.
Denne integrasjonen lar deg utforske hendelsesstrømmer og andre sanntidskilder gjennom Real-Time-huben, rett fra dine Fabric notatbøker. Du kan også opprette nye hendelsesstrømmer og begynne å ta inn data fra nesten 30 (og økende) strømmekilder, inkludert CDC-aktiverte databaser, meldingsmeglere, strømmetjenester og offentlige strømmer. Den nye programmeringsmodellen lar deg enkelt koble til eventstream, lese strømmedata og utføre sanntidsanalyser ved hjelp av kjente Spark-API-er uten noen tilkoblingsstrenger eller legitimasjon, noe som gjør det sikrere å bygge sanntidsapplikasjoner
Forhåndskrav
Før du begynner, sørg for at du har følgende forutsetninger på plass:
- Et Fabric-arbeidsområde med eventstream aktivert.
- Et notatbokmiljø satt opp i Fabric.
- Grunnleggende kunnskap om Spark Structured Streaming og PySpark eller Scala.
Trinn for å spørre hendelsesstrøm fra en notatbok
Oppdag og legg til eventstream i Notebook:
Åpne Microsoft Fabric-notatboken din.
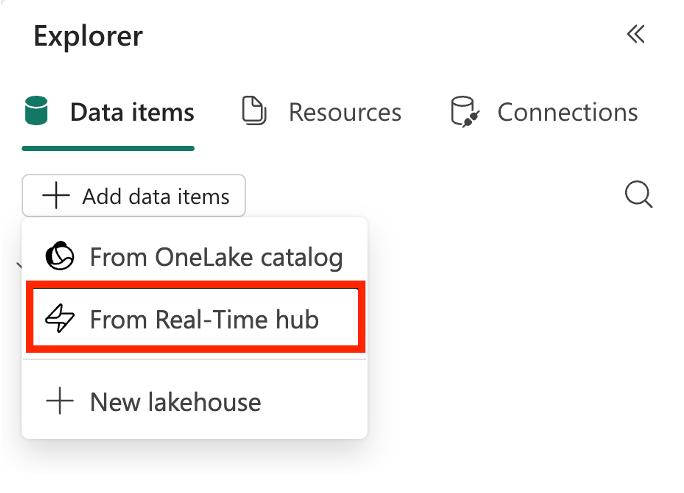
Velg på Legg til dataelementer under fanen Dataelementer , og velg deretter Fra Real-Time hub i nedtrekksmenyen.
I dialogen for Real-Time hub, finn mål-hendelsesstrømmen du ønsker å søke i med ulike søke- og filteralternativer.
Legg til hendelsesstrømmen i notatbokmiljøet ditt.
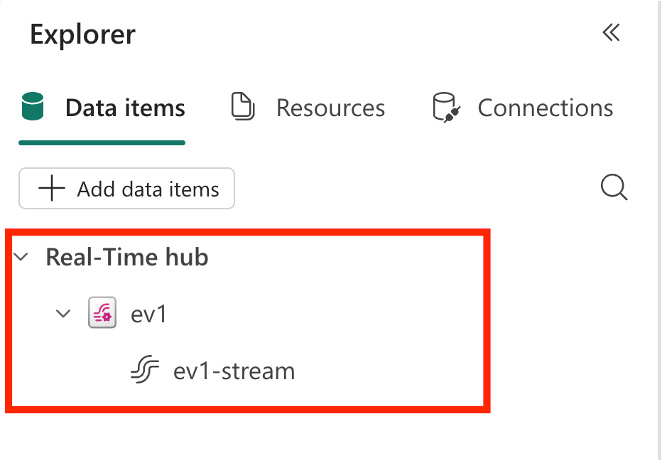
Etter at eventstream-elementet er lagt til, vil det vises under Real-Time-hub-noden i notebook-objektutforskeren med item-navnet, og etter å ha utvidet noden vil du se standard- eller avledede strømmen i eventstream-elementet.
Les strømmedata fra eventstream:
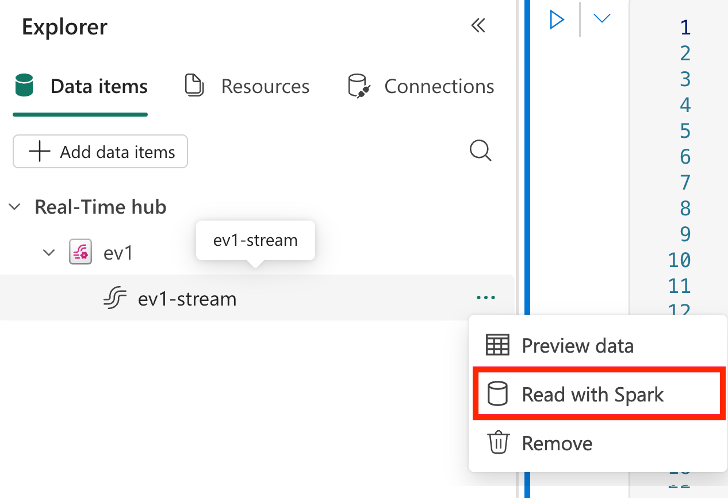
Fra kontekstmenyen til hendelsesstrømmen i objektutforskeren, velg Les med Spark for å lage en forhåndskonfigurert kodecelle som skal leses fra den valgte hendelsesstrømmen.
I den nyopprettede kodecellen kan du bruke følgende PySpark-kodesnippet for å lese strømmende data fra hendelsesstrømmen:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col
from pyspark.sql.types import StringType
from pyspark.sql.dataframe import DataFrame

eventstream_options = {
    "eventstream.itemid": __in_eventstream_item_id,
    "eventstream.datasourceid": __in_eventstream_datasource_id
}

# Read from Kafka using the config map
df_raw = spark.readStream.format("kafka").options(**eventstream_options).load()

decoded_df = df_raw.select(
    col("key").cast(StringType()).alias("key"),
    col("value").cast(StringType()).alias("value"),
    col("partition"),
    col("offset")
)

def showDf(x:DataFrame, y:int):
    x.show()

# Print messages to the console
query = decoded_df.writeStream.foreachBatch(showDf).outputMode("append").start()
query.awaitTermination()
Verdien av
eventstream.itemidogeventstream.datasourceidalternativene fylles automatisk ut i parameterkodecellen over denne kodecellen.Note
For hvert valg på Read with Spark genereres en ny kodecelle med nødvendige parametere automatisk fylt inn, og en ny Notebook-destinasjon opprettes for Eventstream-elementet, hvor den
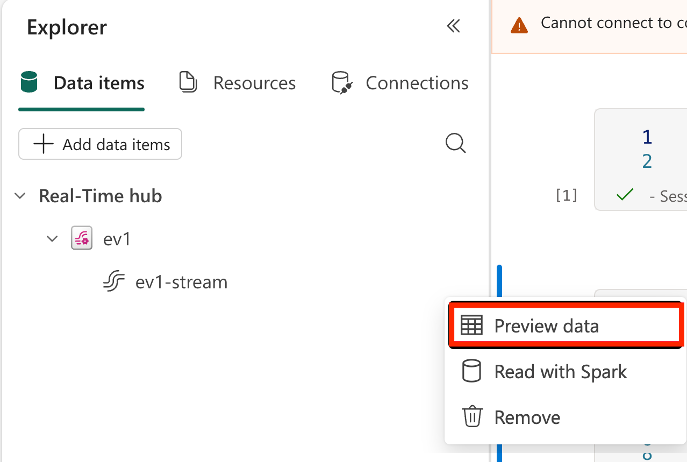
eventstream.datasourceider unik for hver Notebook-destinasjon. For ett notatbokelement anbefaler vi at du setter det én gang som destinasjon for ett Eventstream-element for å unngå å opprette flere destinasjoner.Før du kjører en jobb, kan du også forhåndsvise strømmedataene ved å klikke på knappen Forhåndsvisning av data i kontekstmenyen til Eventstream-elementet. Et sidepanel åpnes og viser et øyeblikksbilde av strømmedataene ved siden av notatboken.
Legg til notatbok som destinasjon: Du kan også legge til notatboken som en destinasjon for at Eventstreamen skal begynne å ta inn data i Eventstream fra innsiden av notatboken. For mer informasjon, se Legg til en Spark Notebook-destinasjon til en hendelsesstrøm.
Konklusjon
Integrering av eventstream i Fabric med notatbøker ved hjelp av Spark Structured Streaming gjør det mulig å behandle og analysere sanntidsdata sømløst. Ved å følge trinnene beskrevet i denne artikkelen kan du enkelt koble deg til eventstream, lese strømmedata og utføre sanntidsanalyser ved hjelp av kjente Spark-API-er. Denne integrasjonen åpner nye muligheter for å bygge sanntidsapplikasjoner og få innsikt fra strømmende data innenfor Fabric-økosystemet.
Beslektet innhold
For å lære mer om å jobbe med eventstreams og notatbøker i Fabric, sjekk ut følgende ressurser