Merk
Tilgang til denne siden krever autorisasjon. Du kan prøve å logge på eller endre kataloger.
Tilgang til denne siden krever autorisasjon. Du kan prøve å endre kataloger.
Gjelder for:✅ Warehouse i Microsoft Fabric
Denne artikkelen beskriver metoder for å migrere datavarehus fra SQL Server til Microsoft Fabric datalager.
Tip
For mer informasjon om strategi og planlegging, se Migrasjonsplanlegging: SQL Server to Fabric datalager.
Bruk Fabric Migration Assistant for datalager for en automatisert migreringsopplevelse fra SQL Server. Resten av denne artikkelen beskriver flere manuelle migreringstrinn.
Følgende tabell oppsummerer metoder for migrering av dataskjema (DDL), databasekode (DML) og data. Hvert alternativ beskrives senere i denne artikkelen.
| Alternativ | Metode | Hva det gjør | Ferdighet eller preferanse | Scenario |
|---|---|---|---|---|
| 1 | Data fabrikk | Skjemakonvertering Uttrekking av data Datainntak |
Data Factory-pipeline | Forenklet skjema- og datamigrering. Anbefales for dimensjonstabeller. |
| 2 | Data Factory med partisjonering | Skjemakonvertering Uttrekking av data Datainntak |
Data Factory-pipeline | Parallellisert migrering for store faktatabeller. |
| 3 | Skjema-først-migrasjon | Skjemakonvertering | Data Factory-pipeline | Migrer skjemaet først, og hent deretter ut og importer data separat for bedre kontroll over gjennomstrømningen. |
| 4 | SQL-migrasjonsskript | Skjemakonvertering Uttrekking av data Kodevurdering |
T-SQL | Bruk en IDE og skript for detaljert kontroll over migreringsoppgaver. |
| 5 | SQL-databaseprosjekter | Skjemakonvertering Kodevurdering |
SQL-prosjektet | Bruk et databaseprosjekt for kildekontroll, vurdering og distribusjon. |
| 6 | DBT | Skjemakonvertering Databasekodekonvertering |
dbt | Gjenbruk et eksisterende dbt-prosjekt ved å endre adapteren og målkonfigurasjonen. |
Velg en arbeidsbelastning for den første overføringen
Når du bestemmer deg for hvor du skal starte et SQL Server til Fabric datalager migreringsprosjekt, velg et arbeidsområde hvor du kan:
- Bevis levedyktigheten av å migrere til Fabric datalager ved raskt å levere fordelene ved det nye miljøet. Start i det små og enkelt, og forbered deg på flere små migrasjoner.
- Gi det tekniske personalet tid til å få relevant erfaring med prosessene og verktøyene de bruker for å migrere andre arbeidsbelastninger.
- Lag en mal for videre migreringer som er spesifikk for ditt SQL Server-miljø, verktøy og prosesser.
Tip
Lag et inventar over objekter som må migreres, og dokumenter migreringsprosessen fra start til slutt slik at den kan gjentas for andre databaser eller arbeidsbelastninger.
Datamengden i en innledende migrering bør være stor nok til å demonstrere kapasitetene og fordelene ved Fabric datalager, men liten nok til å vise verdi raskt. En størrelse i området 1-10 terabyte er typisk.
Migrer med Fabric Data Factory
Fabric Data Factory tilbyr et lavkodegrensesnitt som kan konvertere tabell-DDL og migrere data fra SQL Server.
Fabric Data Factory kan utføre følgende oppgaver:
- Konverter skjema (DDL) til Fabric datalager syntaks.
- Lag skjema-objekter i Fabric datalager.
- Migrer data til Fabric datalager.
Alternativ 1. Skjema- og datamigrering med kopiassistent
Denne metoden bruker Data Factory Copy Assistant for å koble til kilden SQL Server databasen, konvertere tabell-DDL til Fabric syntaks, og kopiere data til Fabric datalager. Du kan velge én eller flere kildetabeller. Den genererte pipelinen bruker en ForEach-aktivitet for å kopiere de valgte tabellene parallelt.
Når du konfigurerer kopieringsoperasjonen:
- Bruk SQL Server-kontakten for kildetilkoblingen.
- Begrens parallelle kopier til et nivå som kildedatabasen og nettverket kan opprettholde.
- Overvåk kilde-CPU, I/O, bruk av transaksjonslogger og produksjonsbelastningsforsinkelse under utvinning.
Anbefalt bruk
Bruk Copy Assistant for et enkelt grensesnitt som konverterer DDL og tar inn utvalgte tabeller i én operasjon. Denne metoden passer godt for dimensjonstabeller og mindre arbeidsbelastninger.
For store tabeller, bruk partisjonering for å øke lese- og skriveparallellismen.
Alternativ 2. Datamigrasjon med partisjonering
For store faktatabeller, bruk en Copy activity for hver tabell og konfigurer kildepartisjonering. Bruk fysiske partisjoner når det er tilgjengelig, eller konfigurer dynamisk område-partisjonering ved å spesifisere en passende numerisk eller datokolonne og dens minimums- og maksimumsverdier.
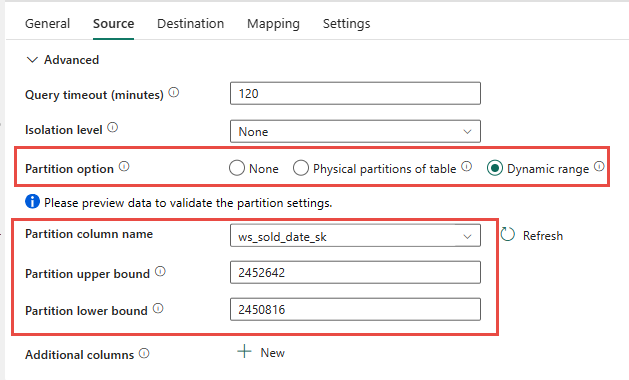
Når du bruker partisjonering:
- Velg en partisjonskolonne som fordeler radene jevnt.
- Unngå å lage flere samtidige kildespørringer enn det SQL Server kan behandle uten å påvirke produksjonsarbeidsbelastningen.
- Test partisjonsområdet og parallelkopieringsinnstillingene mot en representativ arbeidsbelastning.
- Øk parallellismen gradvis mens du overvåker kilde og destinasjon.
Anbefalt bruk
Bruk Data Factory-partisjonering for store faktatabeller når parallell ekstraksjon forbedrer gjennomstrømningen. Skala batch-tellingen og partisjonsområdene i henhold til kildedatabasens ressurser og nettverkskapasitet.
Alternativ 3. Skjema-først-migrasjon
For større databaser, separer skjemamigrering fra datamigrering:
- Konverter og lag tabellskjemaer i Fabric datalager.
- Extract source data into Azure Data Lake Storage (ADLS) Gen2.
- Bruk Data Factory eller COPY INTO-kommandoen for å importere de trinnvise dataene til Fabric datalager.
Ved å skille disse fasene kan du justere ekstraksjon og inntak uavhengig.
Skjemamigrering med Data Factory
Du kan bruke en Fabric pipeline for å migrere tabellskjemaer fra SQL Server til Fabric datalager uten å kopiere rader.
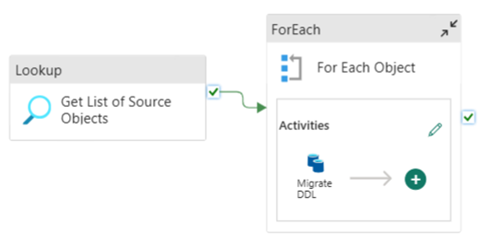
Konfigurer pipeline-parametere
Lag en SchemaName parameter som spesifiserer hvilke skjemaer som skal migreres. Bruk dbo som standard, eller skriv inn en kommaavgrenset liste som 'dbo','sales'.
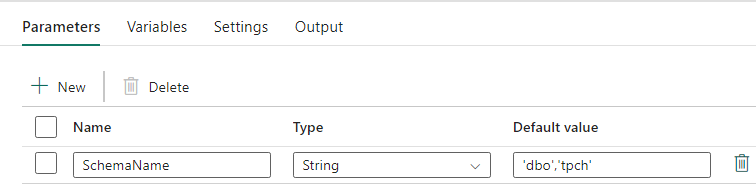
Konfigurer oppslagsaktiviteten
Lag en oppslagsaktivitet, og sett tilkoblingen til kilde-SQL Server-databasen. I Innstillinger-fanen:
- Angi datalagertype til Ekstern.
- Velg kilden til SQL Server-tilkoblingen.
- Sett Use query til Query.
- Legg til en dynamisk spørring som returnerer kildeskjemaet og tabellnavnene.
Bruk følgende uttrykk for å lage spørringen:
@concat('
SELECT s.name AS SchemaName,
t.name AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
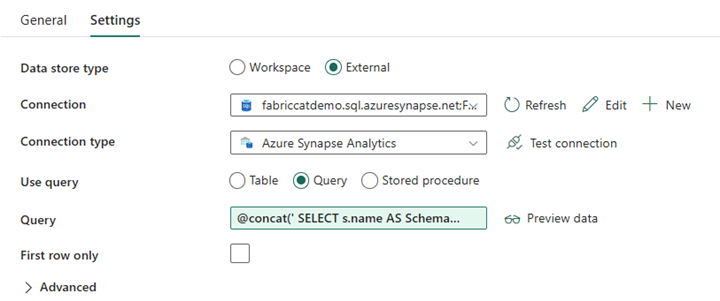
Konfigurer ForEach-aktiviteten
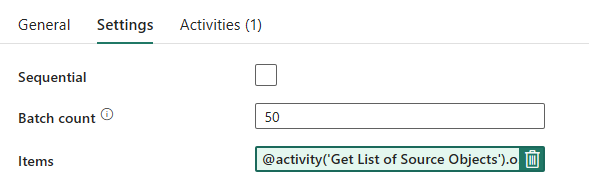
I fanen Innstillinger for ForEach-aktiviteten:
- Deaktiver Sequential for å tillate iterasjoner å kjøre samtidig.
- Sett Batch Count til en verdi kildedatabasen kan opprettholde. Start med en konservativ verdi og test den.
- Sett gjenstander til
@activity('Get List of Source Objects').output.value.
Konfigurer Copy activity
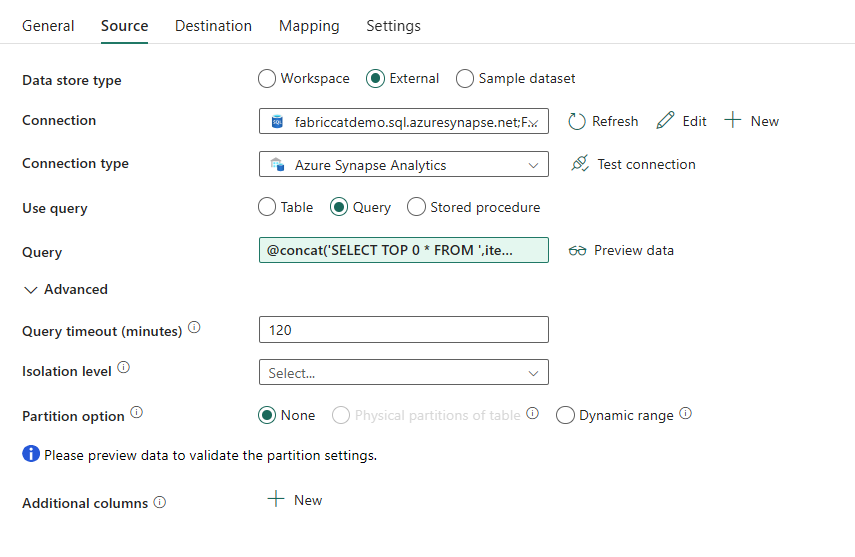
Inne i ForEach-aktiviteten, legg til en Copy activity. I Kilde-fanen:
- Angi datalagertype til Ekstern.
- Velg kilden til SQL Server-tilkoblingen.
- Sett Use query til Query.
- Sett Query slik at
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)kun tabellmetadata migreres.
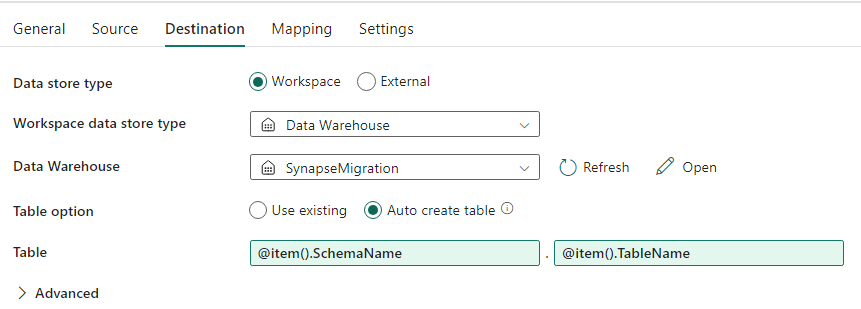
På Mål-fanen:
- Angi datalagertype til arbeidsområde.
- Sett Workspace datalagertype til datalager, og velg destinasjonslageret.
- Sett destinasjonsskjemaet til
@item().SchemaName. - Sett destinasjonstabellen til .
@item().TableName
Etter at du har kjørt pipelinen, verifiser du at Fabric datalager inneholder hver valgt tabell med forventet skjema.
Migrer ved hjelp av SQL-skript
Bruk T-SQL og PowerShell-migreringsskript når du ønsker detaljert kontroll over skjemakonvertering, datautvinning og kodevurdering.
Migrasjonsskript kan:
- Konverter skjema (DDL) til Fabric datalager syntaks.
- Lag skjema-objekter i Fabric datalager.
- Hent ut data fra SQL Server til ADLS Gen2.
- Flagg ikke-støttet T-SQL-syntaks i lagrede prosedyrer, funksjoner og visninger.
Microsoft Fabric CAT-teamet tilbyr migreringskodeeksempler i fabric-migrasjonsarkivet.
Anbefalt bruk
Bruk skript når du er kjent med T-SQL, foretrekker et integrert utviklingsmiljø, og trenger å kontrollere individuelle migreringsoppgaver. Bruk COPY INTO Data Factory for å importere uthentede data til Fabric datalager.
Overføre ved hjelp av SQL-databaseprosjekter
Fabric datalager støttes i SQL Database Projects-utvidelsen for Visual Studio Code.
Et SQL-databaseprosjekt tilbyr kildekontroll, databasetesting, skjemavalidering og distribusjonsmuligheter. Det kan:
- Konverter skjema (DDL) til Fabric datalager syntaks.
- Lag skjema-objekter i Fabric datalager.
- Vurder ustøttet T-SQL-syntaks i lagrede prosedyrer, funksjoner og visninger.
For datamigrering, bruk Data Factory for å kopiere direkte fra SQL Server, eller hent ut data til ADLS Gen2 og importer det med COPY INTO eller Data Factory.
For en gjennomgang av bruk av SQL-databaseprosjekter med migrasjonsskript, se fabric-migration-repositoriet.
For mer informasjon, se Kom i gang med SQL Database Projects-utvidelsen og Bygg et databaseprosjekt fra kommandolinjen.
Migrasjon med dbt
Hvis SQL Server data warehouse din bruker DBT, kan du bruke DBT-adapteren for Fabric datalager til å konvertere skjema- og databasekode ved å endre målprofilen og adapteren.
DBT-rammeverket genererer DDL- og DML-skript fra modellfiler. Du må migrere dataene separat ved å bruke Data Factory eller et annet datamigreringsalternativ i denne artikkelen.
For å komme i gang, se Veiledning: Sett opp dbt for Fabric datalager.
Datainntak i Fabric datalager
For trinnvise data, bruk COPY INTO eller Fabric Data Factory for å importere filer fra ADLS Gen2 til Fabric datalager. Vurder følgende veiledning:
- Trekk ut store tabeller parallelt når kildedatabasen og nettverket har tilstrekkelig kapasitet.
- Foretrekk Parquet-filer for å redusere lagring og nettverksbruk og forbedre inntastingseffektiviteten.
- Last inn flere destinasjonstabeller samtidig når Fabric-kapasiteten din kan håndtere arbeidsmengden.
- Overvåk både kildeuttrekking og Fabric-kapasitet for å finne optimal grad av parallellisme.