Merk
Tilgang til denne siden krever autorisasjon. Du kan prøve å logge på eller endre kataloger.
Tilgang til denne siden krever autorisasjon. Du kan prøve å endre kataloger.
Gjelder for:✅ SQL Analytics-endepunkt og Warehouse i Microsoft Fabric
Viktig!
Denne funksjonen er i forhåndsversjon.
Dataklynging i Fabric datalager organiserer data for raskere spørringsytelse og redusert beregningsbruk. Denne veiledningen går gjennom stegene for å lage tabeller med dataklynging, fra å lage klyngede tabeller til å sjekke hvor effektive de er.
Forutsetninger
- En Microsoft Fabric-leierkonto med et aktivt abonnement.
- Kontroller at du har et Microsoft Fabric-aktivert arbeidsområde: Opprett et arbeidsområde.
- Sørg for at du allerede har opprettet et lager. For å opprette et nytt lager, se Opprett et lager i Microsoft Fabric.
- Grunnleggende forståelse av T-SQL og å spørre data.
Importer eksempeldata
Denne veiledningen bruker NY Taxi-eksempeldatasettet. For å importere NY Taxi-dataene til lageret ditt. Bruk veiledningen Load Sample data to datalager .
Lag en tabell med dataklynging
For denne veiledningen trenger vi to kopier av NYTaxi-tabellen: den vanlige kopien av tabellen slik den ble importert fra veiledningen, og en kopi som bruker dataklynging. Bruk følgende kommando for å lage en ny tabell med CREATE TABLE AS SELECT (CTAS), basert på den opprinnelige NYTaxi-tabellen:
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
Note
Eksempelet antar tabellnavnet som er gitt til NY Taxi-datasettet i Load Sample data to datalager-veiledningen. Hvis du brukte et annet navn på tabellen din, juster kommandoen til å erstatte nyctlc den med tabellnavnet ditt.
Denne kommandoen lager en nøyaktig kopi av den opprinnelige NYTaxi-tabellen, men med dataklynging i kolonnen lpepPickupDatetime . Deretter bruker vi denne kolonnen til forespørsler.
Spørringsdata
Kjør en spørring på NYTaxi-tabellen, og gjenta nøyaktig samme spørring på NYTaxi_With_DataClustering tabellen for sammenligning.
Note
For denne analysen er det nyttig å se på cold cache-ytelsen til begge kjøringene – altså uten å bruke cache-funksjonene i Fabric datalager. Kjør derfor hver spørring nøyaktig én gang før du ser på resultatene i Query Insights.
Vi bruker en forespørsel som ofte gjentas i lageret. Denne spørringen beregner gjennomsnittlig billettpris per år mellom datoene 2008-12-31 og 2014-06-30:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
Note
Label-alternativet som brukes i denne spørringen er nyttig når vi sammenligner spørringsdetaljene i Regular tabellen med tabellen som senere bruker dataklynging ved bruk av Query Insights-visninger.
Deretter gjentar vi nøyaktig samme spørring, men på den versjonen av tabellen som bruker dataklynging:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
Den andre spørringen bruker etiketten Clustered for å la oss identifisere denne spørringen senere med Query Insights.
Sjekk effektiviteten av dataklynging
Etter å ha satt opp klynging, kan du vurdere effektiviteten ved hjelp av Query Insights. Query Insights in Fabric datalager fanger opp historiske spørringsutførelsesdata og aggregerer dem til handlingsrettede innsikter, som å identifisere langvarige eller ofte utførte spørringer.
I dette tilfellet bruker vi Query Insights for å sammenligne forskjeller i data som er skannet mellom de vanlige og de klyngede tilfellene.
Bruk følgende spørring:
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
Denne spørringen henter detaljer fra visningen exec_requests_history . For mer informasjon, se queryinsights.exec_requests_history (Transact-SQL).
Spørringen filtrerer resultatene på følgende måter:
- Henter kun rader som inneholder teksten
NYTaxii kommandonavnet (slik det ble brukt i testspørringene) - Henter kun rader der etikettverdien enten var vanlig eller klynget
Note
Det kan ta noen minutter før søkedetaljene dine blir tilgjengelige i Query Insights. Hvis Query Insights-spørringen din ikke gir noen resultater, prøv igjen etter noen minutter.
Når vi kjører denne spørringen, ser vi følgende resultater:

Begge spørringene har 6 rader og lignende innsendingstider. Undersøkelsen Clustered viser total_elapsed_time_ms fra 1794, allocated_cpu_time_ms 1676 og data_scanned_remote_storage_mb 77,519. Søket Regular viser total_elapsed_time_ms 2651, allocated_cpu_time_ms 2600 og data_scanned_remote_storage_mb 177 700. Disse tallene viser at selv om begge spørringene ga samme resultater, Clustered brukte versjonen omtrent 36% mindre CPU-tid enn versjonen Regular og skannet omtrent 56% mindre data på disken. Ingen cache ble brukt i noen av spørringene. Dette er viktige resultater som bidrar til å redusere spørringskjøringstid og forbruk, og gjør kolonnen lpepPickupDatetime til en sterk kandidat for dataklynging.
Note
Dette er en liten tabell, med omtrent 76 millioner rader og 2 GB datavolum. Selv om denne spørringen kun gir seks rader i aggregeringen (én for hvert år i området), skanner den omtrent 8,3 millioner rader i det oppgitte datoområdet før resultatene aggregeres. Faktiske produksjonsdata med større datavolumer kan gi mer signifikante resultater. Resultatene dine kan variere basert på kapasitetsstørrelse, bufrede resultater eller samtidighet under spørringene.
Velg klyngekolonner fra arbeidsmengden din
For produksjonstabeller, bruk observerte spørringsmønstre i stedet for å gjette hvilke kolonner som skal grupperes. Ferdighetens operasjonskapasitet sqldw-cli analyserer historikken til Query Insights, rangerer gjentakende spørringsmønstre etter fjerndata som skannes, og identifiserer kolonner brukt i WHERE predikater.
Før du starter, installer Skills for Fabric, sørg for at lageret har nylig spørringsaktivitet, og bekreft at du har rollen Bidragsyter eller høyere. Deretter åpner du GitHub Copilot CLI og bruker en prompt som denne:
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
Ferdigheten identifiserer spørringsmønstrene med størst skanningseffekt, trekker ut tabeller og filterkolonner fra disse spørringene, og rangerer klyngekandidatene. Gå gjennom anbefalingene med disse retningslinjene:
- Foretrekk kolonner som gjentatte ganger filtrerer store tabeller og bruker mellomstore til høye kardinalitetsverdier, som datoer eller identifikatorer.
- Favor-kolonner brukt i selektiv rekkevidde eller likhetspredikater i klausulen
WHERE. - Ikke velg kolonner bare fordi de vises i likhetssammenføyningsbetingelser. Disse forholdene drar ikke nytte av dataklynging.
- Bruk ikke mer enn fire klyngekolonner, og ikke legg til flere kolonner enn arbeidsmengden krever.
For eksempel, vurder et e-handelslager hvor Sales.SalesOrder inneholder 1,5 milliarder rader og Sales.OrderLine 6 milliarder rader. Etter å ha analysert gjentakende spørsmål, kan ferdigheten gi disse anbefalingene:
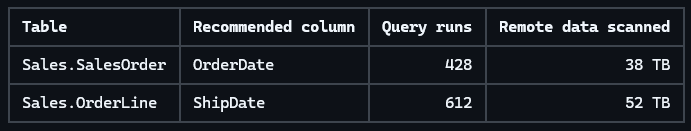
Datokolonnene er sterke kandidater fordi de filtrerer de største tabellene, støtter predikater for felles verdier, og gir flere muligheter for filhopp enn kolonner med lav kardinalitet som OrderStatus eller SalesRegion.
Operasjonsfunksjonen sqldw-cli er skrivebeskyttet. Den anbefaler kolonner, men oppretter eller erstatter ikke tabeller. Etter at du har gjennomgått anbefalingen, bruk CTAS for å lage en klynget kopi av tabellen:
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
Sammenlign de klyngede og ikke-klyngede arbeidsbelastningene for å verifisere effekten. Etter at du har validert den klyngede tabellen, gi den opprinnelige tabellen nytt navn og deretter den klyngede tabellen til det opprinnelige navnet:
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
Den opprinnelige tabellen er fortsatt tilgjengelig for Sales.SalesOrder_old rollback. Verifiser avhengige arbeidsbelastninger og den nye tabellen før du fjerner den opprinnelige tabellen. Når du ikke lenger trenger tilbakerullingskopien, slipp den:
DROP TABLE Sales.SalesOrder_old;