Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of mappen te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen om mappen te wijzigen.
Genereer vooraf ingevulde weergaven over gegevens in een of meer gegevensarchieven wanneer de gegevens niet ideaal zijn opgemaakt voor vereiste querybewerkingen. Deze aanpak kan efficiënte query's en gegevensextractie ondersteunen en de prestaties van toepassingen verbeteren.
Context en probleem
Bij het opslaan van gegevens geven ontwikkelaars en gegevensbeheerders vaak prioriteit aan hoe de gegevens worden opgeslagen in plaats van hoe ze worden gelezen. De gekozen opslagindeling weerspiegelt meestal de indeling van de gegevens, vereisten voor het beheren van de gegevensgrootte en gegevensintegriteit en het soort opslag dat wordt gebruikt. Wanneer u bijvoorbeeld een NoSQL documentarchief gebruikt, vertegenwoordigt u vaak de gegevens als een reeks aggregaties, die alle informatie voor die entiteit bevatten.
Deze benadering kan echter een negatief effect hebben op query's. Wanneer een query voldoende heeft aan een subset van de gegevens uit sommige entiteiten, zoals een samenvatting van orders voor verschillende klanten zonder alle ordergegevens, moet de query toch alle gegevens voor de relevante entiteiten extraheren om over de vereiste gegevens te beschikken.
Het toevoegen van indexen of het opnieuw vormgeven van query's op leestijd lost deze inefficiëntie niet altijd op. Veel winkels kunnen niet opnieuw worden geïndexeerd voor willekeurige leespatronen zonder dat dit van invloed is op de schrijfprestaties. Aggregatie tussen entiteiten blijft duur tijdens het uitvoeren van query's. Sommige winkels hebben standaard beperkte querymogelijkheden. Vanwege deze beperkingen is het optimaliseren van het leespad in het bronarchief vaak onvoldoende.
Solution
Om efficiënte query's te ondersteunen, is een algemene oplossing om vooraf een weergave te genereren die de gegevens materialiseert in een indeling die geschikt is voor de vereiste resultatenset. Het patroon Gerealiseerde weergave beschrijft het genereren van vooraf ingevulde weergaven van gegevens in omgevingen waar de brongegevens niet beschikbaar zijn in een indeling die geschikt is voor het uitvoeren van query's, waar het genereren van een geschikte query moeilijk is of waar de queryprestaties tegenvallen vanwege de aard van de gegevens of het gegevensarchief.
In dit patroon is een gerealiseerde weergave een leesmodel of projectie waarmee gegevens worden bewaard die zijn afgeleid van een of meer bronarchieven. Een specifieke applicatiecomponent of datapijplijn kan de projectie onderhouden, ook over opslaggrenzen heen. Consumenten van query's behandelen de projectie als alleen-leesbaar. Dit architectuurconcept is breder dan een database-native gematerialiseerde-weergaveobject, dat door een database-engine wordt gedefinieerd, opgeslagen en vernieuwd volgens zijn eigen functionele beperkingen.
Met deze gerealiseerde weergaven, die alleen gegevens bevatten die vereist zijn voor een query, kunnen toepassingen snel de benodigde informatie verkrijgen. Naast het samenvoegen van tabellen of het combineren van gegevensentiteiten, kunnen gerealiseerde weergaven de huidige waarden bevatten van berekende kolommen of gegevensitems, de resultaten van het combineren van waarden of het uitvoeren van transformaties op de gegevensitems en waarden die zijn opgegeven als onderdeel van de query. Een gerealiseerde weergave kan zelfs worden geoptimaliseerd voor één query.
Een belangrijk punt is dat een gerealiseerde weergave en de gegevens die deze bevat volledig wegwerpbaar zijn, omdat ze volledig opnieuw kunnen worden opgebouwd uit de brongegevensarchieven. Querygebruikers werken de weergave niet rechtstreeks bij. In plaats daarvan onderhoudt een toegewezen onderdeel, gegevenspijplijn of database-engine het, dus het is een gespecialiseerde cache.
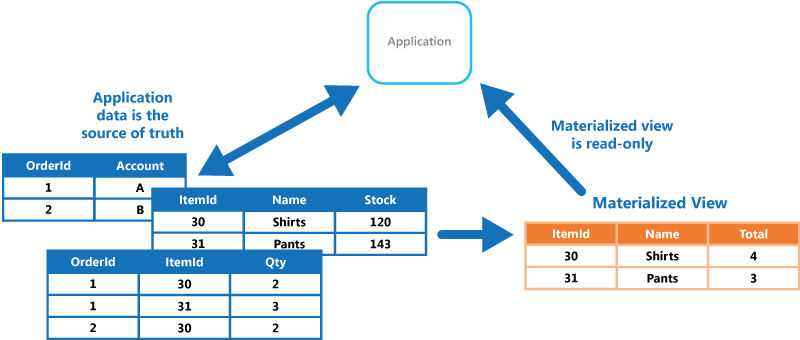
Wanneer de brongegevens voor de weergave worden gewijzigd, moet de weergave worden bijgewerkt om de nieuwe informatie op te nemen. U kunt deze update automatisch plannen of wanneer het systeem een wijziging in de oorspronkelijke gegevens detecteert. In sommige gevallen moet u de weergave mogelijk handmatig opnieuw genereren. In de volgende afbeelding ziet u een voorbeeld van hoe het gerealiseerde weergavepatroon kan worden gebruikt.
Problemen en overwegingen
Houd rekening met de volgende punten wanneer u besluit hoe u dit patroon implementeert:
Bekijk de vernieuwingsstrategie. In het ideale geval wordt de weergave opnieuw gegenereerd als reactie op een gebeurtenis die een wijziging in de brongegevens aangeeft, hoewel deze benadering kan leiden tot overmatige overhead als de brongegevens snel veranderen. U kunt de weergave ook opnieuw genereren via een geplande taak, een externe trigger of een handmatige actie.
Vernieuwingsgedrag. Bepaal of de implementatie een volledige herbouwing uitvoert of wijzigingen incrementeel toepast. U moet ook bepalen of vernieuwingsbewerkingen leesbewerkingen blokkeren.
Met deze beslissingen wordt bepaald of query's verouderde gerealiseerde gegevens retourneren, gerealiseerde gegevens combineren met niet-verwerkte bronwijzigingen om de huidige resultaten te retourneren of de laatste volledige versie blijven leveren totdat het vernieuwen is voltooid.
Signaalbetrouwbaarheid vernieuwen. Als het activatiesignaal dat de weergave opnieuw opbouwt verloren gaat of vertraagd raakt - bijvoorbeeld door een gemiste change-feed-gebeurtenis of een mislukte geplande taak - levert de weergave stilzwijgend verouderde resultaten. Bewaak hoe recent de vernieuwing is en waarschuw wanneer de ouderdom van de weergave de acceptabele verouderingsmarge overschrijdt.
Kosten voor rekenkracht vernieuwen. Het regenereren van een weergave verbruikt rekenresources evenredig met het volume van de brongegevens en de complexiteit van de transformaties. Voor gebeurtenisgestuurde vernieuwing van snel veranderende brongegevens of voor volledige herbouw van grote analytische weergaven kunnen de rekenkosten van vernieuwing een aanzienlijk kostenstuurprogramma zijn. Stem de vernieuwingsfrequentie en de reikwijdte goed af om de actualiteit van gegevens in balans te brengen met de rekenkosten.
Event Sourcing-afhankelijkheid In sommige systemen, zoals wanneer u het patroon Gebeurtenisbronnen gebruikt om alleen de gebeurtenissen die de gegevens hebben gewijzigd, te bewaren, zijn gerealiseerde weergaven doorgaans nodig. Het vooraf invullen van weergaven door alle gebeurtenissen te onderzoeken om de huidige status te bepalen, kan de enige manier zijn om gegevens op te halen uit het archief met gebeurtenissen. Als u geen gebruikmaakt van Event Sourcing, overweeg dan of een materialized view nuttig is. Gematerialiseerde weergaven zijn meestal specifiek toegesneden op één of een klein aantal query's. Als er veel query's worden gebruikt, kunnen gematerialiseerde weergaven leiden tot onaanvaardbare vereisten voor opslagcapaciteit en -kosten.
Gegevensconsistentie. Houd rekening met de impact op gegevensconsistentie bij het genereren van de weergave en bij het bijwerken van de weergave als dit proces volgens een planning plaatsvindt. Als de brongegevens tegelijkertijd worden gewijzigd als de weergave wordt gegenereerd, is de kopie van de gegevens in de weergave niet volledig consistent met de oorspronkelijke gegevens. Het maximale verouderingsvenster is een direct gevolg van het vernieuwingsinterval of de vertraging van gebeurtenisverwerking, dus definieer de acceptabele veroudering voordat u kiest tussen gebeurtenisgestuurde, geplande of handmatige vernieuwing.
Opslaglocatie weergeven. De weergave hoeft zich niet te bevinden in hetzelfde archief of dezelfde partitie als de oorspronkelijke gegevens. U kunt subsets uit een paar verschillende partities combineren.
Opnieuw opbouwen na verlies. Een weergave kan opnieuw worden opgebouwd als deze verloren gaat. Als de weergave tijdelijk is en alleen wordt gebruikt om de queryprestaties te verbeteren door de huidige status van de gegevens weer te geven of om de schaalbaarheid te verbeteren, kunt u deze opslaan in een cache of op een minder betrouwbare locatie.
Als het vernieuwingsproces zelf echter halverwege mislukt, bijvoorbeeld als een geplande regeneratietaak vastloopt, bepaalt u of de werkbelasting de vorige volledige weergave, een gedeeltelijk bijgewerkte weergave of helemaal geen weergave moet uitvoeren totdat de regeneratie is geslaagd.
De veiligste benadering is doorgaans atomische publicatie of versievervanging, waarbij uw workload de laatste volledige weergave blijft gebruiken terwijl u de nieuwe weergave bouwt en valideert. Wisselen naar de nieuwe weergave nadat de validatie is voltooid.
Berekende kolommen. Wanneer u een gerealiseerde weergave definieert, maximaliseert u de waarde ervan door gegevensitems of kolommen toe te voegen op basis van berekening of transformatie van bestaande gegevensitems, op waarden die zijn doorgegeven in de query of op combinaties van deze waarden, indien van toepassing.
Indexering weergeven. Als het opslagmechanisme hiervoor ondersteuning biedt, kunt u overwegen om de gerealiseerde weergave te indexeren om zo de prestaties verder te verbeteren. Veel relationele databases ondersteunen indexering voor weergaven. Indexonderhoud van de view voegt echter tijdens elke vernieuwingscyclus extra belasting op het schrijfpad toe, dus weeg de winst in leesprestaties af tegen de extra vernieuwingstijd en rekenkosten.
Toegangsbeheer voor weergaven. Wanneer een gerealiseerde weergave wordt gebruikt om te beperken welke gegevenssubsets zichtbaar zijn voor bepaalde consumenten, zoals om veiligheids- of privacyredenen, moet het weergavearchief dezelfde of strengere toegangscontroles afdwingen als de brongegevens. Uw vernieuwingspijplijn moet onbedoelde kolommen of rijen uitsluiten, omdat een weergave die per ongeluk gegevens bevat die buiten het beoogde bereik vallen, beveiligde gegevens beschikbaar kan maken.
Gegevenslevenscyclus voor weergaven. Pas de bewaar- en verwijderingsvereisten van de brongegevens toe op elke gerealiseerde weergave. Bronverwijderingen en -redacties binnen de vereiste periode doorvoeren en elke weergave opnemen in de nalevingsmonitoring. Zie Gegevensbeheer- en beveiligingsbasislijnen met Microsoft Purview voor meer informatie.
Levenscyclusbeheer weergeven. Bekijk weergavedefinities als implementeerbare artefacten die worden beheerd via broncodebeheer en CI/CD-pijplijnen, met name wanneer weergaven declaratief worden gedefinieerd. Zonder levenscyclusbeheer kunnen weergavedefinities tussen omgevingen zweven, wat inconsistent querygedrag veroorzaakt tijdens ontwikkeling, fasering en productie.
Wanneer gebruikt u dit patroon?
Gebruik dit patroon wanneer:
- U moet weergaven maken over gegevens die moeilijk rechtstreeks kunnen worden opgevraagd of waarbij query's erg complex moeten zijn om gegevens op te halen die zijn opgeslagen op een genormaliseerde, semi-gestructureerde of ongestructureerde manier.
- U wilt herbouwbare of tijdelijke projecties in de cache maken die de queryprestaties verbeteren of die shapegegevens vormen die worden gebruikt voor het maken van gegevensoverdrachtobjecten voor een gebruikersinterface, rapport of weergave.
- U moet af en toe verbonden of niet-verbonden scenario's ondersteunen waarbij de verbinding met het gegevensarchief niet altijd beschikbaar is. In dit geval kunt u de weergave lokaal in de cache opslaan.
- U wilt query's vereenvoudigen en gegevens beschikbaar maken voor experimenten op een manier die geen kennis van de brongegevensindeling vereist. Een voorbeeld hiervan is het samenvoegen van verschillende tabellen in een of meer databases, of een of meer domeinen in NoSQL-archieven, en de gegevens vervolgens opmaken voor het uiteindelijke gebruik ervan.
- U wilt toegang verlenen tot specifieke subsets van de brongegevens die om veiligheids- of privacyredenen niet algemeen toegankelijk mogen zijn, open zijn voor wijzigingen of volledig beschikbaar zijn voor gebruikers.
- U wilt verschillende gegevensopslagplaatsen verbinden om gebruik te maken van hun individuele mogelijkheden. U kunt bijvoorbeeld een cloudarchief gebruiken dat efficiënt is voor schrijven als referentiegegevensarchief en een relationele database die goede query- en leesprestaties biedt om de gerealiseerde weergaven te bewaren.
- Wanneer u microservices gebruikt, houdt u ze losjes gekoppeld, inclusief hun gegevensopslag. Gematerialiseerde views kunnen je helpen gegevens uit je services samen te voegen. Als gerealiseerde weergaven niet geschikt zijn in uw microservicesarchitectuur of specifiek scenario, kunt u overwegen om goed gedefinieerde grenzen te hebben die zijn afgestemd op DDD (Domain-Driven Design) en hun gegevens op aanvraag samen te voegen.
Dit patroon is mogelijk niet geschikt wanneer:
- De brongegevens zijn eenvoudig en makkelijk te bevragen.
- De brongegevens veranderen zeer snel of zijn toegankelijk zonder gebruik van een weergave. Vermijd in dergelijke gevallen de extra verwerkingslast die ontstaat bij het maken van weergaven.
- Consistentie heeft een hoge prioriteit. De weergaven zijn mogelijk niet altijd volledig consistent met de oorspronkelijke gegevens.
Ontwerp van werkbelasting
Een architect moet evalueren hoe het gerealiseerde weergavepatroon kan worden gebruikt in het ontwerp van hun workload om de doelstellingen en principes te verhelpen die worden behandeld in de pijlers van het Azure Well-Architected Framework. Voorbeeld:
| Pilaar | Hoe dit patroon ondersteuning biedt voor pijlerdoelen |
|---|---|
| Prestatie-efficiëntie helpt uw workload efficiënt te voldoen aan de vereisten door middel van optimalisaties in schalen, gegevens en code. | In de gerealiseerde weergaven worden de resultaten van complexe berekeningen of query's opgeslagen zonder dat de database-engine of client voor elke aanvraag opnieuw hoeft te worden gecomputeerd. Dit ontwerp vermindert het totale resourceverbruik. - PE:08 Gegevensprestaties |
Als dit patroon compromissen binnen een pijler introduceert, moet u deze tegen de doelstellingen van de andere pijlers overwegen.
Example
Overweeg een verkooptoepassing waarin de entiteiten Order, OrderItem en Klant in Azure-tabelopslag worden opgeslagen. Orders worden gepartitioneerd volgens klant-id, orderitems volgens order-id, en klanten volgens regio. Deze sleutels ondersteunen de operationele toegangspatronen van de toepassing, maar een verkooprapport gegroepeerd op product moet gegevens lezen over partities en deze combineren in toepassingscode.
In de volgende afbeelding ziet u een gerealiseerde weergave waarin de totale verkoopwaarde en het aantal afzonderlijke aankoopklanten voor elk product in de categorie Elektronica worden opgeslagen. De bronrijen en samenvattingswaarden zijn illustratief, niet een volledige invoergegevensset voor de weergegeven totalen.
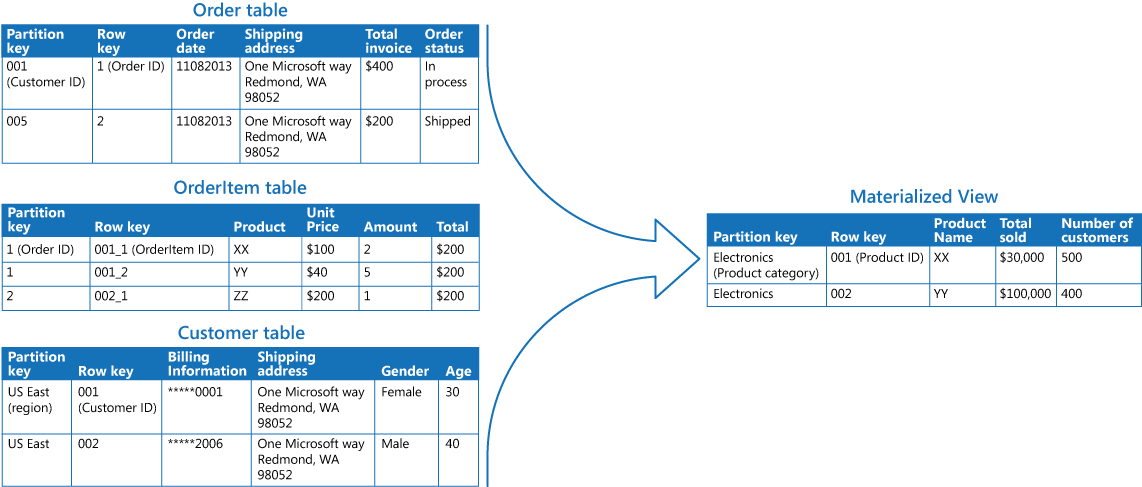
Een achtergrondproces leest de vereiste bronentiteiten, koppelt orderitems aan hun orders en klanten en aggregert de verkoop per product. Elke klant wordt één keer per product geteld, ook als die klant meerdere bestellingen of bestelregels heeft. Het proces schrijft de resultaten naar een afzonderlijke samenvattingstabel met productcategorie als PartitionKey en product-ID als RowKey. Deze overzichtstabel is een projectie die door toepassingen wordt onderhouden, niet een databaseeigen gerealiseerde weergave.
Een dashboard kan vervolgens een query uitvoeren op de Electronics-partitie in plaats van de lees- en aggregatiebewerkingen voor meerdere partities voor elke aanvraag te herhalen. Een zoekactie voor één product levert beide sleutels. Zie Ontwerpen voor query's voor de gevolgen voor queryprestaties van deze sleutels.
Vernieuw de samenvatting volgens een planning die voldoet aan de toegestane verouderingsperiode van het rapport. Bouw en valideer een nieuwe versie voordat deze wordt gepubliceerd, zodat lezers de vorige volledige versie blijven gebruiken tijdens een herbouwing. De vernieuwing brengt nog steeds lees- en aggregatiekosten over partities heen met zich mee, maar herhaalde query's voor rapporten maken opnieuw gebruik van het resultaat. Bronwijzigingen zijn pas zichtbaar wanneer een volgende vernieuwing deze bevat.
Volgende stappen
- In geïndexeerde weergaven wordt beschreven hoe SQL-databases berekende weergaveresultaten kunnen behouden door een index in een weergave te maken.
- Ontwerppatronen voor wijzigingenfeeds in Azure Cosmos DB voor NoSQL beschrijft hoe gebruikers van wijzigingenfeeds gerealiseerde weergaven kunnen onderhouden.
- Overzicht van gematerialiseerde weergaven beschrijft gematerialiseerde weergaven in Azure Data Explorer.
- Azure Managed Redis kan vooraf berekende queryresultaten in de cache opslaan als een voor lezen geoptimaliseerde laag voor persistente gegevensopslag.
- Azure-tabelopslag kunt vooraf samengestelde weergavegegevens opslaan die zijn gegenereerd door toepassingslogica of een achtergrondproces.
Gerelateerde bronnen
De volgende patronen zijn mogelijk ook relevant wanneer u dit patroon implementeert:
- Command and Query Responsibility Segregation (CQRS)-patroon. Gebruik om de informatie in een gerealiseerde weergave bij te werken door te reageren op gebeurtenissen die optreden wanneer de onderliggende gegevenswaarden veranderen.
- Event Sourcing-patroon. Gebruik samen met het CQRS-patroon om de informatie in een gerealiseerde weergave te behouden. Wanneer de gegevenswaarden waarop een gematerialiseerde weergave is gebaseerd veranderen, kan het systeem gebeurtenissen genereren die deze wijzigingen beschrijven en deze opslaan in een gebeurtenisarchief.
- Indextabelpatroon. De gegevens in een gerealiseerde weergave zijn doorgaans geordend op een primaire sleutel, maar het kan zijn dat query's gegevens moeten ophalen uit deze weergave door gegevens in andere velden te onderzoeken. Gebruik dit patroon om secundaire indexen te maken voor gegevenssets voor gegevensarchieven die geen systeemeigen secundaire indexen ondersteunen.